ARTICLE · 1332701
腾讯开源知识库 WeKnora:把文档变成问答、Agent 和自动 Wiki
WeKnora 不是又一个 RAG 套壳。它把知识库当成底层存储,上面跑三种消费方式——检索问答、ReAct Agent、自动生成的 Wiki。该项目的github网址如下:https://github.com/Tencent/WeKnora
本文按架构层次拆,不讲愿景,只讲它做了什么、怎么做的、哪里要留神。
一、为什么大多数 RAG 项目到第二代就停了
RAG 项目的演进路线很一致。第一代:chunk → embedding → top-k → 拼 prompt,能跑就行。第二代:混合检索补关键词召回,rerank 补精排,GraphRAG 补跨文档关系,评测补调参依据。
到这一步大家都在卷同一个指标——召回质量。但召回质量再高,知识库依然是只读的 query endpoint,调用方式只有一种:人问它答。
WeKnora 的差异点不在检索层,而在于它把知识库之上的消费层拆成了三个,并且共用同一份底层数据。这个设计选择决定了后面所有的东西。
二、检索层:第二代标配,不多不少
快速过一遍,因为这一层没有惊喜,只有完成度。
- 混合检索:BM25 类关键词 + 向量,rerank 精排
- 父子分块:小块召回、大块返回,解决上下文截断
- GraphRAG:基于 Neo4j,默认不启,“--profile” 开
- 引用回溯:答案附来源,可跳到原文段落
- 评测:内置召回率、BLEU/ROUGE 端到端测试
最后一条值得多说一句。大部分开源 RAG 换个 embedding 模型只能靠手感,WeKnora 给了量化 pipeline,这才是能进生产的前提。
向量库后端可插拔:pgvector、Elasticsearch、OpenSearch、Milvus、Weaviate、Qdrant、Doris、腾讯 VectorDB。模型层 29 家厂商,含 Ollama 和 LiteLLM,意味着可以完全离线跑。
三、Agent 层:真正有技术含量的部分
这是 WeKnora 和同类项目拉开差距的地方,逐个组件看。
执行模型:ReAct 循环,思考 → 行动 → 观察,每一步在 UI 中可见。不是黑盒输出一个结果。
技能系统:技能是可安装的能力单元,来源支持 ClawHub、SkillHub、Git 仓库、ZIP 包。这意味着可以自己写技能、内部分发、不依赖官方市场。
沙箱:技能执行隔离在 Docker、E2B 或 Cube 三选一的沙箱中,会话级持久化——同一会话内多轮调用共享文件系统状态。沙箱旁边挂了交互式终端和图形桌面,Agent 卡住时可以人工接管。支持检查点,可回滚到任意状态重跑。
浏览器操控:BrowserSkill 驱动的是用户本机的 Chrome/Edge,复用已有登录态和 cookie。遇到登录页或验证码,控制权交回人,处理完继续。这比无头浏览器从零走登录流程的成功率高一个量级,代价是必须有一台带浏览器的机器在线。
对话控制流:对话中途可注入新指令;可以从任意历史节点 fork 出新分支;配合沙箱检查点,实际上是给 Agent 执行加了版本控制。
v0.9.0 新增:多 Agent 协作、cron 式定时任务、三档执行权限(只读 / 变更前确认 / 自动写入)。权限是按任务粒度配的,不是全局开关。
一个实际场景:定时任务每周一触发 → GitLab 数据源拉上周 MR → 检索知识库里的评审规范 → 沙箱内跑脚本做对照生成表格 → 企业微信渠道推送。权限设"变更前确认",推送前阻塞等人工 approve。整条链路不写胶水代码。
四、Wiki 层:被低估的功能
自动 Wiki 容易被当成锦上添花,但它解决的是知识库最根本的熵增问题——文档越堆越多,没人知道里面有什么,检索效果随之下降。
实现逻辑:从文档中抽取实体(人物、产品、概念),每个实体生成一个 Markdown 页面,页面间建双向链接,按目录组织,附知识图谱可视化。页面可人工编辑,每次修改有版本回滚。v0.5.2 在 4 万文档规模上验证过。
关键设计:Wiki 不是独立产品,和问答、Agent 读的是同一份知识库。改 Wiki 页面,等于在给检索层做人工标注。
五、接入面:平台而非应用
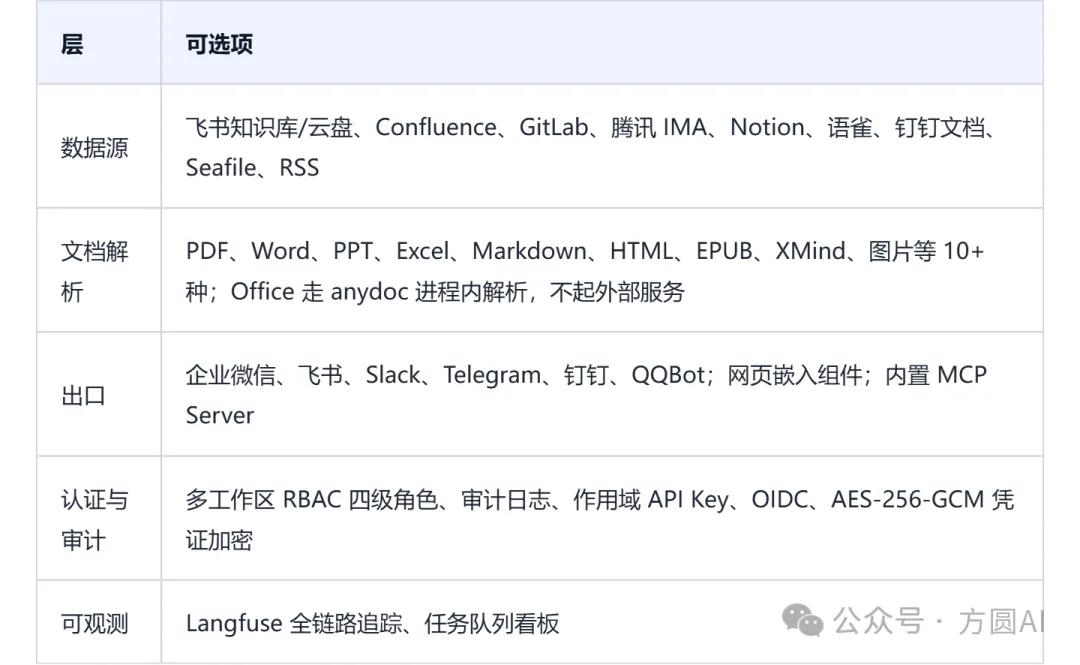
MCP Server 这一项值得单独点出:Cursor、Claude 可以直接把 WeKnora 当 tool 调。知识库从"一个网页"变成"一个 endpoint"。
六、部署与 CLI
代码示例(bash):
git clone https://github.com/Tencent/WeKnora.git cd WeKnora cp .env.example .env docker compose pull && docker compose up -d默认只起核心服务,Neo4j / MinIO / Langfuse 按 “--profile” 开。另有 Helm Chart(K8s)、Lite 单二进制(SQLite + 内存队列,零外部依赖)、桌面版(自行编译)。官方建议内网部署,不暴露公网。
CLI 是按 Agent 优先设计的,这点很少见:
- 默认输出 JSON,不是给人看的表格
- 错误码映射到 exit code,脚本里直接判断
- “weknora mcp serve” 把自己变成 MCP Server
配套还有 Chrome 剪藏扩展、微信小程序、Go SDK、面向 DeepSeek Harness 的只读插件。文档覆盖约 360 个 API 端点、150 个环境变量。
七、哪里要留神
- Agent 的自动写入权限和浏览器操控是真实风险面。默认从只读起步,跑熟再放。
- 完整版依赖链不短:PostgreSQL、Redis、可选 Neo4j/MinIO/Langfuse。个人用直接 Lite。
- BrowserSkill 需要一台带 GUI 浏览器的机器常驻,服务器部署要另想办法。
- 360 个 API、150 个环境变量,学习曲线不平,要有读文档的心理准备。
八、适合谁
文档散落在飞书、Confluence、GitLab 多个平台,想在 IM 和 IDE 里直接用,又需要权限隔离和审计的团队——WeKnora 把拼图一次给齐。想要现成 Agent 基础设施(沙箱、技能、MCP、浏览器、检查点)而不想从零搭的技术团队——这套底座直接可用。
只是本地问几份 PDF 的,Lite 版够了,别上完整版。
WeKnora 的价值不在检索做得多好,而在于它把知识库从 query endpoint 变成了可编程的基础设施。调用方式从一种变三种,这才是第三代的分水岭。