ARTICLE · 1359780
pdf-inspector 让 PDF 转 Markdown 提速 36 倍:200 篇 0.47 秒跑完
一、开篇:每个 PDF 都先过一遍 OCR,钱包真的扛不住
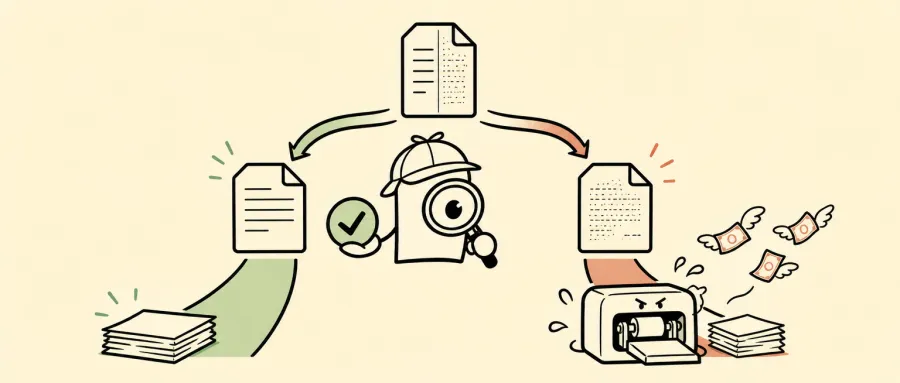
做 PDF 解析的团队都踩过同一个坑:用户上传的合同、论文、报告里,有一半本身就是带文字层的,剩下才是真正需要 OCR 的扫描件。但传统流程不管三七二十一,先把所有 PDF 塞进 OCR 服务。结果就是:54% 的文本型 PDF 走了一段昂贵又缓慢的弯路,账单和延迟一起往上涨。
更糟的是,OCR 引擎对扫描质量差的文档也常常翻车,识别率一塌糊涂,还得返工。如果有个工具能在 200ms 内告诉你「这个 PDF 不需要 OCR」,整条流水线立刻省心。firecrawl/pdf-inspector 做的就是这件事。
二、项目简介:用一句话概括
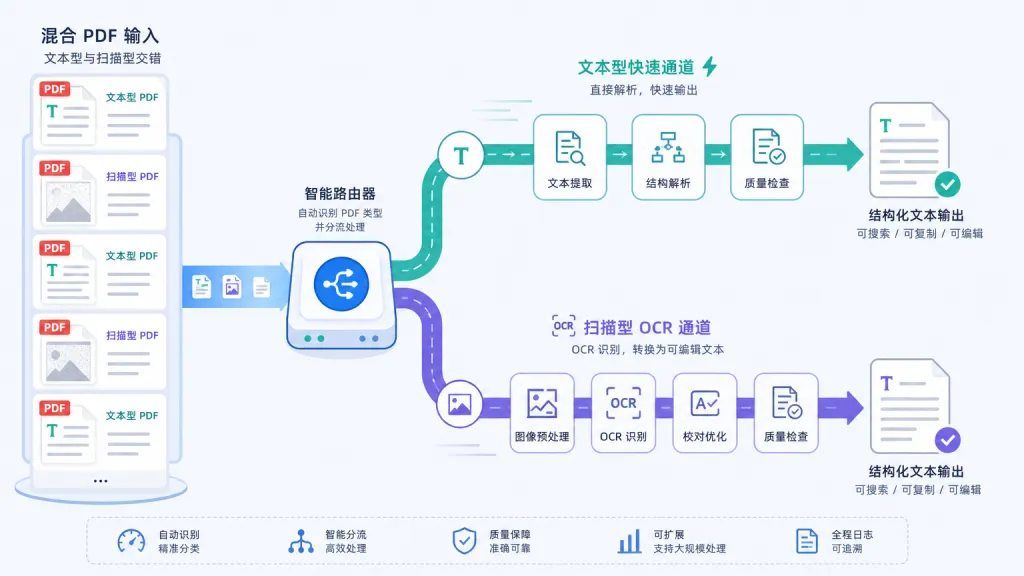
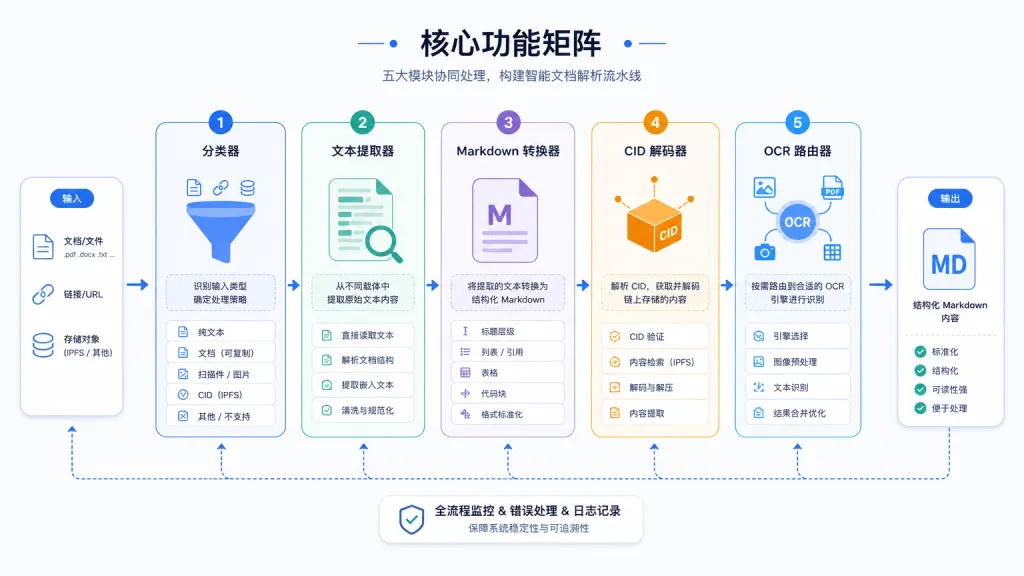
pdf-inspector 是 Firecrawl 开源的 Rust PDF 处理库,核心能力三件套:智能分类(文本型 / 扫描型 / 图像型 / 混合型)、位置感知的文本提取、结构化 Markdown 转换。它同时提供 Python、Node.js、浏览器 WebAssembly 多语言绑定,GitHub 已斩获 16.7K Stars,被官方定位为「本地处理文本型 PDF 的快路径」。
三、核心功能深度解析
1. 毫秒级智能分类
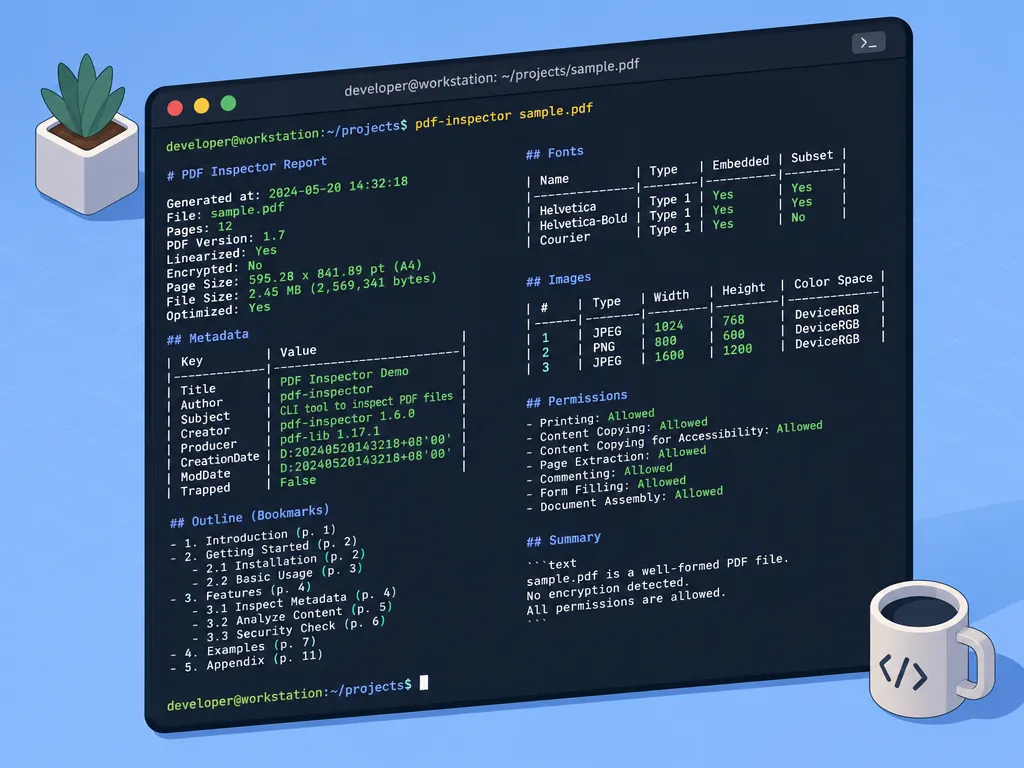
pdf-inspector 不一次性加载整个文档,而是先解析 xref 表和页树,再采样内容流里的 Tj/TJ 文本算子和 Do 图像算子。一次分类仅需 10–50ms,同时给出 0.0–1.0 的置信度,以及具体哪几页缺文字、需要走 OCR。这种「按页路由」的能力,让 300 页的 PDF 也能瞬间分流。
2. 位置感知的文本提取
提取阶段不仅拿字符串,还附带 X/Y 坐标、字体名、字号、加粗、斜体、下划线元数据。下游做阅读顺序推断、表格识别、标题分级时,这些信息是刚需。多列版式(报纸风格)自动合并,RTL 文字、跨页续表、跨页连字符都能正确处理。
3. 结构化 Markdown 转换
直接吐出干净 Markdown,省去后处理:标题通过字号层级识别(H1–H4),代码块识别 Courier、JetBrains Mono 等等宽字体,表格用矩形检测 + 对齐启发式双路识别,财务报表的合并数值会自动拆分。URL 转链接、TOC 点导引线折叠成「...」、图片自动留占位符——开箱即用。
4. CID 字体解码与编码异常兜底
Type0 / Identity-H 这类 CID 编码字体是中文 PDF 的重灾区。pdf-inspector 内置 ToUnicode CMap 解析,支持 UTF-16BE、UTF-8、Latin-1,遇到解码失败的字体还能主动标记,提示调用方「这一页建议走 OCR」。
5. 按需 OCR 与多端部署
Rust 和 CLI 用户可通过 --features ocr 接入 PP-OCRv6 Small,只对被路由的页面渲染识别;Python/Node 原生包内建 OCR 流程;浏览器端靠 WebAssembly + 内嵌 CMap,无需服务器往返就能本地解析。OCR 资源(PDFium、ONNX Runtime、模型文件)默认不加载,只在路由到 OCR 时才启用——这意味着纯文本 PDF 场景零额外依赖。
四、技术亮点与性能数据
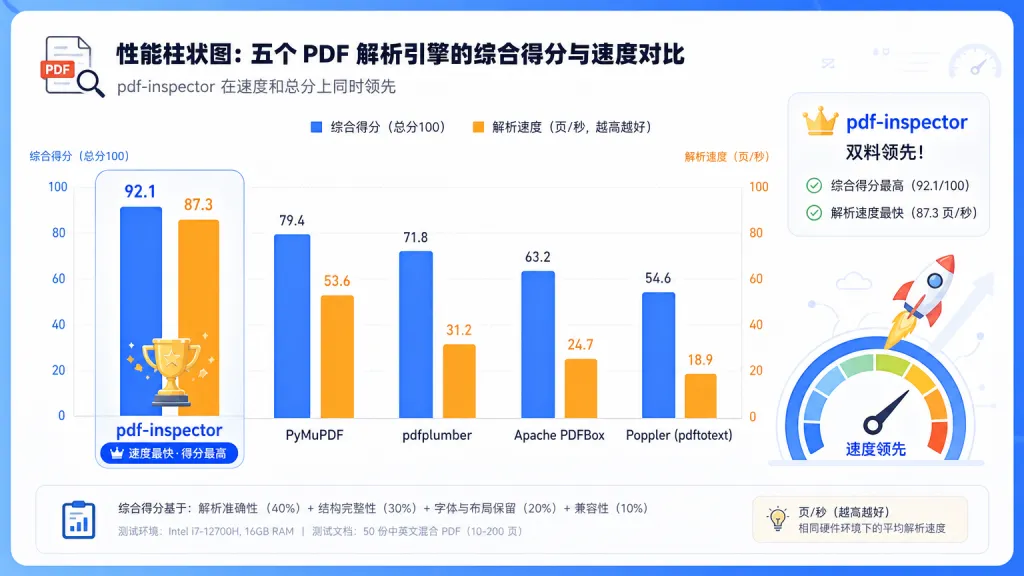
在 opendataloader-bench 200 篇 PDF 语料上(Apple M4 Pro,关闭 OCR,仅本地引擎对比),pdf-inspector 综合得分 0.875,位列第一:
阅读顺序 NID:0.915 表格 TEDS:0.814 200 篇文档中位耗时:0.470s(比第二名 LiteParse 快 60%,比 PyMuPDF4LLM 快 36 倍)
架构上,单次 load_document 同时被检测和提取阶段共享,杜绝重复 I/O;表格检测用并查集做矩形合并,再叠加文本对齐启发式,鲁棒性显著优于纯矩形方案;模块拆分清晰(detector / extractor / tables / markdown),便于独立替换和单测。
五、适用场景与人群
适合谁:
爬虫与文档采集团队:Firecrawl 官方出品,处理大批量混合 PDF 时省 OCR 费用立竿见影。 RAG / 知识库开发者:需要干净 Markdown 与表格结构喂给 LLM 的场景。 金融 / 法律 / 政务系统:财务报表、合同、判决书以文本型 PDF 为主,速度和表格准确率直接决定业务可用性。 浏览器端 PDF 预览与摘要:WebAssembly 包让前端离线解析成为可能,保护用户隐私。
不太适合:完全只有扫描件图片库、需要高保真版面还原(建议配合版面分析专用库)。
六、竞品对比
| 0.875 | 0.915 | 0.814 | 0.470s | ||
| 0.811 | |||||
相比 LiteParse,速度快 60%、表格分高 12 个点;相比 PyMuPDF4LLM 和 MarkItDown,速度快 30 倍以上,且头部 4 项指标全面碾压。再加上原生多语言绑定 + 按需 OCR 的工程设计,综合优势明显。
七、如何快速上手
Python 一行安装:
pip install pdf-inspectorimport pdf_inspectorresult = pdf_inspector.process_pdf("document.pdf")print(result.pdf_type) # "text_based" / "scanned" / "image_based" / "mixed"print(result.markdown)Node.js:
npm install @firecrawl/pdf-inspectorimport { processPdf } from'@firecrawl/pdf-inspector';const result = processPdf(readFileSync("document.pdf"));console.log(result.pdfType, result.markdown);Rust:
cargo add pdf-inspectorCLI 党直接 cargo install pdf-inspector 拿到 pdf2md 和 detect-pdf,支持 --json、--compact、--select-pages、--ocr auto 等参数。OCR 集成需要在 cargo install 时加 --features ocr,并配置 PDFIUM_LIB_PATH 和 ORT_DYLIB_PATH,纯文本场景完全不踩这些坑。
进阶建议:生产环境先用 detect-pdf --analyze --json 摸清 PDF 类型分布,再决定是否开启 OCR 资源预热。
八、总结与行动建议
pdf-inspector 用 Rust + 单次文档加载,把 PDF 分类做到了 10–50ms,把 Markdown 提取做到了亚秒级 200 篇,综合得分在开源引擎里登顶,同时提供 Python / Node / WASM 全栈绑定和按需 OCR。对每天处理上千份 PDF 的团队来说,它是少有的「装上就能省 OCR 钱」的现成方案。
项目地址:
GitHub:https://github.com/firecrawl/pdf-inspector 文档站:https://firecrawl.github.io/pdf-inspector/ PyPI:https://pypi.org/project/pdf-inspector/ npm:https://www.npmjs.com/package/@firecrawl/pdf-inspector
一句话安利:与其让所有 PDF 都排队等 OCR,不如让 pdf-inspector 先花 20ms 把它们分个流——文本型的 150ms 内出 Markdown,扫描型的再走重武器。
#pdf-inspector #PdfInspector #firecrawl #DevOps #容器化 #开源项目 #GitHub