ARTICLE · 1395360
需求评审提示模板 —— 怎么判断一份需求「写清楚了没有」
第15集|需求评审提示模板 —— 怎么判断一份需求「写清楚了没有」
第15集 · AI智能体落地实战笔记系列配套阅读:第14集 合同审阅提示模板 · 第13集 数据分析提示模板 · 第12集 评估集怎么建
配套视频(全 1 集)
第15集《需求评审提示模板:可验收是唯一重要的事》· 6:00
开篇:一份写了三页的需求,开发问了一个问题,然后卡了两周
需求评审是所有模板里最「软」的一个。
数据分析和合同审阅都有明确的判据——数字对不对、条款有没有坑。需求评审没有。它评的是「这句话清楚吗」,而「清楚」这件事:
产品经理觉得自己写清楚了 开发觉得没写清楚 双方都觉得自己没问题 最后靠会议和加班解决
我见过一个真实案例。需求文档写了三页,描述很完整,功能点列了 17 条。开发看完问了一个问题:
「用户点了『导出』之后,如果数据是空的,页面显示什么?」
产品经理说:「……这个我没想到。」
这两周就是这么卡住的。
但真正的问题不是「没想到空数据」。而是:
这份需求从头到尾,没有任何一个地方是可以被验证的。
没有验收标准 → 没法写测试 → 没法判断做完了没有 → 没法估工期 → 没法验收 → 只能靠人盯。
一句更扎心的判断
需求评审的判据可以压缩成一句话:
能不能为它写出至少一条验收用例。
写不出来 → 需求没写清楚。
写得出来 → 剩下的都是细节,评审的重点应该是「写得对不对」,而不是「写得全不全」。
这一篇要给你的东西:
一套可验收性检查表,10 条,每条都能当场判定 四种「看起来清楚但实际不可验收」的写法,附改法 追问清单——模型帮你把需求里说不清的地方问出来 输出契约:需求缺陷 + 追问清单 + 可验收性评分 一份能用的评估集
一、需求评审跟其他模板的根本差异
在给模板之前,先说清楚这个任务的特殊性。
1.1 三个差异
第三行是最关键的。
需求评审的产出如果只是「这份需求有 12 个问题」,那价值有限——产品经理拿到这句话,还是不知道该改什么。
真正有用的输出是:
「第 3 条『快速导出』不可验收,因为没说清导出格式。请产品经理补充:导出文件的格式、字段范围、单次最大数据量。」
每一条问题都要附带「要补什么信息才能验收」。这才是可直接行动的建议。
1.2 为什么「可验收」是唯一重要的事
我算过一笔账。假设一份需求有 12 个功能点:
可验收性几乎线性决定了开发成本。而它跟「描述得详细不详细」关系不大——
一份需求可以写得很长、很认真、格式很规范,但如果每一条功能点都没写清「做完是什么样」,它依然不可验收。
长度不等于清晰度,可验证性才是。
一份 200 字的需求,每条功能点都有明确的验收用例,比一份 3000 字但都是形容词的需求有用得多。
1.3 一个反直觉的推论
既然可验收性是唯一判据,那么:
评审的时候,不该问「这个功能描述清楚了吗」,该问「这个功能做完之后长什么样,你能指给我看吗」。
这个转换把主观争论变成了可操作的具体问题。开发问「导出空数据显示什么」,产品经理答不上来——这个瞬间,需求缺陷就暴露了,不需要再讨论「写清楚了没有」。
二、可验收性检查表:10 条
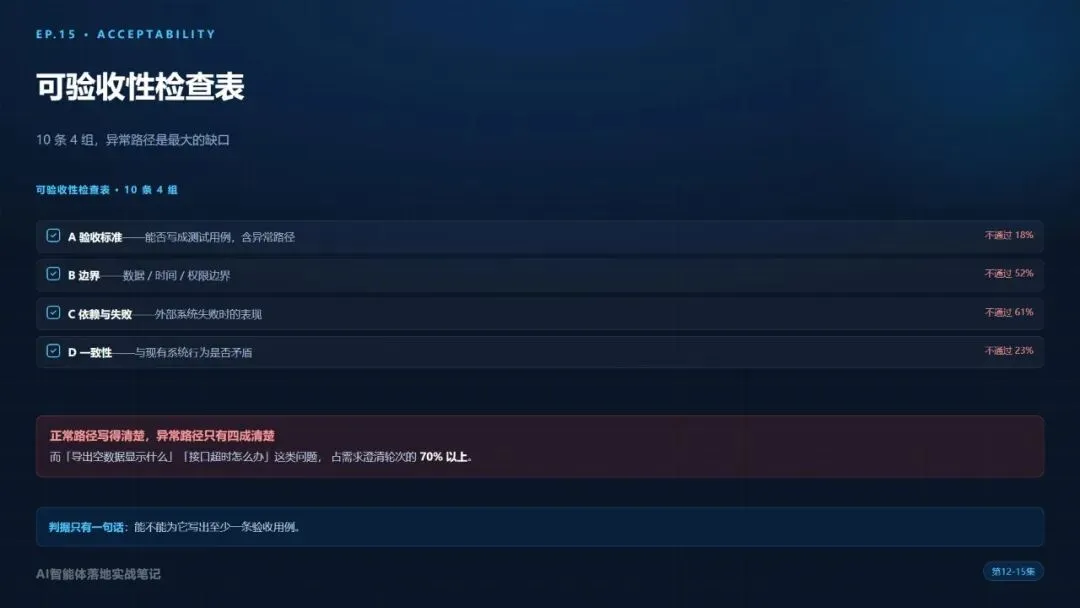
这 10 条是可直接拿到评审会上用的。每条都是二元判定——满足或不满足,不给「基本清晰」这种中间态。
ACCEPTABILITY_CHECKLIST = ”””【可验收性检查表】逐条检查,每条给出「通过 / 不通过 / 部分通过」+ 依据。【A. 验收标准是否可写成测试用例】A1. 每条功能点都有明确的「做完是什么样」的描述(不是「支持导出」,而是「导出 CSV,包含订单号/金额/状态三列」)A2. 每条功能点都有可判断真假的条件(能回答「什么情况算做到了」)A3. 正常路径之外,异常路径的行为也有说明(空数据、超时、并发、越权)【B. 边界是否明确】B1. 数据范围明确(数量上限、字符长度、格式约束)B2. 时间边界明确(超时是多久、重试几次、什么时候算失败)B3. 角色/权限边界明确(谁能做、谁不能看、越权时什么表现)【C. 依赖与失败处理】C1. 依赖的外部系统明确,且失败时的表现有说明C2. 数据从哪来、什么时候来、不来的时候怎么办有说明C3. 是否需要人工介入的环节明确【D. 一致性】D1. 与现有系统的行为不矛盾(不重复已有的功能、不改已有规则)D2. 术语与现有系统/文档一致(同名词是否同义)【说明】- 「部分通过」必须说明哪部分清楚、哪部分不清楚- 「不通过」必须给出需要补充什么信息- A1/A2/A3 任一不通过 → 该功能点整体判定为「不可验收」”””
2.1 为什么异常路径是最容易漏的
看 A3、B2、C1 这三条——它们全在问异常。
我统计过真实的评审记录:
正常路径写清楚的概率很高,异常路径写清楚的概率只有四成。
而异常路径恰恰是开发最常问、返工最集中的地方。「导出空数据显示什么」「接口超时怎么办」这类问题,占需求澄清轮次的 70% 以上。
2.2 一个可验收 vs 不可验收的对照
右边的写法有个共同特征:每一条都能写成一个断言。
# 右边每一条对应的测试用例def test_export_csv():result = export(order_ids=make_orders(10000))assert result.headers == [”订单号”, ”金额”, ”下单时间”]assert len(result.rows) == 10000def test_export_over_limit():result = export(order_ids=make_orders(10001))assert result.pages == 2assert ”p2” in result.filenamedef test_search_case_insensitive():result = search(”ORDER”)assert all(highlighted(r.name) for r in result.items)
如果你能写出这个测试用例,需求就是可验收的。这是一个可以直接教给产品经理的判据。
2.3 边界清单:直接给产品经理用
产品经理最需要的是这个——一份可以直接对照填的边界清单。
BOUNDARY_TEMPLATE = ”””【边界确认清单】请对每个功能点填写以下内容。填不出来的项,说明该处尚不可验收。功能点:{功能点名称}1. 数据边界- 单次操作最多处理多少条?- 单个字段最长多少字符?- 支持哪些格式?(如:仅 CSV / CSV+Excel)- 超出边界时的表现?(截断 / 分页 / 拒绝并提示)2. 时间边界- 超时阈值是多少?- 重试几次?- 什么情况算失败?- 失败后用户看到什么?3. 权限边界- 哪些角色可以操作?- 谁能看数据,谁只能看统计?- 越权访问返回什么?4. 数据依赖- 数据从哪个系统来?- 什么时候来?(实时 / T+1 / 手动上传)- 数据没到时怎么办?5. 空/异常状态- 没有数据时显示什么?- 单条数据字段缺失时显示什么?- 用户中途取消会怎样?”””
这份清单的价值在于:它把「你要想清楚」变成了「你要填表」。
产品经理抗拒「多写文档」,但很难抗拒「填空题」。
三、四种「看起来清楚但实际不可验收」的写法
这四种是评审中最常见的「假清楚」。
3.1 第一种:形容词代替条件
长相:
「界面要简洁美观」「响应要快」「体验要流畅」「性能要好」
为什么不可验收:
「美观」和「快」没有可判断的条件。开发做完了,你说不好看,他说按规范做的。双方都无法判定谁对。
改法:换成可观察的条件。
# ❌”首页加载要快”# ✅”首页首屏 P95 ≤ 1.5s,数据接口超时 3s 显示骨架屏 + 重试按钮”
通用的改写公式:
形容词 → 数值 + 条件 + 超限表现
3.2 第二种:用功能名代替规则
长相:
「支持用户权限管理」「支持订单导出」「支持消息推送」
为什么不可验收:
功能名是目录,不是规则。当开发问「权限有哪几种角色」「导出的字段有哪些」时,文档里没有答案。
改法:功能名后面必须跟规则表。
# ❌”支持用户权限管理”# ✅”支持用户权限管理,角色分三种:- 管理员:全部功能- 运营:除【用户管理】外全部- 客服:仅【订单查询】和【售后申请】权限变更立即生效,不需重新登录”
判断方法:如果一个功能名可以后面跟「等」「等等」,那它就是没写完的。
3.3 第三种:把责任推给「系统」
长相:
「系统自动处理」「系统自动同步」「系统自动提醒」
为什么不可验收:
「自动」没有指定触发条件、时机、失败处理。开发实现的时候要自己猜,猜错就返工。
改法:把「自动」拆成「什么时候 + 做什么 + 失败怎么办」。
# ❌”系统自动提醒用户订单超时未支付”# ✅”订单创建 30 分钟后仍未支付,触发站内信提醒;触发时机由定时任务每 5 分钟扫描一次;发送失败重试 3 次,仍失败则记录日志并在次日补发”
3.4 第四种:把「验收」外包给测试
长相:
「具体细节由测试同学补充」
为什么不可验收:
测试补充的是「怎么测」,不是「做成什么样」。验收标准是产品责任,不能下放。
改法:由产品给出结果状态,测试来设计路径。
# ❌”错误提示的具体文案由测试补充”# ✅”登录失败时提示「账号或密码错误」,不区分具体原因;5 分钟内连续失败 5 次锁定账号 15 分钟;锁定期间提示「尝试次数过多,请 15 分钟后再试」”
3.5 四种写法的对照表
四、追问清单:模型帮你把说不清的地方问出来
需求评审的产出核心是追问清单。这一节讲怎么让模型生成「有价值的追问」。
4.1 无效追问 vs 有效追问
模型很容易生成一堆无用的追问:
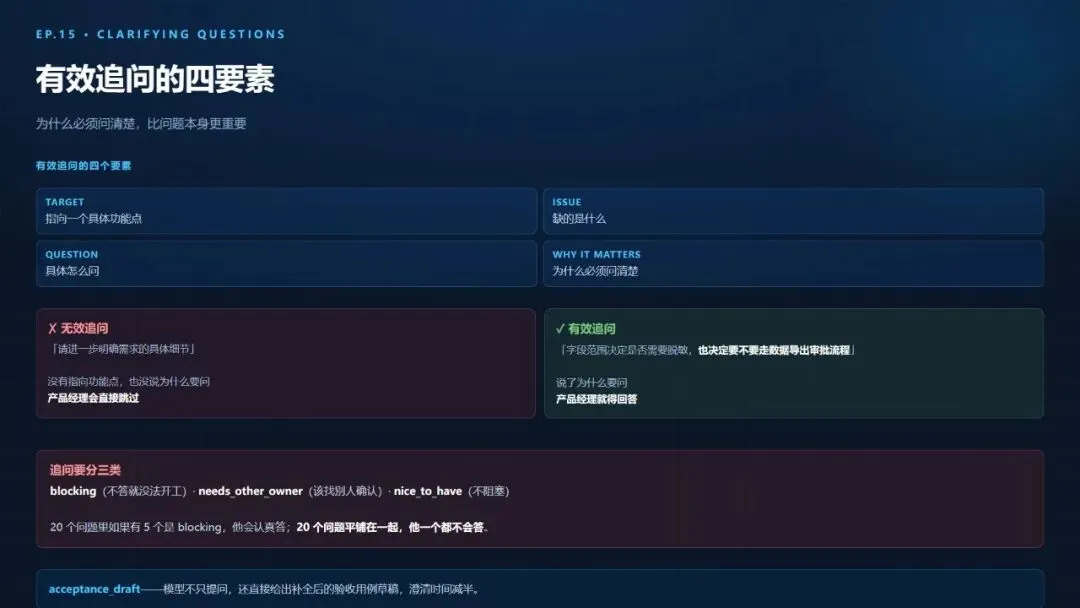
# ❌ 无效追问”请进一步明确用户需求的具体细节。””这个功能的实现方式是什么?””请补充更多背景信息。”
这些问题的共同特征:没有指向任何具体的功能点,也没有说明为什么要问。
# ✅ 有效追问{”target”: ”功能点 3『批量导出』”,”issue”: ”未说明导出的字段范围”,”question”: ”导出文件包含哪些字段?是否包含客户联系方式等敏感字段?”,”why_it_matters”: ”字段范围决定了是否需要脱敏处理,以及要不要走数据导出审批流程”,”blocking”: true}
四个要素:target(指向具体功能点)、issue(缺什么)、question(具体怎么问)、why_it_matters(为什么必须问清楚)。
why_it_matters是最容易被忽略但最重要的字段。它决定了产品经理会不会认真回答。
如果模型说「请补充功能点 3 的细节」,产品经理会跳过。如果模型说「字段范围决定要不要走数据导出审批流程」,产品经理就得回答。
4.2 追问清单的生成方式
CLARIFY_PROMPT = ”””【任务】基于【可验收性检查表】,找出需求中不可验收的部分,生成追问清单。【追问必须满足的要求】1. 每条追问指向一个具体的功能点(用原文的功能点编号/名称)2. 每条追问是一个具体问题,不是「请明确」「请补充细节」这类空泛要求3. 每条追问必须说明「为什么这个必须明确」(对开发/测试/业务的影响)4. 按「阻塞程度」排序:影响实现方案的排前面,影响细节的排后面【追问数量】最多 12 条。超过 12 条说明需求问题太多,应该先整体重构而不是逐条澄清。【不要问的】- 需求文档里已经明确回答了的- 纯技术实现选择(应该由开发决定)- 需求方无法回答的(应该找其他人确认)”””
「最多 12 条」这个限制很重要。不限制的话模型会列 30 条,产品经理看到 30 条问题的第一反应是「这需求没法做了」——然后逃避澄清。
限到 12 条以内,它就变成一个可以逐条过的清单。
4.3 一个必须加的规则:不要问需求方答不了的问题
”不要问需求方无法回答的问题。如果某个信息需要产品经理确认「是否已与某方对齐」,应该直接列为『需补充的业务背景』而不是追问。”
举例:需求写「对接第三方物流接口」。模型追问「第三方接口的具体字段是什么?」——产品经理不知道,那是技术对接的事。
这种追问会浪费产品经理的时间,并让他觉得这个工具没用。
正确的处理是把它归到另一类输出:
{”type”: ”needs_other_owner”,”item”: ”第三方物流接口的字段契约”,”owner”: ”技术对接人”,”why_it_matters”: ”字段不确定无法估算对接工作量”}
4.4 输出分成三类
OUTPUT_CATEGORIES = {”blocking”: ”需求方可回答,且不回答就没法开工”,”needs_other_owner”: ”需要其他人确认,需求方答不了”,”nice_to_have”: ”澄清更好,但不阻塞开工”,}
分三类是需求评审产出最有用的设计。
因为产品经理的时间有限。20 个问题里如果有 5 个是 blocking,他会认真答;20 个问题平铺在一起,他一个都不会答。
五、完整模板
5.1 任务层
REQUIREMENT_TASK = ”””你是需求评审助手,协助产品经理/研发负责人判断一份需求是否可以进入开发。【评审目标】不是评判需求好不好,而是判断**它能不能被验收**。【核心判据】每条功能点能否写出至少一条可执行的验收用例。能写出来 → 细节问题,评审重点是「写得对不对」。写不出来 → 阻塞问题,必须澄清后才能开工。【重要原则】- 每条问题必须指向具体功能点,不得泛泛而谈- 每个追问必须说明「为什么必须明确」- 不问需求方无法回答的问题- 追问总数不超过 12 条- 本输出为辅助评审参考,最终判断由产品与研发共同确认”””
「不是评判需求好不好,而是判断能不能被验收」——这句必须写进任务层。
不然模型会开始评价需求的价值、优先级、可行性,那不是这个工具该做的事。
5.2 输出契约
REQUIREMENT_FORMAT = ”””【输出格式】严格按以下 JSON 结构输出:{{”verdict”: {{”status”: ””,”acceptance_rate”: <0-100 的整数,可验收功能点百分比>,”one_line”: ”<一句话结论:能不能开工,卡在哪>”}},”function_points”: [{{”id”: ”<功能点编号>”,”name”: ”<功能点名称>”,”verdict”: ”<可验收 | 部分可验收 | 不可验收>”,”failed_checks”: [”<未通过的检查项编号,如 A1、B2>”],”reason”: ”<为什么不可验收,一句话>”}}],”questions”: [{{”target”: ”<指向的功能点>”,”issue”: ”<缺什么>”,”question”: ”<具体怎么问>”,”why_it_matters”: ”<为什么必须明确>”,”category”: ””}}],”other_owners”: [{{”item”: ”<需要谁确认什么>”, ”owner”: ”<角色>”, ”why_it_matters”: ”<影响>”}}],”acceptance_draft”: [{{”function_point”: ”<功能点>”,”given”: ”<前置条件>”,”when”: ”<操作>”,”then”: ”<可观察的结果,能写成断言>”}}]}}”””
acceptance_draft是一个特别有用的字段。
模型不只是指出「这里不清楚」,还给出补全后的验收用例草稿。
产品经理看到的是一个具体句子:
「导出功能:给定 100 条订单,当点击导出时,则生成含订单号/金额/下单时间三列的 CSV 文件」
他可以直接确认或修改,比回答「导出字段有哪些」快得多。
这是从「提问」到「给答案」的转变,效率提升非常明显。
5.3 示例层
REQUIREMENT_EXAMPLE = ”””【输出示例】(只示范格式,不要模仿推理过程)需求片段:「3. 支持批量导出订单数据,方便运营使用。」输出:{{”function_points”: [{{”id”: ”3”,”name”: ”批量导出订单数据”,”verdict”: ”不可验收”,”failed_checks”: [”A1”, ”A2”, ”B1”, ”A3”],”reason”: ”未说明导出格式、字段范围、数据量上限,且未定义无数据时的表现”}}],”questions”: [{{”target”: ”功能点 3『批量导出订单数据』”,”issue”: ”导出文件的格式与字段范围未定义”,”question”: ”导出文件是什么格式(CSV/Excel)?包含哪些字段?是否包含客户手机号等敏感信息?”,”why_it_matters”: ”字段范围决定是否需要脱敏,也决定要不要走数据导出审批流程”,”category”: ”blocking”}},{{”target”: ”功能点 3『批量导出订单数据』”,”issue”: ”单次导出数据量上限未定义”,”question”: ”单次最多导出多少条?超出后是截断、分页还是拒绝?”,”why_it_matters”: ”影响异步导出方案的选型,也影响前端是否需要进度条”,”category”: ”blocking”}}],”acceptance_draft”: [{{”function_point”: ”3”,”given”: ”用户已选中 100 条订单”,”when”: ”点击『批量导出』”,”then”: ”生成 CSV 文件,包含订单号、金额、下单时间三列,不含客户联系方式”}}]}}”””
注意acceptance_draft里模型自己补了一个假设(「不含客户联系方式」)——这个假设必须是明写的,不能藏在心里。
这样产品经理看到时会立刻说「不对,要包含」,比让他从零回答快。
5.4 组装
def build_requirement_prompt(requirement_text, context=None):parts = [REQUIREMENT_TASK,ACCEPTABILITY_CHECKLIST,BOUNDARY_TEMPLATE,”【需求文档】\n” + requirement_text,REQUIREMENT_FORMAT,REQUIREMENT_EXAMPLE,]if context:parts.insert(1, f”【业务背景】\n{context}”)return ”\n\n”.join(parts)
六、实现:一次跑通的可运行代码
6.1 校验:需求原文引用检查
跟第14集一样,引用的功能点必须在原文里。
# validate.pyimport reimport unicodedatadef normalize(s: str) -> str:if not s:return ””s = unicodedata.normalize(”NFKC”, s)s = re.sub(r”\s+”, ””, s)return sdef extract_function_points(requirement_text: str) -> list:”””从需求文档里抽取功能点。兼容几种常见写法:「1. 支持 xxx」 「1、xxx」 「### 1 xxx」 「1.1 xxx」”””points = []pat = re.compile(r”^\s*(?:#{1,4}\s*)?(\d+(?:\.\d+)*)\s*[.、))]?\s+(.{2,60})$”,re.M,)for m in pat.finditer(requirement_text):fid = m.group(1)name = m.group(2).strip()# 过滤掉明显的非功能点行(如「1. 需求背景」这种大标题)if len(name) < 4:continuepoints.append({”id”: fid, ”name”: name})return pointsdef validate_function_points(requirement_text: str, result: dict) -> list:”””校验模型提到的功能点是否真的在需求里”””errors = []real = extract_function_points(requirement_text)real_ids = {p[”id”] for p in real}real_names = {normalize(p[”name”]) for p in real}for fp in result.get(”function_points”, []):fid = fp.get(”id”, ””)name = normalize(fp.get(”name”, ””))if fid not in real_ids and name not in real_names:errors.append(f”功能点「{fp.get('id')} {fp.get('name', '')[:20]}」”f”在需求原文中找不到”)return errors
6.2 校验:追问必须指向存在的功能点
这是需求评审特有的校验。
def validate_questions(result: dict, real_ids: set) -> list:”””每条追问必须指向一个真实存在的功能点”””errors = []for q in result.get(”questions”, []):target = q.get(”target”, ””)# target 里应该包含功能点编号或名称ifnotany(fid in target for fid in real_ids):errors.append(f”追问「{q.get('question', '')[:30]}」未指向具体功能点”)if not q.get(”why_it_matters”, ””).strip():errors.append(f”追问「{q.get('question', '')[:30]}」缺少 why_it_matters”)if q.get(”category”) not in (”blocking”, ”needs_other_owner”, ”nice_to_have”):errors.append(f”追问「{q.get('question', '')[:30]}」category 非法”)# 追问数量限制n = len(result.get(”questions”, []))if n > 12:errors.append(f”追问数量 {n} 超过上限 12 条”)return errors
「追问必须指向存在的功能点」这一条能拦住大部分幻觉。模型很容易凭空发明一个「功能点 7. 数据看板」。
6.3 主流程
# review.pyimport jsonfrom pathlib import PathPROMPTS = Path(__file__).parent / ”prompts”def review_requirement(requirement_text: str, context: str = None,attempts: int = 2) -> dict:prompt = build_requirement_prompt(requirement_text, context)real_ids = {p[”id”] for p in extract_function_points(requirement_text)}for i in range(attempts):response = call_model(prompt, model=”gpt-5”, response_format=”json”)result = json.loads(response)errors = validate_function_points(requirement_text, result)errors += validate_questions(result, real_ids)if not errors:result[”_summary”] = summarize(result)return resultprint(f”第 {i+1} 次校验失败:{errors}”)prompt += f”””【校验错误,请修正】{chr(10).join('- ' + e for e in errors)}请重新输出完整 JSON。- function_points 的 id 必须是【需求文档】中真实存在的编号- questions 的 target 必须包含一个真实存在的功能点编号- questions 必须有 why_it_matters 和合法的 category- questions 不超过 12 条”””raise ValueError(”校验未通过,需人工介入”)def summarize(result: dict) -> str:”””给界面用的一句话摘要”””v = result[”verdict”]status_map = {”ready”: ”可进入开发”,”needs_clarification”: ”需澄清后开工”,”needs_rewrite”: ”建议整体重构”,}blocking = sum(1 for q in result.get(”questions”, [])if q.get(”category”) == ”blocking”)return (f”{status_map.get(v['status'], v['status'])}|”f”可验收率 {v['acceptance_rate']}%|”f”阻塞问题 {blocking} 条|{v['one_line']}”)
6.4 一致性校验:与现有系统不矛盾
D1 这条检查需要额外信息——现有系统的行为。
# consistency.pydef check_consistency(requirement_text: str, existing_behaviors: list) -> list:”””检查需求是否与现有系统行为矛盾existing_behaviors: [{”name”: ”菜单项”, ”current”: ”当前位置”}, ...]”””conflicts = []req_norm = normalize(requirement_text)for b in existing_behaviors:# 简单的关键词共现检测(生产环境应换成 embedding 检索)for kw in b.get(”keywords”, []):if kw in req_norm and b.get(”current”):conflicts.append({”item”: b[”name”],”current_behavior”: b[”current”],”requirement_mentions”: kw,”need_confirm”: f”需求中提到「{kw}」,与现有行为”f”「{b['current']}」是否冲突?”})return conflicts
这一层可以用第12集讲的那套思路做——从线上真实反馈里找矛盾点。
比如:已有系统里「导出」是管理员功能,新需求说「所有运营都能导出」——这就是冲突。
6.5 输出到评审会议用的格式
# to_meeting_format.pydef to_meeting_format(result: dict) -> str:”””把 JSON 转成评审会可以直接念的 markdown”””v = result[”verdict”]lines = []lines.append(f”## 需求评审结论:{v['status']}”)lines.append(f”**{v['one_line']}**”)lines.append(””)lines.append(f”可验收功能点:{v['acceptance_rate']}%”)lines.append(””)# 阻塞问题优先blocking = [q for q in result[”questions”] if q[”category”] == ”blocking”]other = [q for q in result[”questions”] if q[”category”] != ”blocking”]if blocking:lines.append(f”### 必须澄清({len(blocking)} 条)”)lines.append(””)for q in blocking:lines.append(f”- **{q['target']}**”)lines.append(f” - 问题:{q['issue']}”)lines.append(f” - 建议问法:{q['question']}”)lines.append(f” - 为什么重要:{q['why_it_matters']}”)lines.append(””)if other:lines.append(f”### 建议澄清({len(other)} 条)”)for q in other:lines.append(f”- {q['target']}:{q['question']}”)lines.append(””)drafts = result.get(”acceptance_draft”, [])if drafts:lines.append(”### 验收用例草稿(可直接确认或修改)”)lines.append(””)lines.append(”| 功能点 | Given | When | Then |”)lines.append(”|---|---|---|---|”)for d in drafts:lines.append(f”| {d['function_point']} | {d['given']} | {d['when']} | {d['then']} |”)lines.append(””)oo = result.get(”other_owners”, [])if oo:lines.append(”### 需其他人确认”)for o in oo:lines.append(f”- {o['item']} → {o['owner']}({o['why_it_matters']})”)return ”\n”.join(lines)
这个输出格式是给评审会用的。会议开始时把这段投屏,一行一行过。
跟「丢给产品经理自己看 JSON」相比,会议效率差很多——因为会上要的是「现在过哪一条」,不是「一坨结构化数据」。
七、一套能用的需求评审评估集
7.1 分桶
按**「缺什么」**分桶,这是需求评审唯一有效的分法。
REQ_BUCKETS = {”缺验收标准”: 25,# 正常路径写清楚了,验收条件模糊”缺边界”: 20,# 数据/时间/权限边界缺失”缺异常处理”: 20,# 异常路径完全没写”术语不一致”: 15,# 与现有系统名词/行为矛盾”隐含假设”: 10,# 依赖未言明的假设”过度简略”: 10,# 一句话需求,几乎无法验收}
7.2 rubric
REQ_RUBRIC = ”””你是需求评审质量评审专家。评估一份需求评审报告的质量,1-5 分。【5 分】产品经理可以直接用它开会:- 每条问题都指向具体功能点,无泛泛而谈- 每条追问都有 why_it_matters,产品经理知道为什么要答- 追问按 blocking / needs_other_owner / nice_to_have 正确分类- blocking 数量控制在合理范围(5-12 条),不是把所有问题都标 blocking- acceptance_draft 的验收用例可直接写成测试,且假设是明写的- 检出需求中的关键缺失(空数据、超时、权限)- 未发明需求里不存在的功能点【4 分】基本可用:- 个别追问缺 why_it_matters,或分类不够准确【3 分】有明显缺陷:- 追问泛泛而谈(如”请明确细节”),或- 把非阻塞问题标成 blocking(导致产品经理放弃),或- 漏掉关键缺失项(尤其是空数据/超时/权限)【2 分】只有清单没有价值:- 问题是通用的(任何需求都能套上)- 没有 why_it_matters- acceptance_draft 是空的或不可用【1 分】不可用:- 发明了不存在的功能点,或- 未做可验收性判断(只复述需求),或- 格式不符合契约【硬性要求】- 不因问题条数多而加分。20 条泛泛而谈不如 5 条切中要害。- 不因措辞专业而加分。只评估”产品经理能不能直接用这个开会”。”””
7.3 金标准怎么标
需求评审的金标准有一个特点:要标「哪些地方其实可验收」。
GOLD_REQ = [{”id”: ”rq_003”,”function_point”: ”3”,”human_verdict”: ”可验收”,”human_reason”: ”功能点 3『支持批量导出订单数据』虽然只写了 12 个字,””但功能点 4『导出字段见附件 A』给出了完整字段清单,””合并后 A1/A2 通过。模型判定为不可验收属误报——””但模型的 acceptance_draft 漏掉了附件引用。”},{”id”: ”rq_008”,”function_point”: ”7”,”human_verdict”: ”不可验收”,”human_reason”: ”功能点 7『消息推送』未说明触发时机、失败处理、””以及用户关闭推送后的行为。A1/A3/C1 全部不通过,””且未检出『消息可被用户关闭』这个隐含假设。”}]
rq_003这个例子很关键:它标的是模型的误报——需求其实可验收(因为有附件),但模型漏看了。
这类误报在需求评审里很常见,因为模型只读需求正文,不读附件。
解法:把附件内容也放进上下文,并且在提示词里明确「附件内容已在【需求文档】中给出」。
八、七个必须避开的坑
8.1 坑一:让模型评判需求好不好
表现:输出「这个需求价值不高」「建议优先级下调」。
为什么不行:评审工具要做的是判断能不能开工,不是评价值不值得做。价值判断需要业务上下文,模型没有。
解法:任务层明确写「不是评判需求好不好,而是判断能不能被验收」。
8.2 坑二:追问泛泛而谈
表现:「请进一步明确功能细节」「请补充更多背景信息」。
解法:每条追问必须有 target + issue + question + why_it_matters 四个字段,缺一不可,代码校验。
8.3 坑三:不限制追问数量
表现:一次列 30 条问题,产品经理放弃。
解法:硬上限 12 条 + 按 blocking 排序。让产品经理先答最关键的 12 条。
8.4 坑四:所有问题都标 blocking
表现:20 条全是 blocking,等于没有优先级。
解法:rubric 里明确「把非阻塞问题标成 blocking 是严重问题」。
8.5 坑五:不问需求方答不了的问题
表现:追问「第三方接口的字段契约是什么」——产品经理不知道。
解法:分 questions 和 other_owners 两类,后者标明该找谁。
8.6 坑六:不读附件
表现:需求正文写「详见附件」,模型只读正文,判定大量不可验收。
解法:附件内容一起放进上下文。这是需求评审最常见的误报来源。
8.7 坑七:只有问题,没有草稿
表现:输出 12 条追问,产品经理要逐条回答,一轮澄清下来半小时。
解法:acceptance_draft 字段——模型直接给出补全后的验收用例草稿,产品经理只需确认或改。
这一个字段能把澄清时间减半。
8.8 对照表
other_owners | ||
acceptance_draft |
九、一页纸总结
核心原则
能不能为它写出至少一条验收用例。
写不出来 → 需求没写清楚。写得出来 → 剩下的都是细节,评审重点是「写得对不对」。
可验收性检查表:10 条 4 组
正常路径写得清楚,异常路径只有四成清楚——而异常路径占了澄清轮次的 70%。
四种「假清楚」
形容词代替条件 → 「美观」改成「数值 + 条件 + 超限表现」 功能名代替规则 → 「支持权限管理」改成附规则表 责任推给系统 → 「系统自动处理」改成「何时 + 做什么 + 失败怎么办」 验收外包给测试 → 产品给结果状态,测试设计路径
有效追问的四个字段
target(指向功能点)· issue(缺什么)· question(具体怎么问)·why_it_matters(为什么必须问)
why_it_matters决定产品经理会不会认真回答。
三类输出
questions— 需求方能答的,分 blocking / nice_to_have other_owners— 需要别人确认的,标明找谁 acceptance_draft— 模型直接给验收用例草稿,产品经理只需确认或改
三个必做的校验
引用的功能点在原文里存在(防幻觉) 追问指向真实功能点 + 有 why_it_matters + category 合法 追问总数 ≤ 12
【AI智能体落地实战笔记】第15集。高频业务提示模板系列到此完结:数据分析、合同审阅、需求评审。
下一篇预告:客户沟通提示模板—— 跟前面三个最大的不同是,它的输出不是给内部用的,是给外部看的。而「给外部看的输出」有一个额外约束:模型必须知道哪些话不能说。