 夜雨聆风
摘要
随着大型语言模型(LLM)驱动的AI代理系统在自主决策、工具调用和跨域交互方面的能力不断增强,其安全风险也呈现出前所未有的复杂性。本文基于ClawLess: A Security Model of AI Agents等最新研究成果,系统性地分析了AI代理系统的安全架构设计原则,深入探讨了特权分离(Privilege Separation)、能力边界控制(Capability Boundary Control)和多层次威胁防御机制。本文提出了一个形式化的安全模型框架,阐述了AI代理在不同执行环境中的权限管理策略,并分析了提示注入、工具滥用、权限提升等关键攻击向量的防御机制。研究表明,基于最小权限原则和深度隔离架构的安全模型能够有效降低AI代理系统的攻击面,为多代理协作环境中的安全性提供理论基础和工程实践指导。
关键词:AI代理安全、特权分离、能力边界、威胁模型、最小权限原则、安全架构
1. 引言
1.1 研究背景
AI代理(AI Agents)作为能够自主感知环境、做出决策并执行动作的智能系统,正在从简单的对话助手演进为能够操作外部工具、访问敏感数据、甚至控制物理设备的复杂系统。根据功能复杂度,现代AI代理可分为以下几类:
AI代理系统的核心架构通常包含以下组件:
• 感知层(Perception Layer):接收用户输入、环境状态 • 推理层(Reasoning Layer):基于LLM进行决策规划 • 执行层(Execution Layer):调用工具、执行动作 • 记忆层(Memory Layer):存储上下文、学习经验
1.2 安全挑战
AI代理系统面临的安全挑战具有独特性:
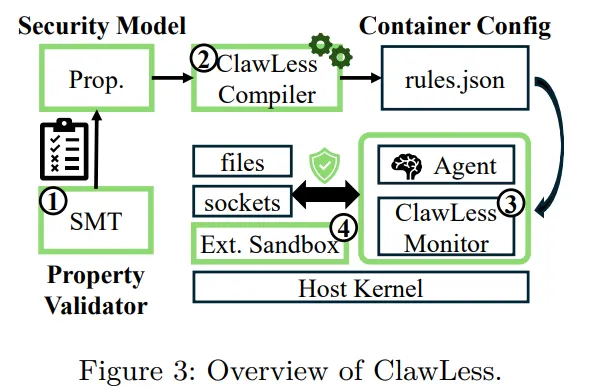
攻击面扩大化:传统软件系统的攻击面主要由代码漏洞定义,而AI代理的攻击面还包括自然语言输入空间。研究表明,提示注入攻击(Prompt Injection)可以在不修改代码的情况下改变代理行为[1]。
权限动态性:与传统应用的静态权限不同,AI代理可能根据上下文动态请求和执行高权限操作,这使得传统的访问控制模型难以适用。
意图识别困难:代理系统需要准确理解用户意图,但恶意输入可能伪装成合法请求,形成"诱导性指令遵循"(Induced Instruction Following)攻击。
1.3 研究目标
本文旨在:
1. 建立AI代理系统的形式化安全模型 2. 分析特权分离架构在AI代理中的应用 3. 提出多层次威胁防御机制 4. 探讨安全与功能性的权衡策略
2. 形式化安全模型
2.1 基本定义
定义 1(AI代理系统):一个AI代理系统 可表示为五元组:
其中:
• :状态空间,包含环境状态、记忆状态、执行上下文 • :可执行动作集合,包括工具调用、代码执行、通信等 • :状态转移函数 • :记忆系统,存储历史交互和学到的知识 • :策略函数,由LLM实现
定义 2(安全状态):状态 是安全的,当且仅当满足以下安全属性:
其中 表示动作 在状态 下被授权执行。
2.2 特权分离模型
特权分离(Privilege Separation)是降低系统攻击面的核心原则。我们将AI代理的特权层次形式化为:
定义 3(特权层):特权层 是一个偏序集合 ,其中:
• •
各特权层定义如下:
定义 4(特权提升函数):特权提升 是一个需要满足条件 的函数:
$$\uparrow(L_i, c) = \begin{cases}
L_{i+1} & \text{if } \text{Verify}(c) = \text{true} \land i < 3 \
L_i & \text{otherwise}
\end{cases}$$
其中 验证条件 是否满足,例如用户确认、多因素认证等。
2.3 能力边界控制
定义 5(能力边界):能力边界 定义了代理在特定状态下允许执行的操作子集:
能力函数定义为:
其中 是第 个风险评估因子, 是权重系数。
定理 1(安全执行保证):若代理系统 满足:
1. 初始状态 是安全的 2. 所有状态转移 都满足 3. 特权提升需要显式授权
则系统 的所有可达状态都是安全的。
证明:
使用数学归纳法。
• 基础: 是安全的(条件1) • 归纳:假设 安全,由条件2, 确保 安全 • 提升:由条件3,特权提升需显式授权,防止未授权的高权限操作
因此所有可达状态都是安全的。
3. 安全架构设计
3.1 分层隔离架构
基于特权分离原则,我们提出如图1所示的分层隔离架构:
┌─────────────────────────────────────────────────────────────┐
│                      用户交互层 (UI Layer)                    │
│                   输入过滤 & 意图解析                         │
└─────────────────────────────────────────────────────────────┘
                              │
                              ▼
┌─────────────────────────────────────────────────────────────┐
│                    策略决策层 (Policy Layer)                  │
│              LLM推理引擎 & 安全策略评估                        │
│  ┌─────────────────────────────────────────────────────┐    │
│  │  安全监控器 (Security Monitor)                       │    │
│  │  - 提示注入检测                                      │    │
│  │  - 意图一致性验证                                    │    │
│  │  - 敏感操作识别                                      │    │
│  └─────────────────────────────────────────────────────┘    │
└─────────────────────────────────────────────────────────────┘
                              │
              ┌───────────────┼───────────────┐
              ▼               ▼               ▼
┌─────────────────┐ ┌─────────────────┐ ┌─────────────────┐
│   沙箱执行环境   │ │   受限执行环境   │ │   特权执行环境   │
│   (Sandbox)     │ │  (Restricted)   │ │  (Privileged)   │
├─────────────────┤ ├─────────────────┤ ├─────────────────┤
│ • 纯计算操作     │ │ • 文件读取       │ │ • 代码执行       │
│ • 内存操作       │ │ • 网络查询       │ │ • 系统调用       │
│ • 字符串处理     │ │ • 数据库读       │ │ • 权限修改       │
└─────────────────┘ └─────────────────┘ └─────────────────┘
图1:分层隔离安全架构
3.2 零信任执行模型
我们采用零信任(Zero Trust)原则设计执行模型:
核心原则:
1. 永不信任,始终验证:每次操作都需验证权限 2. 最小权限:代理只能访问完成任务所需的最小资源集 3. 假设 breach:系统设计假设攻击者已部分入侵
执行流程:
输入 → [ sanitization ] → [ intent analysis ] → [ risk assessment ]
                                    ↓
                              [ policy check ]
                          ┌─────────┴─────────┐
                          ▼                   ▼
                    [ low risk ]         [ high risk ]
                          ↓                   ↓
                    [ direct exec ]      [ user confirm ]
                          ↓                   ↓
                    [ audit log ] ←────→ [ audit log ]
3.3 多代理协作安全
在多代理系统中,代理间的通信引入了额外的攻击向量。
定义 6(消息安全属性):代理 发送给 的消息 满足:
• 真实性: • 完整性: • 不可否认性:
安全通信协议:
其中 是时间戳, 是哈希函数, 是共享密钥。
4. 威胁模型与防御机制
4.1 攻击分类
我们系统性地分类AI代理面临的攻击:
4.2 提示注入防御
定义 7(提示注入攻击):攻击者通过构造特殊输入 ,使得:
其中 表示输入组合操作。
防御机制 1:语义隔离
将用户输入与系统指令在语义空间分离:
$$
\text{Decision} = \text{LLM}(\text{SystemPrompt} \parallel \text{Process}(x_{\text{user}}))$$
防御机制 2:多层过滤
def input_filter(user_input):
    # 第一层:语法检查
    if detect_delimiter_manipulation(user_input):
        return REJECT

    # 第二层:语义分析
    intent = analyze_intent(user_input)
    if intent.confidence < THRESHOLD:
        return REQUIRE_CONFIRMATION

    # 第三层:攻击模式匹配
    if match_known_attack_patterns(user_input):
        return REJECT

    return ACCEPT
防御机制 3:动态沙箱
对于高风险输入,在隔离环境中执行:
$$\text{Exec}_{\text{sandbox}}(a) = \begin{cases}
\text{Result} & \text{if } \text{Safe}(a) \
\text{Alert} \land \text{Block} & \text{otherwise}
\end{cases}$$
4.3 工具使用安全
参数验证策略:
对于工具 的参数 ,执行多维度验证:
其中验证维度包括:
• 类型检查: • 范围检查: • 语义检查: • 历史检查:
工具调用链分析:
对于复合工具调用序列 ,分析累积风险:
若 ,则要求用户确认。
5. 安全评估框架
5.1 评估指标
我们定义以下安全评估指标:
定义 8(攻击成功率):
定义 9(防御覆盖率):
定义 10(性能开销):
5.2 红队测试框架
建立系统化的红队测试方法论:
自动化攻击生成:
使用对抗性优化生成测试用例:
其中 是攻击成功度量函数。
测试覆盖矩阵:
6. 实践案例分析
6.1 代码执行代理安全设计
考虑一个能够执行Python代码的数据分析代理:
安全架构:
用户请求 → [自然语言理解] → [任务规划]
                              ↓
                    [风险等级评估]
                         ↓
              ┌──────────┴──────────┐
              ▼                     ▼
        [低风险代码]           [高风险代码]
              ↓                     ↓
    [受限Python环境]       [沙箱容器]
    • 无网络访问            • 完全隔离
    • 受限文件系统          • 资源限制
• 超时控制 • 审计日志实现要点:
• 使用seccomp-bpf限制系统调用 • 通过cgroups限制资源使用 • 实现代码静态分析预检查 • 所有执行记录审计日志
6.2 多代理协作系统安全
在企业自动化场景中,多个代理协作完成任务:
安全设计原则:
1. 代理身份认证:每个代理具有唯一身份标识和密钥 2. 最小通信:代理间仅共享必要信息 3. 职责分离:敏感操作需要多个代理共同授权 4. 全程审计:所有通信和决策记录不可篡改日志
授权矩阵示例:
7. 未来研究方向
7.1 形式化验证
当前的安全模型主要依赖于经验性验证,未来需要发展形式化验证方法:
• 建立AI代理系统的形式化规约语言 • 开发自动化安全性质验证工具 • 证明安全策略的完备性和一致性
7.2 自适应安全
研究能够根据威胁态势自适应调整的安全系统:
7.3 可解释安全决策
提升安全决策的可解释性:
• 为什么某个操作被拒绝? • 风险评分是如何计算的? • 如何证明系统没有偏见?
8. 结论
本文系统性地研究了AI代理系统的安全架构设计,提出了基于特权分离和能力边界控制的形式化安全模型。主要贡献包括:
1. 形式化安全模型:定义了AI代理系统的安全状态、特权层和能力边界,建立了安全执行的理论保证。 2. 分层隔离架构:设计了从沙箱到特权层的多层次执行环境,实现了最小权限原则。 3. 威胁防御机制:针对提示注入、工具滥用、权限提升等攻击向量,提出了多维度防御策略。 4. 评估框架:建立了攻击成功率、防御覆盖率、性能开销等多维度评估指标体系。
研究表明,通过合理的安全架构设计,可以在保障AI代理功能性的同时,有效控制安全风险。特权分离和零信任原则的应用,为多代理系统的安全性提供了坚实基础。
未来工作将聚焦于形式化验证、自适应安全和可解释安全决策等方向,以应对不断演进的AI安全威胁。
参考文献
[1] Lu H, Liu N, Wang S, et al. ClawLess: A Security Model of AI Agents. arXiv preprint arXiv:2604.06284, 2026.
[2] Perez F, Ribeiro I. Ignore This Title and HackAPrompt: Exposing Systemic Vulnerabilities of LLMs through a Global Scale Prompt Hacking Competition. EMNLP, 2023.
[3] Greshake K, Abdelnabi S, Mishra S, et al. Not What You've Signed Up For: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection. ACM CCS, 2023.
[4] Wu T, Xie R, Yang J, et al. Security of AI Agents. arXiv preprint arXiv:2406.08689, 2024.
[5] Hidayatullah A F, Pardede H, Budiardjo E K, et al. Large Language Model for Code Intelligence: Security and Privacy Issues. arXiv preprint arXiv:2504.01667, 2025.
[6] Chen Y, Su Y, Luo Q. A Survey on Tool Learning and Utilization with Large Language Models. arXiv preprint arXiv:2502.04270, 2025.