乐于分享
好东西不私藏

AI 数据日报 2026-05-22

AI 数据日报 2026-05-22

今日导读

方向

篇数

关键词

一、大模型训练数据

3

数据质量幻觉、数据混合相变、训练数据剪枝

二、数据基础设施

3

Parquet 读取重写、10B 向量搜索、PB 级自动驾驶数据湖

三、RAG 检索增强

3

多语言 Embedding、统一多模态检索、知识冲突检测

四、数据标注与评估

3

开源偏好数据集、全模态奖励模型、浅层偏好信号

五、多模态数据

3

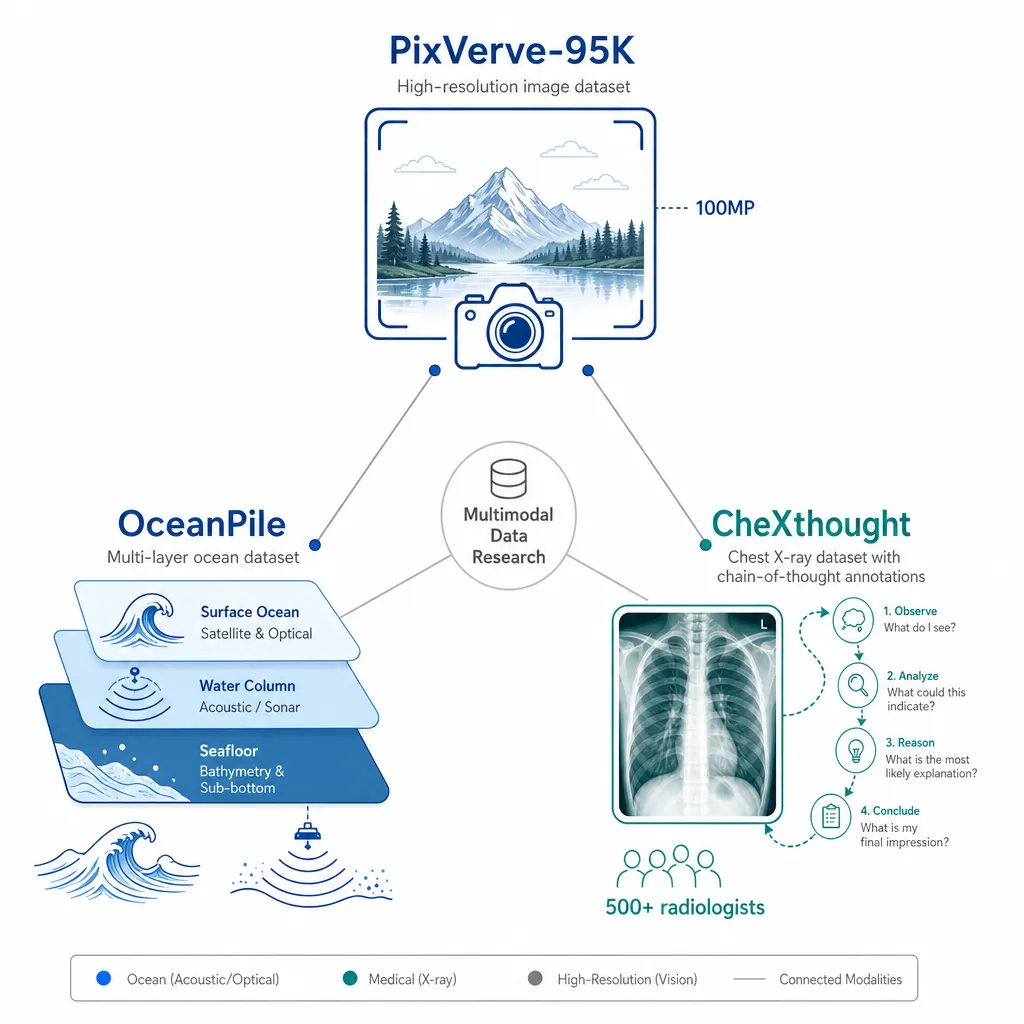
100MP 超高清数据集、海洋多模态语料、临床思维链数据集


一、大模型训练数据

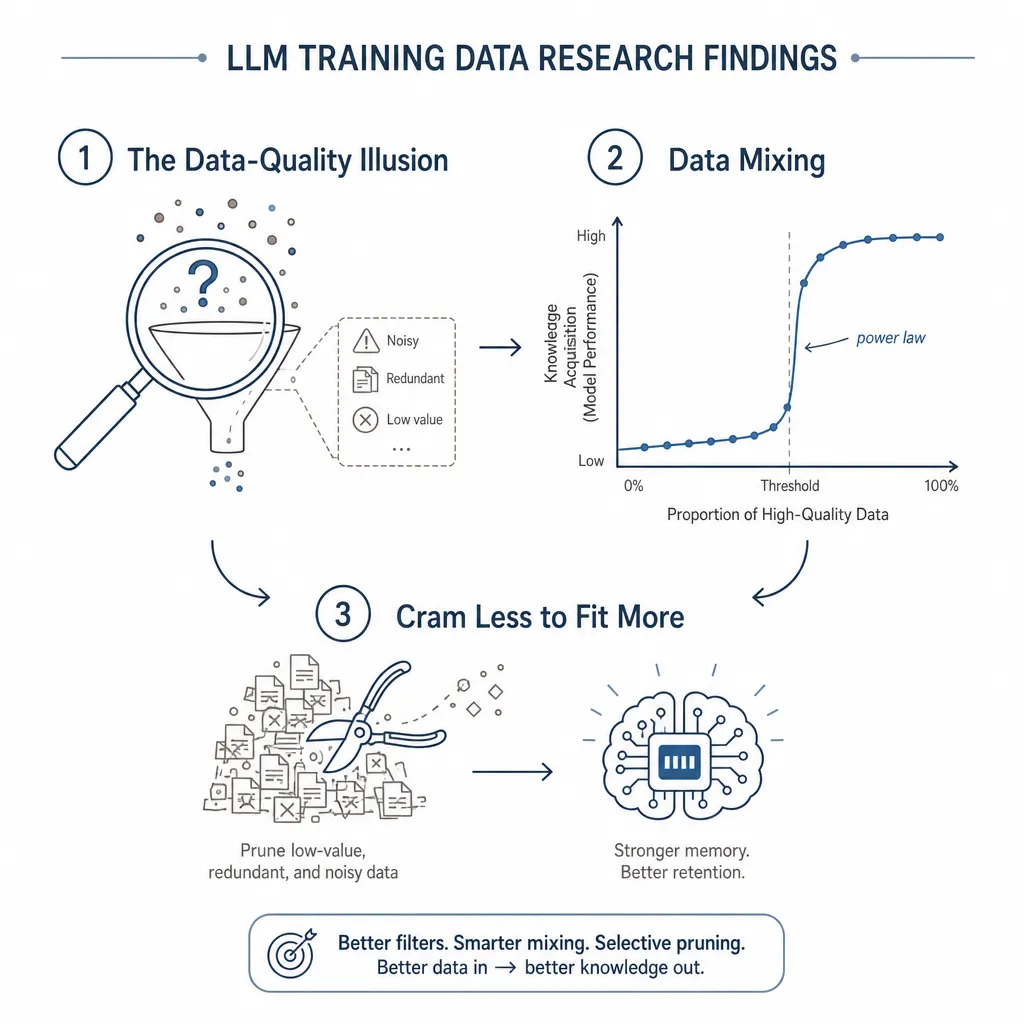
【The Data-Quality Illusion: Rethinking Classifier-Based Quality Filtering for LLM Pretraining】

标签:#数据质量#预训练数据#ICML2026
来源:Apple 研究,ICML 2026
链接:https://machinelearning.apple.com/research
核心摘要:长期以来大家都在用分类器对预训练数据做质量过滤,但 Apple 这篇 ICML 2026 论文质疑了这个做法的有效性。系统实验发现,"高质量"分类器筛选出的数据并不一定带来更好的下游表现,甚至可能丢掉对模型有用的多样性和长尾信息。论文提出了重新思考质量过滤的框架,挑战了"质量越高越好"的直觉。
价值:做大模型预训练和数据处理的技术团队需要关注——你可能一直在做无效的数据清洗。

【Data Mixing Can Induce Phase Transitions in Knowledge Acquisition】

标签:#数据配比#相变#知识获取
来源:arXiv 2505.18091
链接:https://arxiv.org/abs/2505.18091
核心摘要:训练大模型时混合网络数据和 curated 高质量数据,知识获取会出现相变——不像简单 scaling law 那样平滑。当模型规模超过某个临界值时,从"几乎记不住"突然跳到"记住大多数"。关键在于混合比例存在一个阈值,低于它模型即使训练很久也学不到东西,超过后记忆效率急剧加速。临界混合比例与模型规模呈幂律关系。
价值:不同规模模型的"最佳数据配比"完全不同,小模型的最优配方不能直接搬到大模型上。

【Cram Less to Fit More: Training Data Pruning Improves Memorization of Facts】

标签:#数据剪枝#记忆增强#ICML2026来源:Apple 研究,ICML 2026链接:https://machinelearning.apple.com/research
核心摘要:数据剪枝通常被认为会丢失信息,但这篇论文发现恰恰相反——剪掉冗余训练数据反而提升了模型对事实性知识的记忆能力。关键洞察是模型容量有限,去掉低质量/重复数据能让模型把注意力集中在真正重要的事实上,实现更好的 memorization-factuality 权衡。
价值:在做预训练或后训练数据筛选的团队可以参考——"少即是多"在数据剪枝中成立。

二、数据基础设施

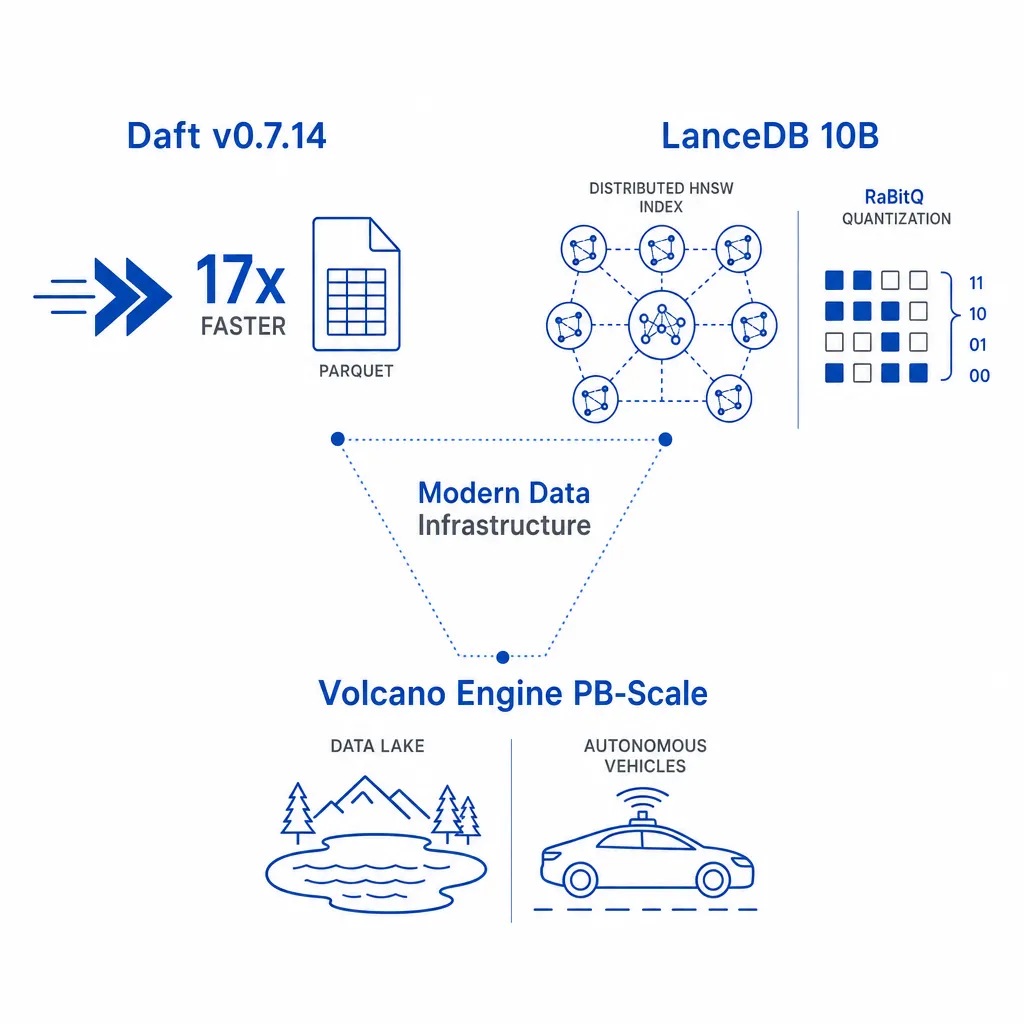
【Daft v0.7.14: Parquet Reader Rewrite, Streaming Distributed Limits, UUIDv7】

标签:#Daft#Parquet#数据处理
来源:Daft 工程博客,2026-05-20
链接:https://www.daft.ai/blog
核心摘要:Daft 团队用 arrow-rs 完全重写了 Parquet 读取器,远程读取性能最高提升17 倍。新版本还引入了分布式 streaming 模式的 limit 算子(不提前物化所有数据)和原生 UUIDv7 生成支持。配合此前版本的双向 ASOF Join、Arrow PyCapsule 和 Iceberg 幂等提交,Daft 近期的迭代节奏非常密集。
价值:用 Parquet 做数据分析/ML 管线的团队可以直接升级,17x 远程读取提升对云端场景尤其显著。

【How LanceDB Accelerates Vector Search at 10 Billion Scale】

标签:#LanceDB#向量搜索#分布式索引
来源:LanceDB 博客,2026-04-29
链接:https://lancedb.com/blog/how-lancedb-accelerates-vector-search-at-10-billion-scale-0f2d75e171e2
核心摘要:LanceDB 详解了如何支撑 10B+ 规模的向量搜索:采用分布式 HNSW 索引 + 分布式查询执行,通过 HNSW centroid routing 减少跨节点通信,搭配RaBitQ快速旋量量化进一步降低内存开销。这套方案让 LanceDB 在十亿级场景下兼顾了高召回和低延迟。
价值:做大规模向量检索选型的团队可以关注 LanceDB 在十亿级场景下的实际表现。

【Volcano Engine LAS's Lance-Based PB-Scale Autonomous Driving Data Lake Solution】

标签:#Lance#自动驾驶#数据湖
来源:LanceDB 博客,2026-04-14
链接:https://lancedb.com/blog
核心摘要:字节跳动火山引擎 LAS 团队选择Lance作为其下一代 AI 数据湖的核心存储格式,支撑 PB 级别的自动驾驶多模态数据(文本、图像、音频、视频)。文章详细介绍了 Lance 在大规模自动驾驶场景下的实际落地经验:列式混合扫描、按需 blob 读取、版本化数据管理,以及与 Spark/Presto 生态的集成。
价值:国内 PB 级 AI 数据湖的落地案例,对做自动驾驶和 AI 数据平台的技术团队有直接参考价值。

三、RAG 检索增强

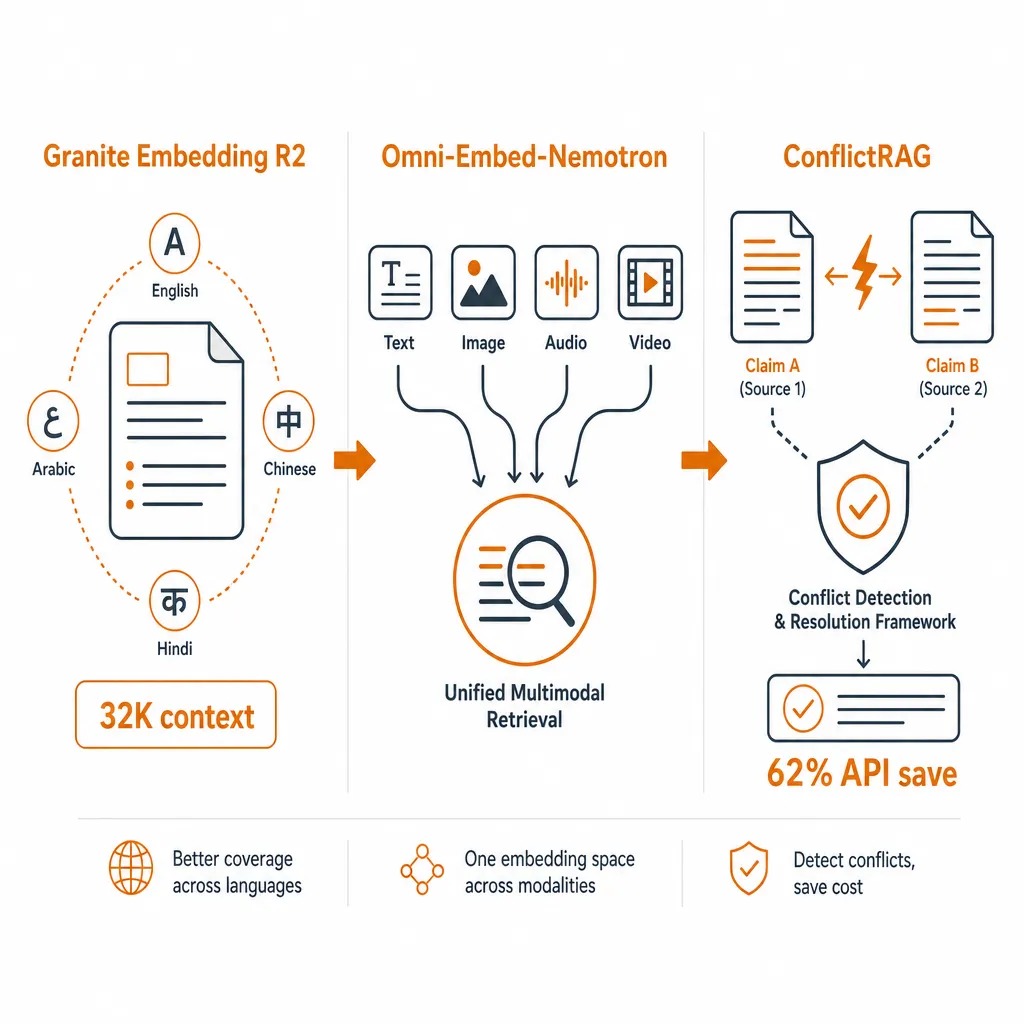
【Granite Embedding Multilingual R2: Best Sub-100M Retrieval Quality with 32K Context】

标签:#Embedding#多语言#开源
来源:IBM / Hugging Face,2026-05-14
链接:https://huggingface.co/blog
核心摘要:IBM 发布 Granite Embedding Multilingual R2,Apache 2.0 开源,以低于 100M 参数实现同规模最佳检索质量,支持32K 上下文窗口,可以处理更长文档而不需要先做 chunking。多语言检索基准上超越多个同类模型。R2 版本在训练数据多样性和长文本处理上做了针对性优化。价值:对多语言 RAG 场景且需要长上下文 embedding 的团队,这是目前开源的最佳选择之一。

【Omni-Embed-Nemotron: A Unified Multimodal Retrieval Model for Text, Image, Audio, and Video】

标签:#多模态检索#Embedding#NVIDIA
来源:arXiv 2510.03458链接:https://arxiv.org/abs/2510.03458核心摘要:NVIDIA 推出统一多模态检索模型,单一模型同时支持文本、图像、音频、视频四种模态的检索,包括跨模态(文本→视频)和联合模态(文本→视频+音频)两种模式。基于 Qwen2.5-Omni 架构扩展,解决了传统纯文本检索器在 PDF、PPT、视频等富视觉内容上的失效问题。价值:做多模态 RAG 或企业知识库搜索的团队可以关注这个统一模型方案。

【ConflictRAG: Detecting and Resolving Knowledge Conflicts in Retrieval Augmented Generation】

标签:#RAG#知识冲突#评估
来源:arXiv 2605.17301
链接:https://arxiv.org/abs/2605.17301
核心摘要:RAG 的一个隐性假设是被检索到的文档之间相互一致,实际中往往不是。ConflictRAG 提出两阶段冲突检测:先用轻量级 embedding + MLP 分类器粗筛,再选择性调用 LLM 精判,相比同类方法减少62% API 调用,保持 90.8% 检测精度。检测后用 Entropy-TOPSIS 框架评估来源可信度选出最可靠证据,还提出了专门诊断指标 Conflict-Aware RAG Score (CARS)。
价值:生产环境 RAG 系统经常面对多源文档冲突,这篇给出了从检测到解决再到评估的完整方案。

四、数据标注与评估

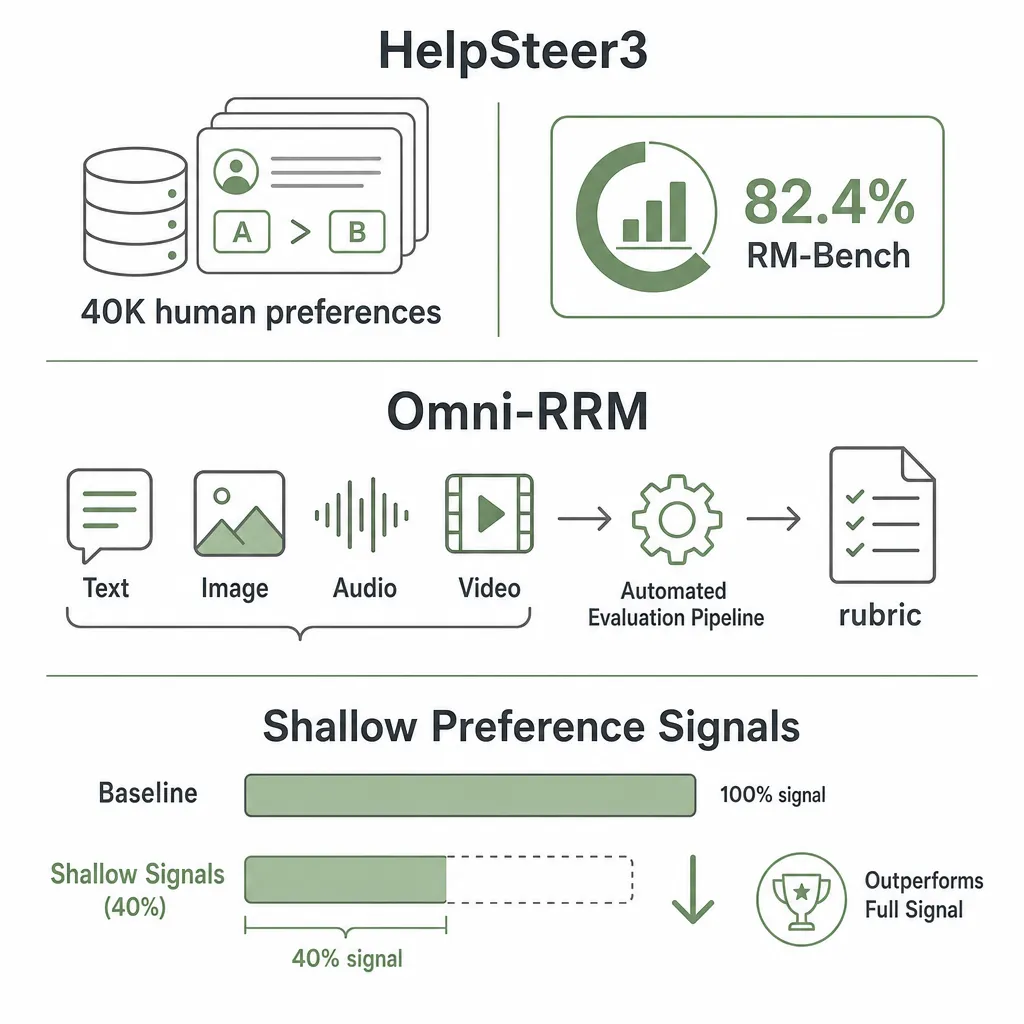
【HelpSteer3-Preference: Open Human-Annotated Preference Data across Diverse Tasks and Languages】

标签:#偏好数据#RLHF#开源数据集
来源:NVIDIA,NeurIPS 2025
链接:https://arxiv.org/abs/2505.11475
核心摘要:NVIDIA 开源HelpSteer3-Preference——超过 4 万条人工标注的偏好数据,覆盖 STEM、编程和多语言场景,CC-BY-4.0 许可。基于此训练的奖励模型在 RM-Bench 达到82.4%,在 JudgeBench 达到73.7%,比此前 SOTA 提升约 10 个绝对百分点。同时验证了对生成式奖励模型和 RLHF 策略对齐的适用性。
价值:做 RLHF 和对齐的团队可以直接使用这个开源偏好数据集训练自己的奖励模型。

【Omni-RRM: Advancing Omni Reward Modeling via Automatic Rubric-Grounded Preference Synthesis】

标签:#奖励模型#全模态#自动化标注
来源:arXiv 2602.00846
链接:https://arxiv.org/abs/2602.00846
核心摘要:现有 RM 的问题:视觉偏重、输出标量不透明、依赖人工标注。Omni-RRM 是首个开源rubric-grounded 奖励模型,支持文本/图像/视频/音频四模态,给出结构化多维度偏好判断及理由。核心是Omni-Preference数据集——通过"不同能力模型对比生成候选 + 强教师模型调和过滤"的自动化管线构建,完全不需要人工标注。在 ShareGPT-V 视频基准达 80.2%,在 Audio-HH-RLHF 达 66.8%,图像任务整体准确率比基线提升 17.7 个百分点。
价值:全模态自动标注偏好数据的方案,对需要降低人工标注成本的多模态对齐工程有直接帮助。

【Shallow Preference Signals: LLM Aligns Even Better with Truncated Data?】

标签:#偏好学习#DPO#数据效率
来源:arXiv 2505.17122
链接:https://arxiv.org/abs/2505.17122
核心摘要:一个反直觉的发现:偏好信号集中在回应的前半段,论文称之为"浅层偏好信号"(shallow preference signals)。系统实验表明,将偏好数据集截断只保留前半部分训练奖励模型和 DPO 模型,效果不输甚至超过全量数据。在 Skywork-Reward-Preference-80K 上,只保留 40% 截断数据训练的 RM 超越了全量版本。这提示现有对齐方法可能只对齐了"开头"。
价值:做 RLHF/DPO 的团队可以大幅降低偏好数据存储和训练开销,也启发重新思考对齐策略。

五、多模态数据

【PixVerve-95K: Advancing Native UHR Image Generation to 100MP with a Large-Scale High-Quality Dataset】

标签:#超高清#图像生成#数据集
来源:arXiv 2605.20147
链接:https://arxiv.org/abs/2605.20147
核心摘要:现有 T2I 模型多集中在 1K-2K 分辨率,而真实场景对超高清(UHR)图像需求日益增长。PixVerve 开源了95,000 张、每张最小 1 亿像素的 UHR 图像数据集,配有 7 维标注。基于该数据集探索了将 T2I 模型扩展到原生 100MP 生成的三种训练方案,并推出 PixVerve-Bench 评估基准。
价值:高分辨率图像生成领域的标杆数据集,95K 高质量 UHR 数据填补了领域空白。

【OceanPile: A Large-Scale Multimodal Ocean Corpus for Foundation Models】

标签:#海洋科学#多模态#领域语料
来源:arXiv 2605.00877
链接:https://arxiv.org/abs/2605.00877
核心摘要:海洋科学数据高度碎片化、多模态、噪声大且标注弱,成为 AI 落地的数据瓶颈。OceanPile 构建了三件套:OceanCorpus(声纳/水下图像/海洋视觉和科学文本的统一集合)、OceanInstruction(基于海洋概念知识图谱引导合成的指令数据)、OceanBenchmark(人工筛选的评测基准)。所有数据均已开源。
价值:海洋等垂直领域的多模态数据构建示范,利用领域知识图谱引导数据合成的思路值得借鉴。

【CheXthought: A Global Multimodal Dataset of Clinical Chain-of-Thought Reasoning and Visual Attention for Chest X-Ray Interpretation】

标签:#医疗AI#思维链#视觉注意力
来源:arXiv 2604.26288,全球放射学联盟链接:https://arxiv.org/abs/2604.26288
核心摘要:不只是又一个影像-报告配对。CheXthought 捕捉了放射科医生解读胸片时的完整认知过程:来自71 国 501 位放射科医生的103,592 条思维链推理轨迹和660 万条同步视觉注意力标注,覆盖 50,312 张多人标注胸片。用该数据训练的 VLM 在事实准确性和空间定位上显著超越 SOTA,视觉注意力作为推理提示可以找回漏诊发现并大幅减少幻觉。
价值:医疗 AI 数据集的标杆——不仅关注"答案",还收集了"推理过程"。

相关学习资料