 夜雨聆风
上周发布的启文v1.1,表面上是增加了模板库和AI历史对话两个功能。但对我而言,这是产品哲学的一次重要转折:工具不再只是执行命令,开始具备「上下文感知」和「记忆能力」。
如果你也在做生产力工具,尤其是面向科研、教育这类专业场景的软件,这篇文章可能会让你重新思考「工具」的定义。
1. 模板库:不是功能,而是「认知卸载」
大多数写作软件的设计哲学,都建立在「用户知道怎么写」的假设上。这听起来合理,却忽略了一个关键事实:写作的难点,往往不是「写什么」,而是「怎么写」。
写一篇学术论文,你要回忆:
期刊要求的格式结构 章节之间的逻辑关系 参考文献的标注方式 图表编号的规范
这些都属于「程序性知识」——你知道怎么做,但每次都要重新回忆和执行。认知心理学称之为「认知负荷」。
模板库的本质,是「认知卸载」。
我们不是简单地提供一堆模板文件,而是构建了一个「结构化写作框架」:
每个模板都按照该领域的专业规范预先设计 占位符提示用户该写什么内容 结构本身引导写作的逻辑流程
但真正有趣的是用户自定义模板这个功能。
当一位生物信息学的研究员把「学术论文」模板改成自己实验室的特定格式(比如增加「数据预处理」和「算法参数」章节),然后保存为个人模板时,发生了一件重要的事:工具开始学习用户的专业习惯。
这不是机器学习意义上的学习,而是工具与用户工作流程的深度耦合。用户不再需要每次从零开始,工具记住了ta的写作习惯。
2. AI历史对话:从「单次交互」到「持续对话」
上一个版本的AI助手,存在一个根本性缺陷:它没有记忆。
这导致了一个奇怪的现象:用户和AI的每次交互都是孤立的。你让AI润色了一段文字,下一轮问它“刚才那段你改成什么样了?”,它只能看到你当前的原始文本。
从技术角度看,这是典型的「无状态服务」设计。但从用户体验看,这就像每次都在和一个失忆的助手合作。
2.1 技术实现:本地记忆的权衡
实现AI历史对话,我们面临几个关键决策:
存储位置:云端 vs 本地
云端:实现简单,可以跨设备同步 本地:数据隐私,离线可用
我们选择了本地。原因很简单:写作是高度隐私的行为。用户可能正在写未发表的论文、敏感的医疗记录、机密的商业计划。这些数据不应该离开ta的设备。
存储结构:对话树 vs 线性列表
对话树:能记录复杂的多轮对话分支 线性列表:实现简单,检索高效
我们选择了线性列表+会话ID的方式。每个编辑会话生成一个唯一ID,同一会话内的所有AI交互都关联到这个ID。这样既保持了对话的连贯性,又避免了过度复杂的存储结构。
检索效率:全文搜索 vs 向量检索
全文搜索:实现简单,对硬件要求低 向量检索:语义相似度匹配,更智能但更重
考虑到启文要能在低配设备上运行,我们选择了基于关键词的全文搜索。但未来如果用户需求强烈,可能会增加向量检索作为可选功能。
2.2 用户体验:从「工具」到「伙伴」
有了历史记忆,AI助手的行为发生了质的变化:
场景一:渐进式优化
用户:把这段改得更学术一些 AI:本研究取得了显著成果... (半小时后) 用户:再正式一点,像论文结论那样 AI:本研究获得的成果具有显著统计意义...AI知道用户是在第一次改写的基础上继续优化,而不是从原始版本重新开始。
场景二:风格一致性
用户:把这段话改成鲁迅风格 AI:(鲁迅风格改写) (后续) 用户:这段也改成类似风格 AI:基于之前的鲁迅风格理解,保持一致性AI记住了用户的风格偏好,在后续交互中保持一致性。
场景三:错误回溯
用户:刚才你改的那段,我觉得太啰嗦了 AI:我看看历史记录...哦,我确实加了太多修饰词。我重新改一下。用户可以指出AI之前的错误,AI能回溯到具体的历史记录进行修正。
这种体验,让工具从「执行命令的机器」变成了「有记忆的合作伙伴」。
3. 本地优先的哲学困境
启文从第一天起就坚持「本地优先、可离线」。这在2026年的AI时代,显得有些「反潮流」。
3.1 技术上的自我限制
选择本地优先,意味着我们主动放弃了很多「捷径」:
模型大小受限
云端:可以用千亿参数的大模型 本地:受限于用户设备,只能用中小模型
功能实现更复杂
云端:所有计算在服务器完成 本地:要考虑不同设备的性能差异
更新部署更慢
云端:随时更新模型,用户无感知 本地:用户需要手动更新客户端
3.2 商业模式的挑战
更现实的是商业模式问题:
无法数据变现
云端软件:收集用户数据训练模型,形成护城河 本地软件:数据都在用户设备上,无法用于改进产品
难以建立网络效应
云端:用户越多,数据越多,模型越好 本地:每个用户都是孤岛,没有规模效应
盈利压力更大
云端:可以SaaS订阅 本地:我们选择了免费,靠什么生存?
3.3 为什么还要坚持?
因为信任是数字时代最稀缺的资源。
当用户知道:
自己的论文草稿不会上传到任何服务器 AI的对话记录只存在于自己的电脑 即使断网,所有功能依然可用
这种安全感,是云端软件无法提供的。
特别是对于科研、教育、医疗、法律这些领域,数据隐私不是可选项,而是必选项。
4. 行业观察:工具进化的三个阶段
回顾生产力工具的发展,我看到了三个阶段:
阶段一:自动化工具(1990-2010)
核心:把重复劳动自动化 例子:Word的模板、Excel的公式 局限:只能执行预设规则
阶段二:智能助手(2010-2025)
核心:AI辅助决策 例子:Grammarly、Copilot 局限:无记忆,每次交互都是孤立的
阶段三:认知伙伴(2025-)
核心:有记忆的AI,理解用户的工作流 例子:启文的AI历史对话 特征:工具开始「理解」而不仅仅是「执行」
我们正处在从第二阶段向第三阶段过渡的时期。工具不再只是被动响应指令,开始主动理解用户的意图、记住用户的历史、适应用户的习惯。
5. 未来展望:工具即延伸
启文接下来的规划,都围绕一个核心思想:工具应该是用户的认知延伸。
模板市场 不只是模板分享,而是工作流共享。一位资深研究员可以把整个论文写作流程(从文献综述到结论)打包成模板,新手可以直接套用这个「认知框架」。
AI自定义角色 让用户用自然语言定义AI的角色:「你是我的论文导师,擅长指出逻辑漏洞」「你是我的合作者,擅长补充实验细节」。AI不再是一个通用助手,而是专业角色的数字化身。
工作流引擎 把多个操作(查找文献→整理笔记→生成大纲→写作→润色)串联成自动化工作流。用户只需要触发一次,工具就能完成整个流程。
6. 写给同行的话
如果你也在做生产力工具,尤其是面向专业场景的软件,我想分享几点感受:
1. 深度比广度重要 与其做100个浅功能,不如做10个深功能。用户需要的是能真正解决他们痛点的工具,而不是功能列表很长的玩具。
2. 理解比执行重要 工具要理解用户的工作场景、思维习惯、专业规范。这需要深入行业,和用户一起工作。
3. 信任比功能重要 在数据敏感的场景,用户对工具的信任,比任何炫酷功能都重要。建立信任需要时间,但一旦建立,就是最深的护城河。
4. 克制比堆砌重要 每个新功能都要问:这真的解决了用户的核心问题吗?还是只是让我们自己感觉良好?
最后
做启文这两年,我最大的感受是:我们不是在写代码,而是在构建「认知基础设施」。
每一行代码,每一个功能,都在影响用户如何思考、如何工作、如何创造。
当一位研究生因为模板库节省了格式调整的时间,当一位教师因为AI助手更顺畅地完成了教案,当一位研究员因为历史对话功能找回了三周前的写作思路……
这些瞬间让我相信:工具的价值,不是让事情变得更容易,而是让人变得更有力量。
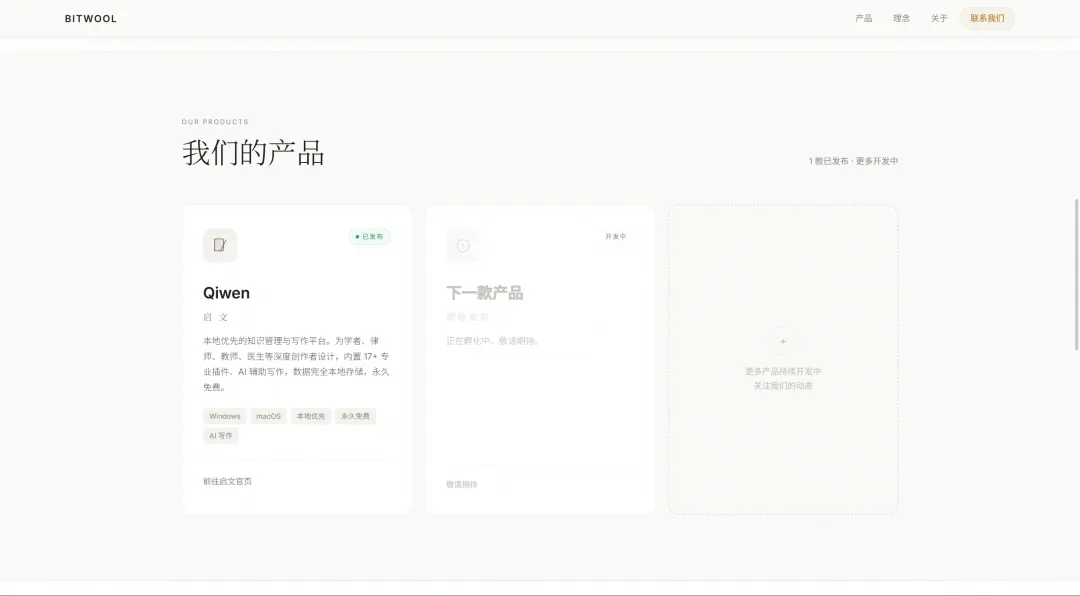
BitWool 数字毛织| bitwool.cn启文|启于思,行于文免费 · 本地优先 · 可离线的写作伙伴
如果你也在工具设计的道路上探索,或者对「认知工具」有自己的思考,欢迎来信交流。我们不是竞争对手,而是这个时代的同行者。