 夜雨聆风
核心议题:三年前,阿里、腾讯、字节集体喊出"All in AI"。两年国内头部公司砸入约 2 万亿,而兴业银行测算 2025-2030 年全国算力基础设施投资将达 9.2 万亿元。然而OpenAI 年亏 80 亿美元、字节净利润下滑超 70%、全国智算中心平均利用率仅 32%——这笔账,为何怎么也算不明白? |
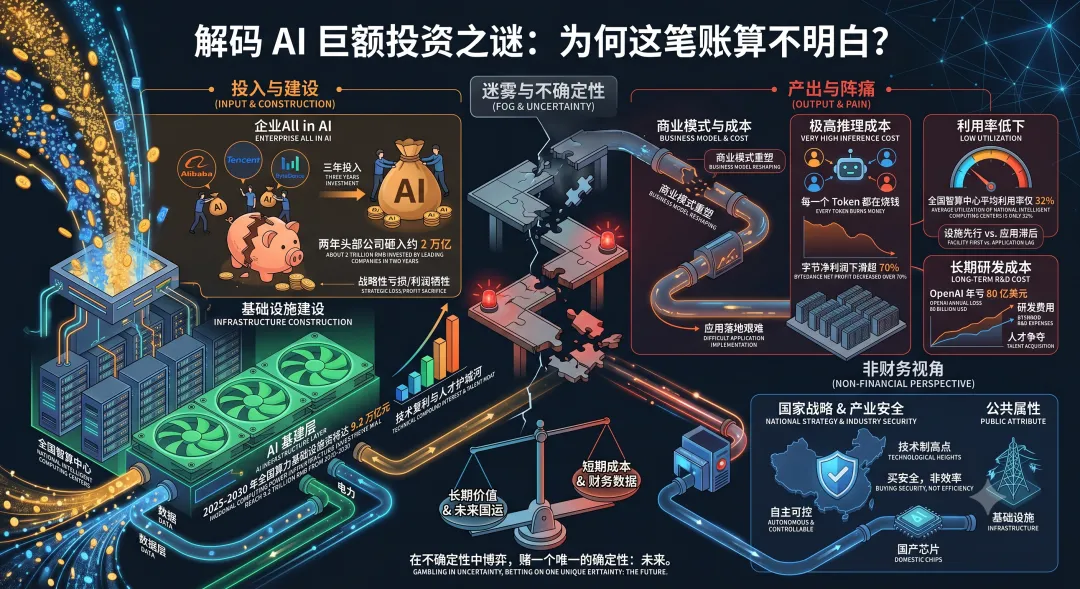
一、算力投资全景:近十万亿为何听不见响
1.1疯狂的资本开支
厂商/机构 | 投入规模 | 时间范围 | 产出/回报 |
阿里巴巴 | 3800 亿元 | 三年计划 | 调整后净利仅0.86 亿 |
字节跳动 | 1500 亿 → 2000+ 亿/年 | 2025-2026 | 净利润同比下滑超70% |
腾讯 | 千亿级/年(同比 +221%) | 2025 | 利润承压但未崩 |
OpenAI | ~400 亿美元/年 | 2025 | 营收131 亿,亏 80 亿 |
全国算力基建 | 9.2 万亿元 | 2025-2030 | 智算中心利用率仅32% |
1.2算力黑洞:投入越大,亏损越大
国内AI公司亏损惨烈 •智谱AI:营收7.24 亿,净亏 31.82 亿 •MiniMax:营收5.43 亿,净亏 17.5 亿 •字节:净利润同比下滑超70% •阿里:调整后净利仅0.86 亿 | 结构错配荒诞图景 •全国已上线智算中心算力平均利用率仅32% •大量智算中心被迫"压价、退租"求生 •平均出租率仅20%-30% •92% 企业却认为算力是最大挑战 「大厂算力荒」与「智算中心卖卡求生」并存 |
困局的本质:92% 的受访企业将算力不足视为大模型落地最大挑战,但供给侧的智算中心却大量闲置。这不是简单的"量不够",而是 典型的结构性错配——需求端嗷嗷待哺,供给端门可罗雀。根源在于,AI 行业至今未找到"可销售的产品形态"。 |
二、三大巨头的路径分化与各自困局
2.1阿里:旧模式被 AI 亲手拆掉
阿里面临"左右手互搏"——AI 购物体验的升级直接把核心盈利模式(商家竞价排名)推向了悬崖。用户直接对千问说"找 500 块以内送妈妈的生日礼物",千问推荐并附上链接——竞价展位消失了,模型直接决定了推荐结果。 |
吴泳铭回归后喊出「3年内持续加码,不算短期账」。但新盈利模式尚未成型,旧业务正被 AI 加速侵蚀——边拆旧模式边建新模式,这是一场跟时间的赛跑。
2.2字节:规模第一,留存无解
字节走的是最进攻性的路线:不做克制性投入,而是用多款AI 应用快速圈地。
应用 | 月活/数据 | 赛道 | 核心挑战 |
豆包 | 3.45 亿月活,token 调用占国内 86% | AI 对话 | 用户粘性弱,付费习惯未养成 |
即梦 | 快速增长 | AI 图像/视频 | 算力成本极高 |
Coze | 生态建设中 | AI Agent 平台 | 商业化路径未通 |
Seedance | 国内同类最贵 | AI 视频生成 | 成本太高 |
豆包赔付承诺书事件的启示:官方辟谣说"没有资格承诺赔偿",反而放大了不信任。用户开始质疑:AI 说的话能不能信?出了问题谁负责?这恰恰说明——没有信任基础设施,AI 代理这套东西玩不转。 |
2.3腾讯:不见兔子不撒鹰
马化腾坦言「之前的AI 战略是有失误的」。混元 3.0 Preview 登顶全球开发者调用榜让腾讯信心倍增,但产品落地依然缓慢——微信智能体计划过去快一年也没上线,AI 功能仍停留在搜一搜、读书、输入法等小方面。
腾讯的赌注:微信13 亿月活,把实名支付、线下消费、企业关系、小程序生态全部串在一起——这是中国唯一的"信任操作系统"。腾讯在等全社会意识到只有依托被广泛认可的信任底座,AI 代理才能真正落地。 |
三、DeepSeek掀起的效率革命
3.1用卡效率 > 卡的数量
2025年 1 月,DeepSeek-V3 发布,将 AI 行业笃信多年的"算力至上"信条炸得粉碎:
模型 | 训练成本 | API 输入定价(每百万 token) | 性能对标 |
GPT-4 | ~1 亿美元 | ~30 美元 | 基准 |
Llama 3.1 405B | ~6000 万美元 | ~0.6 美元 | 接近GPT-4 |
DeepSeek-V3 | 557.6 万美元 | ~0.14 美元 | GPT-4 级 |
三重算法创新叠加效应: •MoE 架构 → 训练成本降低 50% •稀疏化技术→ 减少 70%无效计算 •量化压缩→ 不牺牲精度将模型"瘦身" 50%+ DeepSeek 用算法优化证明:用卡效率比卡的数量更重要。 |
3.2杰文斯悖论:成本越降,需求越爆
微软CEO 纳德拉在 DeepSeek 发布后直接喊出:「杰文斯悖论再次上演!」一个反直觉的逻辑正在全面兑现——成本每下降一级,就打开一个更大的市场。尽管DeepSeek 将单次训练能耗降低 90%,英伟达 2025 年数据中心 GPU 出货量仍同比增长 13%。 |
3.3国产替代:从被迫选择到性价比优选
国产AI 芯片市占率从 2020 年的 12%飙升至2025 年的 41%,华为昇腾以约81.2 万颗出货量占据国产阵营半壁江山。
年份 | 国产芯片市占率 | 英伟达市占率 | 关键节点 |
2020 | 12% | ~95% | 起步期 |
2023 | ~20% | 95% | 出口管制倒逼自主化 |
2025 | 41% | 55% | 昇腾910C 发布 |
华为昇腾910C 的 FP16 稠密算力达 800TFLOPS,已接近英伟达 H100 的 80%。单卡性能差距从"代际鸿沟"收窄至"一代以内"。
四、推理经济:从"卖矿机"到"收电费"
4.1训推拐点已到
2025年是中国 AI 的"训推拐点"——推理数据量首次超越训练数据量,达到 101.34EB。全国日均 Token 调用量在年末突破 100 万亿。
年份 | 推理算力占比 | 关键里程碑 |
2023 | ~33% | 训练主导期 |
2025 | ~50% | 推理首超训练 |
2026(预测) | 66% | 推理成为绝对主力 |
2028(预测) | 73% | 推理工作负载占绝对主导 |
训练vs 推理的本质差异: 训练是CapEx(资本支出)——一次性重投入,回报周期不确定推理是 OpEx(运营支出)——按需调用、按量计费、持续消耗 商业模式从「卖矿机」转向「收电费」。更重要的是,推理持续运行,可能占生产AI 系统生命周期成本的 80%-90%——训练只是偶发性投资,推理则产生永不间断的成本流。 |
4.2推理基础设施的新范式
训练追求极致吞吐量,推理需要贴近用户的低延迟响应。从"中心化训练集群"到"分布式推理网络"的演进,意味着算力需要从"集中供能"走向"网格化配电"——哪里产生 Token 调用,算力就要在毫秒级时间内流动到哪里。
中国推理算力市场2025 年达 438.5 亿元,年均复合增长率66.3%,2028 年将突破 2931 亿元。
五、服务化转型:从"卖瓦特"到"卖服务"
5.1三层价值金字塔
维度 | 资源服务(算力租赁) | 平台服务(算力平台) | 生态服务(产业运营) |
毛利率 | 10%-15% | 50%-60% | 50%-70% |
核心产品 | GPU/服务器租赁 | 大模型平台、训推一体 | 园区运营、数据服务、行业方案 |
客户黏性 | 低,可替换性强 | 中,依赖平台工具链 | 高,深度嵌入业务 |
底层资源服务只是入场券,真正的利润区在平台和生态层。同一座智算中心,卖"裸算力" vs "算力+平台+生态",盈利水平相差 3 到 5 倍。谁能把"算力+模型+数据"打包成行业解决方案交付,谁就能从毛利率 10% 的红海游到毛利率 60% 的深蓝。 |
5.2成功案例
润泽科技:从IDC 到 AIDC •在手订单超60 亿元 •与字节跳动签有50 亿元长单 •头部企业毛利率达55%-60% •远超纯租赁的10%-15% | 利通电子:绑定巨头 •与腾讯签50 亿元 3 年长单 •2026 Q1 净利 2.71 亿 •同比增长821% •风险:80% 收入来自腾讯 |
六、算力网络与垂直深耕
6.1全国算力一张网
工信部2026 年提出"单点提质、创新强链、连算成网、全面赋能"十六字方针,核心诉求只有一个:把已经建好的算力用起来,而不是继续盲目堆硬件。
指标 | 数据 |
全国智能算力总规模 | 188 万 PFLOPS |
国家级平台接入占比 | 72%(137 万 PFLOPS) |
八大枢纽节点占比 | >80% |
枢纽间时延圈 | 20 毫秒已实现 |
超算互联网加速卡 | 15 万+ |
工信部首次提出探索"算力银行""算力超市"创新业务模式,推行按"卡时""核时"及 Token 计费。这意味着算力资源有望像银行存款一样,随存随取、按量计息。 |
6.2垂直深耕:放弃万能平台的幻想
垂直领域 | AI 渗透率 | 核心落地场景 | 标杆成效 |
金融 | 92% | 风控建模、智能客服 | 120+ 算法模型覆盖 840 场景 |
制造 | 65% | 智慧配煤、AI 质检 | 盘古32 场景落地,效率提升 35% |
医疗 | 58% | AI 辅助诊断、药物研发 | 研发周期缩短78% |
弃"万能平台"的幻想。XX大模型不搞"万能问答",扎进 30 多个行业、500 多个场景——从高铁巡检 3.2 万个项点、350 余种故障识别(准确率 99%),到宝钢每年降本超10 亿元。这套"行业 know-how + 算力"的组合拳,打的不是技术参数战,而是产业价值战。 |
七、算力金融化与十大破局法则
7.1算力 REITs 与算力券
算力REITs •2025 年 6 月首批数据中心公募 REITs 获批 •万国数据中心REIT 募集 16.09 亿元 •收益率4%-6%,但"有通道"就是革命性的 •算力投资从"一锤子买卖"变成"可循环金融闭环" | 算力券政策
|
7.2十大破局法则
法则 | 核心要义 | 关键数据 | 破局逻辑 |
一、效率优先 | 算法优化> 堆卡 | DeepSeek 训练成本仅为GPT-4 的 1/20 | 用卡效率取代卡的数量 |
二、推理为王 | 从训练驱动转向推理驱动 | 推理数据量首超训练训推比达3:1 | 商业模式从"卖矿机"变"收电费" |
三、国产降本 | 自主可控是降本路径 | 国产市占率12% → 41% | 供应链安全+性价比驱动 |
四、服务升级 | 从资源租赁到平台+生态 | 租赁10-15% → 生态 50-70% | Token 经济重构计费单元 |
五、网络协同 | 全国一张网消灭孤岛 | 调度平台接入137 万 PFLOPS | 算力银行让沉睡算力流动 |
六、垂直深耕 | 行业know-how 是护城河 | 87% 企业不满通用模型 | 算力+模型+数据一体化 |
七、金融赋能 | REITs 和算力券打通资本循环 | 首批数据中心REITs 超 64 亿 | 重资产"投建管退"闭环 |
八、边缘突破 | 端侧算力开辟新蓝海 | AI 智能终端 2025 年 5347 亿 | 2030 年边缘算力占比 70% |
九、软硬一体 | 绑定硬件量产稀释成本 | 一体机市场三年翻四倍至5208 亿 | "开箱即用"缩短部署周期 |
十、运营为王 | 投建营一体化提升效率 | 预制化模块缩短建设周期50% | 运营效率决定生死,用好>建好 |
十大法则横跨算法、硬件、网络、金融、运营五个维度,指向同一个终局——谁能把算力更高效地转化为客户价值,谁就能在这轮洗牌中活下来。法则1-3 解决"成本怎么降",法则 4-6 回答"需求怎么接",法则 7-10 回应"资本怎么转"——三层递进,构成完整的破局闭环。 |
八、终局:从军备竞赛到价值创造
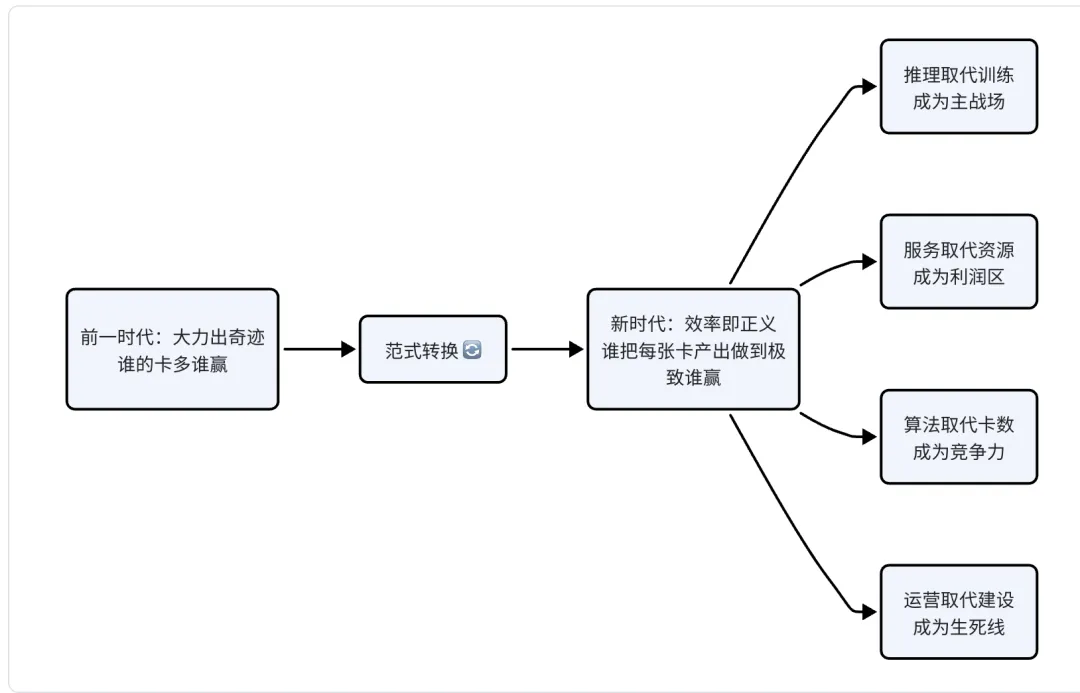
算力商业的终局,不是谁拥有最多的GPU,而是谁能让算力像电流一样无处不在、即插即用。从"军备竞赛"到"价值创造",从"资源为王"到"运营为王"——这不是温柔的演进,而是一场残酷的淘汰。 摩根大通预测,到2030 年仅中国日均 Token 调用量就将从当前的 140 万亿攀升至 10700 万亿——两个数量级的跃升。算力消费将从"企业采购"变成"日常水电煤"。 近十万亿砸下去,响声终将到来,但它只回应那些真正懂得"用卡"而非"囤卡"的人。 |
本文综合整理自微信公众号「智慧城市运营研究」沈永洲《国内三大互联网巨头的AI布局拆解》与「MOOC」Tom的猴毛《All in AI第三年,这笔账还是算不明白》两篇文章,IDC《2025年中国人工智能计算力发展评估报告》、国家数据局、中国信通院、兴业银行研报、各上市公司财报等公开资料,结合阿里、腾讯、字节跳动公开财报及行业研究报告整理而成。