 夜雨聆风
这个新开源工具,专门帮你调试 AI Agent
如果你已经开始做 AI Agent,不要只盯着最后一句回答。真正该看的,是它中间查了什么、调用了什么工具、在哪一步开始跑偏。
最近我看到一个挺适合技术读者收藏的新工具:Raindrop Workshop。它在 2026 年 5 月发布,定位很明确:给 AI Agent 做本地开发、调试和评估。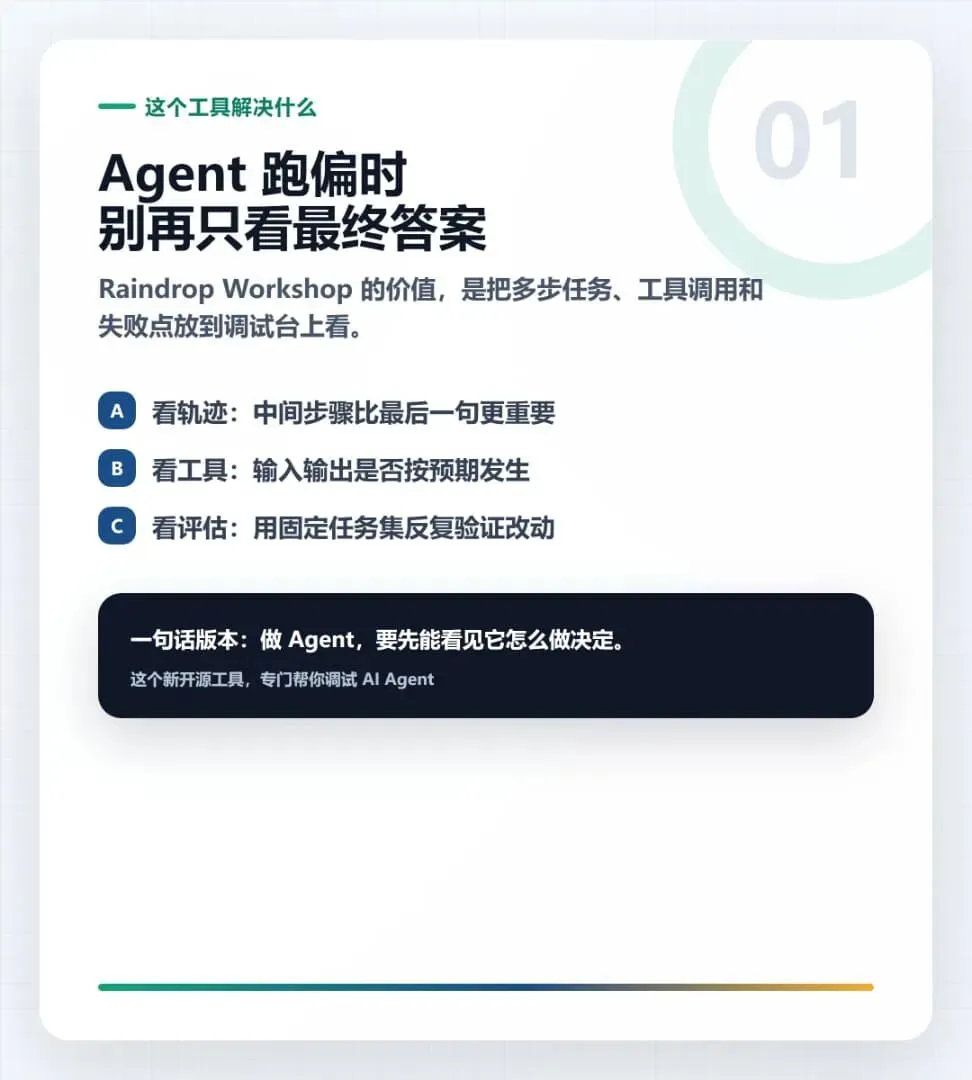
简单说,它不是又一个聊天机器人,而是一个 Agent 工作台。你可以在本地启动它,把自己的 Agent 接进去,观察多步任务的执行轨迹、工具调用、上下文变化和评估结果。
这类工具现在很有价值,因为很多人已经不满足于“让 AI 回答一句话”,而是在做更复杂的任务:自动查资料、写代码、调用 API、整理文件、跑工作流。问题也随之出现:Agent 失败时,你很难知道它到底是哪一步错了。
它解决的不是生成,而是看清过程
Raindrop Workshop 最吸引我的点,是它把 Agent 的运行过程摆到台面上。
普通聊天界面只能看到结果。结果错了,你最多知道“它答错了”。但 Agent 经常不是最后一步才错,而是早在中间就选错工具、漏掉约束、拿错上下文,最后只是把错误包装成一段流畅回答。
Workshop 想解决的就是这个问题:让你能看到每一次运行的轨迹,而不是靠猜。
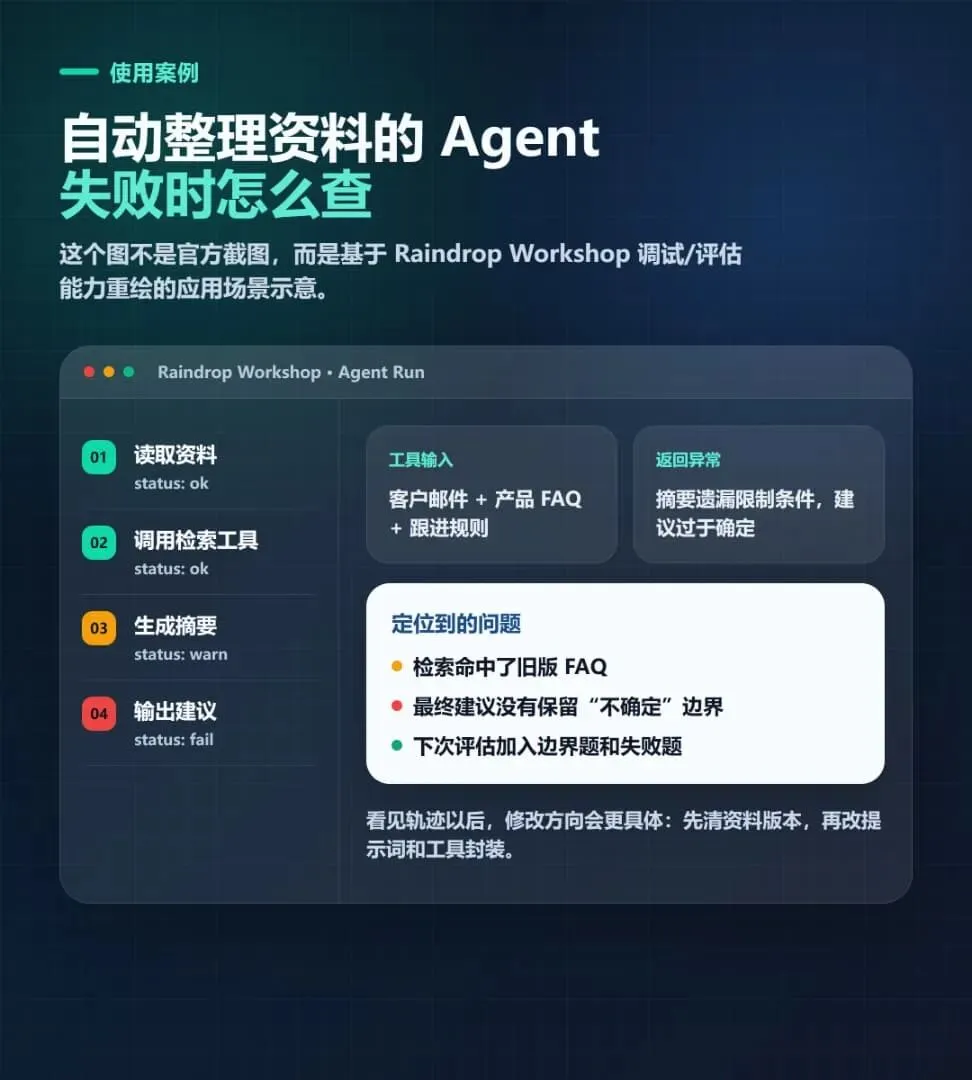
这对做自动化的人很实用。比如你做了一个“自动整理客户邮件并生成跟进建议”的 Agent,如果结果不稳定,你需要知道它是邮件检索错了、分类错了、提示词不清楚,还是工具返回值没有处理好。
一个典型应用场景是:Agent 读取客户邮件、检索产品 FAQ、生成跟进建议。最后建议看起来很完整,但其实中间命中了旧版 FAQ,或者把“不确定”的规则写成了确定结论。用调试台看轨迹时,你能更快定位问题发生在哪一步,而不是反复改最后的提示词。
三个功能最值得看
第一,它支持本地开发。官方给出的入口很直接,可以用命令启动 Workshop,在浏览器里打开本地工作台。对还在试验阶段的 Agent 来说,本地跑更方便,也更适合反复改。
第二,它强调调试轨迹。你可以围绕一次任务运行去看中间步骤,这比只看最终答案有用得多。Agent 任务越长,轨迹越重要。
第三,它把评估放进开发流程。很多 Agent 项目最大的问题,是每次改提示词或工具逻辑都靠感觉。Workshop 这类工具的价值,是提醒你用固定任务集反复跑,观察结果有没有真的变好。
我会把它归到“Agent 工程化小工具”这一类:不一定适合所有普通用户,但对正在做 Agent 的人,它解决的是很真实的痛点。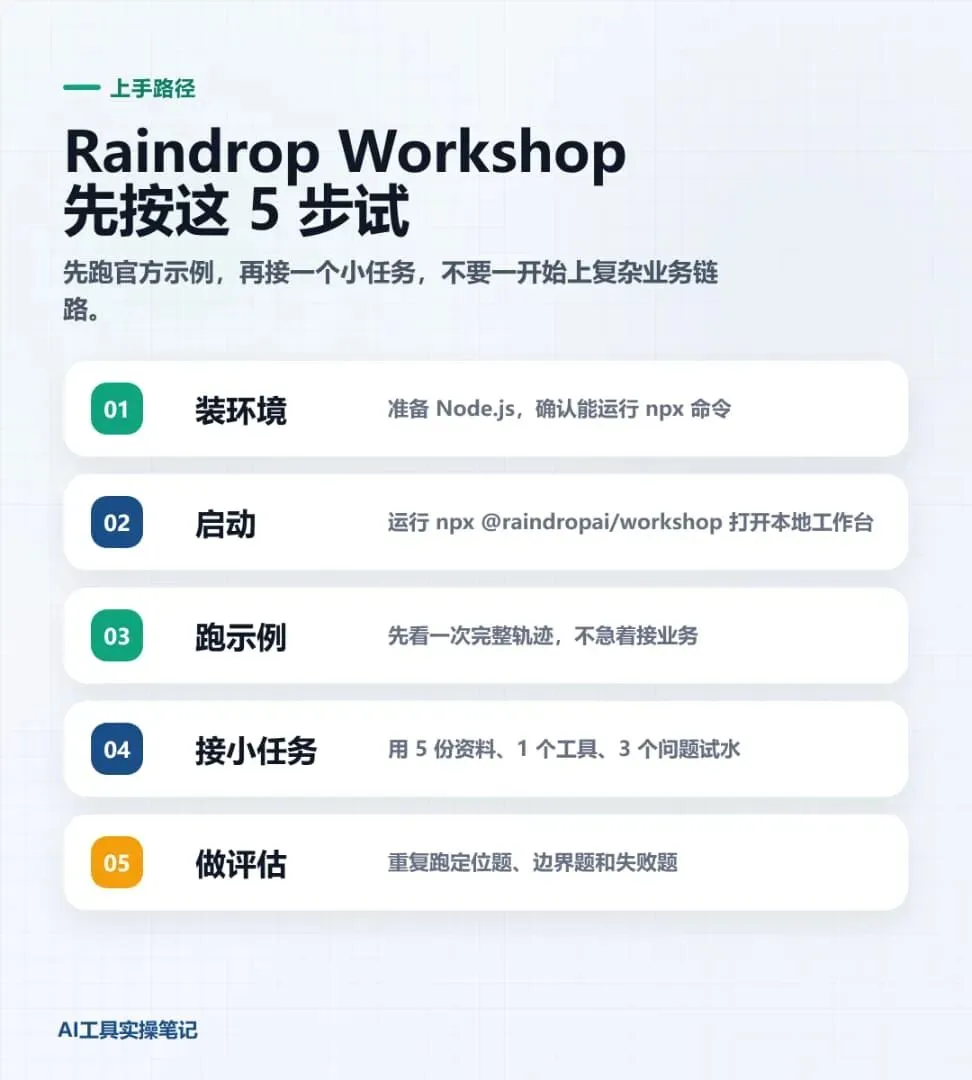
怎么开始试
如果你想快速体验,可以按这个最小路径走。
先准备 Node.js 环境,然后按官方文档启动:
npx @raindropai/workshop启动后,浏览器会打开本地工作台。你可以先用官方示例跑一遍,重点不要看“答案漂不漂亮”,而是看这三件事:
- 1每一步任务有没有清楚记录;
- 2工具调用的输入输出能不能看懂;
- 3同一个任务重复运行时,失败点是否稳定出现。
如果你已经有自己的 Agent,不要一开始接最复杂的业务流程。先选一个小任务,比如“读取一组资料并回答三个固定问题”,把它接进去跑通。等你能稳定看到轨迹,再接更长的自动化链路。
我建议这样用它验收 Agent
你可以给每个 Agent 准备一个小型验收集,先不用复杂。
这个表比“感觉今天回答不错”可靠得多。尤其是你每次改提示词、换模型、换工具封装后,都可以用同一组问题重新跑一遍。
几个更有价值的应用场景
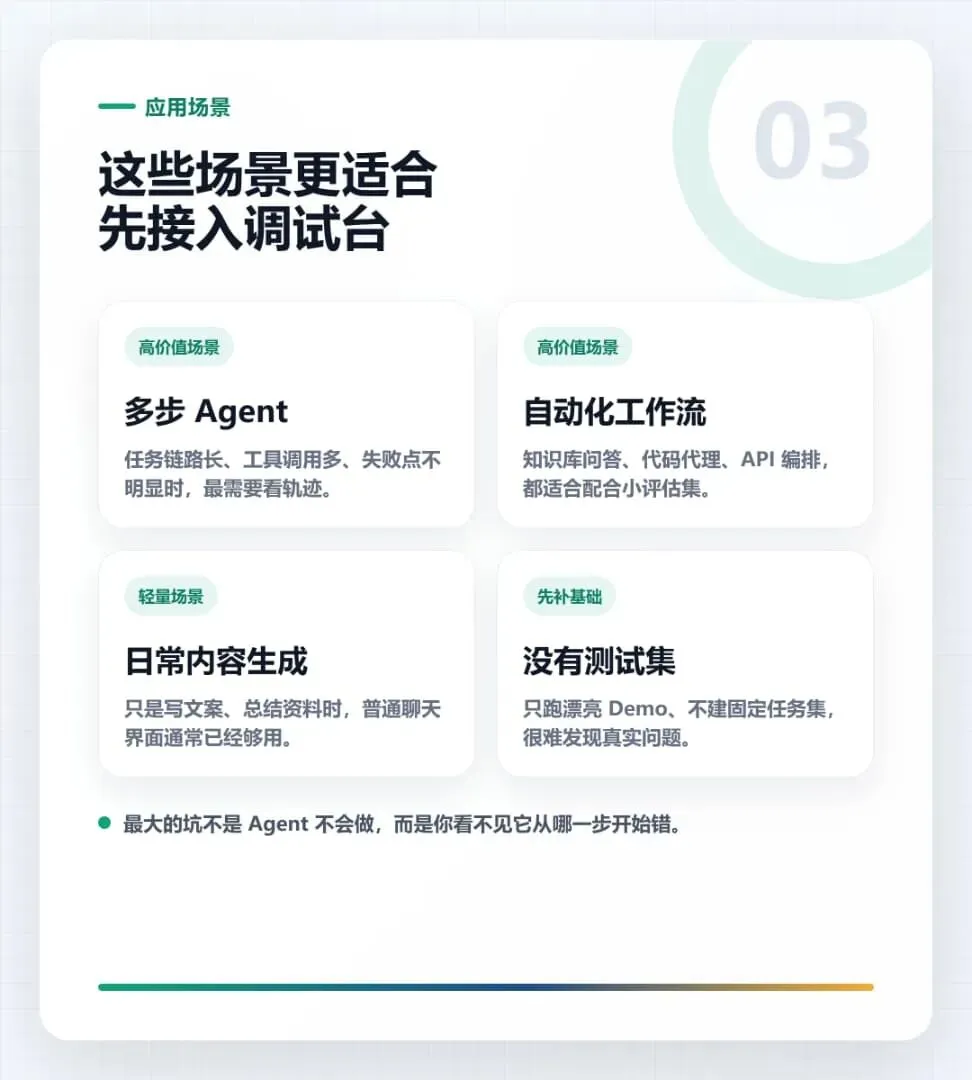 Raindrop Workshop 更适合放在那些“过程比结果更重要”的场景里。比如多步 Agent、工具调用链、自动化脚本、内部知识库问答、代码代理、API 编排,这些任务一旦出错,不能只看最后一句回答,必须回到中间轨迹里查原因。
还有一种场景也很典型:你已经有一个 Agent Demo,但每次改提示词、换模型、换工具封装后,都不知道它到底有没有变稳。这时 Workshop 可以配合固定任务集使用,把“感觉更好了”变成“同一批问题跑出来确实更稳定”。
反过来,如果只是日常聊天、写文章、做简单总结,就没必要急着上调试工作台。它更偏工程调试,不是面向普通用户的一键效率工具。
另外要提醒一点:开源工具更新会比较快,命令、接口和能力边界都可能变化。真正使用前,最好看一眼官方文档和 GitHub 仓库,确认安装方式、许可证和当前版本。
最大的坑:只看 Demo,不建测试集
这类工具最容易被用错的地方,是只跑一个漂亮 Demo,然后觉得 Agent 已经稳定了。
真实业务里,Agent 的问题通常出现在边界条件:资料缺失、接口返回异常、用户问题含糊、工具权限不足、上下文太长。你不专门测这些情况,它们就会在发布后冒出来。
所以我建议把 Raindrop Workshop 当成“Agent 体检台”,而不是展示台。每次改完 Agent,都用固定任务集跑一遍,看看轨迹、失败点和最终输出有没有变好。
如果你最近也在做 AI Agent,不妨先试一个小任务:让它处理 5 份资料、调用 1 个工具、回答 3 个固定问题。跑完之后,你会更清楚问题在模型、提示词、工具,还是流程设计。
你现在做 Agent 时,最头疼的是工具调用不稳定、结果难评估,还是出了错不知道从哪一步查?