 夜雨聆风
一个轻量级的OCR工具包,支持100+语言,准确率超96%,让文档解析不再麻烦。
#OCR#Document AI#PaddleOCR#开源工具#LLM数据预处理
你有没有遇到过这种场景:手里一堆扫描的合同、PDF报告、老照片,想提取里面的文字、表格、公式,甚至直接喂给大模型做分析,结果还得一行行手动复制粘贴?或者用了一些在线工具,识别率堪忧,还动不动就收费、限制页数。
今天想聊一个我最近发现并深度使用过的开源项目——PaddleOCR。它来自百度的PaddlePaddle团队,目前在OCR领域做到了世界第一梯队,GitHub上已经拿了81k+星标,在文档解析和OCR圈子里几乎是“国民级”的存在。但大多数人可能只知道它能识别文字,其实它最新版本的能力早已超出了“文字识别”的范畴:它能把PDF、图片、甚至Word/Excel/PPT文件,直接转成结构化、大模型友好的JSON或Markdown数据。换句话说,它是连接“纸质/图像世界”和“AI世界”的一座桥。
它凭什么能超越普通OCR?
传统的OCR工具,通常只能框出文字位置,然后给你一堆带坐标的文本块。但PaddleOCR现在做的,是“文档智能解析”——它能理解文档的结构:标题、段落、表格、公式、图表,甚至印章、手写文字,然后输出一份结构清晰的Markdown文档,或者带层级关系的JSON。这意味着你不光得到了文字,还得到了“哪里是标题,哪里是表格,表格里哪一行是表头”。
这背后有两个核心引擎:
- PaddleOCR-VL
系列:这是他们自研的轻量级视觉语言模型(VLM)。最新版本PaddleOCR-VL-1.6只有0.9B参数,但在OmniDocBench基准测试上达到了96.3%的准确率,超过了绝大多数闭源大模型和专门的文档解析方案。它特别擅长处理表格、公式、古籍、生僻字、印章这些老大难问题。输出格式直接是Markdown或JSON,完全可以直接喂给LLM做RAG(检索增强生成)或Agent应用。 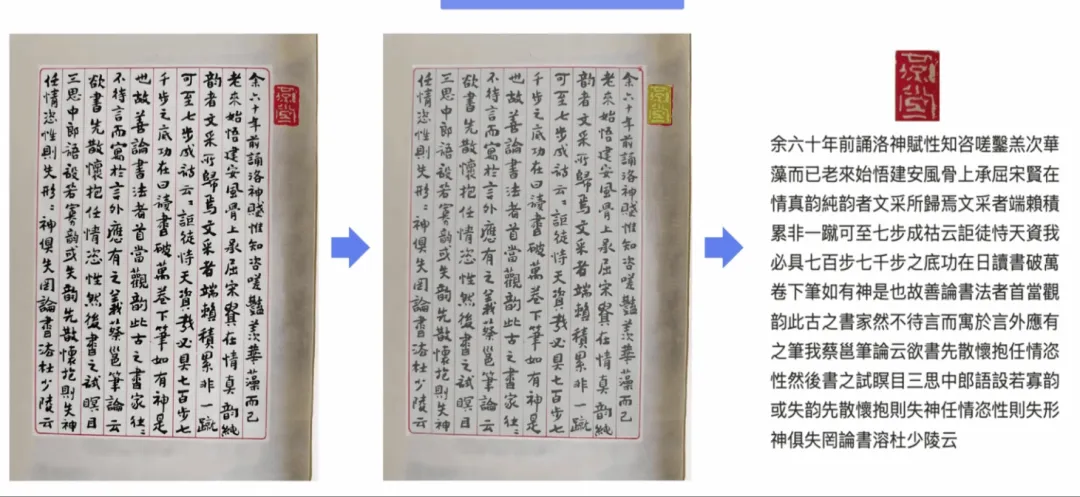
- PP-StructureV3
:如果你需要更精细的坐标信息(比如表格单元格的精确位置、每个文字块的边界),就用这条流水线。它同样能把复杂的PDF和图片转成Markdown/JSON,并且提供细粒度的位置数据,方便做自定义的后处理。 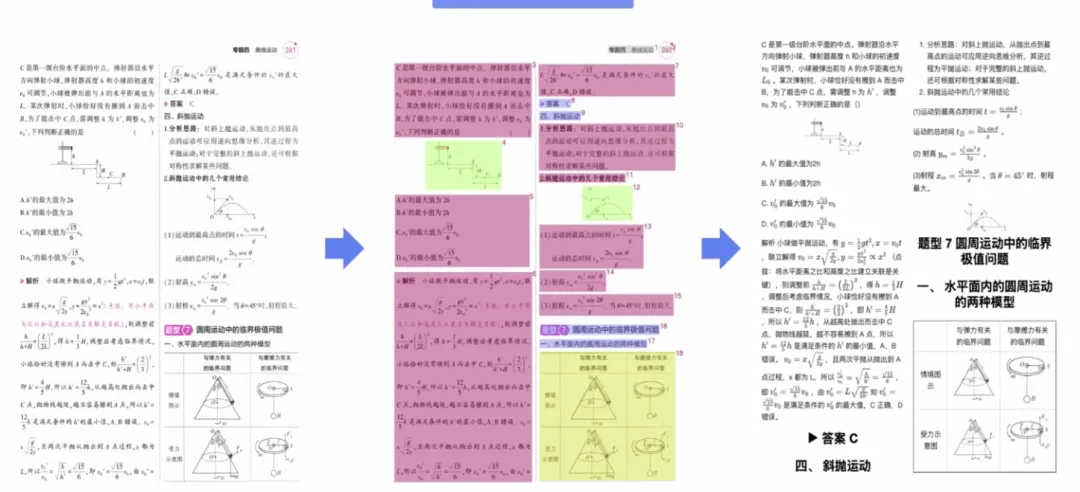
举个例子,你有一份混合了中英文、带数学公式和折线图的科研论文PDF,用PaddleOCR跑一遍,出来的是一份规整的Markdown文件:公式用LaTeX表示,表格是Markdown表格,图表区域被识别并标注了位置。这比任何“截图转文字”工具都靠谱太多了。
100+语言,连生僻字和印章都不放过
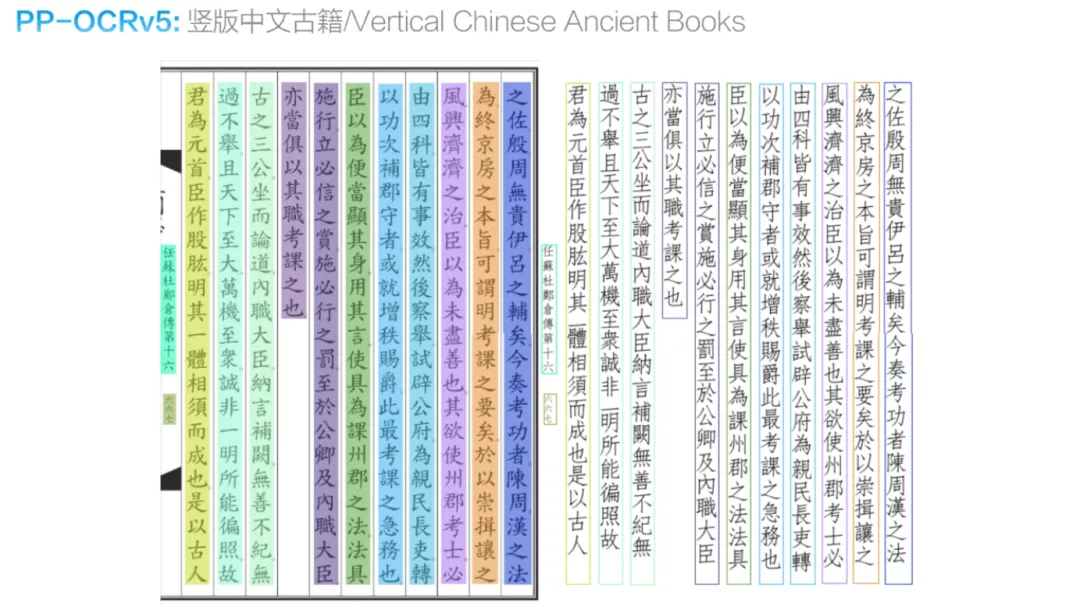
如果你做的是跨国业务、多语言文档处理,PaddleOCR的语言支持会让你省心不少。它原生支持109种语言,包括中文、英文、日文、韩文、阿拉伯文、印地文、泰文等等。而且最新的PP-OCRv5模型,一个模型就能处理中英文混合、拼音混写的场景,不需要你切换不同语言包。
识别能力上,PP-OCRv5相比上一版本准确率提升了13%,参数却只有2M(百万级),极其轻量。对于拉丁语系、西里尔语系、阿拉伯语系,改进尤其明显,有些语种的准确率直接提升了40%以上。对于古籍、生僻字、印章、手写体,PaddleOCR-VL也做了专门的增强——以前很多OCR工具对“刻在石头上的字”或者“模糊的印章印文”束手无策,PaddleOCR现在可以识别出印章中的文字,甚至能检测印章的旋转角度和位置。
一个让开发者“爽”的生态
PaddleOCR不仅仅是工具,它还是一个开放的生态。官方提供了丰富多样的集成和部署方式:
- 深度集成主流AI框架
:Dify、RAGFlow、Pathway、Cherry Studio 这些流行的AI应用平台,都内置了对PaddleOCR的支持。你不需要自己写任何接口代码,直接选它作为文档解析引擎就行。
- 多种推理后端
:不只是PaddlePaddle自家的静态图/动态图,它还支持Transformers(Hugging Face生态) 和ONNX Runtime。这意味着你可以在任何Python环境里用熟悉的API调用它。
- 前端也能用
:官方推出了 PaddleOCR.js,可以直接在浏览器里跑PP-OCRv5模型。对于一些隐私敏感的文档处理(比如发票、合同),完全可以在用户本地用JS完成OCR,数据不上传服务器。
- 从文档到Docx
:最新版本还支持把解析结果导出为 DOCX 格式,方便你在Word里直接编辑、标注。这对于需要人工审核的场景来说非常实用。
- 超轻量部署
:支持NVIDIA GPU、Intel CPU、昆仑芯XPU,甚至ARM架构。最小的模型只有2M参数,边缘设备也能轻松运行。
适合谁用?几乎每个跟“文档”打交道的人
- AI应用开发者
:做RAG、Agent、知识库类的应用,PaddleOCR是你把PDF/图片“喂”给大模型前的标准预处理工具。只要一行 pip install paddleocr,就能获得顶级解析能力。
- 数据工程师/分析师
:从大量PDF报告、财务报表中批量提取结构化数据,自动生成JSON/CSV,省去人工录入的繁琐。PP-StructureV3的精细坐标信息还能帮你做自定义的数据抽取。
- 学术研究者
:处理外国文献、手写笔记、古籍扫描件时,PaddleOCR的多语言能力和公式识别能力几乎是刚需。它还被用来做文档翻译(有专门的 PP-DocTranslation模块)。
- 普通人
:也许你只是想把一张表格照片转成Excel,或者把旧书扫描版变成可复制搜索的文本。PaddleOCR有在线体验中心,不需要写代码,上传文件就能得到结果。
上手有多简单?
如果你想快速体验,直接访问他们的官方网站(就是项目主页里那个链接),有在线体验中心和API,上传一张图片或者PDF,几秒钟就出结果。完全免费,不需要注册。
如果想在本地运行,安装就一句话:
```bash
pip install paddleocr
`
然后写三行Python代码就能识别一张图片里的文字。针对文档解析,也有详细的文档说明如何使用PaddleOCR-VL模型或PP-StructureV3。他们甚至提供了Docker镜像和C++本地部署方案,可以无缝集成到现有后端系统里。
一些让我印象深刻的细节
在最新版本3.6.0里,PaddleOCR-VL-1.6的模型架构和上一版完全一致,意味着换模型时不用改代码,直接下载更新权重就行。他们还做了自动跨页表格合并和层级标题识别——处理长文档时,不会再出现“表格被截断,合并后对不上”的尴尬。另外,官方还提供了细粒度的耗时分析工具,方便你调优部署性能。
下载好了以后,让我的Agent直接帮我处理文件夹里面的所有PDF文档并且提取成为markdown格式的文件,简直不要太爽。
写在最后
在“AI+文档”这个赛道上,PaddleOCR几乎是把开源能做到的极致都做了出来:模型强大、语言覆盖广、生态完善、文档齐全(中英文文档都很详尽)。它不像有些项目那样只是把论文模型丢出来就不管了,而是真正在解决“从图像/PDF到结构化数据”这条链条上的每一个实际痛点。
如果你正在为“如何让AI读懂文档”发愁,不妨给PaddleOCR一次机会。它绝对能帮你省掉至少一半的“洗数据”和“写转换脚本”的时间。毕竟,把时间花在真正创造价值的事情上,而不是和格式作对,才是我们使用工具的意义。
持续分享优质 AI 开源项目与源码实战,一个人摸索很容易踩坑。
对 Agent、智能体感兴趣的朋友,无论新手还是大佬,都欢迎一起交流。私信「时之」拉你进群。
想拿到仓库地址,直接动手试试?
GITHUB: https://github.com/PaddlePaddle/PaddleOCR