 夜雨聆风
别把几百篇 PDF 直接丢给 AI:GPT + Zotero + Codex 写综述的可落地流程
高亮不是综述,下载 PDF 也不是综述。真正困难的是:怎么把几百篇文献,变成几个清楚的问题、几条稳定的证据链,以及一套能写下去的综述框架。
欢迎回到《研究生生存指南》。
很多研究生写综述,第一步就走偏了。
打开 Web of Science,输入几个关键词,导出几百篇文献,全部扔进 Zotero。然后开始下载 PDF、高亮、看摘要、做笔记。
看起来很努力。
但一个星期后,常见结果是:
Zotero 里文献越来越多;PDF 下载了很多;高亮画了一大片;脑子越来越乱;不知道哪篇该放在哪一节;也不知道 GPT 到底该怎么帮自己。问题不在于你不努力。
问题在于:
你把文献当成 PDF 来管理,而不是当成“证据材料”来组织。
这篇文章不讲“如何让 AI 一键生成一篇综述”。
我更想讲一套普通研究生可以跑通的流程。
GPT 网页:负责想清楚问题、设计检索、归类文献、写章节草稿Zotero:负责存文献、存 PDF、存标签、存集合Codex:负责批量执行、整理文件、打标签、检查初稿Elicit:负责补充发现相关文献、快速查看摘要和相似研究一句话概括:
GPT 做大脑,Zotero 做仓库,Codex 做手脚,Elicit 做雷达。
01 先给结论:综述不是“AI 写出来的”,而是“流程跑出来的”
很多人用 AI 写综述,最大的问题是太早让它“直接写”。
比如一上来就说:
帮我写一篇关于 XXX 的综述。这样很容易得到一篇看起来完整、但其实很空的文章。
因为综述真正难的不是“生成文字”,而是下面这些问题:
所以我的建议是:
不要一开始就让 AI 写正文。先让 AI 帮你分类、建框架、整理证据。
综述写作更合理的顺序是:
先检索再建库再归类再打标签再按章节整理证据最后才写正文AI 的作用不是把这条链条跳过去。
AI 的作用是让这条链条跑得更快、更清楚、更不容易乱。
02 这套流程适合谁?
我的态度很简单:
AI 可以帮你省掉大量整理劳动,但不能替你承担学术判断。
03 先准备四样东西
最小版本其实很简单:
一个 Zotero 文献库;一个 GPT 网页;一个能读写本地文件的 AI 编程助手;一个用于补充检索的 Elicit。不用一开始就追求全自动。
先把流程跑通,再逐步自动化。
04 总流程先看一遍
这一张表就是整篇文章的核心。
后面只是把每一步展开。
05 第一步:先让 GPT 帮你设计检索词
确定综述主题后,不建议自己凭感觉随便搜。
很多人一开始就去 Web of Science 输入一个关键词,然后导出几百篇。
问题是:
更稳的做法是:先让 GPT 网页帮你设计检索策略。
可以直接用这条提示词:
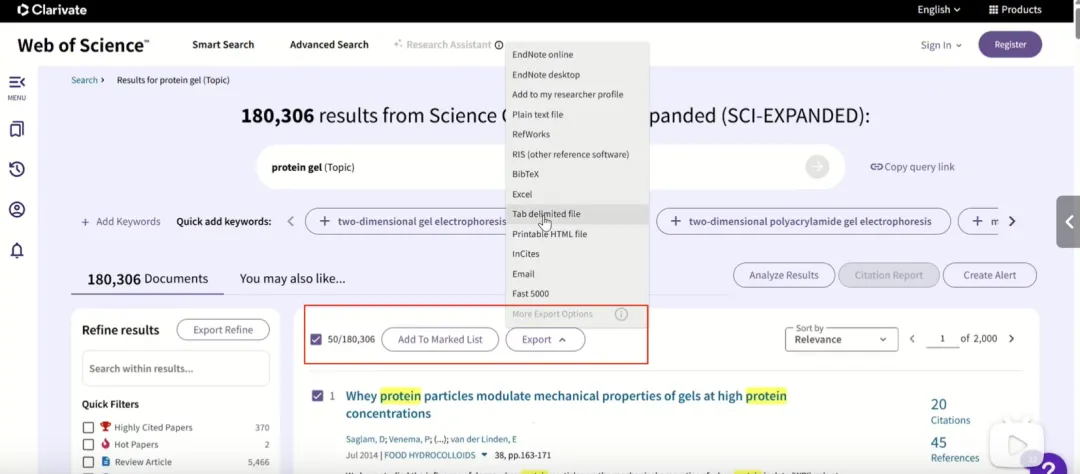
我准备写一篇关于 XXX 的科研综述。请帮我设计文献检索策略,要求:1. 以 Web of Science 为例,给出 TS= 检索式;2. 给出核心检索式、扩展检索式和近 5 年检索式;3. 列出同义词、近义词、上位词和下位词;4. 给出可能需要排除的关键词;5. 说明每一组关键词的作用;6. 如果适合,也请给出 PubMed / Scopus / Google Scholar / CNKI 的检索建议;7. 最后给我一版可以直接复制到数据库里的检索式。这里以 Web of Science 为例,但不必局限于 Web of Science。
我的建议是:
数据库负责系统检索;Elicit 负责补充发现;GPT 网页负责设计检索策略;Zotero 负责管理结果。这一阶段尽量用 GPT 网页完成,不要一开始就让 Codex 做。
原因很现实:
Codex 额度宝贵。能用 GPT 网页完成的思考任务,就先用 GPT 网页。
06 第二步:导入 Zotero,先建一个干净的文献库
检索完成后,可以先导出几批文献。
然后导入 Zotero。
导入之后,不要急着写。
先做清理:
这里要强调一点:
不要低估 Zotero 自带的“查找全文”功能。
很多 PDF 它自己就能找到。
找不到的,再考虑学校数据库、Google Scholar、ResearchGate、作者主页,或者向同学老师求助。
建议先建一个总集合:
Review_综述主题名后面的分类、标签、导出、写作,都围绕这个总集合进行。
顺藤摸瓜找神作!这款可视化文献神器,帮你挖出领域的“祖师爷”
07 第三步:不要先扔全文,先用“轻量信息”归类
文献进入 Zotero 后,不要立刻把所有 PDF 全部丢给 GPT。
这一步很重要。
很多人最容易犯的错误就是:
我有 300 篇 PDF;我全部上传给 AI;让 AI 帮我写综述。这基本等于把一堆原材料倒进锅里,然后希望它自己变成菜。
更好的做法是先导出轻量信息。
方法 A:创建参考文献表到剪切板
这是最快的方式:
Zotero 全选文献→ 创建参考文献表→ 复制到剪切板→ 粘贴给 GPT 网页参考文献表通常包含:
作者年份题名期刊DOI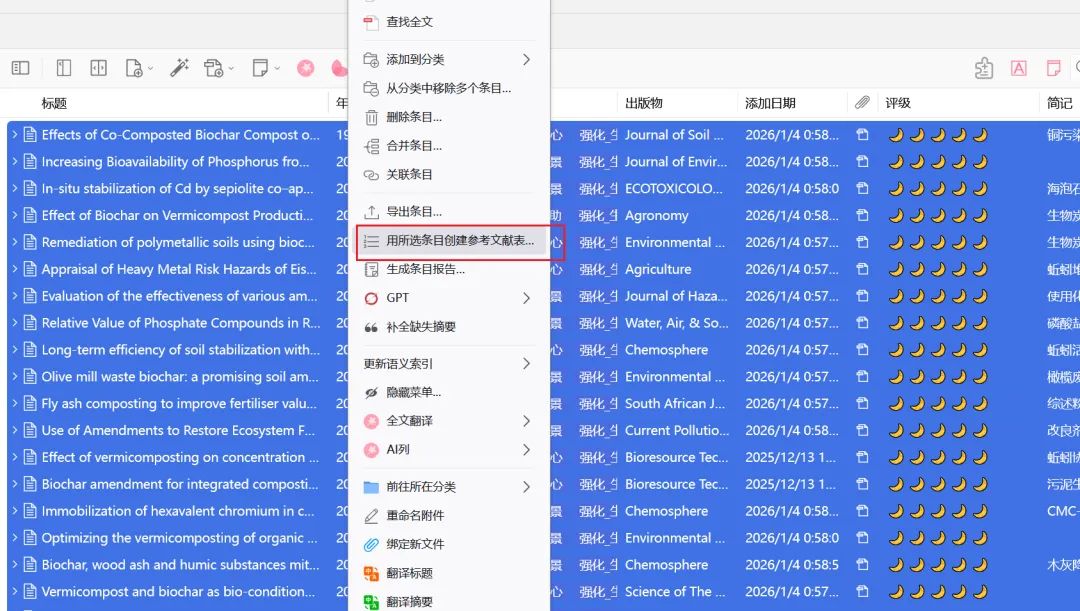
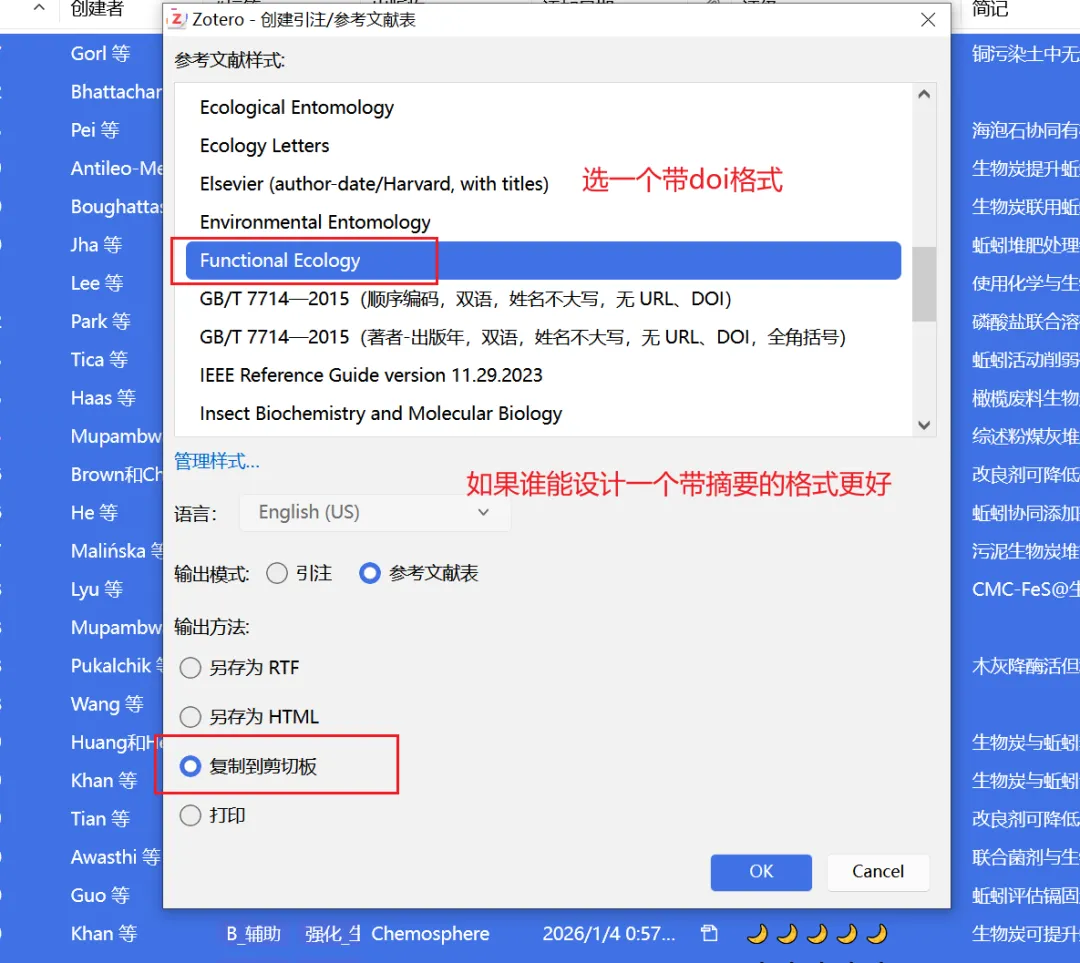
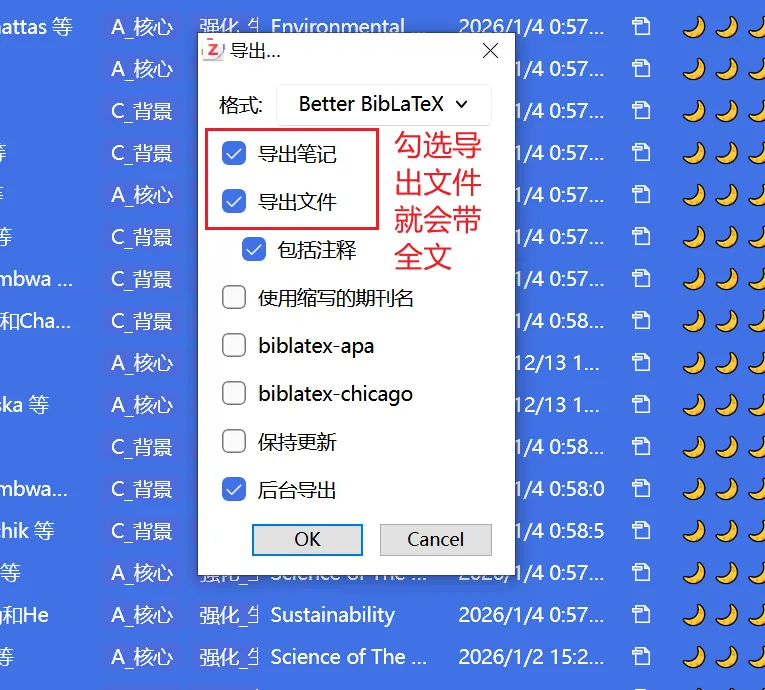
方法 B:导出不包含全文的 Better BibLaTeX
更稳的方法是导出一个不包含全文的 .bib 文件。
这个文件最好包含:
titleauthoryearjournaldoiabstractkeywords我建议准备两个版本:
初步归类阶段,不建议直接用全文版 bib。
因为全文信息量太大,容易浪费上下文,也容易让 GPT 陷入细节。
先用轻量信息把骨架搭起来。
后面再逐步加全文材料。
08 第四步:让 GPT 设计分类体系和“双标签”
把参考文献表或不含全文的 bib 文件直接发给 GPT 后,不要马上让它写正文。
先让它做两件事。
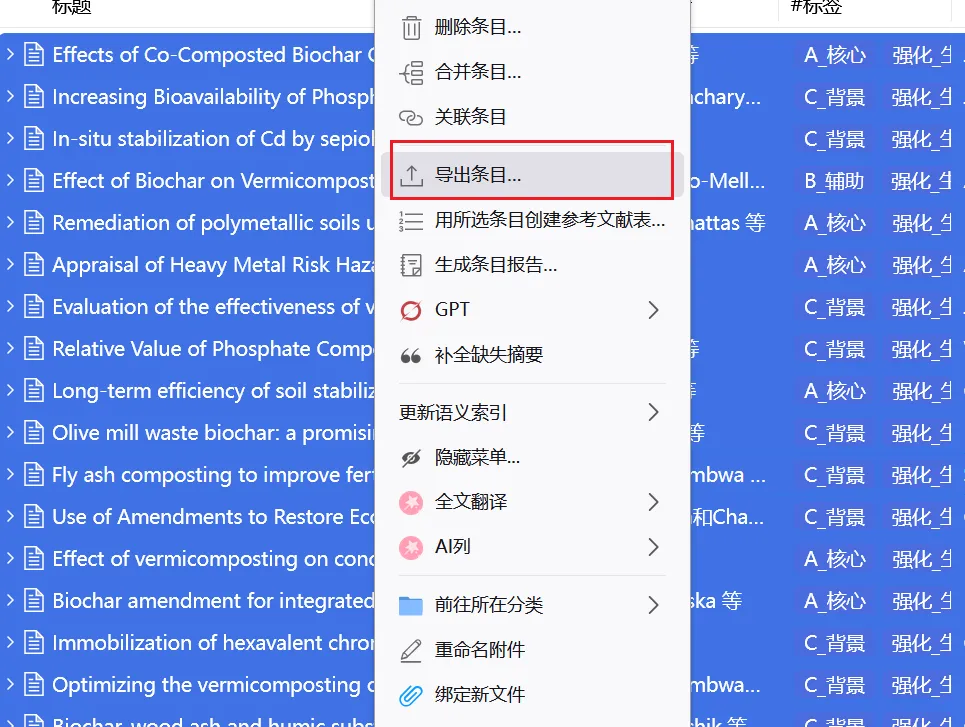
我更推荐“双标签”策略:
一个分类标签 + 一个证据强度标签例如:
这个设计非常关键。
分类标签解决的是:
这篇文献应该放在哪一节?证据强度标签解决的是:
这篇文献对我的主题到底有多重要?可以用这条提示词:
下面是我从 Zotero 导出的文献题名、摘要和关键词。我的综述主题是:XXX。请你完成以下任务:1. 判断每篇文献与综述主题的关系:直接相关 / 间接相关 / 背景文献 / 方法文献 / 综述文献 / 不确定 / 暂时排除;2. 设计 5–8 个适合综述章节的分类标签;3. 每篇文献分配 1 个分类标签和 1 个证据强度标签;4. 给出每个分类标签的含义;5. 标出需要优先精读的文献;6. 输出一个表格,列为:题名、年份、分类标签、证据强度、建议用途、备注。09 第五步:让 GPT 生成“发给 Codex 的任务单”
GPT 网页完成初步归类后,不一定要让它继续一篇篇执行。
更好的做法是:
让 GPT 直接生成一份“发给 Codex 的任务单”。
可以这样让 GPT 输出:
请根据上面的归类结果,生成一份发给 Codex 的操作指令。要求:1. 使用 Zotero 中的文献题名或 DOI 作为匹配依据;2. 每篇文献添加 1 个分类标签和 1 个证据强度标签;3. 标签格式使用 #分类_子主题 和 #直接证据 / #间接证据 / #背景文献;4. 对不确定文献添加 #不确定;5. 对暂时排除文献添加 #排除;6. 按分类标签创建 Zotero 左侧集合;7. 将对应文献移动到相应集合中;8. 不删除任何文献和附件;9. 执行前先在 5 篇文献的小集合里测试;10. 只输出给 Codex 的任务指令。这一节的核心是:
GPT 网页负责判断;Codex 负责执行。这是节约 Codex 额度的关键。
你不要让 Codex 一边理解学术主题,一边操作 Zotero。
先让 GPT 把规则讲清楚,再让 Codex 执行规则。
10 第六步:Codex 在 Zotero 里批量打标签和建集合
如果 Codex 已经接入 Zotero 插件,或者通过 Zotero MCP 连接 Zotero,就可以让它直接操作 Zotero。
Codex 可以做这些事:
推荐结构是:
例如标签:
#直接证据#间接证据#背景文献#方法文献#综述文献#不确定#排除#优先精读例如集合:
01_背景理论02_核心机制03_关键证据04_方法模型05_争议与展望这样后面写综述时,每个集合就是一个章节材料包。
需要提醒一句:
第一次不要让 Codex 直接操作整个文献库。
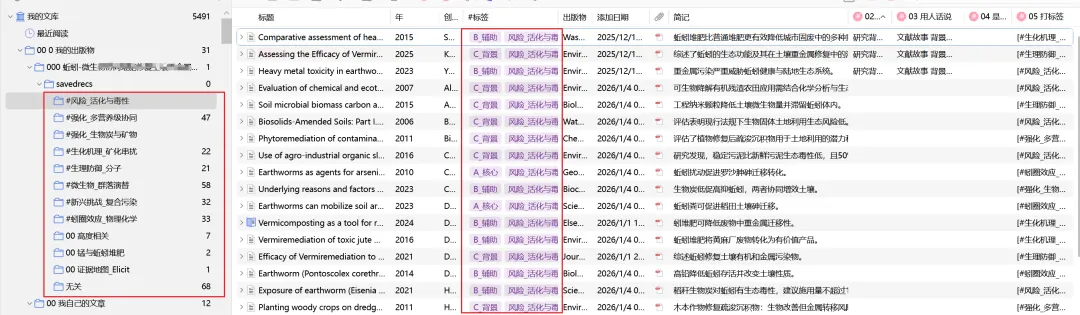 归类效果展示
这个任务也可以用WorkBuddy完成
爆改 Zotero:我用 AI 给 1140 篇综述文献批量打标签
11 第七步:按分类导出,逐章写作
文献打好标签、分好集合后,才进入真正的写作阶段。
这时先让 GPT 设计整篇综述的大纲。
然后按 Zotero 左侧分类集合,逐个导出文献。
导出的 bib 可以包含更多材料:
摘要关键词笔记注释高亮附件信息每次只处理一个分类。
正确节奏是:
一个分类→ 一批文献→ 一张证据表→ 一个章节大纲→ 一个章节草稿每一节都可以这样问 GPT:
下面是一组已经按主题分类的文献,分类主题是:XXX。请你帮我完成:1. 先生成一张证据表:题名、年份、研究对象、方法、核心发现、与本节主题的关系;2. 再总结这一类文献共同支持的 3–5 个观点;3. 标出哪些文献是直接证据,哪些只是背景材料;4. 设计这一节的小标题结构;5. 最后生成一版中文章节草稿;6. 不要编造文献信息,不确定的地方标注“需人工核对”。这里的重点是:
先证据表,再章节草稿。
如果没有证据表,AI 很容易开始顺嘴写。
有了证据表,你才知道它到底依据哪些文献在写。
12 第八步:重要文献转成 Markdown 再深读
如果某篇文献特别重要,不建议只把 PDF 直接发给 GPT。
因为 AI 读 PDF 有时会跳读。
尤其是双栏排版、图表较多、公式较多、扫描版质量一般的文章。
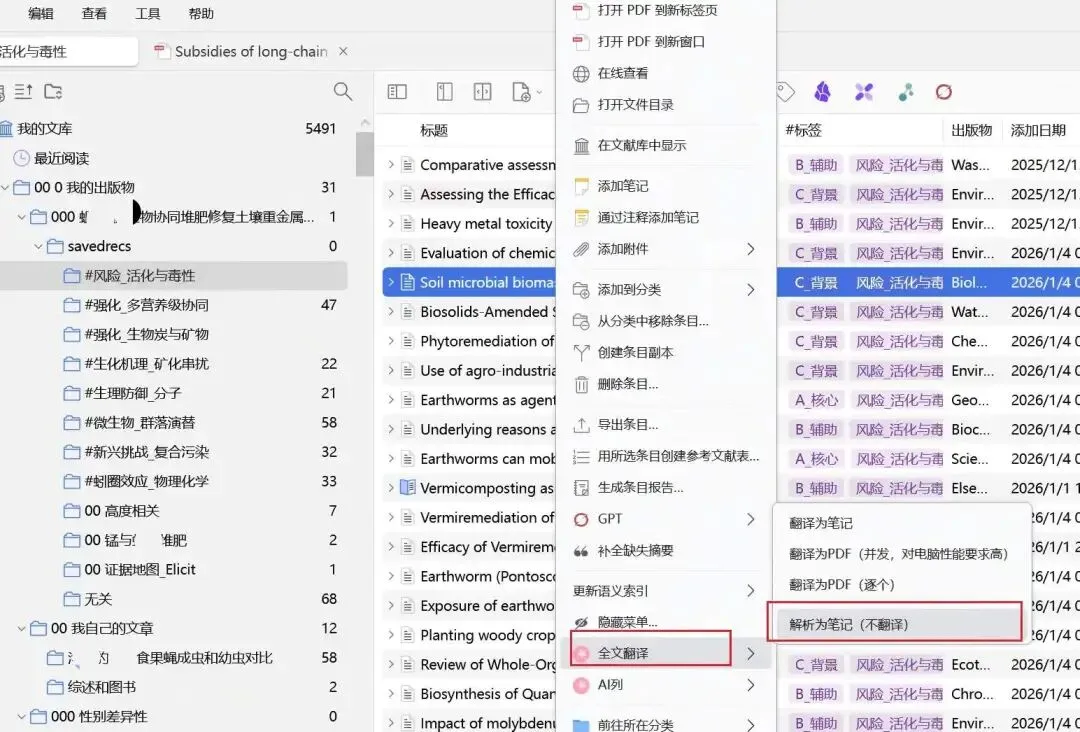
更稳的方法是:
PDF→ Markdown / 纯文本→ GPT 深度解读→ 写入 Zotero 笔记或 Obsidian 笔记对于关键文献,可以单独让 GPT 做:
研究问题总结;方法设计总结;关键结果总结;与综述主题的关系;可以支持哪一个章节;可引用观点;局限和争议;一句话评价这篇文献的价值。可以直接用这条提示词:
下面是一篇关键文献的 Markdown 文本。请你按综述写作需求进行深度解读:1. 这篇文章研究了什么问题?2. 它用了什么方法?3. 最关键的结果是什么?4. 它对我的综述主题 XXX 有什么直接贡献?5. 它更适合放在哪一节?6. 它能支持哪一句核心观点?7. 它的局限是什么?8. 请输出一段可写入 Zotero/Obsidian 的中文文献笔记。13 第九步:先写中文初稿,再改英文
我建议初稿先写中文。
原因很简单:
中文更方便自己判断逻辑。
尤其是你不熟悉的领域,如果一开始就让 AI 生成英文,可能看起来很专业,但你未必能迅速判断它哪里空、哪里虚、哪里证据不够。
中文阶段先解决这些问题:
结构是否合理;分类是否清楚;文献是否真的支撑观点;是否存在文献堆砌;每一节之间是否有过渡;综述有没有自己的框架;哪些地方需要补文献;哪些地方只是 AI 写得顺,但证据不足。等中文初稿稳定后,再让 GPT 改成英文版。
不要反过来。
如果中文逻辑都没站住,英文越漂亮,越容易把问题藏起来。
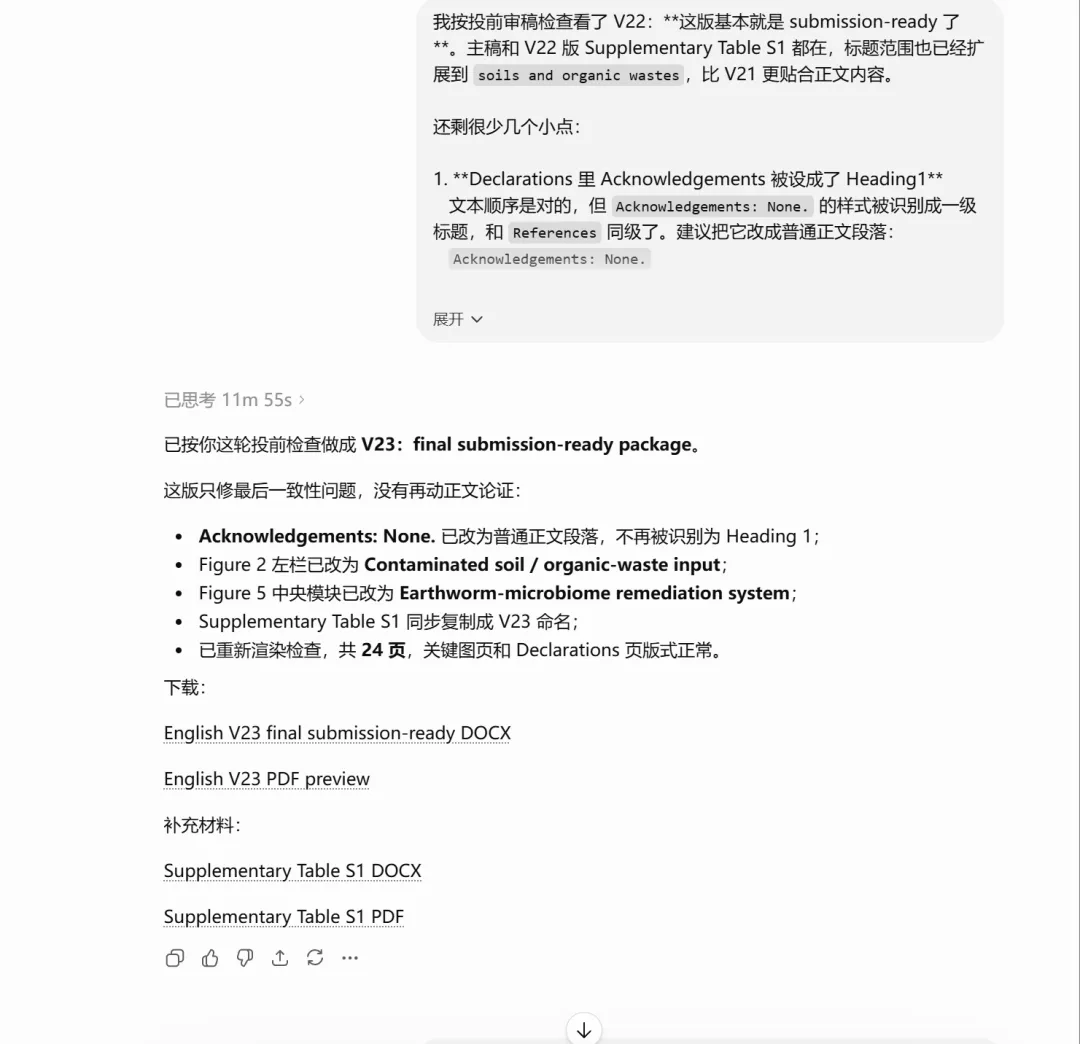
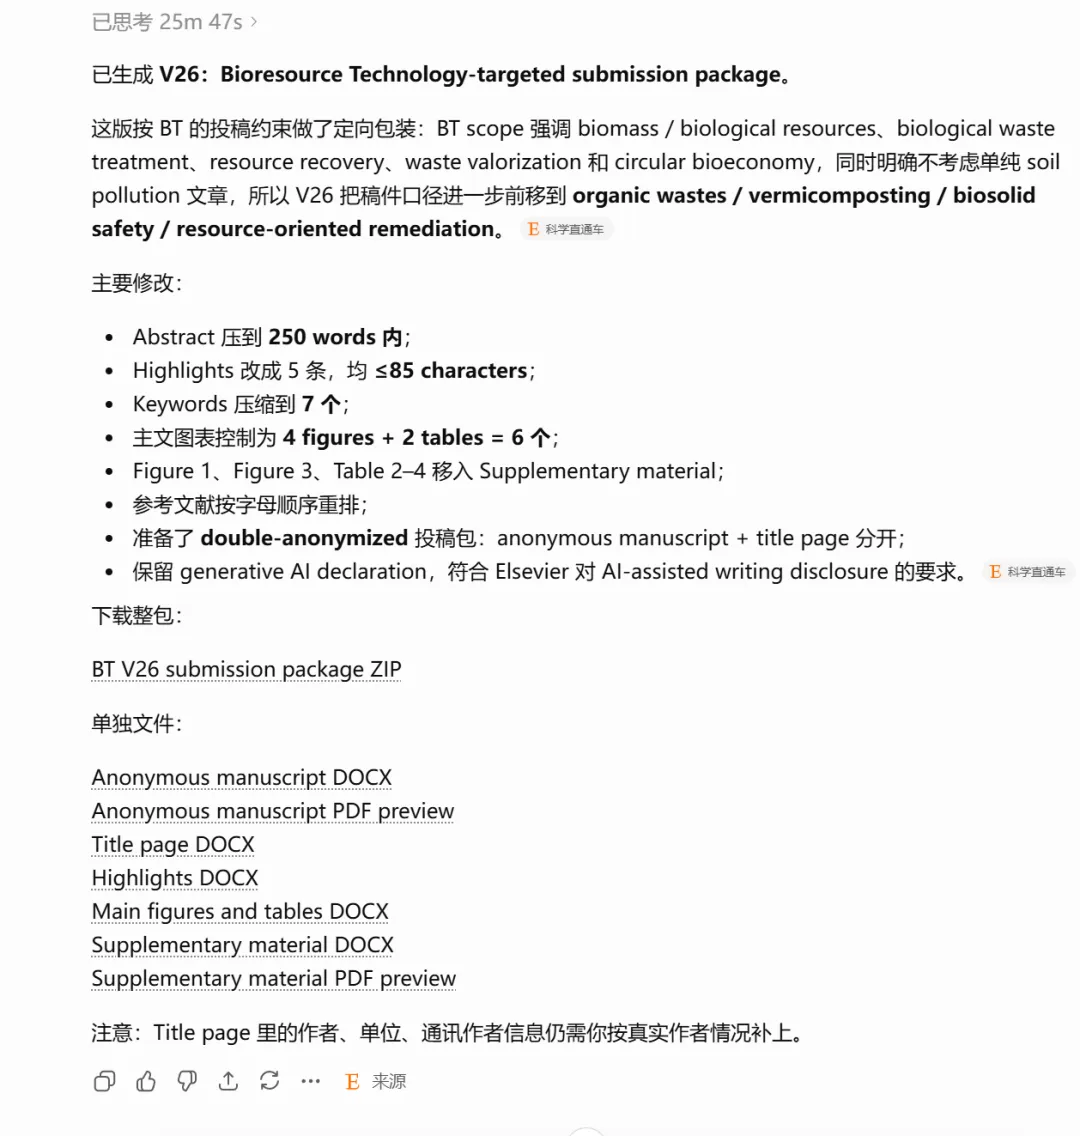
让GPT / Codex 提修改意见,反复迭代,不断生成新版本,而且是直接让gpt生成文档。
14 第十步:表格、机制图和投稿版放在后期
正文结构基本稳定后,再让 GPT 辅助生成:
需要提醒的是:
AI 生成的图片更适合作为草图,不一定适合直接投稿。
有些期刊对 AI 生成图片比较敏感,甚至可能不接受。
更稳的做法是:
AI 生成概念图草稿→ 自己用 PowerPoint / Illustrator / BioRender 重画→ 人工调整术语、箭头、配色和版式→ 再用于投稿这样既能保留 AI 帮你梳理结构的优势,也能降低投稿风险。
15 常见错误与改法
16 可拆成哪些 Codex Skills?
如果只是偶尔写一篇综述,不一定要把流程做成 Skills。
但如果你 Codex 额度比较充足,或者经常要写综述、带学生写综述,这条流程非常适合拆成多个 Codex Skills。
这样做的好处是,每一步都有固定规则。
不是每次都临时问 AI:
你帮我看看这些文献怎么分类?你帮我想想这篇综述怎么写?你帮我检查一下这个初稿有没有问题?而是把常用流程沉淀成可以复用的工作模块。
以后再写新的综述,只需要换主题、换文献库、换目标期刊,底层流程不用每次重搭。
别再人工肉眼比对了!Zotero 终极杀招:一键生成高颜值「文献矩阵」!
17 最终简化版流程
确定主题→ GPT 网页设计数据库检索式→ Web of Science / PubMed / Scopus / CNKI / Elicit 等检索文献→ 导入 Zotero→ 去重、补 DOI、补摘要、查找全文→ 导出参考文献表或不含全文的 bib→ GPT 网页初步归类并设计双标签→ GPT 网页生成发给 Codex 的打标签指令→ Codex 通过 Zotero 插件或 Zotero MCP 批量打标签→ Codex 创建 Zotero 分类集合并移动文献→ 人工检查标签和集合→ 按分类导出包含全文 / 笔记 / 附件信息的 bib→ GPT 网页逐分类生成证据表和章节草稿→ GPT 合并中文初稿→ GPT / Codex 提修改意见→ 反复迭代→ 生成表格、机制图、英文版和目标期刊格式→ 人工把关→ 投稿版本如果嫌长,可以记住这四句话:
18 最后说几句实话
这套流程看起来步骤很多,但真正难的不是工具。
难的是你要改变一个习惯:
不要把综述理解成“读完很多文献后写一篇文章”。
更准确地说,综述是:
把一批文献整理成几个问题;把几个问题整理成几条证据链;把几条证据链整理成一个解释框架。AI 能帮你的,正是中间那些很耗时间的整理工作。
它可以帮你初筛,帮你归类,帮你生成证据表,帮你发现重复,帮你把一堆材料变成章节草稿。
但它不能替你判断:
这个问题值不值得写;这篇文献是不是可靠;这个观点有没有证据;这个框架是不是你自己的理解。所以不要把几百篇 PDF 直接丢给 AI。
先让文献进入 Zotero。
再用标签把它们变成结构。
最后再让 GPT 按结构写。
这才是 AI 时代比较现实的综述写法。
Codex 连通 Zotero:AI 终于不用再“假装”读过你的文献库了!
结尾金句
PDF 是原料,标签是结构,证据表是骨架,综述才是成品。
获取更多指南
如果你想继续看这类 Zotero × GPT × Codex × 综述写作 的实操指南,可以关注公众号,在后台回复:
综述我会把后续整理好的内容放在一起,包括:
—— 蜘蛛侠 / 专注科研效率与逻辑升维 🕷️
如果觉得有用,欢迎点个“在看”,也可以转给正在写综述的同门或课题组同学。