大家在看 AI Agent 相关内容的时候,一定会看到过“ 工具调用 ”和 Function Calling 这两个概念,但其实很多人并没有真正理解这两个概念。 这篇文章从实际工程角度,把 Agent 为什么需要工具调用,到 Function Calling 的工作机制讲清楚。 文章开始之前,先抛出几个AI Agent面试中的高频问题,大家可以先思考: 1、为什么 Agent 必须调用工具?
2、工具调用解决了什么问题?
3、Function Calling 的工作机制是什么?
4、有哪些工程风险和坑?
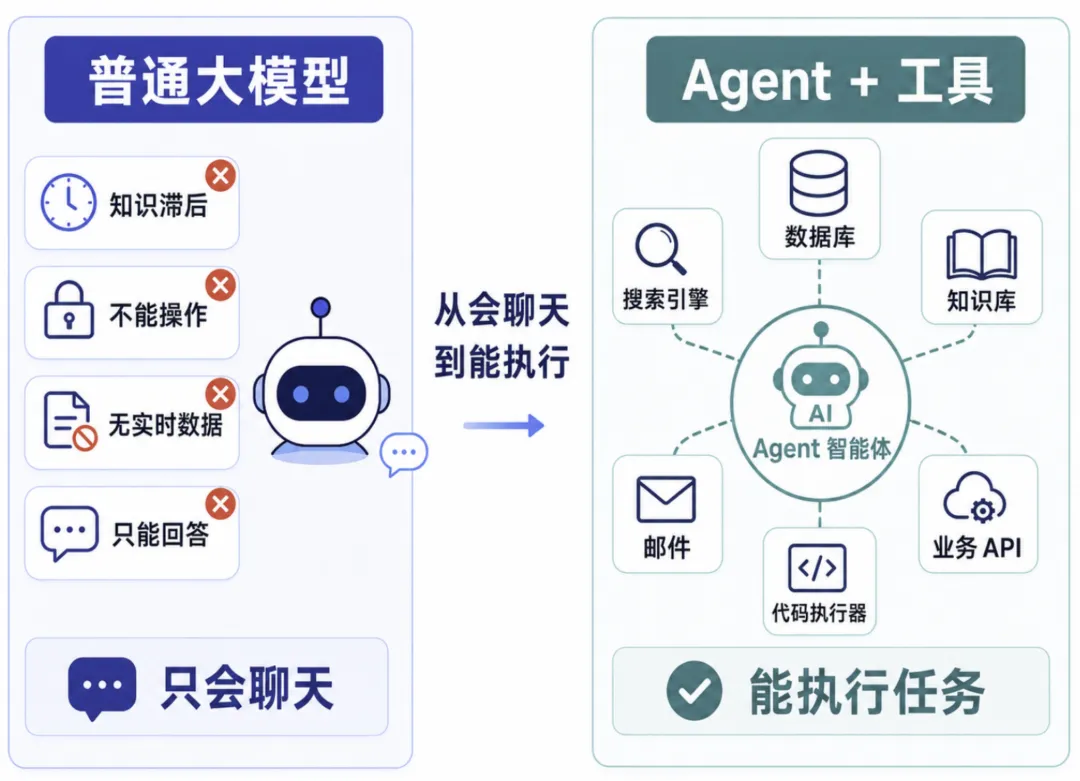
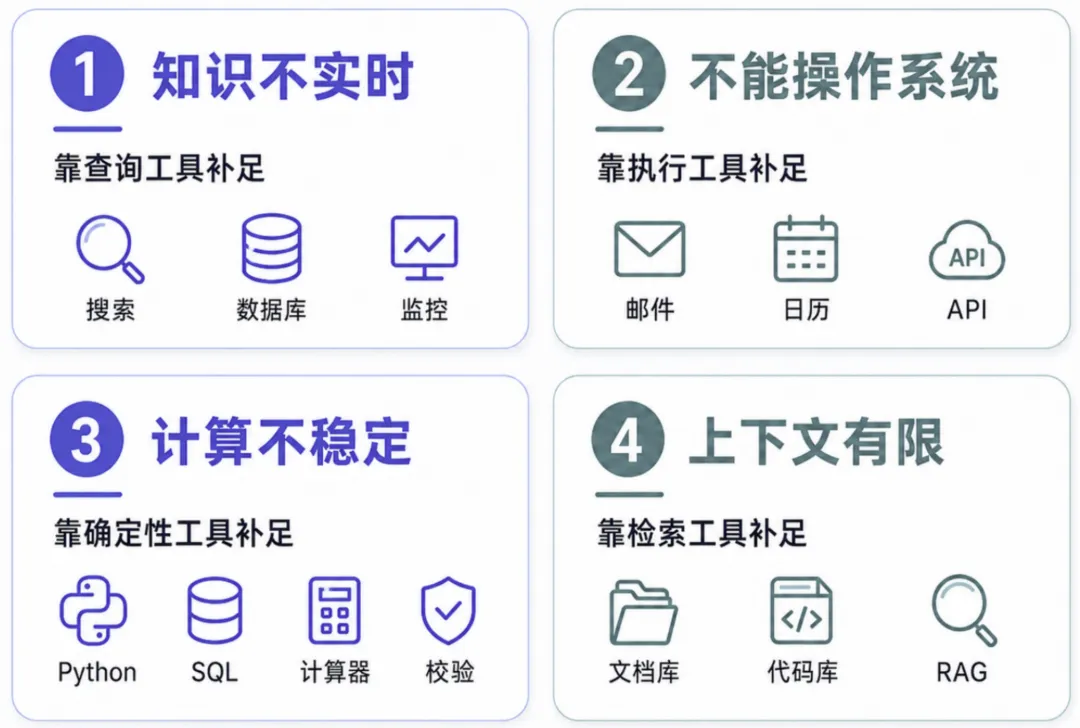
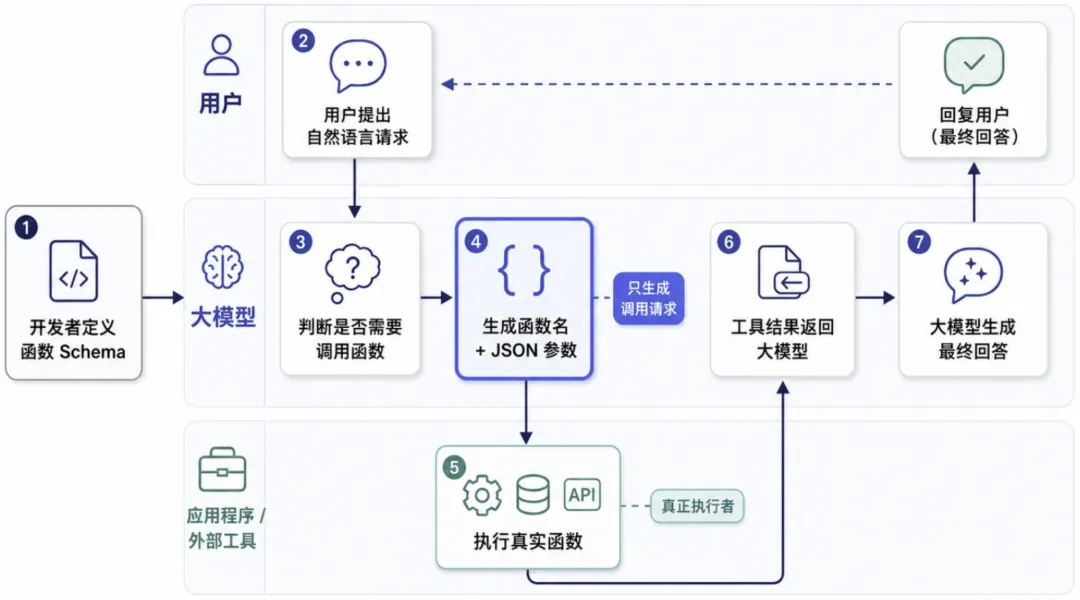
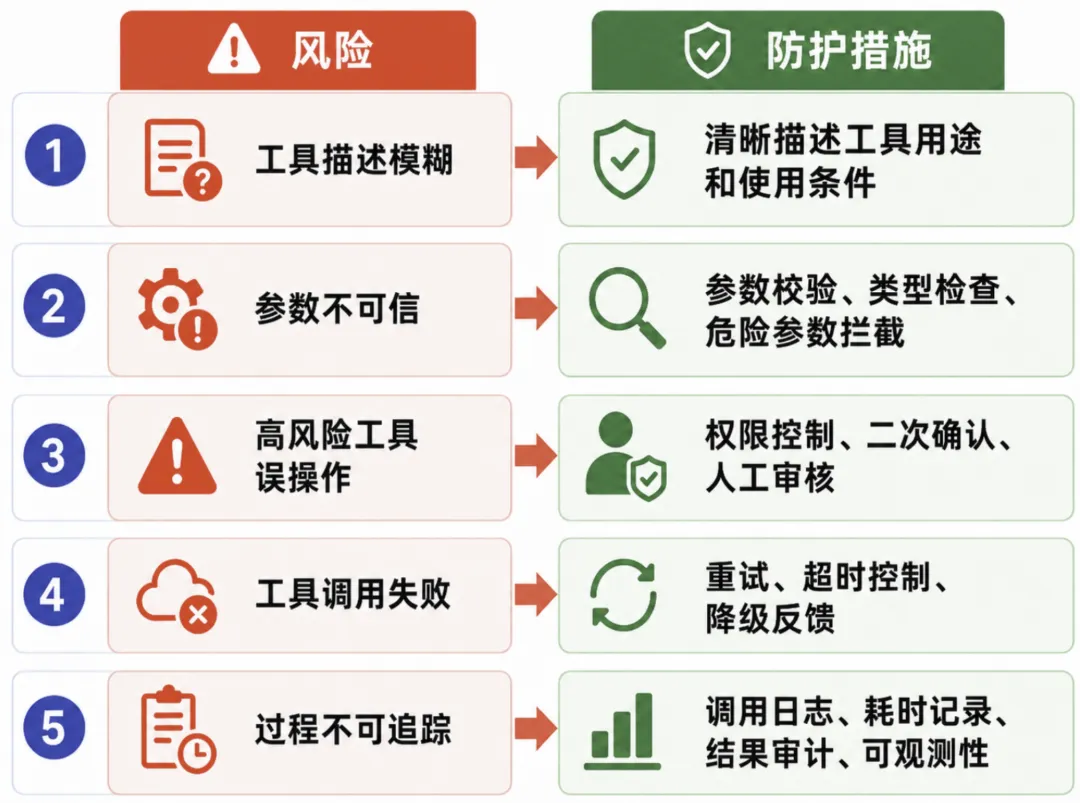
如果能搞清楚这几个问题,那么说明你对工具调用和 Function Calling这两个概念理解到位了。 一、为什么 Agent 需要调用工具? Agent 需要工具调用,是因为大模型本身主要具备语言理解、推理和生成能力,但它 不能可靠获取实时信息,也不能直接操作外部系统 。 比如查询数据库、访问业务接口、检索企业知识库、执行代码、发送邮件、创建工单等, 都需要通过工具完成 。 在 Agent 架构里,大模型更像大脑,负责理解用户意图、任务规划和决策;工具更像眼睛和手, 负责获取外部信息和执行真实动作 ,通过工具调用,Agent 才能完成复杂任务,而不是只能生成文本。 二、工具调用解决了什么问题? 1、大模型的知识不是实时的 大模型的知识来自训练数据。模型训练完成后,它并不会自动知道最新世界发生了什么。例如,如果用户问今天北京天气怎么样?现在某只股票价格是多少? 这些问题, 大模型仅凭记忆是没法准确回答的 ,所以大模型是需要实时数据的,在工程实践中,常用的获取实时信息的系统有: 搜索引擎、数据库、日志系统、监控平台、订单系统、工单系统、企业知识库 ,这些系统可以对外提供工具给大模型来调用查询实时信息。 2、大模型不能直接操作外部系统 想象一个场景,如果你要求Agent帮你给客户发一封邮件或者创建一个明天下午三点的会议,对于这些需要执行的任务,如果没有工具,Agent是没法完成的,这些场景就需要提供邮件工具、日历工具给大模型来用。 3、大模型做精确计算和验证并不可靠 虽然大模型的推理能力很强,但其实并 不适合去做强确定性的计算任务 ,例如复杂的数学计算、JSON Schema 校验和代码执行结果验证这些任务,这些场景应该交给工具去完成。 例如,如果你让Agent分析销售数据,大模型应该去调用Python、SQL分析工具去执行,因为这些工具的结果会更可靠,也就是说 需要准确结果的地方应该让工具去做 ,如果需要解释和表达的地方的话就交给大模型去做。 4、大模型上下文长度有限 在真实的实践场景中,企业内部的文档代码仓库、日志系统,这些数据都非常大,不可能一次性全部塞给大模型。 所以这个时候Agent需要去用检索工具,然后去找到相关的文档片段,这就是RAG的基本思想,本质上就是一种典型的工具调用场景。 三、什么是 Function Calling?工作机制是什么? Function Calling 其实是 工具调用的工程实现方式 ,开发者先把外部能力封装成函数,通过函数名、函数描述和参数 Schema 注册给模型。 用户发起任务后,大模型判断是否需要调用函数。如果需要,它会生成结构化的函数调用请求,包括函数名和 JSON 参数。 应用程序拿到这个请求后, 负责真正执行函数 ,比如查数据库、调接口或检索知识库,执行结果再返回给大模型,大模型基于工具结果生成最终回答。 为了帮助理解,下面举例说明一个 Function Calling 的完整工作流程: 1、定义工具 这一步的作用是告诉大模型有哪些工具可以用,有固定的函数定义格式,比如有一个查询订单物流的工具: { "name" : "query_order_logistics" , "description" : "根据订单号查询订单物流状态" , "parameters" : { "type" : "object" , "properties" : { "order_id" : { "type" : "string" , "description" : "订单号" } }, "required" : [ "order_id" ] } } 2、用户提出自然语言请求 比如用户问:帮我查一下订单 123456 的物流状态 3、模型生成函数调用请求 这一步就是大模型 把用户自然语言描述的任务转换为函数名和JSON参数 ,对于这个任务,大模型会判断需要调用查询物流订单工具,并且提取出订单号这个参数,会输出下面的这种结构化JSON: { "name" : "query_order_logistics" , "arguments" : { "order_id" : "123456" } } 4、应用程序执行真实工具 这一步是应用程序拿到这个函数调用请求,根据请求真正去执行后端逻辑,就是调用对应的查询物流订单接口,这里要注意的是这个函数不是大模型执行的,是你的应用程序执行的。 5、工具结果返回大模型 当应用程序调用工具后,会把结果返回给大模型,通常也是结构化的结果,例如: { "status" : "运输中" , "current_location" : "杭州转运中心" , "estimated_delivery_time" : "明天下午" } 6、大模型生成最终回答 这一步就是大模型根据原始的任务请求还有工具的返回结果,最终生成用户能够理解的回答:“订单 123456 当前正在运输中,目前位于杭州转运中心,预计明天下午送达。” 上面这就是Function Calling的完整流程,其实并不复杂,本质就是让大模型把用户的自然语言任务,转换成可执行的函数调用参数。 四、工程落地时要注意哪些坑? 1、工具描述不能太模糊 大模型会根据工具的描述去选取工具,如果工具描述太简单,大模型可能就会选不对工具。 { "name" : "queryData" , "description" : "查询数据" } { "name" : "queryOrderById" , "description" : "根据订单号 ID 查询订单详情,仅当用户提供明确 ID 时使用" } 2、参数必须校验 大模型生成的参数并不是完全可靠的,可能会出现字段缺失、类型错误或者是参数超出范围这种问题,所以 在后端系统里一定要好做参数校验 ,不能直接信任模型的输出,比如要做一些订单号不能为空的校验,或者是拦截危险参数这种。 3、高风险工具必须加权限控制 有一些工具不能让AI去自主执行,比如删除数据、修改生产配置,或者发起支付这种工具,这些操作必须要加上一些权限二次确认或者是人工审核这种机制,否则的话如果出现错误的操作,那么影响就会非常大,有可能直接提桶跑路。 4、工具调用失败要有降级机制 在真实业务系统中,工具调用可能会失败,例如接口可能会超时、数据库异常或者第三方系统不可用这些问题,对于这种场景,Agent要给出合理的反馈,比如:当前日志系统暂时不可用,我无法查询实时日志。要保证应用不能直接崩溃,这就是降级能力。 5、工具调用过程要可观测 在生产环境中需要记录模型调用了哪个工具、传入了什么参数、工具返回了什么结果、调用是否成功、耗时是多少,如果不记录这些,如果Agent回答错误,那就很难排查到底模型问题还是工具问题。 我是 AgentGuide,大厂在职资深开发,后端转 AI Agent 开发。 持续分享 Agent / 大模型应用的优质面试题和答案解析。 如果你也在准备 AI 应用开发、大模型工程相关面试,可以继续关注后续系列。
 夜雨聆风