夜雨聆风
导读:Octop 是腾讯云开源的自托管 AI 助手平台,支持多用户、多 Agent 协作。OctopMemory 是其记忆内核,通过证据溯源、冲突检测、分层存储和受控召回,让 Agent 的记忆从“能存能搜”走向“可信、可控、可迁移”。
Octop 是腾讯云自研并开源的 AI 助手平台,专为个人、家庭和小团队设计。
Octop 项目地址:
github.com/TencentCloud/Octop
它的核心理念是本地优先、数据归属用户:一个进程即可运行 Web 面板、CLI、IM 通道和定时任务,所有对话、工作区和凭证都存储在用户自己的机器上,不经过第三方服务器。
Octop 支持多用户隔离、多 Agent 并行,每个 Agent 可配置不同的大模型和工具集,还内置了专家库、远程桌面、浏览器自动化等能力。你可以把它理解为——一个跑在自己机器上的、可定制的 AI 团队。
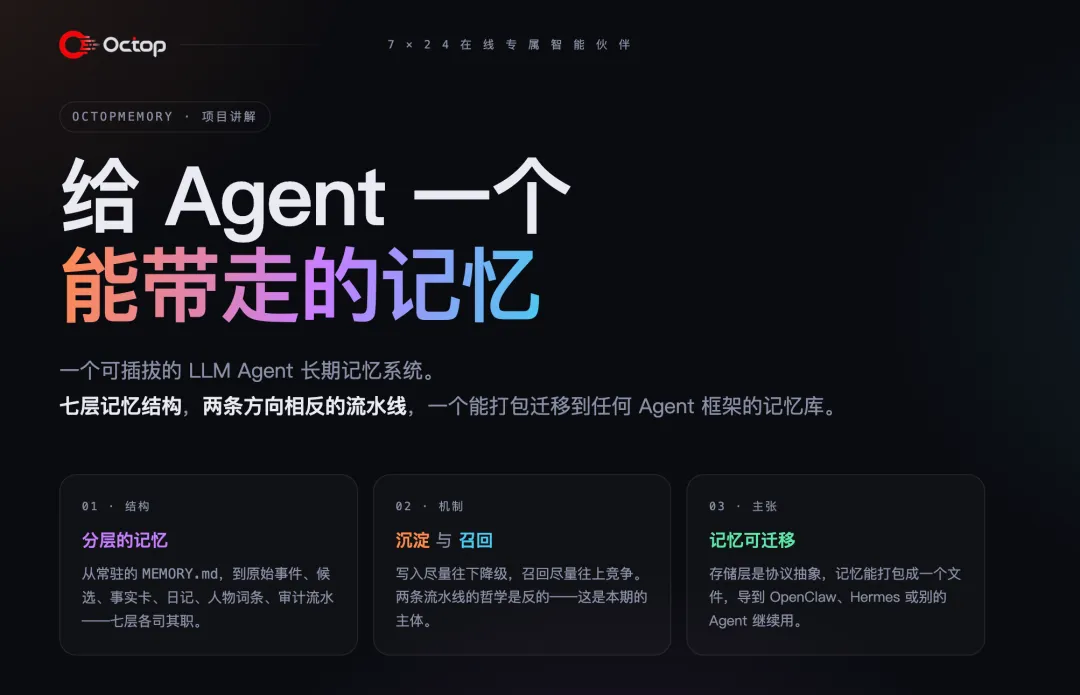
而 OctopMemory,是 Octop 的记忆内核。它要解决的不是“让 Agent 记住”,而是“让 Agent 记对”。
在实际使用中,Agent 记忆出错往往不是因为“忘了”,而是因为“记混了”。
一个典型场景:你对 AI 助手说过“这个项目暂时先别上 Postgres,本地 SQLite 够用”。两周后再问,它却回答“用 Postgres 做主库”——因为三个月前你确实这么说过,只是后来方案变了。
AI 同时检索到了新旧两条记忆,却无法判断哪条仍然有效,于是选了一条看起来更完整的。
它没有忘记,但它记错了。
忘记,最多让你再说一次;记错,可能让一个过期结论变成下一步行动的依据。
当记忆越来越多,新的问题浮现:
找到的内容,是用户原话,还是模型的改写? 新旧事实冲突时,该信哪一条? 一段经历和一个稳定事实,应该混在一起吗? 记忆换到另一个 Agent,还能继续使用吗?
OctopMemory 正是对这些问题的重新回答。它不再是某个助手内部的记忆模块,而是一层可以独立接入不同 Agent 的长期记忆基础设施。目标是:
让每条记忆有证据、有状态、有层次,并且真正属于用户。
模型抽取事实时会改写,而改写最容易丢掉语气。
“暂时先别上 Postgres”,可能被压缩成“使用 Postgres”。只少了一个“别”字,意思正好相反。
所以在 OctopMemory 里,原始对话首先会作为 RawEvent 保存。它只追加、不改写,是后续所有记忆的证据源。
模型从中提取出 Candidate,通过价值、证据、实体、重复和冲突检查后,才会成为正式的 AtomCard。
最终留下的不只有整理后的结论:
该项目暂不使用 Postgres,先用本地 SQLite
它旁边还会保留用户原话:
“暂时先别上 Postgres 了,本地 SQLite 够用”
模型可以整理表达,但不能把证据改没。
一条无法溯源的记忆,和一次写得很像真的幻觉,没有本质区别。
如果系统里已经有一条旧记忆:
该项目使用 Postgres 做主库
新决定到来时,OctopMemory 会检测两者是否冲突。
它不会让模型静默覆盖,而是把冲突交给人确认。
确认后,新事实生效;旧事实不会消失,而是被标记为“已被替代”,并退出默认召回范围。
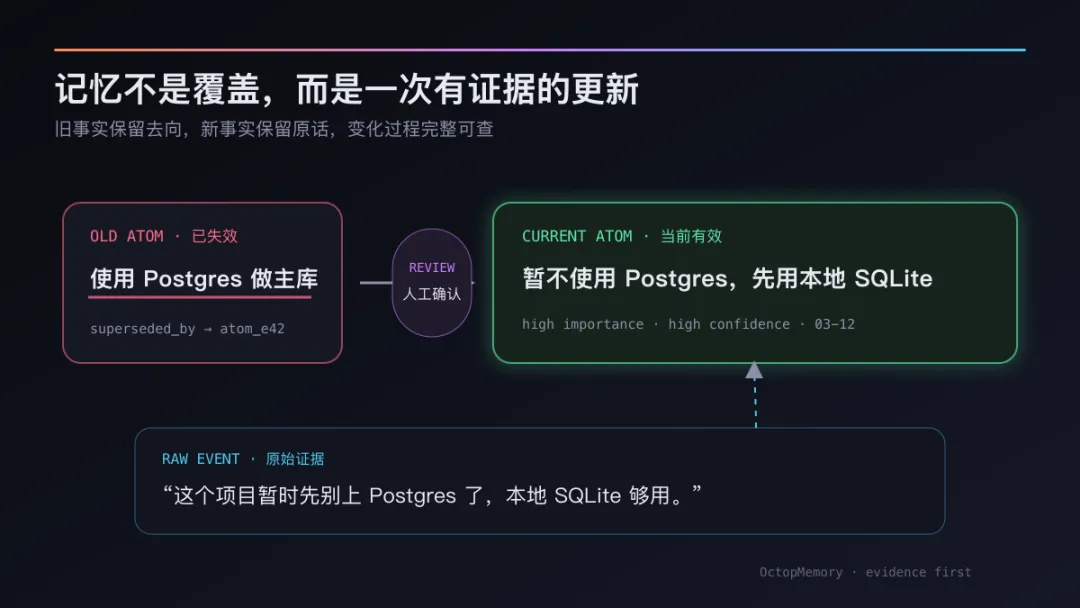
什么时候变化、依据哪句原话、旧结论被什么替代——都有迹可循。
这样,两周后再问:
“那个项目数据库当时怎么定的?”
Agent 拿到的是当前有效的决定、时间和原话证据。那条已经过期的 Postgres 方案,不会进入候选列表干扰模型判断。
记忆不是一张可以反复擦写的纸,而是一段有来路、有变化、有去向的历史。
OctopMemory 的底层是一棵 root → branch → leaf 的记忆树。
树适合人理解和整理:一个人、一个项目、一个长期主题,都可以拥有自己的分支。
但树上的 leaf 不再保存另一份事实副本,而是指向 AtomCard,读取时再投影出内容。
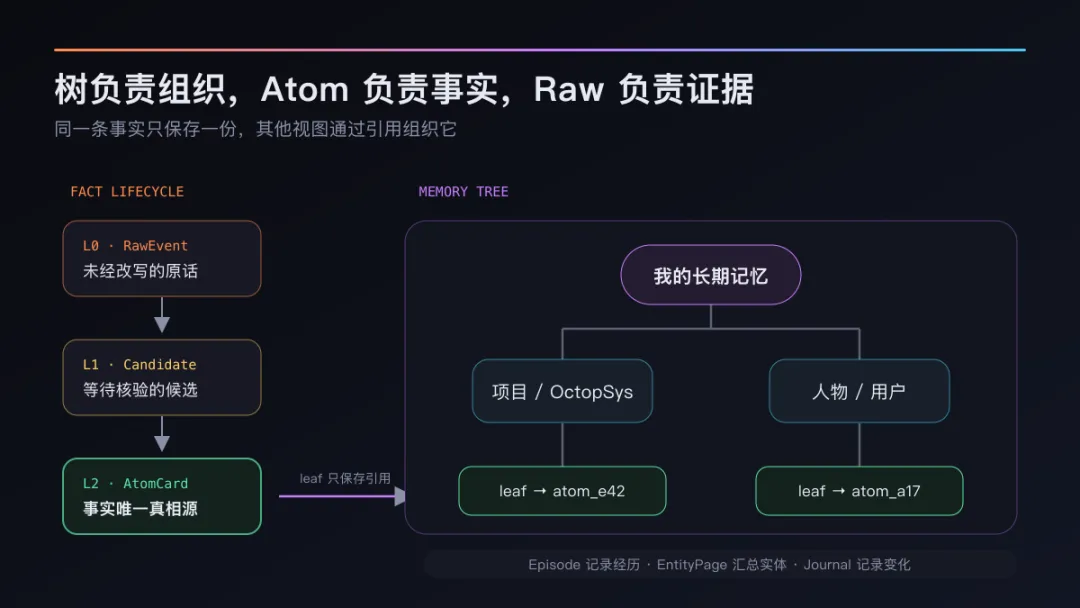
这样,同一个事实不会在两个地方各存一份,改着改着变成两个版本。
在树之外,记忆还有清晰的层次:
- RawEvent
保存原始证据 - Candidate
保存等待核验的候选 - AtomCard
是当前事实的唯一真相源 - Episode
保存生活事件和情绪经历 - EntityPage
汇总一个人、项目或组织的相关事实 - Journal
记录每一次晋升、冲突、替代与清理
一句“我老婆叫小丽”和一句“我上周跟老婆吵架了”,因此不会再被混成同一种数据。
前者是需要核验的稳定事实;后者是需要被理解的生活经历。
系统不仅要拥有记忆,还要知道不同记忆应该被相信到什么程度。
长期记忆越积越多,不可能每轮全部塞进上下文。
OctopMemory 把写入和召回设计成两个相反方向:
- 写入宁可多记。
漏掉的记忆通常没有第二次机会,多记的内容之后还能去重和清理。 - 召回必须克制。
所有候选互相竞争,只有最相关、最重要、最可信、时间上最合适的内容才能进入提示词。
召回会解析问题、识别实体和时间范围,从事实、原话、实体摘要、生活事件以及可选的向量索引中收集候选,再经过重排、去重、多样性控制和 token 预算裁剪,生成一份可以直接交给 Agent 的精选摘要。
默认情况下,整个过程要在 200 毫秒、1500 token 内完成。
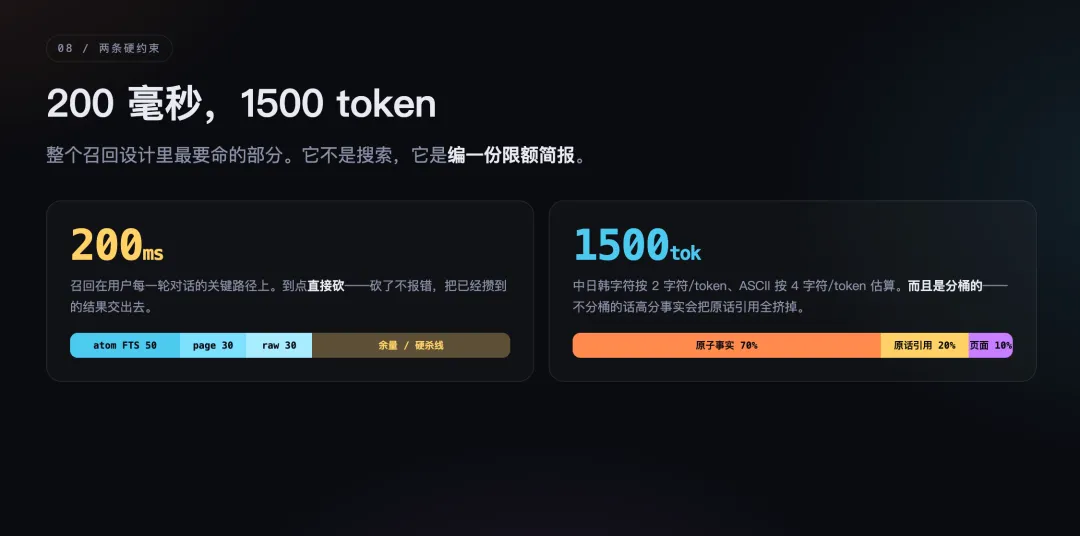
到达时限即交付当前最优结果,超出预算的部分按优先级裁剪;预算中会专门给用户原话留出空间,避免整理后的结论把证据全部挤走。
搜索解决的是“找得到”,记忆召回解决的是“此刻最应该想起什么”。
如果记忆只能留在某一个 Agent 里,它更像平台的资产,而不是用户的资产。
OctopMemory 因此把存储抽象成 MemoryBackend 协议。
核心只依赖 Python 标准库和 SQLite,默认使用 SQLite + FTS5;也可以切换到 PostgreSQL,或接入 Chroma、Qdrant 等可选向量索引。
它同时提供面向不同宿主 Agent 的适配层,也可以被其他 Agent 通过 Memory 或 MemoryService 接口直接接入。
整套记忆还能打包成一个 .hmpkg 文件,再导入另一个宿主环境。导入过程支持备份、幂等执行和完整性校验。
你更换模型、框架或 Agent 时,过去积累的事实、经历和偏好,不必全部从零开始。
记忆应该是用户的资产,不应该是某个 Agent 厂商的护城河。
一次记录,随处检索;换个 Agent,记忆也能一起走。
好的 Agent 记忆,不是把所有对话都永久保存,也不是为每个问题搜索出最多的结果。
它应该知道:
哪些内容只是说过,哪些已经核验 哪些事实仍然有效,哪些已经被替代 哪些是稳定事实,哪些只是某段经历 此刻应该想起什么,又应该忘掉什么 这些记忆从哪里来,最终又属于谁
我们想做的,不是一个什么都不忘的 AI。
而是一个知道什么是真的、什么已经改变、什么值得在此刻被想起的 AI。
Octop 项目地址:
github.com/TencentCloud/Octop
扫码加入 Octop 用户服务群 3:
如果你也在做 Agent、长期记忆或个人 AI,欢迎来提 Issue,或者扫码进用户群交流。
毕竟——
AI 最危险的不是忘记,而是带着十足的把握,记住了一个错误答案。
Lighthouse Agent焕新升级:管理更统一