ARTICLE · 948076
vLLM-Omni 分布式逐层卸载:64 GB 显存跑 124 GB 的 DiT 视频生成模型
124 GB 的 DiT 模型跑在 64 GB 的卡上。逐层卸载压住了显存,代价却转嫁到 host 侧:每个 DP rank 各存一整份权重,DP4 就要 496 GB 内存。vLLM-Omni 把 host 侧也切开——权重按 rank 分片,运行时用 AllGather 逐层重建,双缓冲预取保证设备上只驻留 2 层。实测冷启动 cgroup 峰值从 178 GB 降到 47 GB,4 张 B300 上吞吐是 HSDP+USP4 的 1.39 倍而每卡显存只用 30%,各策略输出逐字节一致。
TL;DR
开箱即用的版本组合: 下文 DLO + AllGather 的快速上手命令,请使用 vLLM 0.27.0 搭配 vLLM-Omni v0.27.0rc1。
vLLM-Omni 的 Distributed Layerwise Offload 让比单卡 HBM 还大的视频生成模型(例如 Cosmos3-Super,64B / 124 GB)能够跨多张 NPU 或 GPU 运行,同时把 host 内存开销压到很低。整套方案包含:
• meta device 初始化 + mmap 权重加载:权重以 mmap 视图的形式指向共享的 OS page cache,消除了建模阶段 O(dp_size × model_size) 的 RSS。冷启动时 cgroup 可见峰值下降 73%(Cosmos3-Nano DP4:178 GB → 47 GB)。 • 权重分片 + AllGather:每个 rank 只保存 1/dp_size 的模型权重,运行时通过 AllGather 在专用 stream 上重建完整的层权重,并与计算重叠。 • 固定双缓冲方案:任意时刻每个设备上只驻留 2 层权重,与模型总层数无关。缓冲区容量仍随模型中最大的 block 增长,总显存还包含随负载变化的激活值与通信缓冲。在实测的 720p 10s 负载下,从 17B 到 64B 模型,峰值显存增长约 22%(23.1 → 28.1 GB),空载显存增长约 27%(11.5 → 14.6 GB)。 • DP 多并发:每个 DP rank 并行处理不同的请求,相对单请求 HSDP 取得 3.3× 吞吐——约为理想 4× 扩展的 83%。 • 平台无关:借助 vLLM-Omni 的平台抽象层,NVIDIA GPU(CUDA/NCCL)与昇腾 NPU(CANN/HCCL)都能跑。 • 8× B300 上的拓扑相关性:在评估过的三条 MiniMax-H3 路线中,AllGather 在 DP1×SP8 的延迟场景和 DP4×SP2 的平衡点上表现最好,而在 DP8×SP1 上则是 rank-local DLO 胜出,达到 183.78 videos/h 与 43.97 Wh/video。
在昇腾 910B3 上实测的 DLO+AllGather 运行中(Cosmos3-Nano,33 GB;Cosmos3-Super,124 GB),所有配置都产出了正确的视频输出,且 cgroup 可见的 host 内存按 O(model_size + dp_size × 常数) 增长,而不是 O(dp_size × model_size)。关闭 AllGather 的模式下,纯 DP 配置中每个 rank 仍保留一整份 host 副本;而既有的 TP 分片本来就是 rank-local 的,直接复用即可。CUDA 侧的进程内存统计包含了 pinned 分片,下文单独列出。
快速上手
版本要求:下面两条 AllGather 命令需要 vLLM-Omni v0.27.0rc1 或更高版本,搭配 vLLM 0.27.0。在 v0.26.0 版本上,Cosmos3 的 DLO+DP 路径会拒绝所有请求,因为引擎要求 supports_request_batch=True 才允许多请求准入,而 Cosmos3OmniDiffusersPipeline 并未声明该属性[1]。
#5864[2] 修复了这一点:对 DLO+AllGather+DP 配置绕过 supports_request_batch 的要求——每个 DP rank 通过 pipeline 的单请求前向路径独立跑自己的请求,引擎再从各 rank 的队列收集结果。关闭 AllGather 的 DP 命令不在 #5864 的覆盖范围内;--dlo-no-use-allgather 下的独立请求分发由 #5911[3] 跟踪(仍未合并)。#5864 中的正确性修复不改变 DLO 的权重分片与卸载内存机制;下文每个测量小节都会各自说明所用环境。
# 4× NPU 或 GPU —— Cosmos3-Nano,DP=4vllm serve /path/to/Cosmos3-Nano --omni \ --enable-distributed-layerwise-offload \ --data-parallel-size 4# 2× 设备 —— Cosmos3-Super(124 GB),DP=2vllm serve /path/to/Cosmos3-Super --omni \ --enable-distributed-layerwise-offload \ --data-parallel-size 2# 关闭 AllGather(每个 rank 加载完整权重,不做分片)vllm serve /path/to/Cosmos3-Nano --omni \ --enable-distributed-layerwise-offload \ --data-parallel-size 4 \ --dlo-no-use-allgather--dlo-use-allgather / --dlo-no-use-allgather 这组开关控制权重是否分片(默认分片)。关闭时,每个 rank 加载标准 loader 给出的 rank-local 张量——在纯 DP 配置下这就是一整份模型副本,而既有的 TP 分片本来就是 rank-local 的,直接复用。当 AllGather 的同步开销超过省下的内存时,这个模式就派得上用场。
问题:大扩散模型 vs. HBM 与 host 内存
Cosmos3-Super(64B 参数,BF16 下 124 GB)装不进单张 64 GB HBM 的卡。现有方案分为两类——卸载类,把权重从 host 内存流式搬入;以及并行类,把常驻的工作切分到多个设备上。两类各有局限:

图 1:针对 Cosmos3-Super 的卸载类与并行类方案对比。HSDP 每卡约 31 GB 权重加上约 25 GB 的激活值与通信缓冲(合计约 56 GB),只剩 8 GB 余量;DLO 则只在 HBM 里保留两层,同时把 host 侧权重也切开。
对纯 DP 部署来说,host 内存才是致命瓶颈:传统逐层卸载会在每个 rank 的 host 内存里各存一整份模型。4 张卡就是 4 × 124 GB = 496 GB——比大多数服务器的内存还多。TP 部署可能本来就在用 rank-local 分片,每 rank 的 host 内存会按比例下降。
更糟的是,模型加载期间每个 rank 各自调用 param.data.copy_(loaded_weight),在 RSS 里造出 dp_size 份完整的私有副本。峰值 RSS 按 O(dp_size × model_size) 增长,200B 模型在 dp_size=4 时会到 2 TB。
方案总览
Distributed Layerwise Offload 用四项相互配合的技术同时解决 HBM 和 host 内存两个瓶颈:
前三项让大模型部署在内存上变得可行;DP 多并发则是一项吞吐优化,建立在第二项技术本来就需要的 AllGather 同步之上。下面按我们实现的顺序逐项展开,每项回答三个问题:问题为什么存在、方法为什么有效、你能得到什么。
1. meta device + mmap 权重加载
为什么。 原先的加载路径是每个 rank 各自调用 load_model(load_device="cpu"),然后才 offload_backend.enable()。这导致 param.data.copy_(loaded_weight) 在 RSS 里造出 dp_size 份完整的私有模型副本。Cosmos3-Nano DP4 的 cgroup 可见峰值是 178 GB——而模型本身只有 33 GB。
为什么有效。 卸载后端用 to_empty(device="meta") 把已经建好的 DiT 模块转到 meta device,释放其参数存储而保留张量元信息;随后把这些 meta 参数替换成来自 safe_open().get_tensor() 的 mmap 视图——它们指向 OS page cache,而不是私有副本。
# distributed_layerwise_backend.py —— 释放已有的 DiT 参数存储dit_module.to_empty(device="meta")# 先解析 HF repo ID,再把 meta 参数替换成 mmap 视图model_path = download_weights_from_hf(...)tensor = safe_open(file_path, framework="pt", device="cpu").get_tensor(ckpt_key)parent._parameters[name] = Parameter(tensor) # 指向共享 page cache由于所有 rank mmap 的是同一批 safetensors 文件,操作系统在 page cache 里只维护每个文件页的一份副本——所有进程共享。没有任何一个 rank 会造出私有副本。
对于 Hugging Face repo ID(而非本地路径),我们先用 download_weights_from_hf() 解析出 snapshot 路径,与 vLLM 既有的 DiffusersPipelineLoader 的做法保持一致。
你能得到什么。 Cosmos3-Nano DP4 的冷启动 cgroup 可见峰值从 178 GB 降到 47 GB——下降 73%。178 GB 的基线由三部分构成:132 GB 的私有模型副本、33 GB 的共享 page cache,以及约 13 GB 的框架 / 瞬态开销。mmap 的 page cache(1× model_size)是共享且只读的,内存吃紧时操作系统还能部分回收。

图 2:实测 Cosmos3-Nano DP4 的冷启动峰值从 178 GB 降到 47 GB——把四份私有权重副本换成了由一份共享 mmap page cache 支撑的 meta 参数。
2. 权重分片与 AllGather 重建
为什么。 即便用上 mmap 加载,逐层卸载机制仍然会把完整模型拷进每个 rank 的 pinned CPU 内存里,用于 H2D 传输。在这里实测的纯 DP 基线中,4 张卡就意味着 4 × 33 GB = 132 GB 的 pinned 内存——而且随设备数线性增长。
为什么有效。 每个 rank 不再存完整模型,而是只存 1/dp_size 的权重。运行时在专用通信 stream 上通过 all_gather_into_tensor 重建出完整的层权重。
# _shard_and_pin:每个 rank 只保存自己的 1/dp_size 分片shard_size = (total_numel + dp_size - 1) // dp_size # 向上取整shard = torch.zeros(shard_size, dtype=dtype, device="cpu")# 只拷贝落在 [rank * shard_size, (rank+1) * shard_size) 区间内的部分shard[dst_slice].copy_(mmap_view.flatten()[src_slice])shard = shard.pin_memory() # 用于快速 H2D 的 DMA 缓冲分片采用向上取整并补零,使所有分片等长——这是 all_gather_into_tensor 的要求。分片完成后,原来的 mmap 视图会被替换成零元素占位张量,释放对 page cache 的引用。
你能得到什么。 pinned 内存总量从 dp_size × model_size 降到 model_size(所有 rank 求和)。以 Cosmos3-Super DP4 为例:4 × 124 GB → 总计 124 GB,每 rank 31 GB。

图 3:host 侧常驻权重从"每 rank 一整份模型"缩到"每 rank 一个分片";AllGather 只在设备上重建当前这一层的完整权重。
3. 双缓冲预取:H2D 与 AllGather 重叠
为什么。 分片解决了内存问题,但每一层在计算时仍然需要完整权重在设备上。如果一次性加载所有层,HBM 又会被撑满——回到最初的问题。同步式加载(H2D → 等待 → AllGather → 等待 → 计算)也很浪费时间:数据搬运期间 GPU 是闲着的。
为什么有效。 我们只维护两个设备缓冲区(slot),每个按模型中最大的 block 大小分配。当计算 stream 在执行第 N 层(使用 slot 0)时,后台 stream 把第 N+1 层准备到 slot 1:
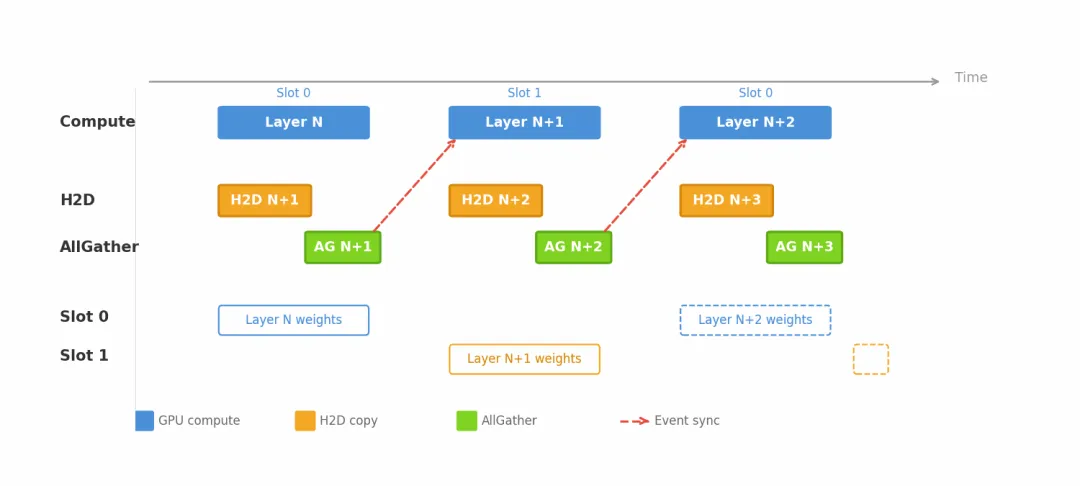
图:完整的三 stream 时间线,展示计算(蓝)、H2D(橙)、AllGather(绿)如何通过双缓冲 slot 相互重叠。红色虚线箭头表示事件同步——计算要等 AllGather 完成后才切换 slot。
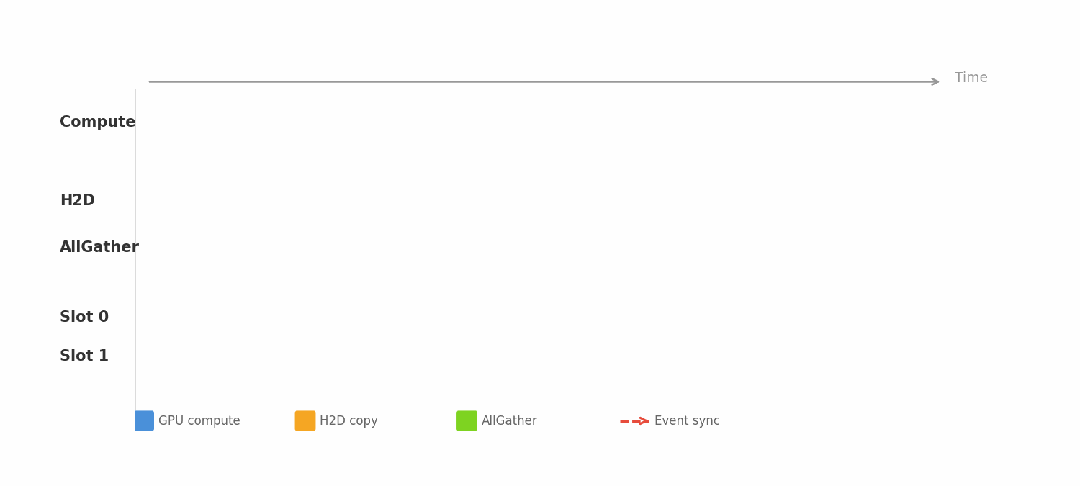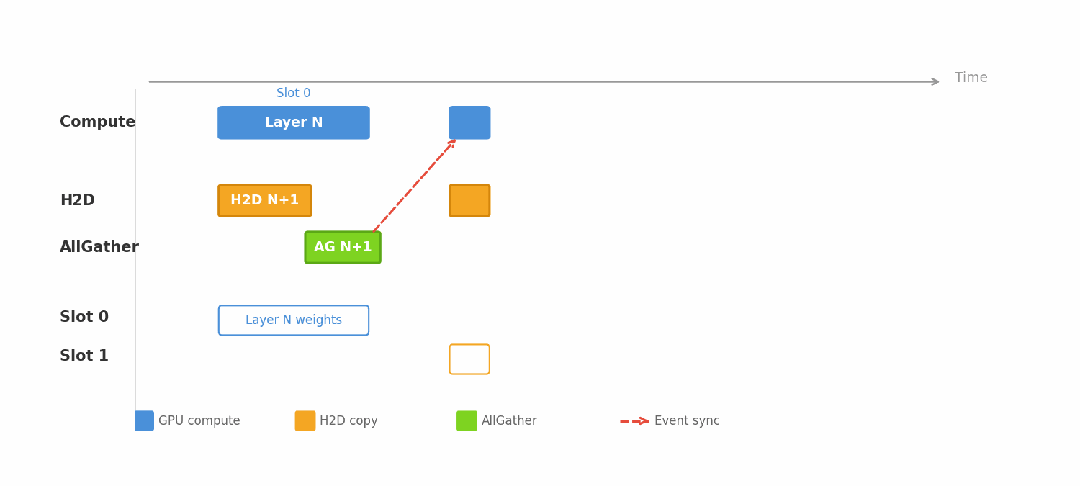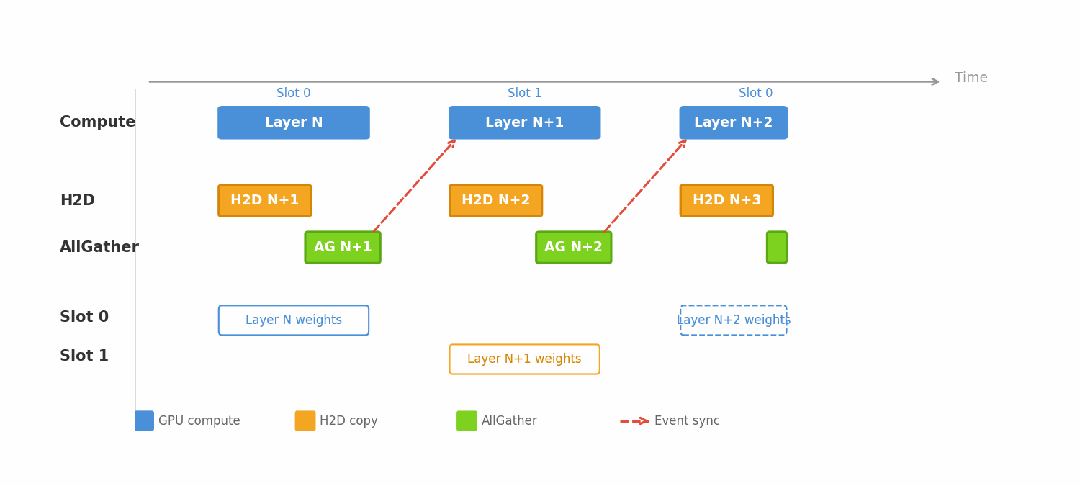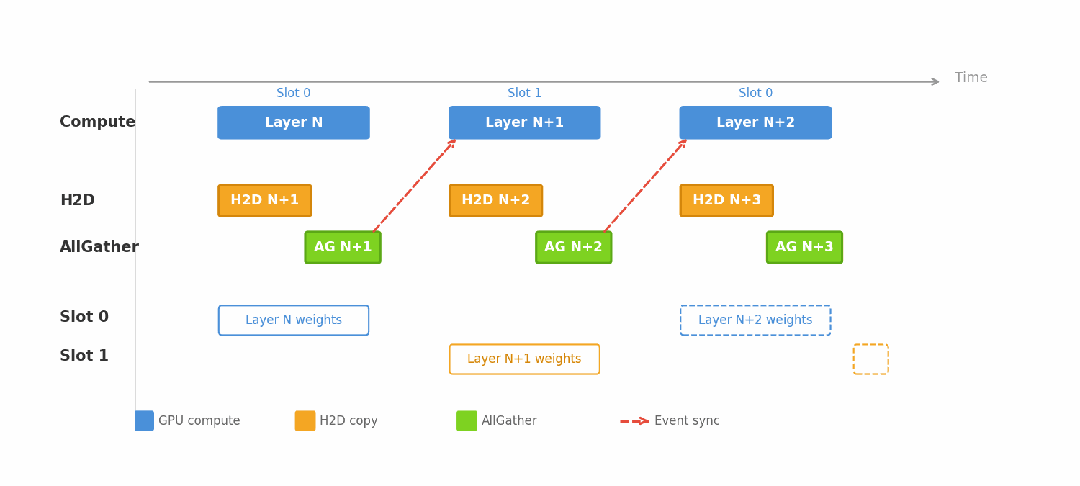
两阶段的准备工作跑在不同的 stream 上:
1. H2D( copy_stream):把 1/dp_size 分片从 pinned CPU 内存搬到设备2. AllGather( comm_stream):从所有 rank 汇聚分片,拼成完整权重缓冲
两条 stream 都通过基于 event 的同步与计算 stream 重叠。AllGather 完成后,参数会依据缓存好的元信息重新指向输出缓冲区的对应切片。
缓冲区在所有 block 之间共享——按最大 block 大小一次性分配,每一层复用。这保证了显存占用被 2 × max_block_size 限住,与总层数无关。
在昇腾 NPU 上,pin_memory() 通过 /dev/davinci_manager(NPU 设备驱动)分配可做 DMA 的内存。这块内存位于 CPU 内核空间,不被 cgroup 统计——这也是 cgroup 峰值比预期低得多的关键原因。
你能得到什么。 HBM 里只放 2 层权重(Nano 约 2 GB,Super 约 3 GB),与总层数无关。所需的缓冲区容量仍随最大 block 增长,总显存还包含随负载变化的激活值与通信缓冲。在实测的 dist_offload+SP 720p 10s 负载下,从 Nano 到 Super 的峰值显存增长约 22%(23.1 → 28.1 GB),空载显存增长约 27%(11.5 → 14.6 GB)。模型大了 3.8 倍,但两项显存指标都远低于 64 GB。
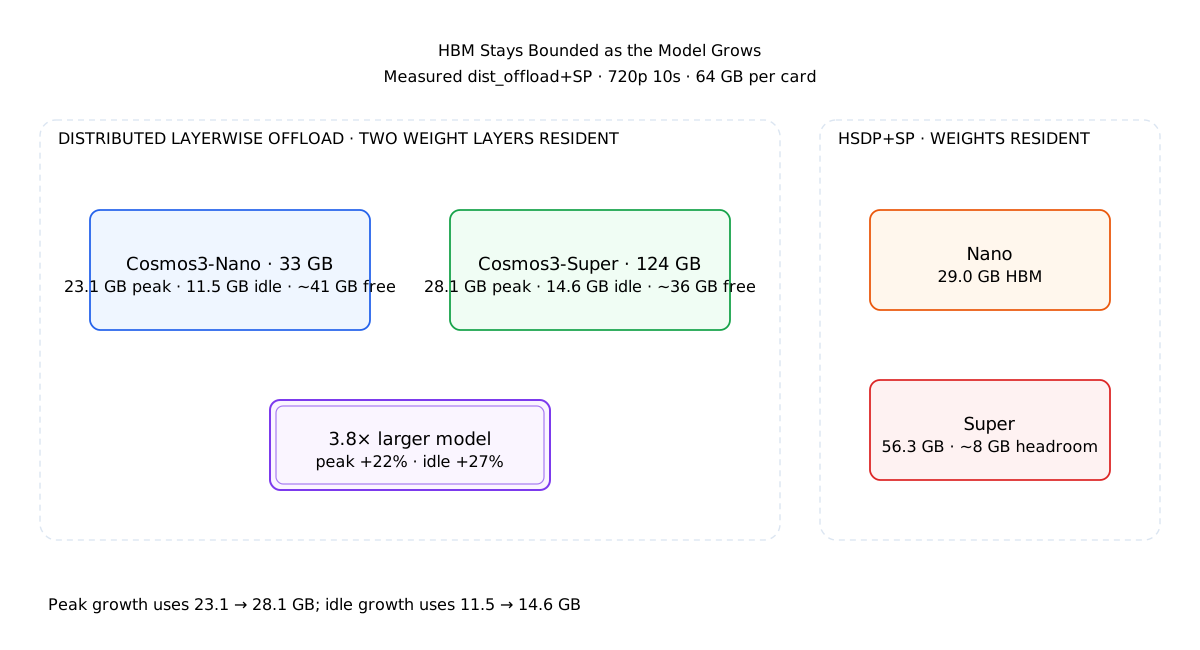
图 4:720p 10s 下实测的 dist_offload+SP 显存。峰值显存从 23.1 GB 升到 28.1 GB,约 +22%,而 124 GB 的模型体量是原来的 3.8 倍;HSDP+SP 在 Super 上则达到 56.3 GB。
4. DP 多并发:N 个请求并行
为什么。 AllGather 汇聚的只是权重分片——它完全与请求无关。这意味着所有 DP rank 在每次 AllGather 调用处同步,但它们可以并行计算不同的激活值(也就是不同的请求)。如果不利用这一点,DP rank 在两次 AllGather 之间就是闲着的,吞吐被限制在同时只处理 1 个请求。
为什么有效。 启用 dp_concurrent 后,调度器会把至多 dp_size 个请求打成一批。executor 用单次广播 RPC 把所有请求发出去:

图 5:一次广播携带一个请求列表;各 DP rank 计算不同的请求,而同步的 AllGather 调用交换的是与请求无关的权重分片。
# Executor:一次性发出所有请求reqs_list = [nr.req for nr in new_reqs]results = collective_rpc("execute_model", args=(reqs_list, ...), unique_reply_rank=None, exec_all_ranks=True)每个 worker 依据自己的 DP rank(而不是 global rank,以便正确处理 SP/TP)挑一个请求:
dp_rank = get_data_parallel_rank()req = reqs_list[dp_rank % len(reqs_list)]每个 DP 副本内只有主 rank(SP=0、TP=0、CFG=0、PP=0)回复,并带上 dp_rank 标签用于结果匹配。executor 通过轮询收集响应,再按 dp_rank 排序把结果对回请求。
有一道校验会拒绝批次兼容性键不一致的并发请求。这个键覆盖空间 / 时间形状(height、width、num_frames、fps)、CFG / guidance 设置(guidance_scale、true_cfg_scale、cfg_normalize)、num_inference_steps、LoRA 身份(lora_int_id、lora_scale)、输出数量、质量模式,以及 pipeline 特有的 extra_args——因为 AllGather 是集合通信,这些共享字段一旦不一致,就会出现一个 rank 走偏、其他 rank 挂住的情况。extra_args 尤其可能改变前向调度,所以引擎要求同一波请求里它的 JSON 完全相同。而随机种子、generator 这类请求本地字段可以逐 rank 不同。自 #5864[2] 起,pipeline 不再需要声明 supports_request_batch=True;引擎让每个 DP rank 的请求各自走 pipeline 的单请求前向路径,再从各 rank 的结果队列收集。不兼容或空 prompt 的请求波会在派发到 worker 之前被拒绝,而部分完成的请求波会以超时失败告终,而不是把集合通信卡死。
你能得到什么。 4 个并发请求达到 3.22 生成视频帧/秒——是 HSDP 单请求基线的 3.3 倍,约为理想 4× 扩展的 83%。固定的 AllGather 开销(约 150 ms/step)被 4 个并发计算摊薄。
昇腾的内存统计:cgroup 可见 vs. 物理内存
朴素的分析会预期 host 内存占用是 2× model_size:page cache(1× 模型)+ 分片缓冲(合计 1× 模型)。但在昇腾 NPU 上,pin_memory() 是通过 /dev/davinci_manager 分配的,把分片放进了 CPU 内核态的 DMA 内存里——这部分对 cgroup 内存控制器不可见。物理内存 ≈ page cache + pinned 分片 + 框架开销;cgroup 看不到 pinned DMA 那一块,但服务器仍然需要这么多物理内存。

图 6:Cosmos3-Nano DP2 下的昇腾内存统计。cgroup 看到的是共享 page cache 与框架 RSS,而通过 /dev/davinci_manager 分配的 pinned 分片位于驱动管理的 CPU DMA 内存中,而非 NPU HBM。
用干净的测量(Cosmos3-Nano DP2,全新 cgroup)验证:
cgroup usage_in_bytes = 49 GB = cache(31) + rss(18) ← 精确吻合,没有额外项cgroup kmem = 0 GBdavinci_manager RSS = 0 kB (见 /proc/<pid>/smaps)每卡 NPU HBM = 10 GB (< 14.5 GB 的分片 → 分片不在 HBM 里)Slab = 3.3 GB (装不下 29 GB 的分片)也就是说,cgroup 可见内存按 O(model_size + dp_size × 常数) 增长,而不是 O(dp_size × model_size)——但总物理内存等于 cgroup 可见内存加上cgroup 看不见的那部分 pinned DMA 分片。以 200B 模型、dp_size=4 为例:约 423 GB cgroup + 约 400 GB 内核 DMA = 约 823 GB 总物理内存(2 TB 内存装得下),而不用 mmap 则是 2000 GB。
验证结果
全部测试在昇腾 910B3(每卡 64 GB HBM,2 TB 系统内存)上完成,模型为 Cosmos3-Nano(33 GB)与 Cosmos3-Super(124 GB)。
正确性
host 内存(cgroup 峰值)
NPU 显存
在实测的 dist_offload+SP 720p 10s 负载下,从 Nano 到 Super 峰值显存增长约 22%(23.1 → 28.1 GB),空载显存增长约 27%(11.5 → 14.6 GB)。设备上只驻留 2 层权重,所以体量大 3.8 倍的模型依然远低于 64 GB 上限。
性能
这批昇腾测量使用 Cosmos3-Nano,832×480,29 帧,35 步去噪。生成帧/秒指的是每墙钟秒产出的输出视频帧总数(29 帧 × 每波输出数 / 每波时延),不是视频的播放帧率。
AllGather 开销 = 150 ms/step(72 ms stream 切换 + 10 ms HCCL + 68 ms Python 分发),在 Cosmos3-Nano DP4 上测得。通信量随层维度、参与方数量与拓扑变化。有 4 个并发请求时,这项固定开销被摊薄 4 倍。
NVIDIA B300 GPU 结果
为验证平台无关性,我们把同一套 DLO 栈跑在 NVIDIA B300 SXM6 GPU 上。下面的 Cosmos3 测试使用 Cosmos3-Super BF16(124 GB)、4× NVIDIA B300(物理 GPU 1,5,6,7)、Python 3.12.3、PyTorch 2.11.0+cu130、CUDA 13.0、vLLM 0.23.0,以及 vLLM-Omni commit 9772bb32[4](PR #5397[5] 合并前的快照;最终合并的 head 还包含本次基准测试中没有的 loader 门控与 TP/mmap 校验改动)。紧随其后的 MiniMax-H3 小节会各自说明它用的 vLLM / vLLM-Omni 版本、enforce_eager=True 开关,以及一处本地 pipeline 补丁;那些细节只适用于 MiniMax-H3 研究,不能套用到 Cosmos3 的运行上。
正确性通过跨策略逐字节一致的输出哈希验证。例如 T2I 种子 42 在 DLO+AG、无 AG、DLO+USP4、传统逐层卸载+USP4、HSDP+USP4 之间产生了完全相同的 SHA256 6e7d2a8c63b88391...。T2V 832×480×29f 种子 17 在所有策略下产生了相同的 666,029 字节输出(SHA256 c5d38f5d21ca619e...)。
CUDA 侧的进程树 PSS 包含共享 page cache、pinned CPU 分片与框架内存。昇腾的 cgroup 测量则不含 /dev/davinci_manager 背书的 pinned 分片,因此 GPU 的 PSS 数字与昇腾的 cgroup 数字不能直接对比。
1024×1024 T2I,50 步
4 个并发请求下,DLO+AG DP4 的吞吐达到 HSDP+USP4 的 1.39×,而每卡显存只用了 30%(12.6 GiB vs 42.0 GiB)。
832×480 T2V,29 帧,35 步
各负载下的时延与显存(35 步,DLO+AG DP4 vs HSDP+USP4)
在 720p 10s(241f)上,DLO+AG+USP4 用时 214.53s——与 HSDP 的 210.05s 相差 2.13% 以内——且输出逐字节一致(SHA256 08cb679322996ea6...),同时显存只用了 HSDP 的 47%(24.99 GiB vs 53.73 GiB)。
MiniMax-H3 在 8× B300 上:DLO 模式取决于拓扑
Shunyang Li 另做了一份 MiniMax-H3 B300 研究[6],测试 DP、SP 与 DLO 执行模式在一个 8× NVIDIA B300 SXM6 AC 节点上如何相互影响。与上面的 Cosmos3 测量不同,这个负载同时生成视频和音频:768×1344,124 视频帧,立体声音频,BF16,每副本 batch size 1,请求 50 步(49 次调度器去噪更新)。该研究的 environment.json.txt 记录的是 vLLM 0.24.0 与 vLLM-Omni 0.26.0rc2.dev11+g6607f4a7f(源码 commit 9e73ee1[7]);运行脚本设置了 enforce_eager=True(关闭图编译),并对 pipeline_minimax_h3.py 打了一处本地 subgroup-broadcast 补丁[6]。这些结果并不代表未修改的正式发布版本,也不代表默认的编译图路径。下面每条被选中的 T2VA 路线,都包含跨两个引擎生命周期、每个生命周期完成一次完整预热之后的 20 次测量波。吞吐为输出数除以波时间;能耗按八卡板级功率求和后按每个输出积分,未扣除空载基线;外部 nvidia-smi 采样器以 0.758s 的中位间隔记录显存与功率。
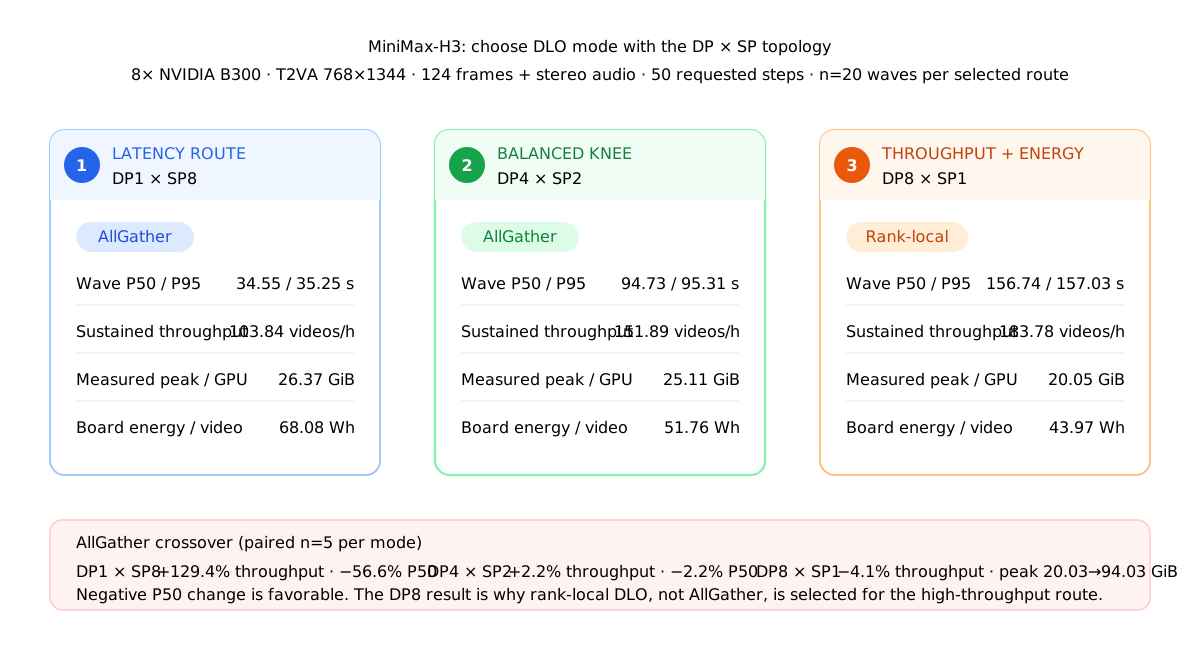
图 7:三条被评估路线内实测出的服务前沿。提高 DP 是用每波时延换并发输出能力;到 DP8×SP1 时,更优的 DLO 模式从 AllGather 变成 rank-local。
配对的五波模式对比解释了为什么不存在一个全局统一的 DLO 策略。在 DP1×SP8 上,AllGather 使用 SP 组,吞吐提升 129.4%,P50 时延下降 56.6%。在 DP4×SP2 上,它的吞吐收益收窄到 2.2%。到 DP8×SP1 时,AllGather 反而让吞吐下降 4.1%、P50 时延上升 3.8%,并把实测的每卡峰值从 20.03 GiB 推到 94.03 GiB,因此这里更适合 rank-local DLO。FL2VA 首帧与 Ref2VA 图像+音频测试保持了同样的"时延—吞吐"排序。
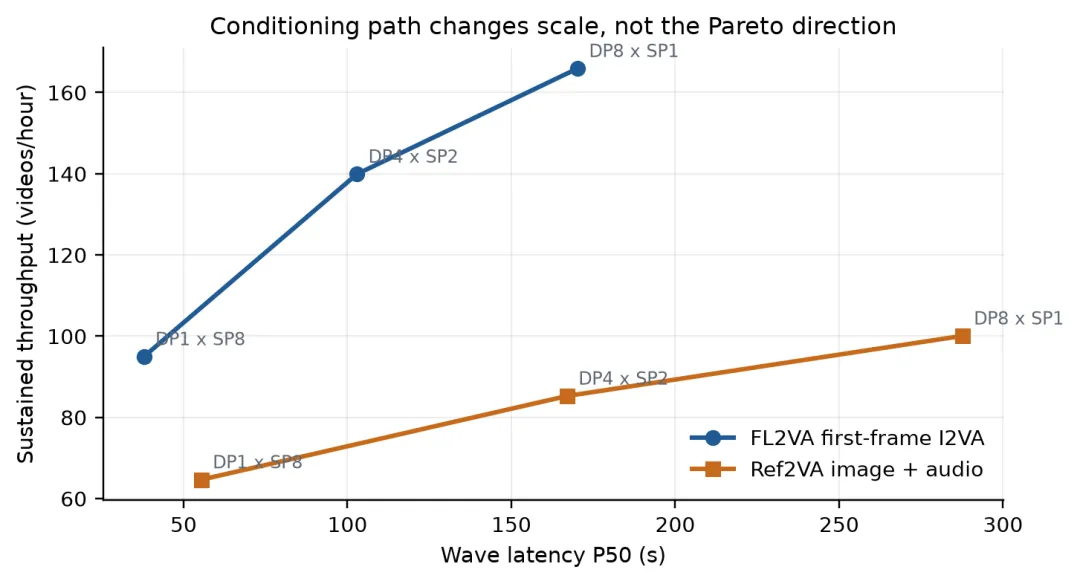
图 8:在三条被评估的路线上(每条 n=5 次测量波),FL2VA 首帧 I2VA 与 Ref2VA 图像+音频改变了时延与吞吐的绝对值,但保持了 DP1×SP8 → DP4×SP2 → DP8×SP1 的前沿排序。数据来源:MiniMax-H3 B300 研究归档[6]。
这些结果是一份拓扑研究,不是普适的生产结论。DP2×SP4 未做测量;实验覆盖的是单节点、单一输入集、单一分辨率与帧数,且只做形状校验而非感知质量评估。它使用的是源码 commit 9e73ee1[7] 加上一处记录在案的本地 subgroup-broadcast 修复,运行时还警告所测的 vLLM-Omni 与 vLLM 版本并非发布对齐版本。该归档提供了 PDF、CSV、105 个波样本、环境哈希、本地 diff 与基准测试脚本[6],供独立复核。
外推到 400 GB
下表是基于上文内存模型做的 host 容量外推;并没有真正跑过 200B 级别的模型,该规模下的最大 block 大小、显存余量、带宽、时延与输出质量都尚未验证。
致谢
感谢各位 vLLM-Omni 贡献者,包括 @hsliuustc0106 与 @yuanheng-zhao 细致的代码评审意见,感谢 Shunyang Li(GitHub @lishunyang12)贡献的 MiniMax-H3 B300 拓扑研究与可复现归档,也感谢昇腾 NPU 团队提供的硬件支持。
参考资料
源码:
• 分布式逐层卸载后端、meta 转换与 mmap 加载: distributed_layerwise_backend.py• OffloadConfig 与策略选择: base.py• 多队列 executor: multiproc_executor.py• DP 多并发 worker: diffusion_worker.py• 单元测试: test_distributed_layerwise_backend.py
RFC 与 PR:
• RFC:GitHub Issue #5396 • 实现 PR:vllm-omni#5397[5] • DLO DP 并发请求修复:vllm-omni#5864[2] • rank-local DLO DP 的独立请求支持:vllm-omni#5911[3]
模型与基准归档:
• Cosmos3-Nano:33 GB safetensors(17B 参数,72 个 block) • Cosmos3-Super:124 GB safetensors(64B 参数,128 个 block) • MiniMax-H3:B300 DLO 研究说明与可复现归档[6]
参考链接
1. vllm-omni Issue #5953 — github.com/vllm-project/vllm-omni/issues/59532. vllm-omni PR #5864 — github.com/vllm-project/vllm-omni/pull/58643. vllm-omni PR #5911 — github.com/vllm-project/vllm-omni/pull/59114. vllm-omni commit 9772bb32 — github.com/vllm-project/vllm-omni/commit/9772bb321f558a28c0dca1cb53b44aaf10e4ab695. vllm-omni PR #5397 — github.com/vllm-project/vllm-omni/pull/53976. MiniMax-H3 B300 DLO 研究说明与归档 — github.com/lishunyang12/vllm-omni-rankings/tree/main/scripts/minimax_h3_b300_dlo_industrial_report7. vllm-omni commit 9e73ee1 — github.com/vllm-project/vllm-omni/commit/9e73ee1a50ce247c638052011914d8027d717f28
vLLM 官方博客
vllm.ai/blog/2026-08-17-distributed-layerwise-offload