夜雨聆风学习资料网

ARTICLE · 983236

【AI实盘】20260820|240M Token|084倍率|15+6H|4项目|20R|21问题|0脏话

【AI实盘】20260820|240M Token|084倍率|15+6H|4项目|20R|21问题|0脏话

What's up,大家!这是我的第 102 篇原创文章,也是【AI实盘】系列的第 40 篇。

2026年8月20日AI实战日记,AI 学习有风险,入坑需谨慎。【AI实盘】记录我怎样把 AI 用进真实的学习、开发和内容生产:当天看执行,一周看主线,一个月看趋势。本文仅用于记录我个人的 AI 学习与实践,最多可作参考,不对任何人构成 AI 学习建议。

概览

这一天的模型投入明显降下来了。请求数、Token 和模型小时都比前一天少,但返工记录还在高位,说明钱花得少了,事没少折腾。

回到结果看,真正往前推的不是算力,而是把报告链和证据链重新归位。日报、AI Usage、Session 索引都能回读,但主线项目的状态结果还不够直观,后面还得继续补。

模型分析
分析项
数据
分析
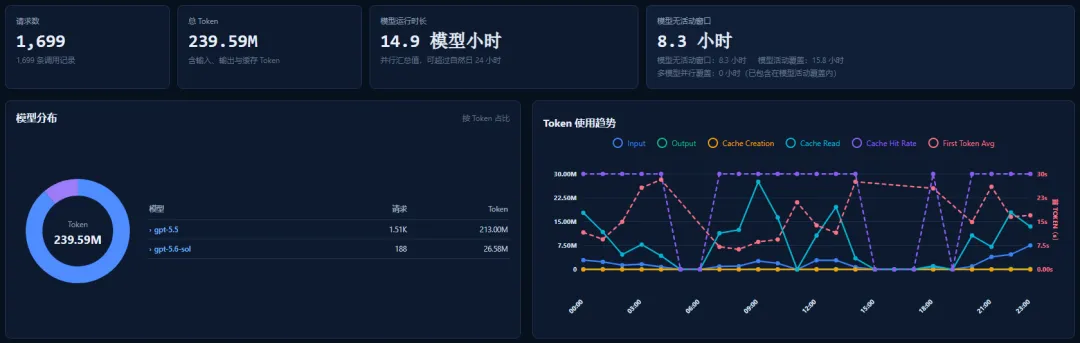
使用总览
1,699 次请求;239.59M Token;14.9 模型小时;模型活动覆盖 15.7 小时;模型无活动 8.3 小时
和前一日比,请求数、Token 和模型时长都下来了。模型小时仍是并行累计值,不是人工连续工时。
模型分布
gpt-5.5:1.51K 次、213M Token(占 88.9%);其他模型合计 189 次、26.59M Token
gpt-5.5 是绝对主力,主要干的是会话评审、图表分析、报告模板审稿、脚本调试和自动化纠偏。返工记录 13 次,说明这天不是单纯扩量,而是反复校正。
Token 使用趋势
输入约 41M、输出约 1.5M、缓存读取 198.12M(占 82.7%)
缓存读取占比很高,说明长上下文和历史规则反复进入视野。今天更像持续回看和修正,不像一次性直线出成果。

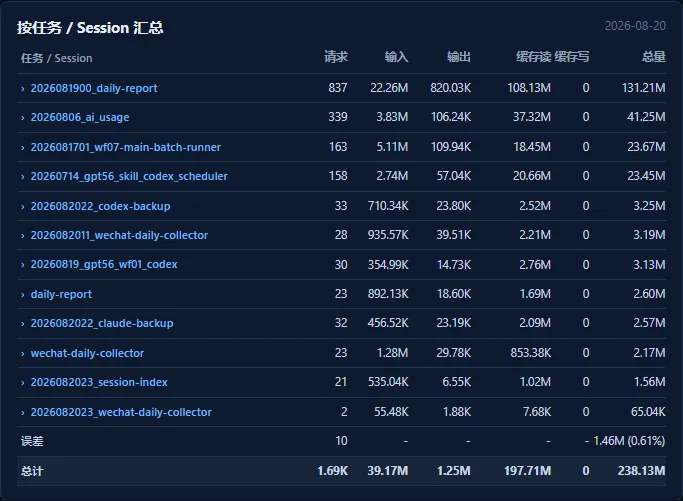
从图里能看出,这一天的模型投入没前一天那么猛,但并没有轻松下来。高频的不是新问题本身,而是围着同一批问题来回对齐:标题怎么定、上一批怎么接、结论怎么写、边界怎么画。看起来是少烧了点,实际上只是把钱更多花在了修正和确认上。

生产力分析
分析对象
生产/工作时间
无生产/休息时间
分析
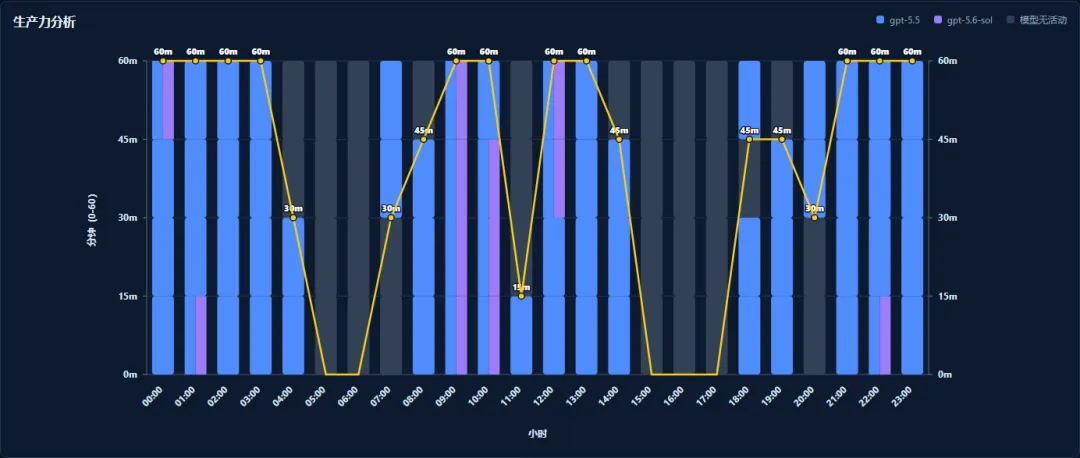
AI 生产分析
约 50/96 个 15 分钟槽有模型请求,槽位合计约 12.5 小时
模型无活动 8.3 小时
AI 侧有持续执行,但更多是在做评审、修正和回看,不是单段爆发式产出。
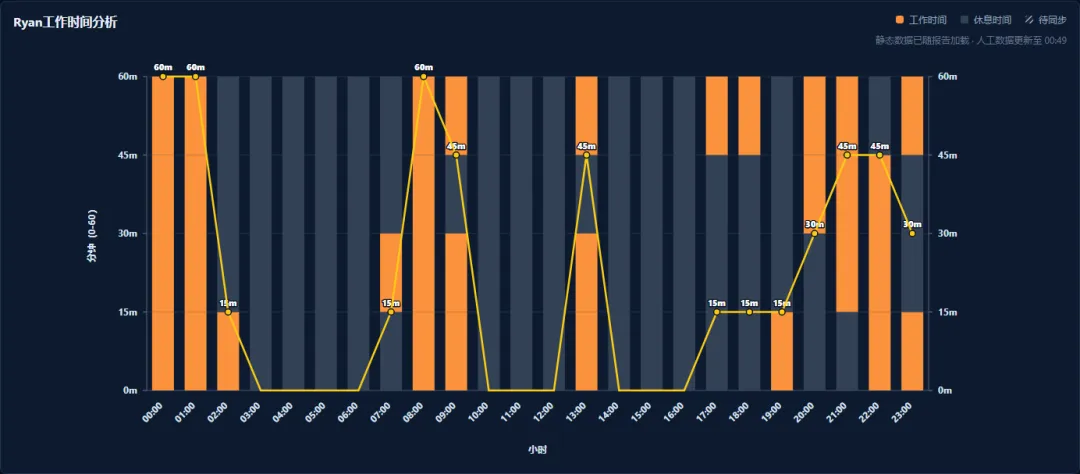
本人工作分析
约 25/96 个分散槽,槽位合计约 6.25 小时
无已确认生活窗口
我主要在发起、评审、纠偏和验收;分散槽位只说明我回来处理过,不说明连续工时。
AI 与人
同槽约 22 个,合计约 5.5 小时;AI 独立约 28 个,合计约 7.0 小时
双方无活动或无可确认关系 8.30 小时
这天的人机关系还是"AI 持续跑、人回来收",但真正占人力的是纠偏、核对和重写,而不是单纯盯着模型跑。

这一天的节奏很典型:AI 继续跑,我隔一段回来拉一把,事情没有一下子做完,但也没有白跑。最费劲的不是新任务,而是把旧问题从同一条链上拽下来,避免它继续把下一轮也拖进来。只要停止条件和验收边界没先写清,模型活动越久,返工半径就越大。

消费分析
消费范围
当日消费与规模
近期趋势
分析
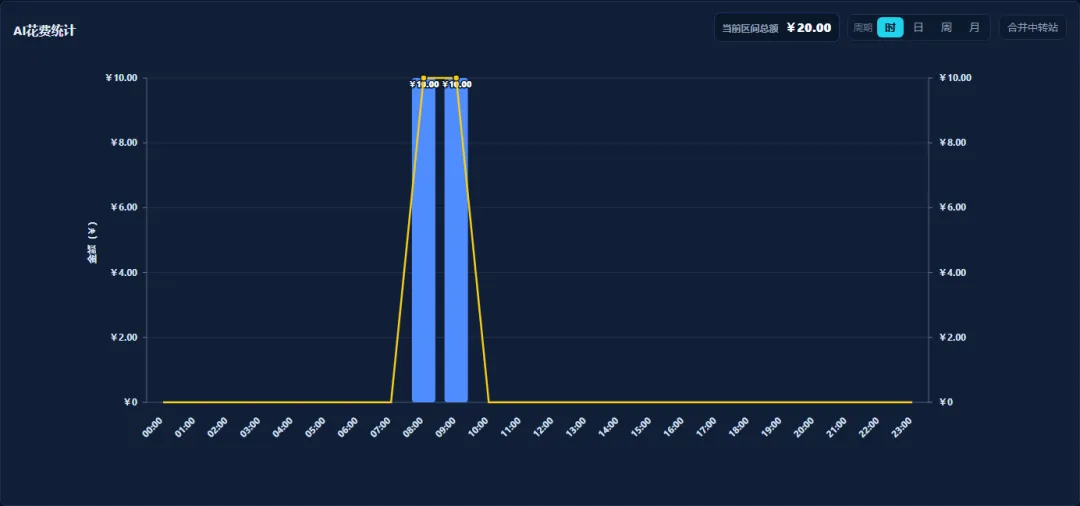
全部模型与渠道
20.00R;1,699次;239.59M Token
较前一日约 -60%;较近 1—3 日基线约 -50%
按人民币实付和 Token 算,约 0.084 元/百万 Token;如果只补 5 元,大概只能补 60M Token,够接短任务,不够再扛一轮同级长会话。

这笔账跟前一天比很直接:总花费下来了,但 Token 量和请求数也没有换来同等幅度的推进,说明今天的钱还是更多花在了回看、修正和确认,而不是纯扩量。对我来说,这就是最硬的提醒:补费可以补一小段,补不回一整轮同规格长跑。

进展
项目
当天做了什么
最终结果
report-dashboard
修正日报模板、流程合同和用户反馈里的"上一批有效报告"规则,重新把 0820 报告的标题、章节和完成回复放回同一条时间线
0820 草稿与规则口径已对齐,进入待发布边界
sharingan_ai_usage
产出 0820 exact-period AI Usage 报告和四图、session_summary,保住模型/消费/人机证据链
私有复盘图表齐全,可直接喂给日报
session-index
抽取当天问题块、会话覆盖和缺答情况,给当日复盘提供证据
当天问题与回复对位清楚,覆盖完整
ai_creator_system
把生命周期、Profile 与看板 Web 的验收边界重新摆到主线前面,确认它不是旁枝
作为默认活跃主线已被显式识别,但仍缺一个一眼可读的状态结果

从任务图里能看出,最重的几块还是围着报告链和证据链转。今天不是单独做了一个新项目,而是把会反复让人追问的地方,逐个按时间线归位:报告怎么接、上一批怎么认、问答怎么核、发布怎么留。对我来说,这也算是真成果,因为它让后面不必再靠口头解释补洞。

问题

问题
影响
解决过程
当前结果
ai_creator_system 没有在进展里单独说清
主线项目被挤到后面,读者看不出今天先看什么
把它提到进展最后一行,并按主线边界重新解释
现在能看出它是主线,但状态结果还不够直观
5 元补费只能接短任务
长会话一旦继续跑,预算很快被切碎
按 0820 的实付和 Token 算出约 0.084 元/百万 Token,补 5 元约 60M Token
阈值已经算清,只适合短任务
前一份报告的问题核实写错类型
用户一直追着改,文章和回复都难读
改成按报告内容时间线、跨日报/周报/月报判断
规则已落盘,后面不再按同类型硬切
反复回看和纠偏把窗口切碎
看起来很忙,实际有效推进被稀释
先把标题、模板、完成回复和审核稿一并理顺,再补正文
这轮至少把可复发缺口压下去了
当天记录不能被后续补丁打乱
章节核实容易把 0820 和 0821 串起来
按当天记录重新取 0820 原始输入,只保留当日问题块和当日记录
现在原始输入口径回到了当天
标题不一致
用户反复问"为什么标题跟我看到的不一致"
0819 已解决但 0820 再次出现,标题核对机制未固化到流程
需在发布前核对标题流程中补充门禁

我今天最该警惕的,不是模型跑得慢,而是我自己把同一条线来回推了太多次。钱花得快,原因不是单次算力不够,而是中间有太多轮确认和返工,把本来能完成的地方拖成了长跑。

计划

明日计划
执行动作
完成标准
先把 ai_creator_system 读清楚
先看它的页面、数据和状态结果,再判断主线是否真的清楚
进展里能一眼看出它的验收边界
先把上一轮问题来源找清楚
不再按报种硬切,先找报告内容时间线里最近的有效报告
第 5 段一次写对,不再来回改
先卡住补费阈值
当成本接近当前 0.084 元/百万 Token 的量级时,只跑短任务
5 元只接短活,不硬扛长会话
先守住待发布边界
未收到明确发布命令前,不跑 WF08
报告、清单和 Dashboard 保持待发布
先把标题核对机制固化
发布前核对标题的流程
标题不一致问题不再复发
先把规则写到能复用的地方
持续同步模板、流程、Skill 和反馈文件
不再只写在临时记录里

最后

这一回,灯还亮着,台先稳住了。ai_creator_system 走到前头,report-dashboard 也把日报和审核稿接上了。

可对上的先对上,没验明的先留边界。主线、支撑、证据各归各位,今天这口气总算捋顺了。

最费劲的不是新任务,而是把"执行链交接"和"标题核对"这两个老问题从同一条链上拽下来。门禁后不执行从六次加到七次,说明执行链交接还没解决;标题不一致上期已解但这期又冒,说明标题核对机制还没固化到流程。这两个坑不填,后面每一轮都可能被拖住。

明日先看主线状态,再看报告链差哪一步。主线一清,后面的活才知往哪儿补。

历史文章

相关学习资料