ARTICLE · 984169
如何开发一个好用的 DSH 插件市场 | 实战踩坑
GitHub 的 dsh-plugin Topic 下,已经有不下十个 Marketplace 相关插件。
我还是花了至少整整两天,重新做了一个。
听起来有点不划算。
挑一个现成的装上,显然更快。
但今天是十来个候选,以后可能是几十个。
它们的数据从哪来,搜索结果怎么排,安装时改了什么,失效后如何恢复,我都要重新判断一次。
如果 DSH 只是偶尔打开的工具,这点成本可以忽略。
可我很想把它变成自己的重度工作台。
一个每天使用的环境,运行逻辑不透明、行为不符合我的 taste,迟早会变成持续的摩擦。
我当时还在录制《手工川 DSH 实战》系列。
最初只想做一期“如何 DIY 插件市场”的教程,没想到数据源、模型、同步架构、UIUX、安装链和进程生命周期接连冒出问题。
每解决一个问题,都会出现新的事实,逼着我重新做判断。
自己做当然更贵。这两天的投入,早已超过找一个能用的 Marketplace 所需的时间。
但我得到了一条完全理解、可以继续塑造的插件发现与分发链,也把一路上的错误、取舍和工程经验留了下来。
对 Agent Harness 研究者、工程师、产品经理和 AI 产品创业团队,这些过程比一份功能清单更有参考价值。
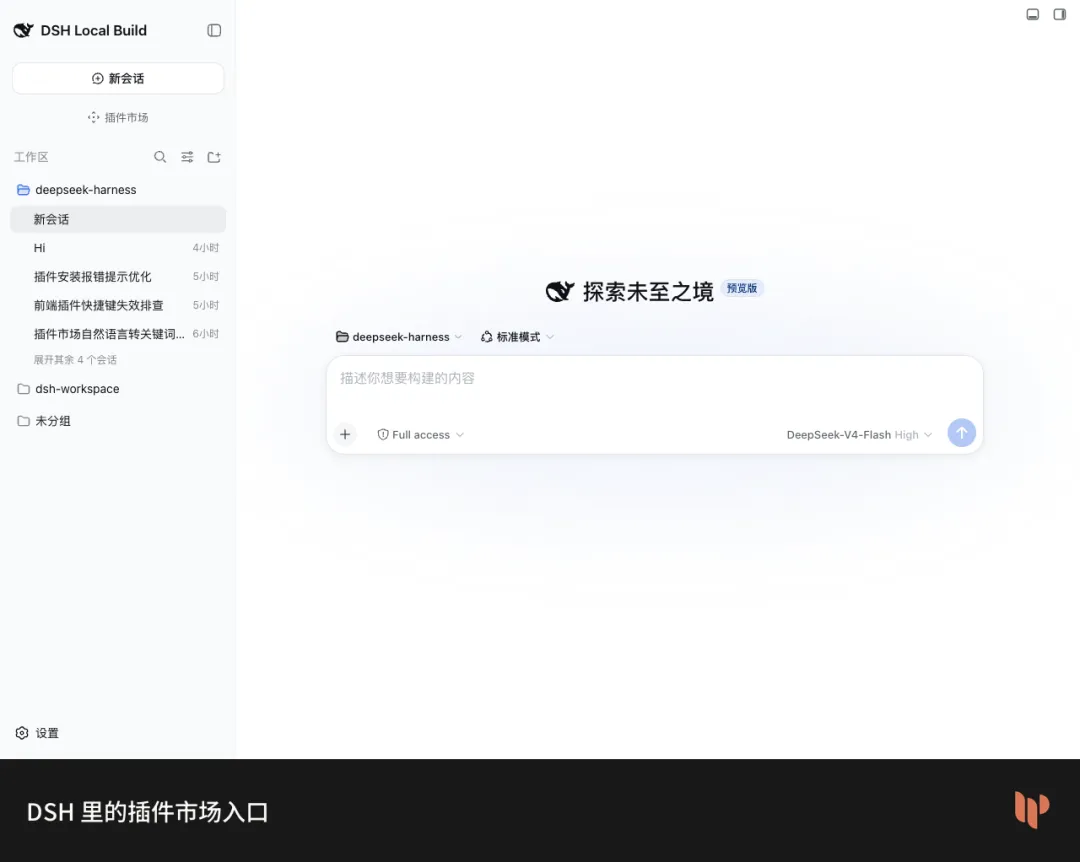
最后那个插件市场长什么样,反而没有这两天为什么不断改向重要。
接下来,我将与大家分享这两天里,我如何从 dshfind 的数据接口开始,为什么把主开发战场从 DSH 转到 Codex,又如何围绕同步性能、UIUX 和插件生命周期一次次改向,最终把一个能运行的 Marketplace 做到我愿意长期使用。
目录
01|第一步不是画页面,而是把 dshfind 变成接口
02|我在 DSH 里做出第一版,然后转战 Codex
03|云端只负责同步,高频操作全部回到本地
04|真正难的性能优化,从 GitHub 的 1000 条上限开始
05|UIUX 不是收尾,它决定这个市场会不会每天被使用
06|市场做完了,安装、配置和重启却可能让它失效
07|我做出来的插件会继续变,这套判断方式更值得留下
01|第一步不是画页面,而是把 dshfind 变成接口
开发没有从 DSH 的市场页面开始。
第一天,我先研究了 dshfind.com。
它已经积累了一套成熟的插件目录,还有分类、评级、精选等经过加工的信息。对大多数普通用户来说,直接使用 dshfind 很可能已经足够;在国内网络环境下,它甚至可能比 GitHub 更稳定。
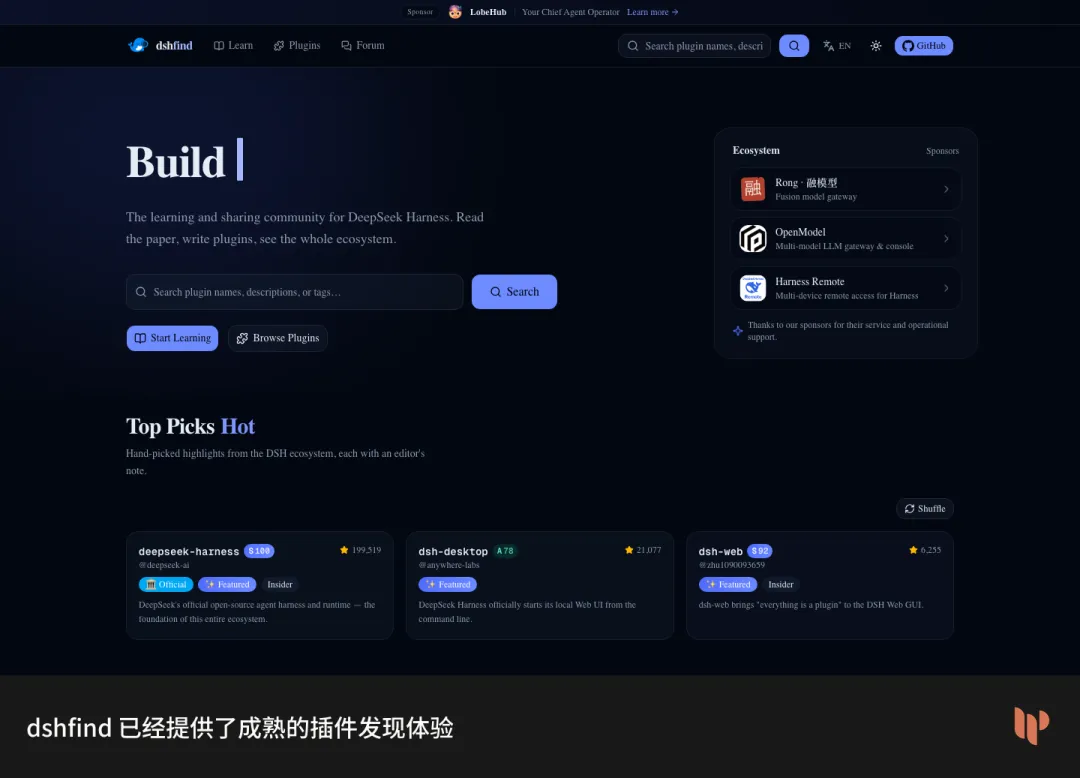
但我要在自己的插件里程序化使用这些能力。当时没有一套让我满意、可以直接调试的数据接口,我不想让后续开发一直围着网页结构猜。
这里需要先介绍一下 cli2anything++。它是我持续开发的一套 authorization-first 接口工程工具,也是 lov-cli2anything Skill 的 canonical source。
项目最早先在 ZenMux 的授权后台日志工作流上跑通:从我有权访问、能够真实观察的 API 行为出发,生成 OpenAPI 3.1、轻量 JavaScript SDK、可复验的 discovery evidence,再按任务继续生成 Swagger 或 CLI。
它关注的从来不只是“把网页包成接口”。真实请求是怎么发生的、调用者拥有什么授权、凭据能否留在原站登录态、生成结果如何复验,这些都要进入交付物。
dshfind 是它的第二个内置 target,也是第一次把这套能力用于公共只读插件目录。
项目地址 https://github.com/lovstudio/cli2anything-skill
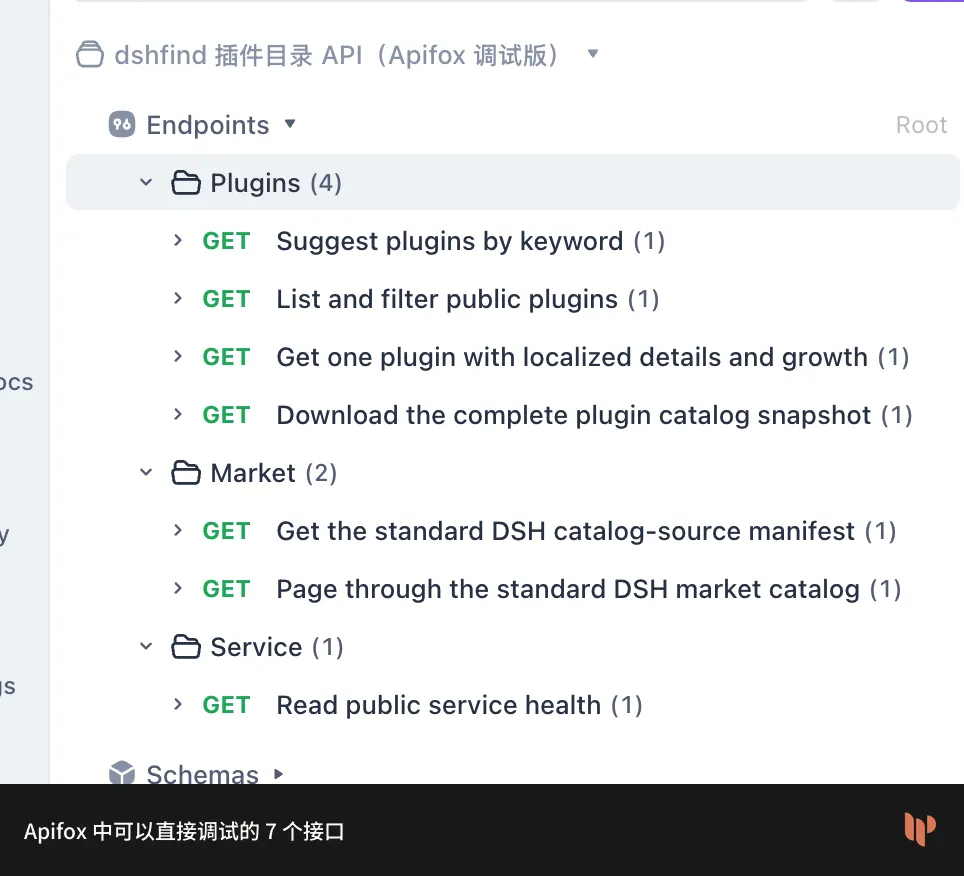
所以我用 cli2anything++ 分析 dshfind,把它整理成 RESTful 适配层,同时生成 OpenAPI、SDK、CLI 和 API 关系图,再导入 Apifox 做真实请求验证。
最后跑通了 7 个可调试端点。
它们包括健康检查、关键词建议、插件列表、单插件详情、完整目录快照,以及兼容 DSH 市场协议的 manifest 和分页目录。
这一步解决了两个问题:
后面我又补了分类接口、可刷新的 OpenAPI 地址和托管入口,继续验证 GraphQL/GraphSQL 后面的能力边界。
数据已经能拿到了。
可一个能请求数据的 Marketplace,离好用还很远。
02|我在 DSH 里做出第一版,然后转战 Codex
最早的插件市场直接在 DSH 里开发。Host 侧提供数据服务,Client 侧展示市场界面,还尝试把自然语言找插件接进 Agent Tool 和斜杠命令。
这很符合 DSH 的气质:用户描述需求,Agent 帮忙找到插件,市场和 Agent 形成配合。
真实开发很快撞上三层摩擦。
第一层来自 Harness 自修改。DSH 处于 dev 模式时,我让它修改自身,再反复重启、加载新插件。一次 loader id 重复就能让整个插件树无法启动:Host 端 smart-find 与 Client 端 UI 都注册成同一个 id,最终抛出 duplicate loader entry id: smart-find。
第二层来自运行链。源码、构建产物、profile、worktree、Host Remote、Client slot 只要有一层没对齐,页面就可能仍在读取旧代码。后面补安装能力时,又碰到 bundle 包装、workspace 链接、生成产物和 profile symlink 的差异。
第三层来自模型和 Harness 本身的能力差异。我在 DSH 里使用的默认 DS 模型,面对长时间、多轮日志回读和跨前后端验证时,收敛效率明显下降。DSH 一旦崩溃,正在修改它的 Agent 也跟着失去工作环境。
继续留在 DSH 里,我要同时承受模型能力、Harness 能力和自修改稳定性三层摩擦。
没必要硬扛。
我把主开发战场转到 Codex,使用 GPT-5.6-sol 加速长链代码修改、日志分析和回归验证;DSH 继续承担真实运行与验收。这个改向很实际:我要更快地把插件做完,同时保留它在 DSH 里真实可用的证据。
为了看清自修改过程到底发生了什么,我还把 TypeScript watch 日志做成一张可交互错误时间线:53 个编译快照,20 次错误数变化,峰值一度达到 44,最后仍残留 6 个。每一次升降都对应具体原因,而不是只画一条“错误变少了”的线。
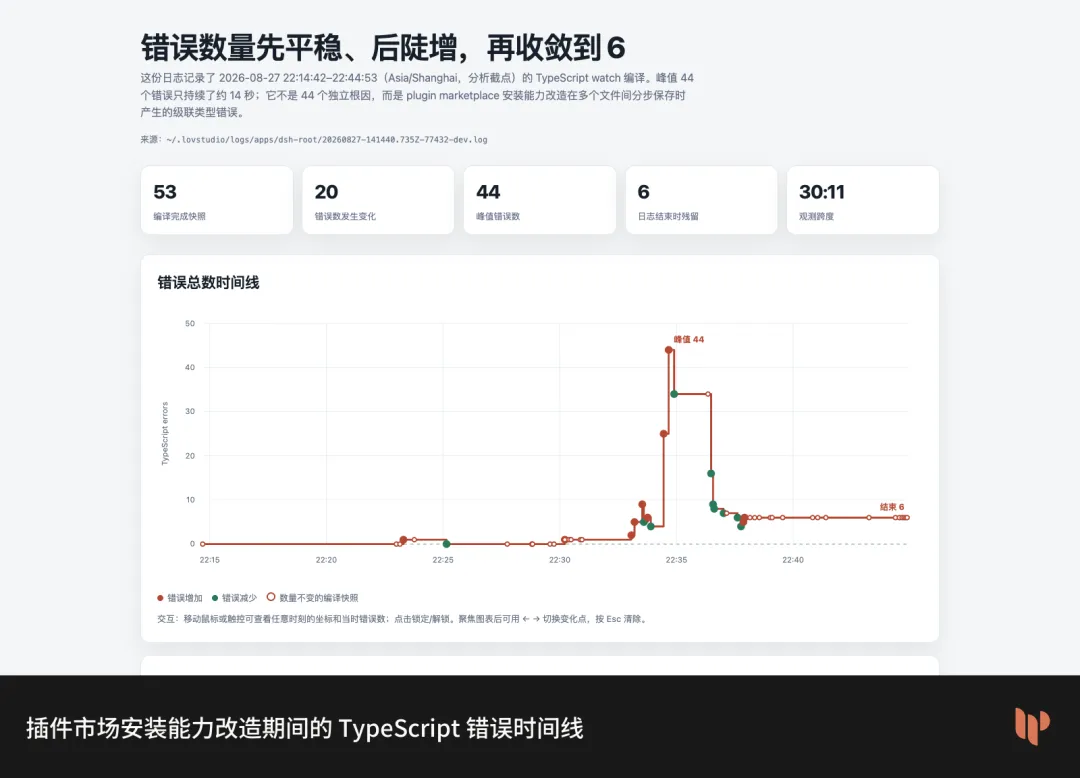
峰值 44 不代表突然出现了 44 个独立问题。
一次跨文件类型变更,就可能级联放大成几十条错误。对 Agent 来说,很容易被拖进逐条消错;对我来说,关键是找出哪次变更引入了哪组错误,系统最后有没有真正收敛。
自然语言搜索也在这个阶段被我拿掉了。
一方面,AI 的自然语言匹配要真正快,数据最好已经在本地。让模型围绕远端目录反复取数,速度很难接受。
另一方面,这种灵活性很难在固定 UI 里讲清。用户输入的到底是关键词、筛选表达式,还是一项准备交给 Agent 的任务?把这些能力全塞进一个搜索框,只会让界面和心智模型一起变复杂。
高级意图留在 Agent 对话里。市场界面只做确定、快速、可预期的搜索、筛选和排序。
03|云端只负责同步,高频操作全部回到本地
Codex 接手后,我先修界面,很快又回到了数据架构。
早期实现中,每次搜索、筛选、排序、翻页,甚至打开详情,都可能继续请求 dshfind。远端服务一抖,所有高频操作一起变慢。自然语言匹配再叠加跨网络取数,等待尤其明显。
我最后把链路改成:云端只负责同步,搜索全部在本地完成。
dshfind / GitHub ↓ 同步本地插件目录 ↓搜索、筛选、排序、分页、详情dshfind 当时可以一次返回约 1.1 万条完整目录,并提供 data_version,很适合作为快照源。第一版本地目录落在 IndexedDB:应用启动时先读本地,用户可以立即使用;随后静默检查更新,手动刷新也只更新目录,不阻塞日常检索。
IndexedDB 目前仍是保留设计。浏览器端存储简单、离线友好;如果以后要分析使用趋势、数据质量和同步健康度,把目录与事件放到后端会更方便。现在先守住 Provider 和本地仓库的边界,为后续迁移留下空间。
接着是 Provider。
我一开始也差点套用“不能绑定单一数据源”这句常见解释。仔细想想,单一与否根本不重要。一个来源只要长期解决问题,绑定它完全可以接受。
这里真正存在的是两套各有优劣的体验:
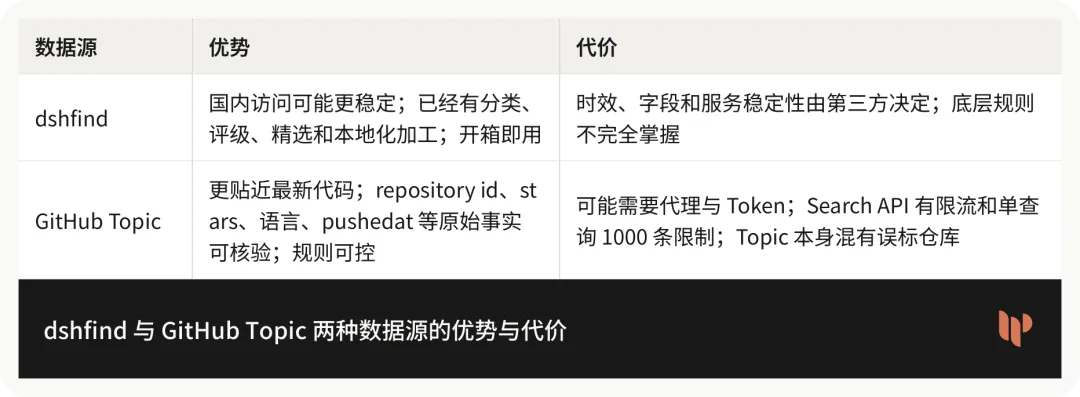
普通用户使用 dshfind 很可能已经足够。
我更偏向 GitHub,因为我愿意为及时性、可信度和控制力多付一些工程成本。
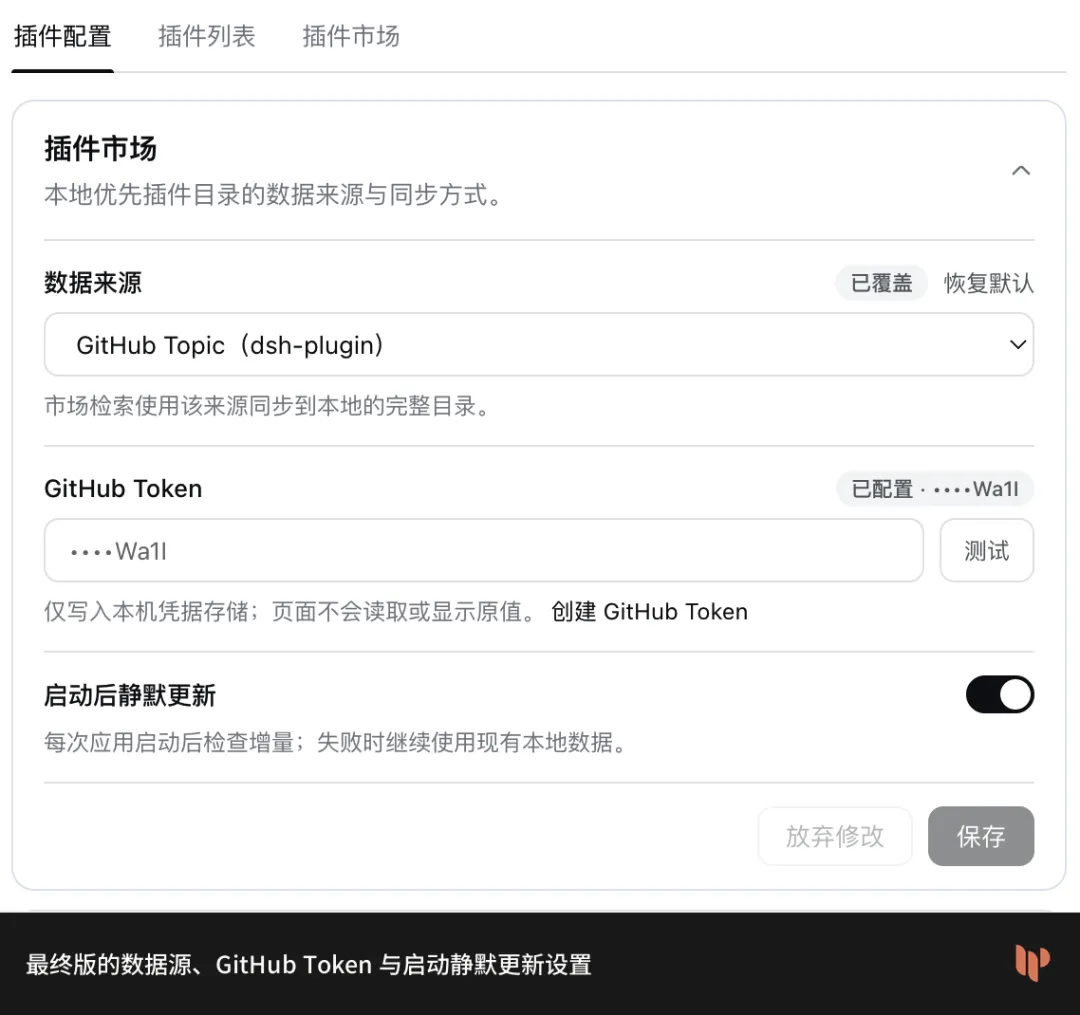
Provider 最后被落实为一组具体能力:首次完整同步、后续增量同步、按 id 获取详情,以及给本地检索提供一致的数据形状。GitHub 成为默认候选后,设置页还要处理 Token 获取指引、有效性测试、已保存凭据的末位确认、错误反馈和启动静默同步。
抽象有没有用,看用户能否完成选择、配置和故障恢复。
04|真正难的性能优化,从 GitHub 的 1000 条上限开始
GitHub 的 dsh-plugin Topic 当时已经有 12,238 个公开仓库。
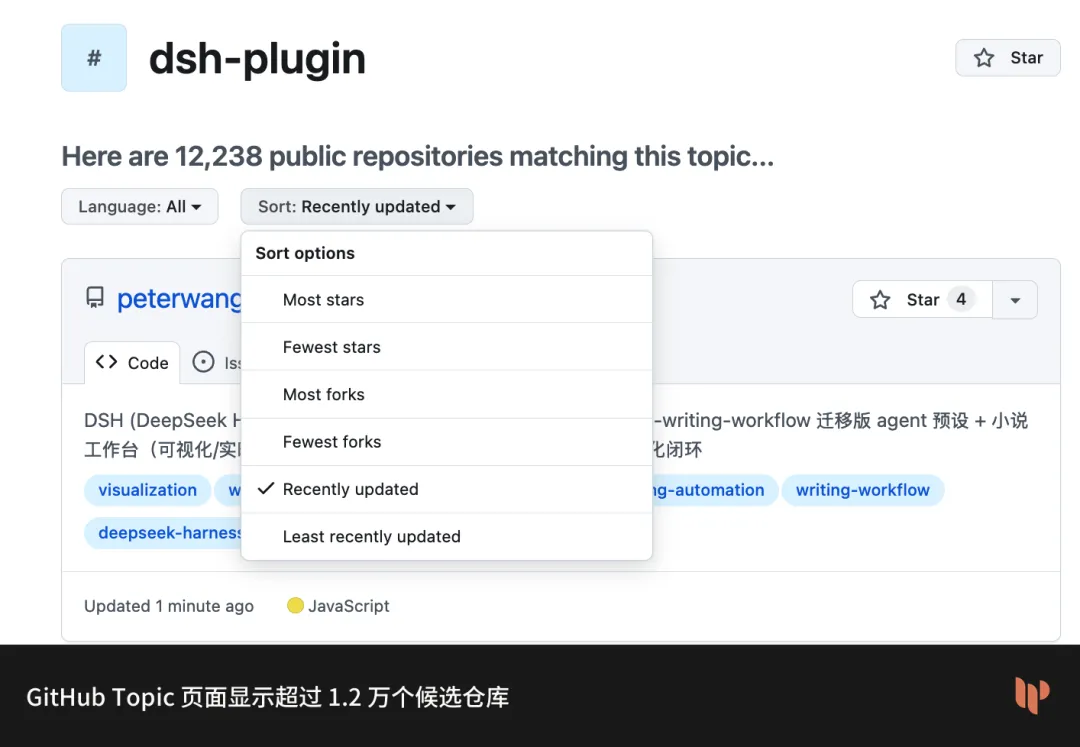
Repository Search 对单个查询最多只开放前 1000 条。直接翻页,永远拿不全。
先换掉错误的时间语义
最初我想按 Recently updated 从新到旧抓,记住上次时间点,下次抓到旧水位就停。这个方案很直观,却有两个硬伤:
updated_at 可以排序,却不能像 created:、pushed: 一样作为时间范围过滤条件;我另外开了一次架构会话,研究“给定 GitHub Topic,如何保证全面和及时”。当时得到的方案包含热扫描、按 created_at 递归分片、周期性集合对账和移除确认。
它很完整,也很重。
我的真实优先级没有那么复杂:
我最终选择 pushed: 时间区间递归二分:先探测区间总数,超过 1000 就继续二分;每个叶子区间按每页 100 条抓取。完整初始化和增量同步都使用同一套算法。
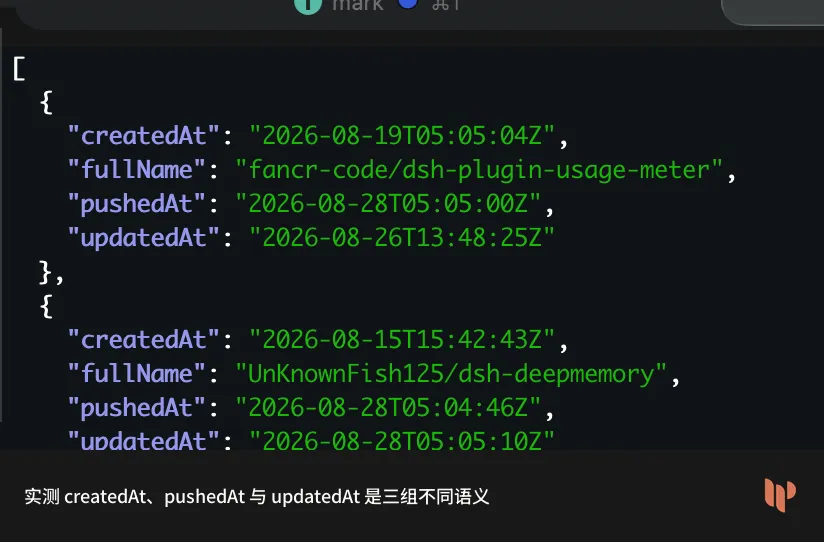
系统设计首先要承认什么不重要。否则,理论上的“绝不漏数据”很快就会长成一套与产品价值无关的基础设施。
AI 把一万多条数据全放在内存里
同步终于能跑了,体验依然很差。
AI 第一版把整轮结果都留在内存,等所有时间区间和页面抓完,再一次性写入 IndexedDB。中间只要遇到限流、断网、重启或关闭页面,下次全部重来。
超过 1.2 万条数据,第三方 API 受限,桌面应用又随时可能中断。可恢复性本来就该进入第一版架构。AI 当时只解决了“把数据抓完”,没有处理真实用户会遇到的等待和失败。
我先要求从最旧区间向最新区间抓。Agent 给出的 checkpoint 仍以“完整叶区间”为单位。
还是太粗。
我继续追问:每个请求返回后,把本页结果和下一个游标放进同一个事务,为什么还要等完整叶区间?
最终模型变成:
请求一页 ↓同一事务写入: - 本页 rows - 剩余时间区间队列 - 下一页 cursor - 已下载数量 - 固定的本轮上界 - 限流恢复状态 ↓事务成功后才继续下一请求事务前中断,重放当前请求;事务后中断,从下一请求继续。上一份完整目录始终可查,进行中的数据写入 staging,全部完成后再发布成正式目录。
AI 交付了 happy path。
checkpoint、恢复边界和等待体验,是我一轮轮追问出来的。
数据已经落盘,页面为什么还是空的
断点续爬完成后,市场列表依旧空白。
每页数据确实已经写进 staging,但列表只读取上一份完整快照,控制器也要等整轮结束才重新投影。
界面一边显示正在同步,另一边持续显示“没有找到匹配的插件”。
这个体验我无法接受。
我要求已抓取的数据立即进入列表。Provider 随后把“正式快照 + 已提交 checkpoint rows”合并成本地查询投影,控制器在提交数增长时后台刷新结果,同时区分三种完全不同的空状态:
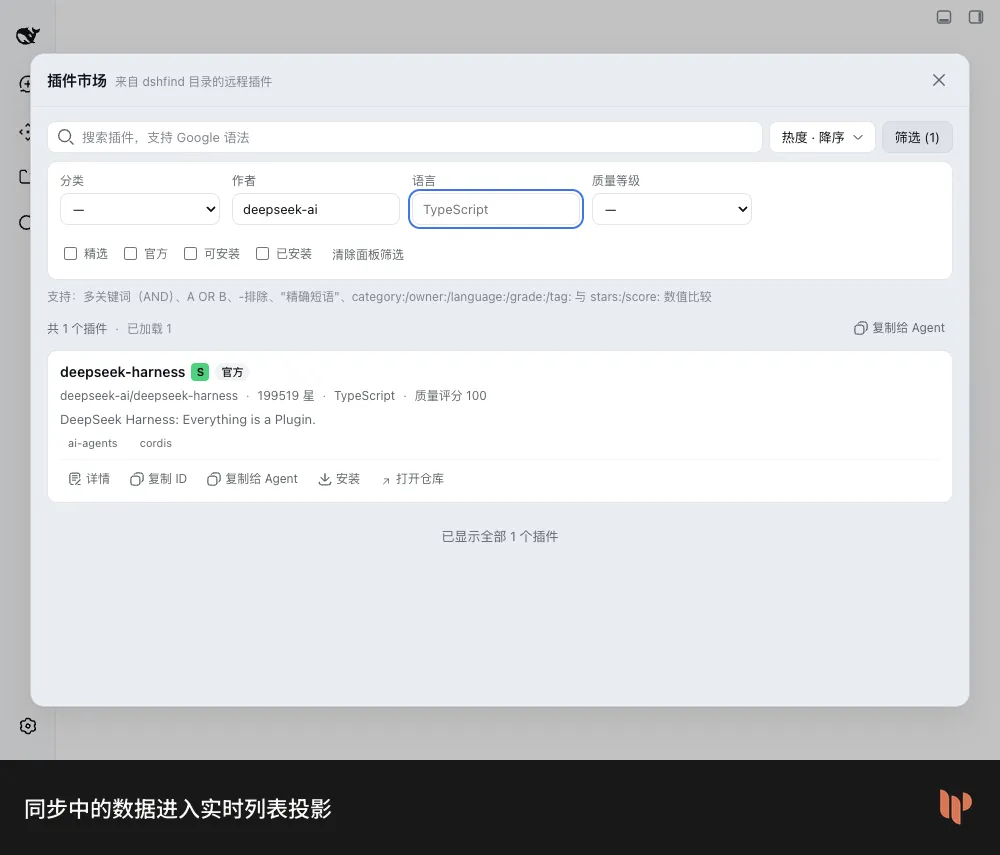
IndexedDB 里有数据,工程链看起来没错;用户看到的却是一张空页面。
产品显然还没有完成。
1269 条“增量”,到底增量了什么
第一次完整同步超过一万条后,我再次点击刷新,进度又从 100 / 1269 开始。
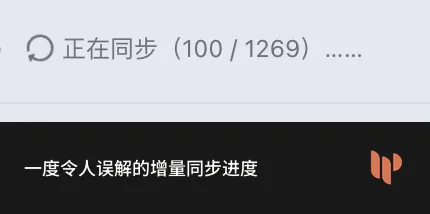
Agent 起初解释:这是新一轮增量批次,原来的完整目录没有丢。
这个解释只回答了“数据还在不在”,没有回答真正的问题:这么短的时间里,哪里来的 1269 条增量?
我继续往下追,原因才暴露出来。代码每次都会把上次游标向前回退 24 小时。GitHub 实测过去 24 小时约 1272 条,和页面数字几乎完全对上。
所谓增量,实际在重复抓一整天的数据。
删掉 24 小时重叠后,我又纠正了第二层游标语义。下一轮起点不该使用本轮开始时的墙上时钟,而要使用本轮实际返回数据中的最大 pushed_at;只有本轮没有结果,才推进到已经确认扫描完的区间上界。边界重复按 GitHub repository id 覆盖。
“防漏数据”听起来很安全。没有真实数据量的验证,它也可以稳定制造性能浪费。
05|UIUX 不是收尾,它决定这个市场会不会每天被使用
数据链收敛后,我开始集中处理搜索、筛选、排序、卡片和入口。
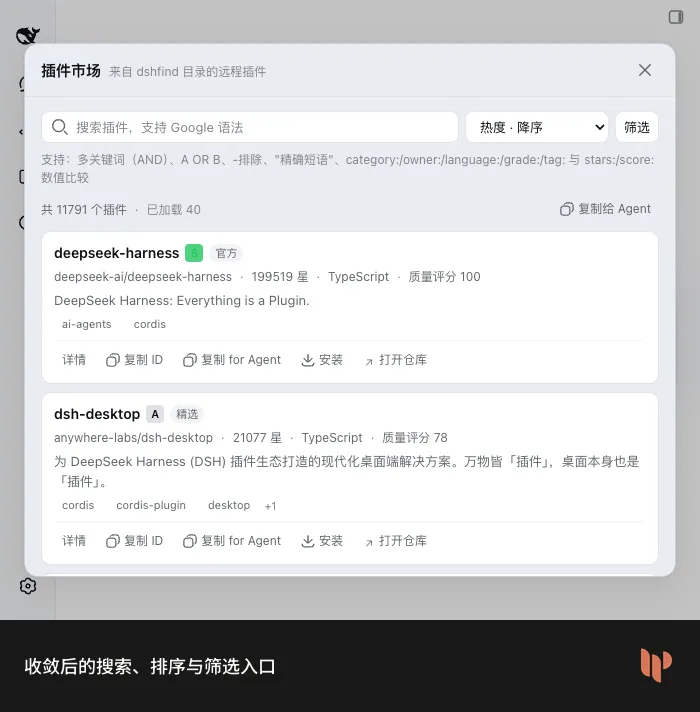
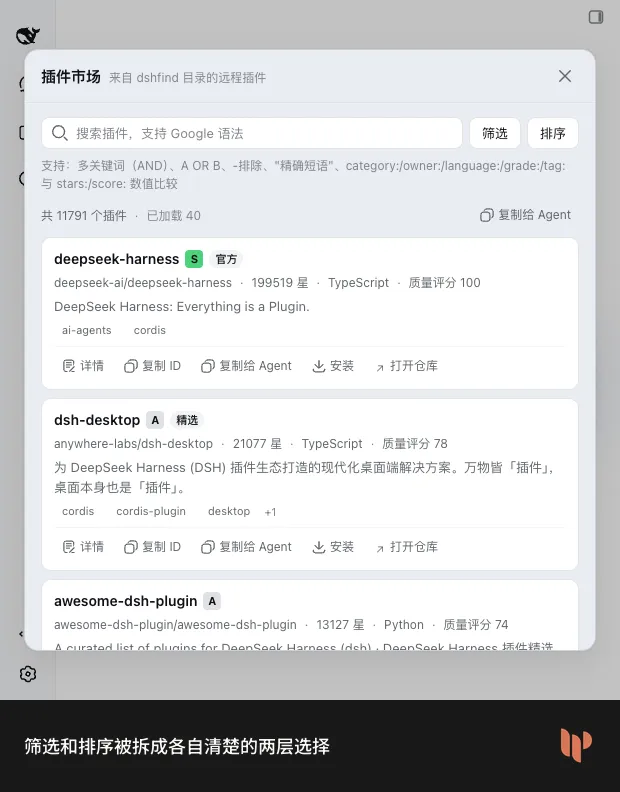
早期工具栏把“排序字段”“方向”“筛选”拆成多个密度和距离都不一致的控件,“复制已加载给 Agent”又挤在同一区域。功能都有,操作关系却没有形成。
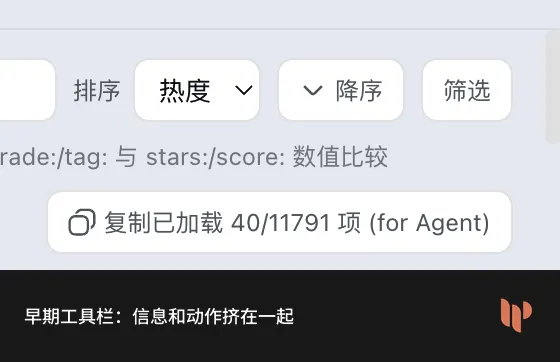
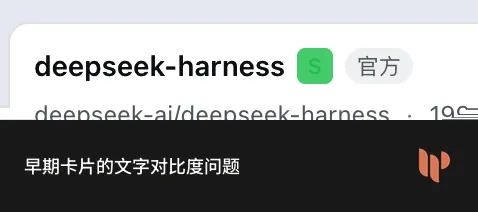
卡片里也有明显的对比度和语义问题:等级 icon 可以使用颜色区分,文字不能因此变得难读;“详情”缺少 icon;“复制给 Agent”和“复制 ID”没有清楚的动作差异。
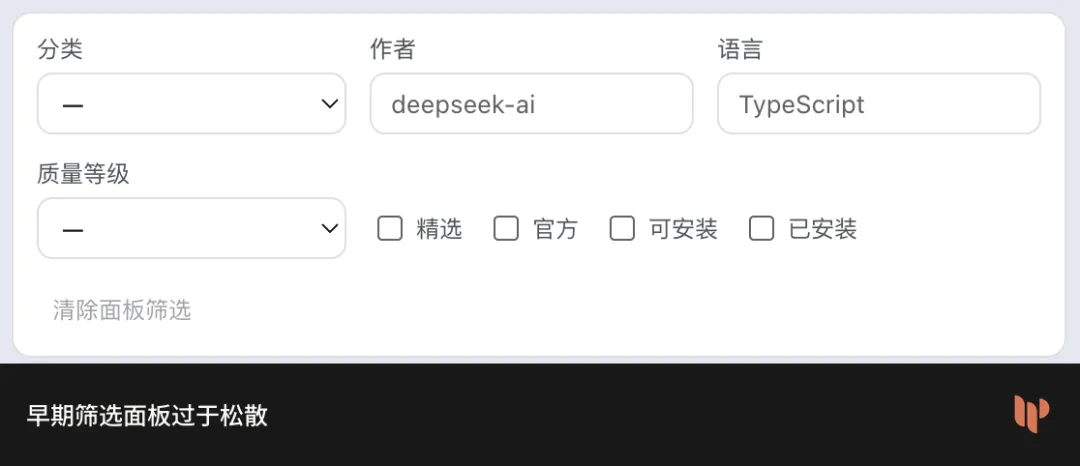
筛选面板一度像一张传统后台表单:字段散开,空值、勾选项和清除动作同时抢注意力。
我最后收敛出几条体验原则:
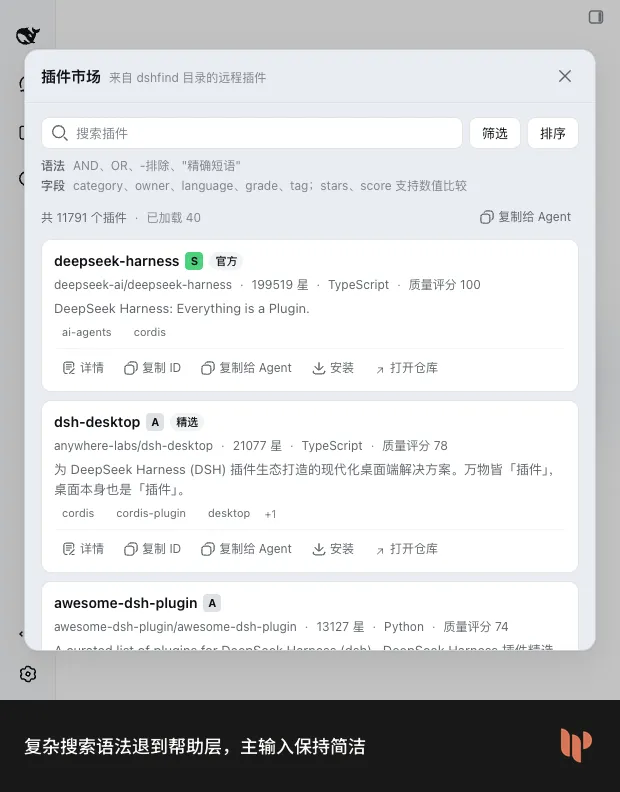
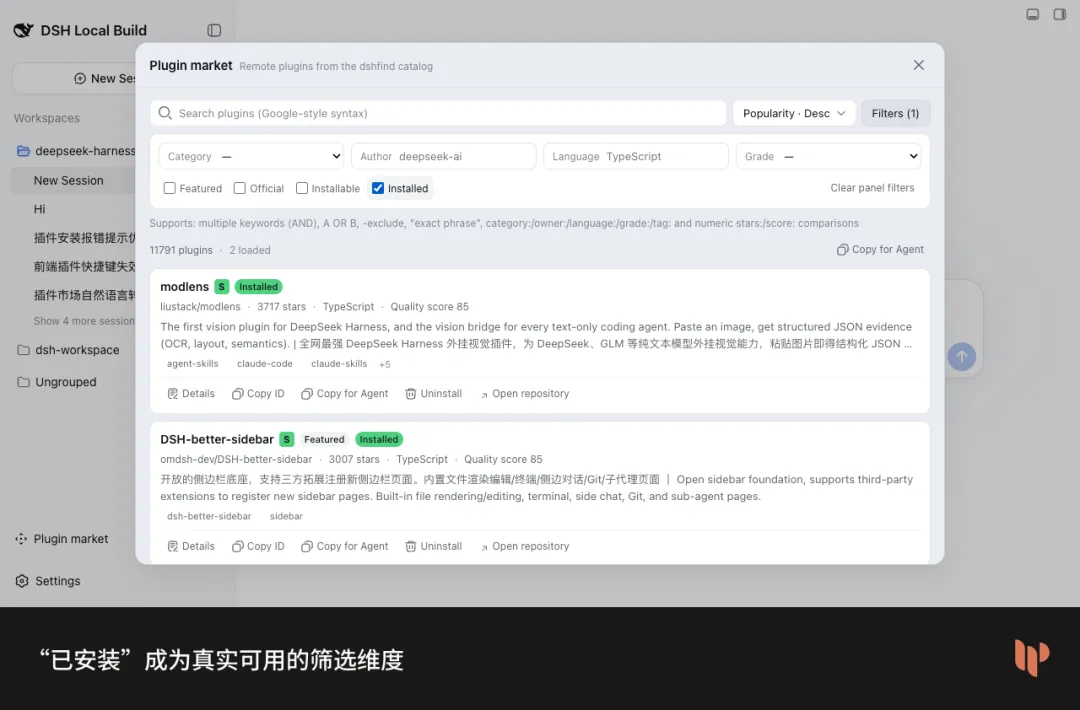
这些工作不是给完成品“美化一下”。它们在修正操作逻辑、信息优先级和用户预期。
一个每天使用的工具,是顺手,还是不断让人停下来理解,往往就差在这些地方。
06|市场做完了,安装、配置和重启却可能让它失效
找到插件,只是这条链的开头。
DSH 的插件能力横跨 bundle、profile、Host 和 Client。安装后的配置要进入原生插件设置;Host 端新增 Remote 或 schema 后,旧进程不会因为浏览器热更新自动获得能力;有些变化需要真正替换 Host PID。
最早连开发入口都不完整:npx lovstudio app deepseek-harness dev 会报 Command "dev" not found,仓库当时只有 dev:web。我先补出统一拉起前后端的 dev supervisor,后面才有条件在同一条日志里观察 watcher、Host 和页面加载。
8 月 27 日晚的一连串错误,把整条链暴露了出来:pluginManager/install 与 namespace service 冲突,Client module table 缺少 zod,第三方 UI bundle 加载失败,安装 dsh-better-sidebar 又被 ERR_PNPM_IGNORED_BUILDS 拦住。页面一度长时间停在“正在加载插件”。
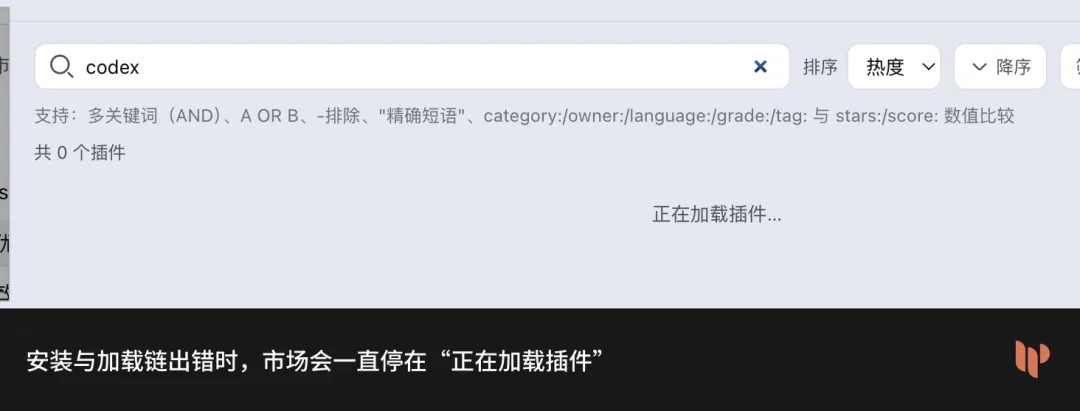
同一晚,已有插件 better-restart 也暴露出问题。按钮当时只在同一个 Node 进程里 dispose 再 boot,Cordis tree 重新加载了,后端进程根本没有重启。新增 Host provider、环境变量或构建产物之后,这种“假重启”无法提供可靠边界。
我继续把它改成真正的进程替换:
后续又发现,dev 冷启动会先打开旧 dist,前端 watcher 还要在后台构建约 20 秒。继续拆解后,真正的主要瓶颈是 96 个 tsdown 配置的首轮构建;frontend-inspector / LovInsp 确实增加约 0.4~1.1 秒,却没有“拖慢十几秒”。
市场页面、安装器、插件设置和 Host 重启看起来是不同模块,用户经历的却是一条连续路径:发现、安装、配置、生效、出错、恢复。
任何一段不可信,前面的 Marketplace 都只是一张目录。
这两天,我到底改了哪些判断
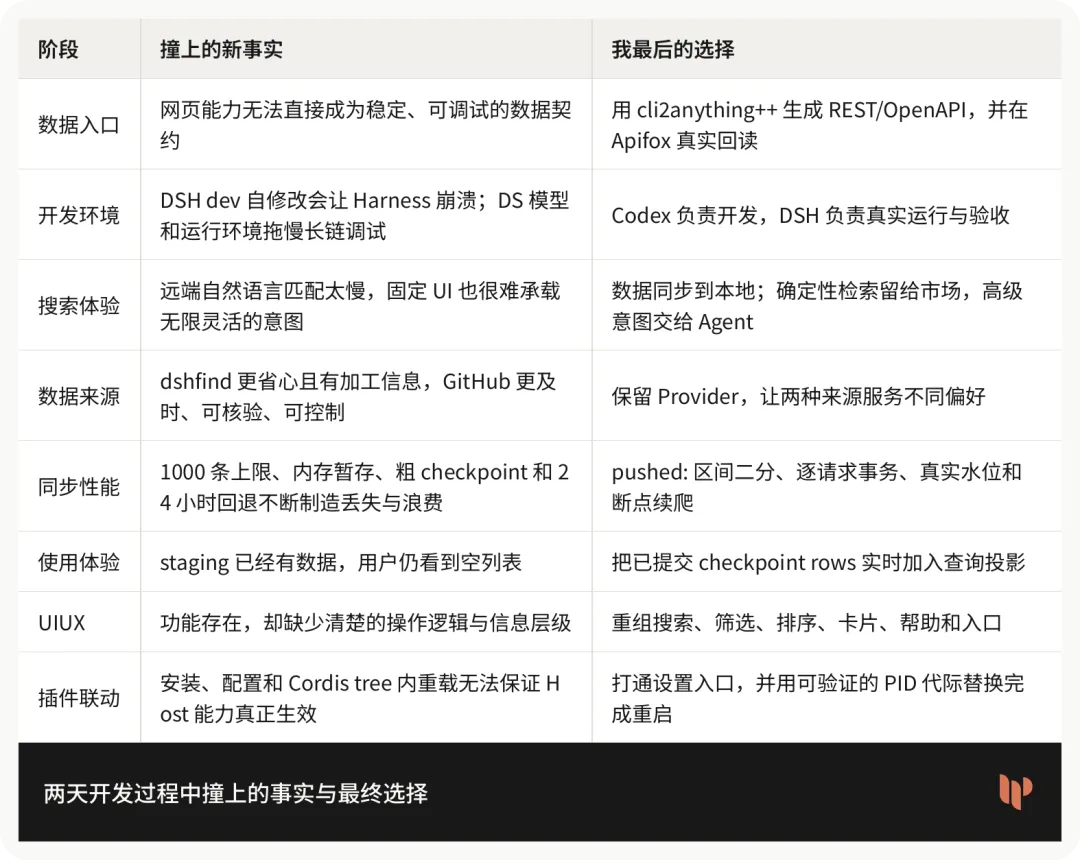
这次沉淀下来的,也不只有一个插件市场
值得补充的是,这次 Marketplace 并非一次孤立开发。
过去一两周,我围绕 DSH 的开发、调试、安装和发布不断往下挖,已经陆续沉淀出 5 个插件。其中 4 个已经公开发布、可以直接安装,1 个仍在 DSH 仓库内开发:
dsh-inject-system-prompt:给 DSH Agent 注入一段可配置的 system prompt;项目地址:https://github.com/lovstudio/dsh-inject-system-promptdsh-frontend-inspector:在 dev 模式下通过 Shift + Option + 点击 从页面直接定位到 React 组件源码;项目地址:https://github.com/lovstudio/dsh-frontend-inspectordsh-better-restart:在 Web 界面中执行可确认、可观察的应用重启,并处理正在运行的对话;项目地址:https://github.com/lovstudio/dsh-better-restartdsh-plugin-marketplace:本文最终做出的本地优先插件市场,支持 GitHub Topic 与 dshfind 两种 Provider、本地检索、增量同步和断点续爬;项目地址:https://github.com/lovstudio/dsh-plugin-marketplacedsh-llm-config:Host 侧的可复用 LLM profile 库。每个 profile 统一保存 provider、model 与 system prompt,其他插件只需要引用稳定 id,不必直接依赖 Host LLM 服务。这四个插件目前都已经发布到 npm。前三个 latest 为 v0.1.1,刚上传的 @lovstudio/dsh-plugin-marketplace 为 v0.1.0。
由于 dshfind 的公开目录快照仍停在 2026 年 8 月 27 日,新插件暂时还查不到;GitHub 仓库和 npm 包已经可以直接回读。
@lovstudio/dsh-llm-config 则是 v0.1.0-rc.8,当前仍标记为 private: true,没有独立的公开 GitHub 仓库,也没有发布到 npm,所以暂时不能和前四个放在同一类“可安装插件”里。
它来自 Marketplace 早期的自然语言搜索方案。当时我不希望每个 Client 插件自己选择 provider、model 和 system prompt,于是把 LLM profile 抽成 Host 侧公共能力。后来,自然语言搜索因为远端数据性能和固定 UI 的表达困难被移出市场,但这层配置能力仍然可以供其他插件复用。一次产品改向,并不要求把之前形成的通用工程能力一起丢掉。
开发过程中形成的经验,也被继续压缩成 4 个 Skills:
dsh-plugin-creator:从扩展点选择、脚手架、实现到仓库验证,完整走一遍 DSH 插件开发;体验地址:https://lovstudio.ai/skills/dsh-plugin-creatordsh-plugin-publisher:把已经验证的插件发布到 npm、Git 或 tarball,并回到 DSH 中确认它真的能够加载;体验地址:https://lovstudio.ai/skills/dsh-plugin-publisherdsh-search-plugin:从 dshfind 网关检索候选插件,连同评分、等级、stars、安装方式、风险标记和数据版本一起返回,避免只凭名称和简介做选择;dsh-search-or-create-plugin:先判断现有候选是 MATCH、PARTIAL 还是 NO-MATCH;确实没有合适插件时,再把能力缺口写成新插件 brief,交给 Creator 继续实现。后两个 Skills 已经在我的本地工作流中使用,但目前还没有公开详情页。这里先保留准确名称和能力边界,等公开分发完成后再补安装链接。
这组沉淀有一条很清楚的因果链。frontend-inspector 解决开发时如何快速定位页面源码,better-restart 解决 Host 能力如何真正生效,llm-config 把插件共用的模型配置收回 Host,两个搜索 Skills 负责发现与取舍,Creator 和 Publisher 继续覆盖创建、验证与分发。Marketplace 把这些能力收回到一个每天可以使用的入口。
我把目前可以公开阅读和体验的内容集中到一个专题页。后续新的 DSH 插件和 Skills,也会继续从这里进入。
DSH 专题页 https://lovstudio.ai/dsh
07|我做出来的插件会继续变,这套判断方式更值得留下
现在这个插件市场已经具备本地优先检索、可替换 Provider、GitHub 时间区间二分、逐请求 checkpoint、断点续爬、实时结果投影、安装态筛选和原生设置入口。
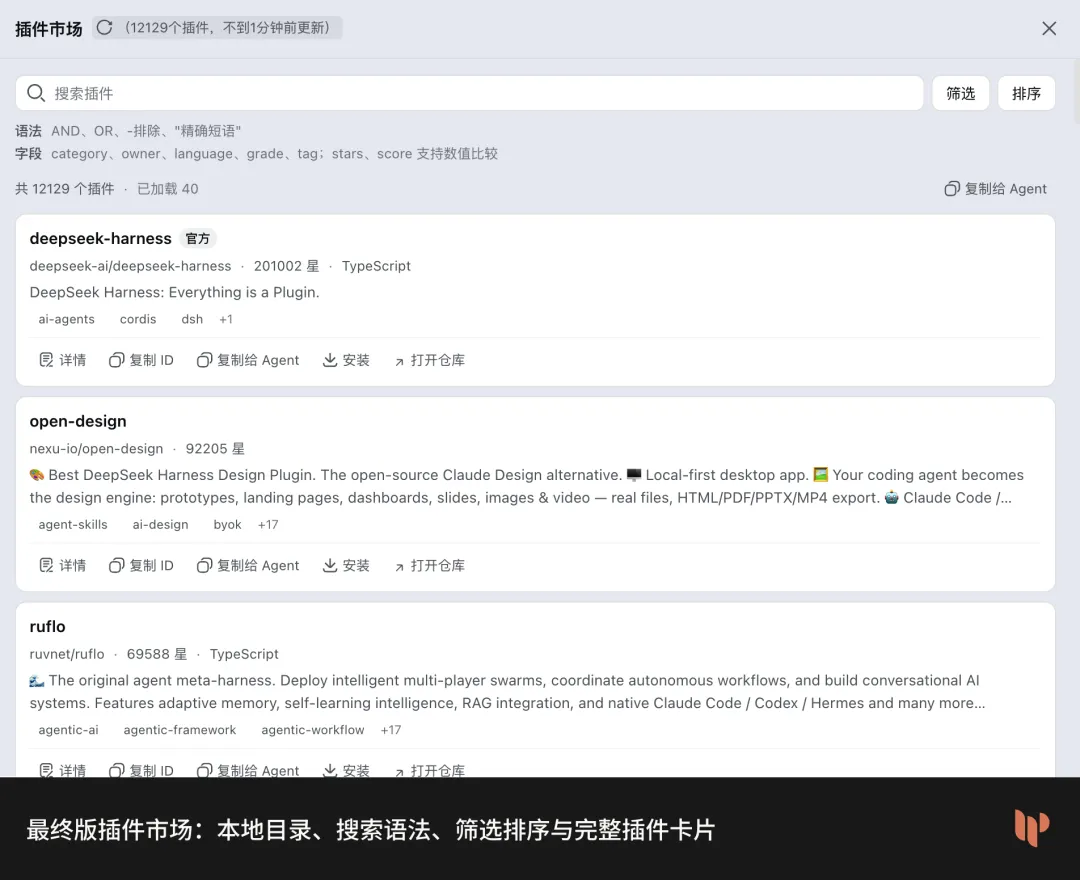
它当然还会继续变。
IndexedDB 可能迁到后端,Provider 可能增删,GitHub 的规则也可能变化。
具体实现没有必要被神圣化。两天里真正留下来的,是一套在 Agent 编程中不断校正产品的方式。
让 Agent 修改 Harness 自身,会产生特殊的递归风险。运行环境、开发模型、插件树和宿主进程互相依赖,工作 Agent 与被修改实例需要适度隔离,还要为崩溃恢复保留外部控制面。
AI 很擅长快速铺出 happy path。
checkpoint、游标语义、旧快照可用性、投影刷新和进程代际,经常要靠工程经验继续追问。
函数写得漂不漂亮没有那么重要。中断、限流、重启、并发和重复数据出现时,系统能不能继续,才决定它是否可靠。
产品判断也必须贴着事实走。远端搜索太慢,就把高频操作搬到本地;自然语言很难在固定 UI 中讲清,就交还给 Agent;24 小时重叠制造 1200 多条重复,就重新定义水位。每次改向都有成本,也都要有证据。
对 AI 产品团队来说,模型能力会显著降低实现成本,却不会承担 taste、取舍和产品责任。做什么、做到什么程度、用户为什么会焦虑,最后仍然需要人持续判断。
回头看,我动手的原因恰恰是市面上已经有十多个插件市场。选择越多,挑选和理解的成本越高。既然 DSH 会成为我长期使用的重度工作台,我愿意亲手掌握其中最关键的一条链。
Agent 可以把实现推得很快。一个产品最终是否值得每天使用,仍然取决于人有没有持续追问、验证,并为自己的 taste 做选择。
如果你也在 DIY 自己的 Agent Harness,可以先问自己一个问题:哪些能力会长期影响我的工作,所以值得我亲手理解?
答案不必和我一样。
但你的每一次 pivot,都应该有原因、有证据,也有你愿意承担的代价。
本期封面
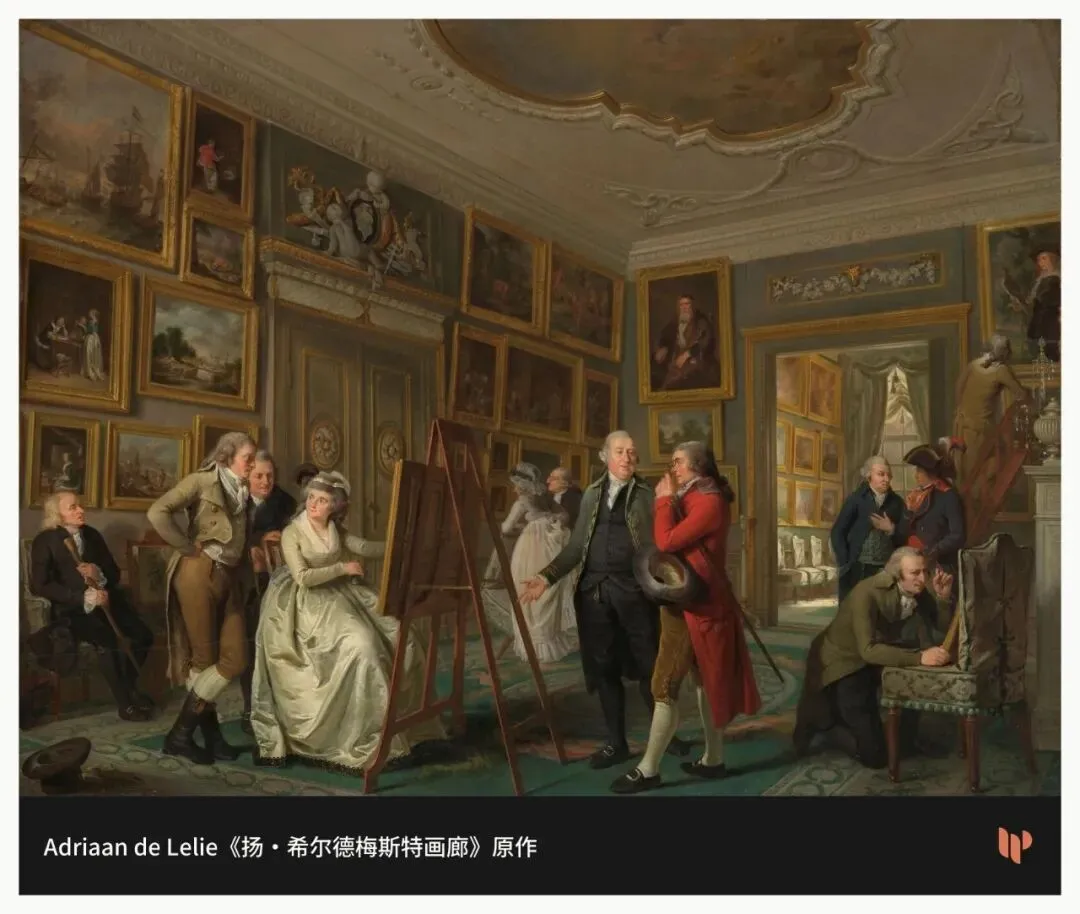
这期封面选用荷兰画家 Adriaan de Lelie 的《扬·希尔德梅斯特画廊》(The Art Gallery of Jan Gildemeester Jansz,1794—1795)。
1792 年,阿姆斯特丹商人扬·希尔德梅斯特把运河边住宅里的两个大房间改造成私人画廊。画中,墙面密密挂着镀金画框,客人没有被动站成一排,而是在交谈、比较和观看;希尔德梅斯特站在前厅中央,画家本人则出现在右侧前景。门洞之后还有第二个房间,提示这套收藏远比第一眼所见更大。
我喜欢它与这篇文章形成的关系:当作品越来越多,价值不再只是“拥有一个目录”,而是知道它们从哪里来、怎样被组织、如何被理解,以及谁在为选择负责。三百年前的私人画廊与今天的插件市场当然不是一回事,但它们都在处理同一个问题——面对不断增长的供给,如何建立自己的判断与秩序。
作品现藏于 Rijksmuseum。馆方将数字图像标记为 Public Domain。
馆藏页:https://www.rijksmuseum.nl/en/collection/object/The-Art-Gallery-of-Jan-Gildemeester-Jansz--01a1742c9b17d32c1e8b27d0827aac5a
生命的意义在于创作
手工川工作室(LovStudio)是一间由独立开发者驱动的 AI 产品工作室,持续把想法做成真正可用、可发布的产品。
Yoda 是手工川工作室打造的 AI 工作空间,让任务、会话、代码与制品在一个连续上下文中协作推进。