ARTICLE · 984254
口腔诊断AI|Nat Commun(IF=15.7)浙江大学&上海九院&北大口腔&华西口腔等:拍牙片,能诊断36种问题!覆盖7类口腔影像和36项诊断任务
口腔AI医生来了
口腔AI以前给人的印象,更多是“识别一个病”:
看全景片识别龋齿,
看CBCT做牙齿分割,
看头颅侧位片找标志点,
看口内照片判断牙列拥挤。
这些任务当然有用,但和真实口腔门诊还有距离。临床医生面对的不是一道单选题,而是一个患者:全景片、头颅侧位片、口内照片要一起看;既要判断龋病、牙周病、根尖周炎,也要识别种植体、冠桥、根管治疗;如果是正畸患者,还要看骨性分类、覆牙合、覆盖、开牙合、反牙合、牙列拥挤和面型。
这篇 Nature Communications 文章做的,就是把口腔AI从“单点识别”往“综合诊断助手”推进一步。研究团队提出 DentVLM,一个面向牙科场景的视觉语言模型,可覆盖7类口腔影像、36项诊断任务,并输出诊断答案、诊断理由和病变位置。
清璟AI——清北医工交叉团队,擅长AI智能体、大模型、深度学习、机器学习、多模态与多组学等,能够为医学研究者和临床医生提供全方位的支持与创新解决方案。我们拥有顶级科研资源,欢迎咨询!共同探索AI与医学的无限可能,一起发顶刊!
研究速览
口腔疾病影响人群广泛,但专科牙科资源分布并不均衡。现有牙科AI多集中在单一任务,难以满足真实门诊中多影像、多疾病、多治疗状态共同判断的需求。
本研究构建了 DentVLM,基于Qwen2-VL-7B进行两阶段训练。第一阶段使用2.37百万简单VQA问答对进行视觉-语言对齐;第二阶段使用88.6K带诊断理由和定位信息的高质量VQA进行诊断指令微调。整个训练集来自20,741名患者、110,447张图像、2.46百万中英文视觉问答对。
结果显示,DentVLM在内部测试、外部数据集和临床读者研究中均表现较好。模型平均较领先基线提升23.8%,超过初级读者,接近中高级医生;在人机协作中,还能将诊断时间缩短15.0%–37.0%。
研究团队
这项研究由浙江大学医学院附属口腔医院/浙江大学口腔医学院、浙江大学计算机学院、上海交通大学医学院附属第九人民医院、时代天使科技、深圳大学第一附属医院、北京大学口腔医院、新加坡管理大学、A*STAR、四川大学华西口腔医院、伊利诺伊大学厄巴纳香槟分校等团队合作完成。
从单位构成看,这不是单纯算法团队做口腔影像,而是口腔临床、正畸、计算机视觉、多模态大模型和企业真实数据场景共同参与的研究。
研究亮点
覆盖7类口腔影像:包括全景片、头颅侧位片和5类口内照片。
覆盖36项诊断任务:同时包括口腔疾病、治疗识别和错颌畸形判断。
训练数据规模大:110,447张图像,2.46百万中英文VQA问答对。
不是只给答案:模型还能输出诊断理由和病变区域定位。
有临床读者研究:32名不同经验层级读者参与验证AI独立诊断和辅助诊断价值。
做了外部验证:在Türkiye Dentex和美国TDD数据集上测试模型泛化能力。
研究结果
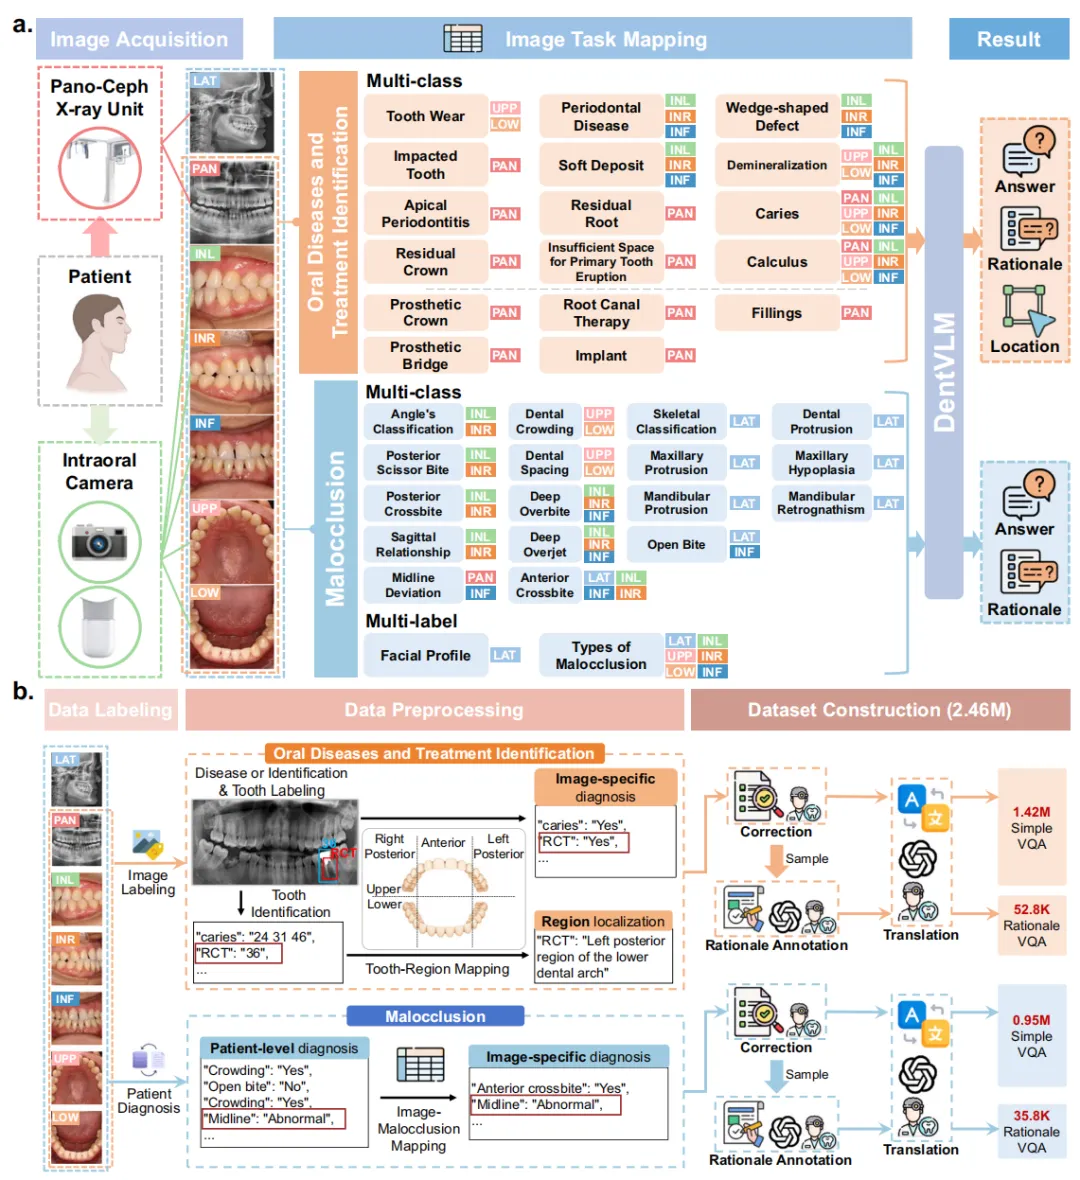
Figure 1|DentVLM到底看什么?7类影像,36项任务
图注:
Figure 1展示DentVLM的问题定义和数据构建流程。模型输入包括头颅侧位片、全景片、左侧口内照、右侧口内照、正面口内照、上牙弓照和下牙弓照;诊断任务包括口腔疾病与治疗识别、错颌畸形判断两大类;输出包括答案、诊断理由和病变定位。
图示解读:
这张图把DentVLM和传统口腔AI的区别讲清楚了。
它不是只看一种影像,也不是只判断一种疾病。龋齿、牙结石、牙周病、根管治疗、种植体、残根残冠、阻生牙、根尖周炎、修复冠桥,这些属于疾病和治疗识别;骨性分类、开牙合、深覆牙合、反牙合、牙列拥挤、牙列间隙、面型,则属于错颌畸形相关任务。
更关键的是,DentVLM采用VQA形式工作。医生可以把影像和问题一起输入,模型返回诊断结果,还能补充“为什么这样判断”和“病变大概在哪里”。这比传统分类模型更接近医生实际使用方式。
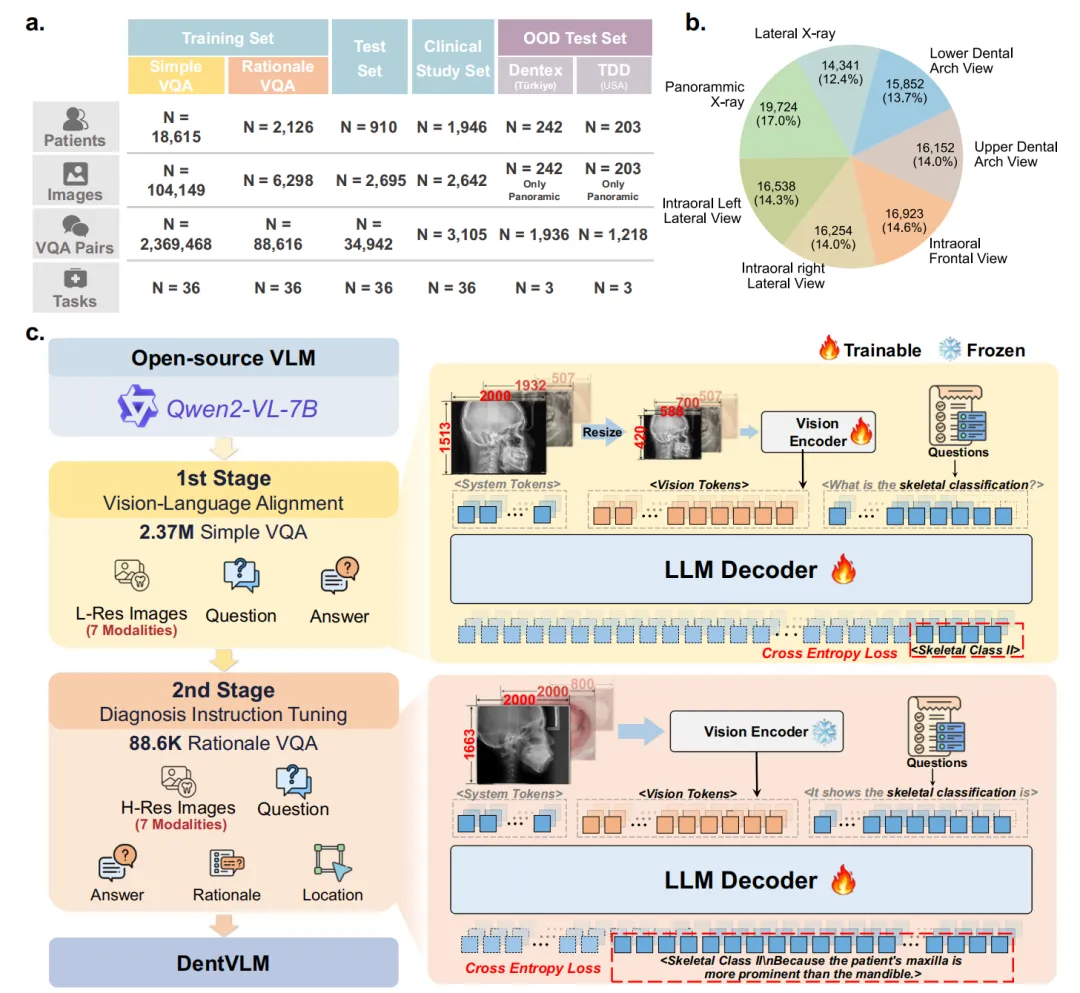
Figure 2|训练策略:先学会看牙,再学会解释
图注:
Figure 2展示DentVLM的数据统计和两阶段训练框架。训练数据包括2.37百万简单VQA和88.6K带理由VQA。第一阶段使用低分辨率多模态图像进行视觉-语言对齐;第二阶段使用高分辨率图像和带理由答案进行诊断指令微调。
图示解读:
DentVLM的训练逻辑很清楚:先让模型“认识口腔世界”,再让模型“按照临床方式回答”。
第一阶段数据量大,目标是让模型熟悉口腔图像和专业概念之间的对应关系。比如看到全景片上某个牙位的根管充填,知道它对应“root canal therapy”;看到口内照片中的牙列拥挤,知道该如何回答对应问题。
第二阶段数据量更小,但质量更高。模型不再只学习“是/否”或分类答案,而是学习答案、理由和位置。例如,不仅回答有龋齿,还要指出证据和区域。
这一步很重要。临床医生不会只接受一个黑箱答案,尤其在口腔诊断里,病变位置、影像依据和诊断逻辑都会影响后续治疗选择。
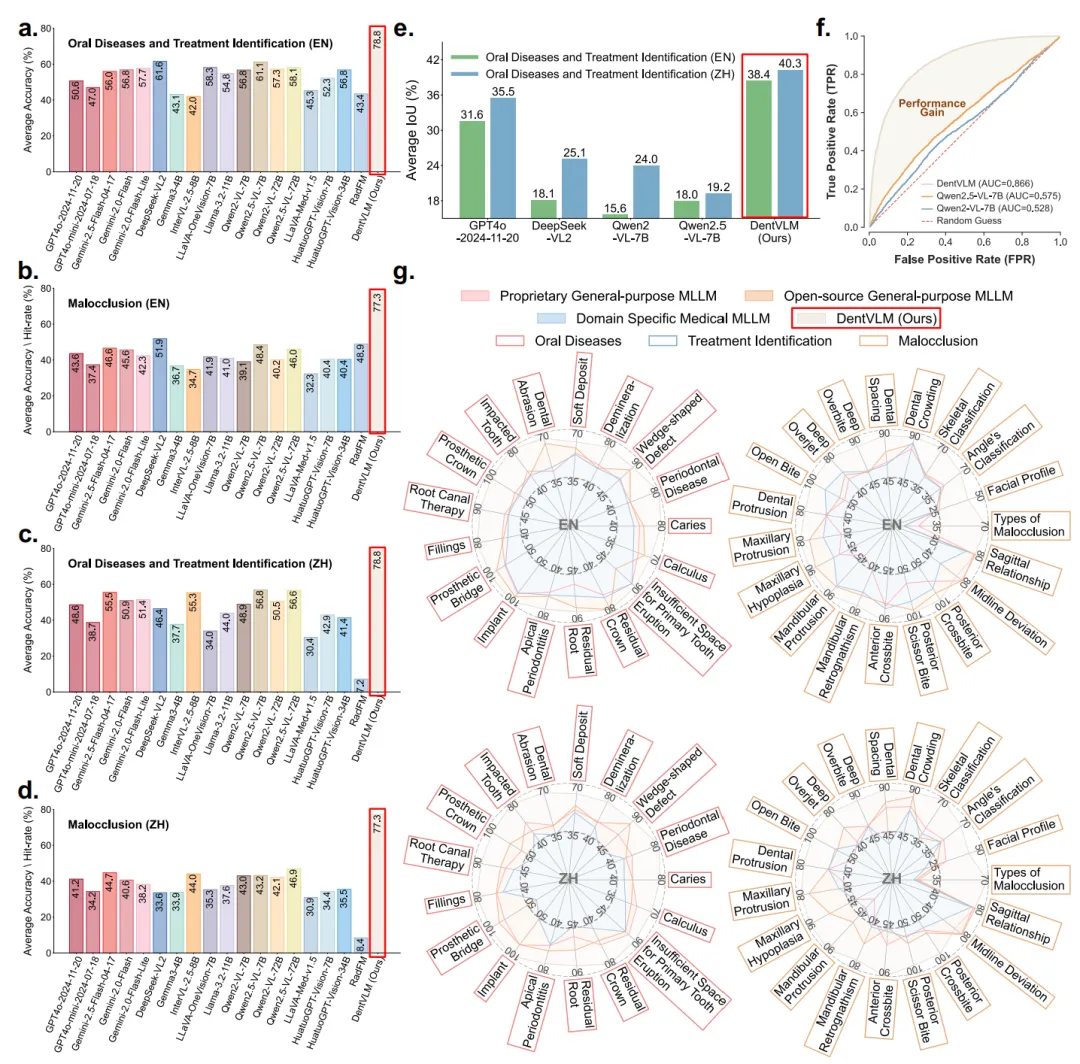
Figure 3|模型对比:DentVLM超过18个主流模型
图注:
Figure 3比较DentVLM与18个基线模型在不同任务和语言环境下的表现。基线包括GPT-4o、Gemini、DeepSeek-VL2、Qwen2/2.5-VL、LLaVA-Med、HuatuoGPT-Vision和RadFM等通用或医学多模态模型。
图示解读:
结果比较直接。DentVLM在中英文场景下均显著优于各类基线模型,平均较领先基线提升23.8%。在口腔疾病与治疗识别任务中,平均准确率为78.8%;在错颌畸形任务中,平均准确率为77.3%。
定位能力也有提升。DentVLM平均IoU为39.4%,较GPT-4o高5.8%。在32项二分类任务的ROC分析中,DentVLM平均AUC为0.866,明显高于Qwen2.5-VL-7B和Qwen2-VL-7B。
这说明一个问题:通用多模态模型虽然能看图、能回答,但在细粒度牙科影像上,仍然需要专科数据和专科任务训练。口腔影像里很多异常非常小,治疗痕迹和活动性病变也容易混淆,裸用通用大模型并不稳。
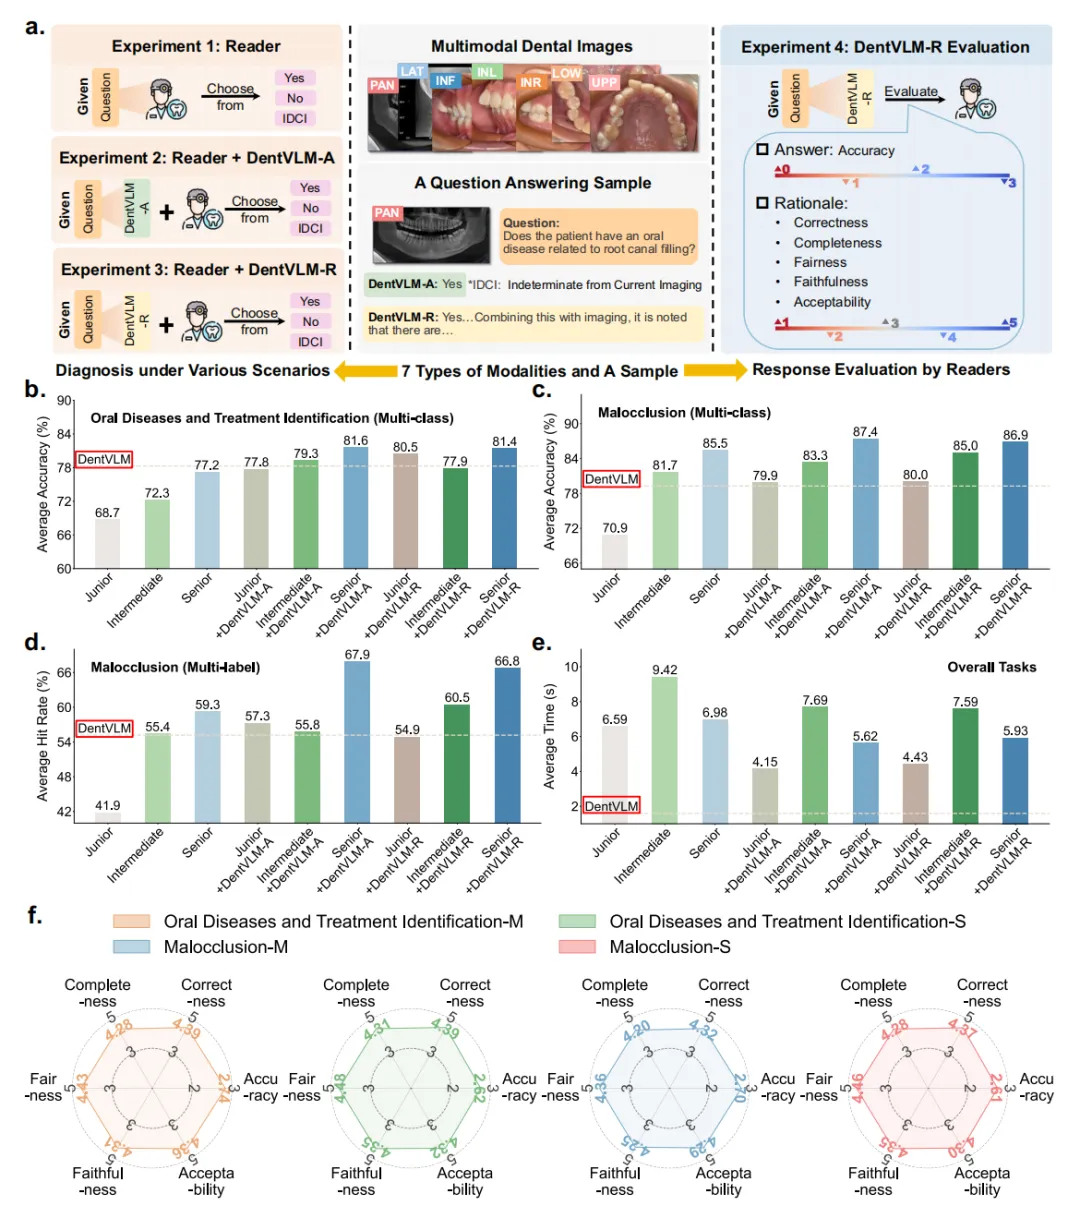
Figure 4|临床读者研究:AI最适合做“第二读片者”
图注:
Figure 4展示DentVLM临床读者研究。32名读者分为初级、中级和高级三组,分别完成独立诊断、DentVLM答案辅助诊断、DentVLM答案+理由辅助诊断,并评价模型回答的准确性、正确性、完整性、公平性、忠实性和可接受性。
图示解读:
这部分最贴近临床。
DentVLM单独诊断平均准确率为77.6%,显著高于初级读者,与中级全科牙医接近,并接近高级专科医生水平。分任务看,在普通口腔疾病和治疗识别中,DentVLM甚至略高于高级医生;但在复杂错颌畸形任务中,DentVLM仍低于高级正畸专科医生。
这个结果并不意外。龋齿、修复体、根管治疗、种植体这类任务更偏视觉识别,AI容易发挥优势;但错颌畸形涉及更复杂的空间关系和专科经验,尤其还缺少CBCT、口扫等3D信息,模型自然更难完全追上专家。
在人机协作中,AI帮助最明显的是初级和中级读者。初级读者平均提升10.5%;中级读者在错颌任务中更受益于带理由输出;高级医生则更多把AI当作快速核查工具。
效率方面,DentVLM让不同层级读者诊断时间缩短15.0%–37.0%。这也是它更现实的定位:不是替代医生,而是在基层、初筛、教学和复核中提高效率。
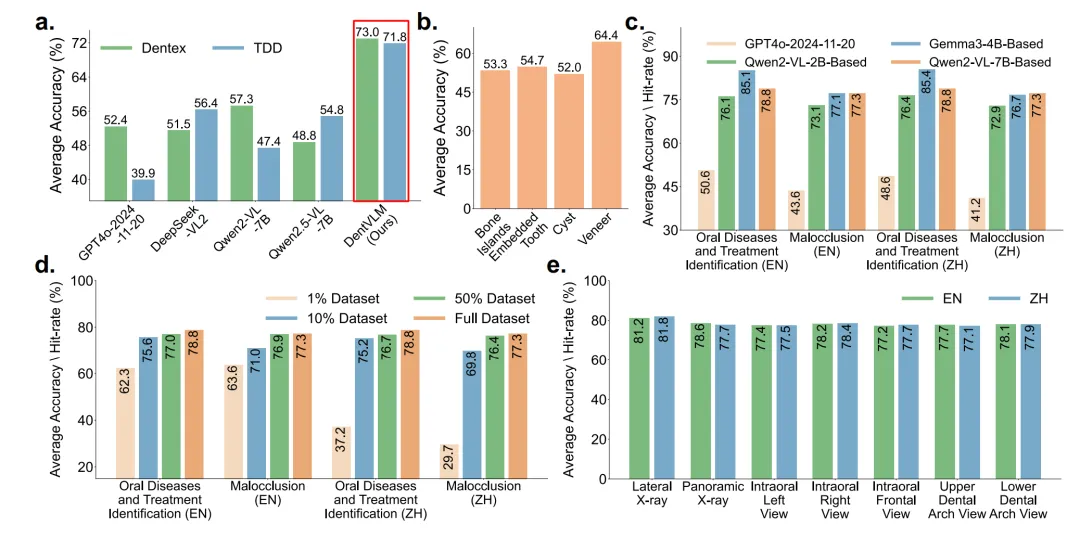
Figure 5|外部验证:不是只在本院数据上好看
图注:
Figure 5展示DentVLM在外部全球数据集、训练外任务、不同基座模型和不同数据规模下的泛化表现。外部数据包括Türkiye Dentex和美国TDD数据集,训练外任务包括骨岛、埋伏牙、囊肿和贴面。
图示解读:
外部验证是这篇文章的一个加分点。
在Dentex和TDD两个外部数据集上,DentVLM分别较最接近竞争模型平均高出15.7%和15.4%。这说明模型并非只适配中国本地设备和人群,对不同国家、不同设备来源的全景片也有一定泛化能力。
训练外任务也值得看。骨岛、埋伏牙、囊肿和贴面并没有出现在训练任务中,DentVLM在零样本条件下取得**52.0%–64.4%**的准确率。这个水平还不能直接用于临床,但说明模型确实学到了一部分通用牙科视觉知识。
数据规模实验也很现实:1%、10%、50%、100%数据训练下,模型表现呈现明显增长。尤其是错颌畸形和中文任务,对数据规模更加敏感。换句话说,牙科VLM不是靠“小样本微调”就能轻松做好的,专业数据量仍然是核心门槛。
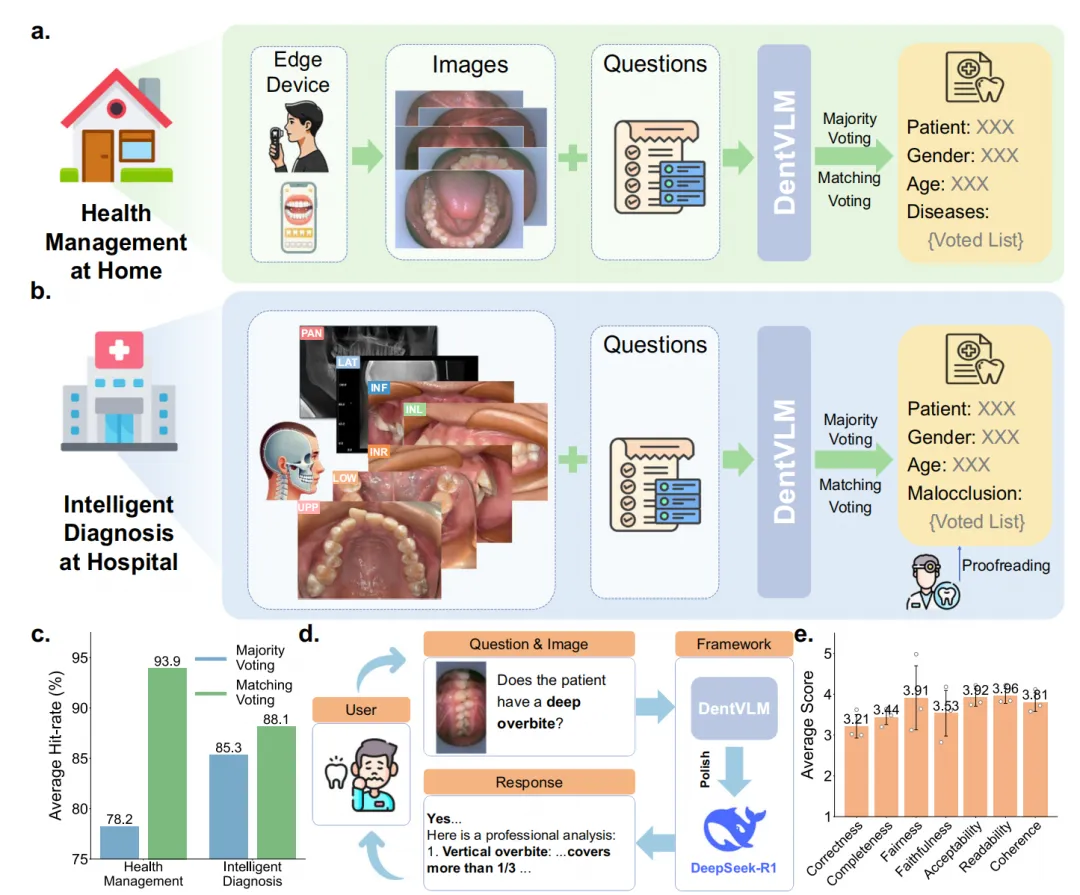
Figure 6|真实应用设想:家庭筛查、医院诊断、多智能体交互
图注:
Figure 6展示DentVLM的三类实际应用探索:家庭口腔健康管理、医院智能诊断和多智能体协作交互。家庭场景中,用户通过手机或便携设备采集口内图像;医院场景中,系统整合7类专业口腔影像;多智能体框架中,DentVLM生成初始诊断,再由DeepSeek-R1优化表达和交互。
图示解读:
这张图把DentVLM的使用场景讲得很具体。
在家庭健康管理中,用户拍摄5类口内照片,系统对龋齿、牙周病、楔状缺损、脱矿、菌斑、牙磨耗、牙结石等任务进行初筛。61例患者测试中,匹配投票策略诊断匹配分数为93.9%,多数投票为78.2%。
在医院正畸诊断中,模型整合7类专业影像,对错颌表现进行结构化判断。69例外部测试患者中,匹配投票分数为88.1%,多数投票为85.3%。
研究还尝试把DentVLM和DeepSeek-R1组合成多智能体框架。DentVLM负责看图和初步诊断,推理模型负责把回答改写得更清楚、更适合多轮交流。这很适合患者教育和远程咨询,但真正临床使用仍需要医生复核。
这篇文章怎么读,才不跑偏?
第一,DentVLM不是“AI牙医独立接诊”。
它目前更适合定位为辅助诊断工具,尤其适用于口腔初筛、基层辅助、教学训练和医生复核。
第二,它强在2D多模态综合诊断,但不是完整口腔治疗规划。
研究主要基于全景片、头颅侧位片和口内照片。复杂正畸、种植、颌骨空间关系分析仍需要CBCT、口扫、面扫等3D数据支持。作者也明确指出,3D模态整合是未来方向。
第三,模型在普通口腔病变识别上更强,在复杂错颌诊断上仍有差距。
这很符合临床常识。正畸诊断依赖长期专科训练和三维空间推理,单靠2D图像和VQA任务还不够。
第四,理由输出有帮助,但也可能增加认知负担。
研究发现,中级医生更受益于模型理由,而高级医生更多把AI答案当作核查工具。未来系统可能需要根据医生经验和任务难度,决定是否展示详细理由。
给临床团队的课题启发
这篇文章很适合口腔医院、正畸科、牙体牙髓科、牙周科、口腔影像科、基层口腔门诊和医工交叉团队参考。
方向一:口腔多模态VLM辅助诊断
整合全景片、头颅侧位片、口内照片、病历文本和检查记录,建立面向口腔综合诊断的视觉语言模型。
方向二:基层口腔筛查系统
从龋齿、牙周病、牙结石、楔状缺损、脱矿等高频病变入手,做手机端或便携设备口腔初筛。
方向三:正畸智能诊断与治疗前评估
围绕错颌分类、牙列拥挤、覆牙合覆盖、面型、骨性分类等任务,构建多影像联合模型。
方向四:可解释口腔AI研究
不要只输出诊断结果,应同步设计诊断理由、病变定位、医生可复核界面和错误案例分析。
方向五:人机协作读片实验
比较医生独立诊断、AI独立诊断、医生+AI辅助诊断,在准确率、耗时、一致性和不同年资医生收益上的差异。
方向六:3D口腔多模态扩展
后续可以加入CBCT、口扫、面扫和咬合记录,让模型从2D诊断走向更完整的治疗规划辅助。
写在最后
口腔AI正在从“识别一个病”走向“理解一个患者”。
DentVLM这项研究之所以值得关注,不只是因为模型指标高,而是它把牙科临床里常见的多影像、多任务、多语言、可解释输出和人机协作都放进了同一个框架里。这样的设计比单病种AI更接近真实口腔门诊。
但也要清楚,它还不是一个可以独立决策的牙科医生。复杂错颌、种植规划、颌面三维结构评估,仍然需要更完整的数据和专科医生判断。DentVLM更现实的位置,是做一个标准化初筛、辅助诊断、教学训练和基层口腔服务补位工具。
如果你的团队有口腔影像、正畸病例、口内照片、CBCT、口扫或随访数据,可以从“口腔多模态AI辅助诊断”切入。真正值得做的不是再训练一个单病种检测模型,而是围绕临床工作流,把图像、问题、诊断、理由、定位和医生复核连成闭环。
关于我们
清璟AI由国内TOP2高校医工交叉博士联合创立,专注于医疗大模型科研、影像组学、病理组学、深度学习、AI智能体、生信分析、多组学、多模态和各类人工智能算法。致力打造一站式Al+医学科研生态圈,提供专业的AI智能体、高端科研资源及一对一定制化服务。我们的服务涵盖从科研方案设计、数据处理到AI模型训练及系统开发等各个领域,旨在为医学研究者和临床医生提供全方位的支持与创新解决方案。携手清璟AI,让科研更智能,让医学更精准。
科研合作请联系
长按二维码加微信