ARTICLE · 985204
第358讲:用 Python 和 Excel VBA 两种方式:用户留存(Cohort Analysis)矩阵自动生成
运营同学每月最头疼的事之一,就是从千万条登录日志里算出“新用户的次月留存率”。数据源只有一张表:用户ID、登录日期。本文用 Python 和 Excel VBA 两种方式,手把手带你从0生成留存矩阵,并对比两种技术路线的核心差异。
一、场景与数据说明
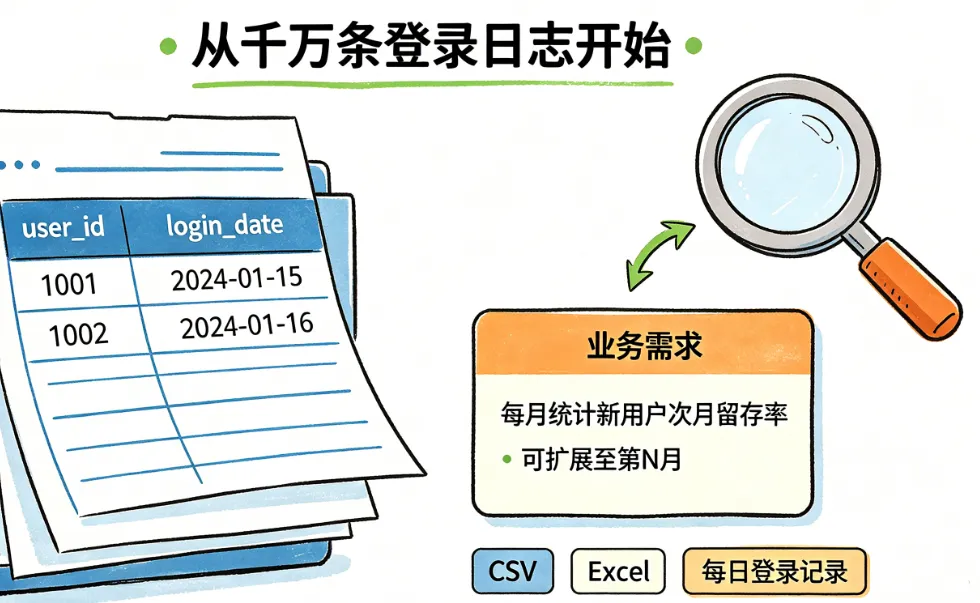
业务需求:每月统计新用户的次月留存率、三月留存率(可扩展至第N月)。
原始数据:每日登录日志(CSV 或 Excel),字段至少包含:
user_id | login_date |
|---|---|
1001 | 2026-01-15 |
1002 | 2026-01-16 |
... | ... |
关键指标定义:
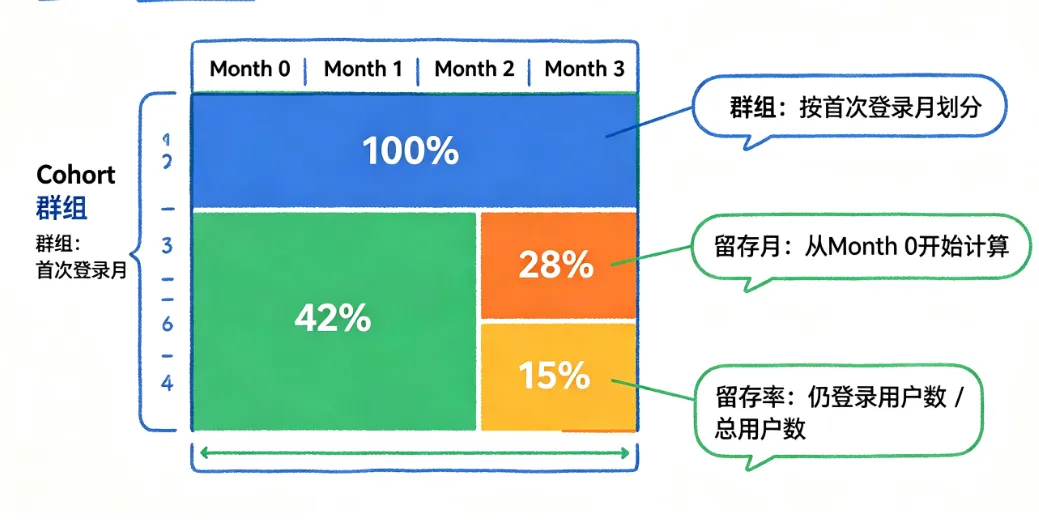
Cohort 群组:按用户首次登录月份划分(如 2026-01 月的新用户群)。
留存月份:首次登录月为 Month 0,次月为 Month 1,三月后为 Month 3。
留存率 = 该月仍登录的用户数 / 该群组总用户数。
二、Python 实现:pandas 透视 + 偏移量计算
2.1 核心思路
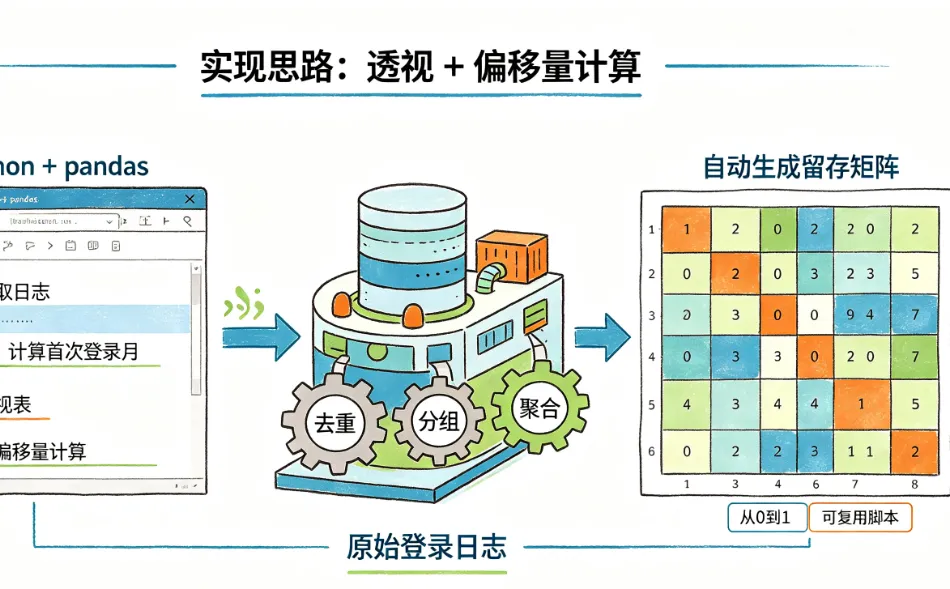
找出每个用户的首次登录日期,作为 Cohort 月份。
计算每条登录记录距离首次登录的月份差。
用
pd.pivot_table生成“群组 × 月份差”的用户计数矩阵。按行求百分比,得到留存率矩阵。
用
seaborn绘制热力图。
2.2 完整代码(含注释)
import pandas as pdimport seaborn as snsimport matplotlib.pyplot as pltfrom datetime import datetime# 1. 读取数据df = pd.read_csv('login_log.csv', parse_dates=['login_date'])df = df.sort_values('login_date')# 2. 计算首次登录月(Cohort)df['cohort_month'] = df.groupby('user_id')['login_date'].transform('min').dt.to_period('M')# 3. 计算月份差(Month Offset)def month_diff(a, b):return (a.year - b.year) * 12 + (a.month - b.month)df['login_month'] = df['login_date'].dt.to_period('M')df['month_offset'] = df.apply(lambda r: month_diff(r['login_month'].to_timestamp(), r['cohort_month'].to_timestamp()),axis=1)# 4. 透视:统计每个群组各月份去重用户数cohort_data = df.groupby(['cohort_month', 'month_offset'])['user_id']\.nunique().reset_index()cohort_counts = cohort_data.pivot(index='cohort_month', columns='month_offset', values='user_id')# 5. 计算留存率(按行除以首月总数)cohort_size = cohort_counts.iloc[:, 0]retention = cohort_counts.divide(cohort_size, axis=0)# 6. 绘制热力图plt.figure(figsize=(10, 6))sns.heatmap(retention, annot=True, fmt='.1%', cmap='Blues')plt.title('User Retention Cohort Analysis')plt.xlabel('Month Offset')plt.ylabel('Cohort Month')plt.show()
2.3 代码亮点解析
向量化操作:
transform('min')直接得到每个用户的首次登录月,无需循环。月份差计算:自定义
month_diff函数,避免日期直接相减的坑。透视表:
pivot_table一行代码完成交叉统计,比 Excel 数据透视表更灵活。留存率矩阵:
divide(cohort_size, axis=0)按行广播除法,极简优雅。
三、VBA 实现:数组字典嵌套,循环计算
3.1 核心思路
将数据读入数组,提升遍历速度。
使用双层字典:
第一层:Key 为
user_id,Value 为first_date(首次登录日期)。第二层:Key 为
cohort_month,Value 为另一个字典(Key 为month_offset,Value 为去重用户集合或计数)。循环每一行,计算首次日期与回访日期差,确定月份偏移。
输出矩阵到工作表,计算百分比。
3.2 核心代码片段(简化版)
Sub CohortRetention()Dim dictFirst As Object, dictCohort As ObjectSet dictFirst = CreateObject("Scripting.Dictionary")Set dictCohort = CreateObject("Scripting.Dictionary")Dim lastRow As Long, i As LonglastRow = Cells(Rows.Count, 1).End(xlUp).RowDim data As Variantdata = Range("A2:B" & lastRow).Value' 第一遍:找首次登录日期For i = 1 To UBound(data, 1)uid = data(i, 1)dt = data(i, 2)If Not dictFirst.exists(uid) ThendictFirst(uid) = dtElseIf dt < dictFirst(uid) ThendictFirst(uid) = dtEnd IfNext i' 第二遍:计算偏移并填充字典For i = 1 To UBound(data, 1)uid = data(i, 1)dt = data(i, 2)firstDt = dictFirst(uid)cohortKey = Year(firstDt) & "-" & Month(firstDt)monthOffset = (Year(dt) - Year(firstDt)) * 12 + Month(dt) - Month(firstDt)If Not dictCohort.exists(cohortKey) ThenSet dictCohort(cohortKey) = CreateObject("Scripting.Dictionary")End IfIf Not dictCohort(cohortKey).exists(monthOffset) ThendictCohort(cohortKey)(monthOffset) = CreateObject("Scripting.Dictionary")End If' 用字典去重用户dictCohort(cohortKey)(monthOffset)(uid) = 1Next i' 输出到工作表(略)End Sub
3.3 VBA 痛点直击
双层字典嵌套:为了按群组、月份偏移去重计数,不得不嵌套字典,代码冗长且难调试。
循环两次:第一次找首次日期,第二次算偏移,时间复杂度 O(2n)。
日期差计算:需手动拆年、月,易出错。
输出矩阵:需手动定位单元格,无法像 pandas 直接生成 DataFrame。
四、Python vs VBA 对照要点
维度 | Python (pandas) | VBA (数组+字典) |
|---|---|---|
数据读取 |
| 需循环读入数组 |
首次日期 |
| 字典遍历,手动比较 |
月份偏移 | 自定义函数,清晰直观 | 手工计算年月差 |
透视矩阵 |
| 双层字典嵌套,手动统计 |
留存率计算 |
| 需循环每行做除法 |
代码量 | 约 30 行 | 约 80+ 行 |
可维护性 | 高,语法简洁 | 低,嵌套深,易出错 |
一句话总结:Python 的切片、位移和向量化操作让 Cohort 分析变得极简;VBA 则依赖双层字典嵌套和循环,代码臃肿且难以扩展。
五、扩展干货:留存分析的 3 个进阶技巧
按周/天粒度:将
to_period('M')改为to_period('W')或直接使用日期差,即可计算周留存或次日留存。累计留存 vs 滚动留存:累计留存从首次日起算,滚动留存以最近 N 天为窗口,Python 中可用
rolling实现。自动化报告:用
pandas处理完数据后,通过openpyxl直接写入 Excel 模板,或使用Jinja2生成 HTML 报告,每月定时邮件发送。
六、课后练习(5道选择题)
在 Cohort Analysis 中,Month 0 通常指:
A. 当前月份
B. 用户首次登录月份
C. 数据截止月份
D. 注册月份的下个月
Python 中,用于按组计算首次登录日期的最佳方法是:
A.
df.groupby('user_id')['login_date'].min()B.
df.groupby('user_id')['login_date'].transform('min')C.
df['login_date'].min()D.
df.groupby('user_id').first()VBA 中,为了按用户 ID 去重并统计首次登录,通常使用:
A. 数组
B. Collection
C. Dictionary
D. ArrayList
关于 pandas 的
pivot_table,以下说法正确的是:A. 只能对数值列聚合
B. 可以指定多个 index 和 columns
C. 不能处理缺失值
D. 必须提前排序
留存率矩阵的计算本质是:
A. 每个群组各月用户数相加
B. 各月用户数除以群组总人数
C. 各月用户数减去首月用户数
D. 首月用户数除以各月用户数
答案
B
B
C
B
B