ARTICLE · 986544
AI Coding 时代真正重要的是软件工程判断力
3011字, 阅读需 16 分钟
过去三周,Andrew Ng 连续发了三篇文章。
第一篇是 8 月 15 日的 《The AI Engineering Skills Map》[1]。他和团队分析了超过 1 万个 AI 工程岗位,做了数十次结构化访谈,最后把 AI 工程能力归纳成四类:构建和部署 AI 应用、软件工程基础、使用 Coding Agent,以及参与定义到底要构建什么。
8 月 22 日,他发布 《AI Engineering Skills Map: Building and Deploying AI Applications》[2],展开第一类能力,讲 LLM 基础、如何让模型结合数据、Agentic 系统、评估与部署。
再过一周,第三篇 《AI Engineering Skills Map: Software engineering fundamentals》[3] 出来了。
把这三篇连起来读,可以看到 Andrew 其实反复强调的是同一件事:AI 工程师的能力重心正在变化,写代码只是其中一环,你还得知道应该构建什么,能把模型接进真实应用,也能判断 Agent 生成的系统是否合理、可靠、可以运行。Coding Agent 可以接管越来越多实现工作,但不会替你承担工程选择的后果。
我现在也发现,AI Coding 让代码变便宜了,但软件决策并没有一起变得简单。
也正因为这样,这个文章系列的第三篇最值得细看。大家还在追更强的模型、更长的上下文、更自动的 Agent,Andrew Ng 却专门再来讲软件工程基础。
这篇文章中,他讨论的也不是语法、API 和手写代码的熟练度,反而追问的是:Agent 替你写代码的时候,也在替你做很多工程选择。你看得见这些选择吗?
一、Andrew Ng 的五个模块,浓缩成五个问题
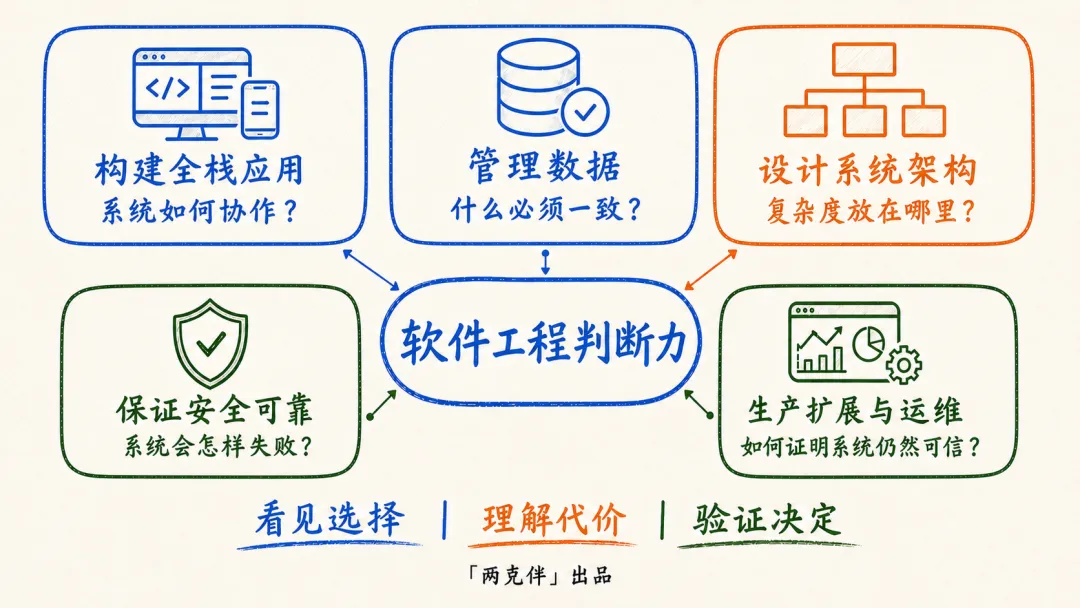
Andrew Ng 在第三篇文章里列了五个软件工程基础模块。我把它们压缩成五个问题:
• 构建全栈应用:前端、后端、状态、API、认证和异步任务应该怎样协作? • 管理数据:哪些数据必须一致,应该采用什么模型和存储方式,隐私与生命周期怎么处理? • 设计系统架构:面对当前的用户量、延迟、成本和团队规模,复杂度应该放在哪里? • 保证安全可靠:系统可能怎样失败,测试、降级和安全边界应该设在哪里? • 生产扩展与运维:发布之后怎样观察、报警、扩展和回滚,靠什么确认系统仍然可信?
这五个问题共同指向 tradeoffs ('权衡' 这个词在他这篇文章中反复出现)。工程师要能看见选择,知道每种选择会带来什么代价,也知道哪些地方不能直接接受 Agent 的默认值。
二、Agent 不会等你把需求想明白再动手
实际使用 Coding Agent 时,需求很少是完整的。
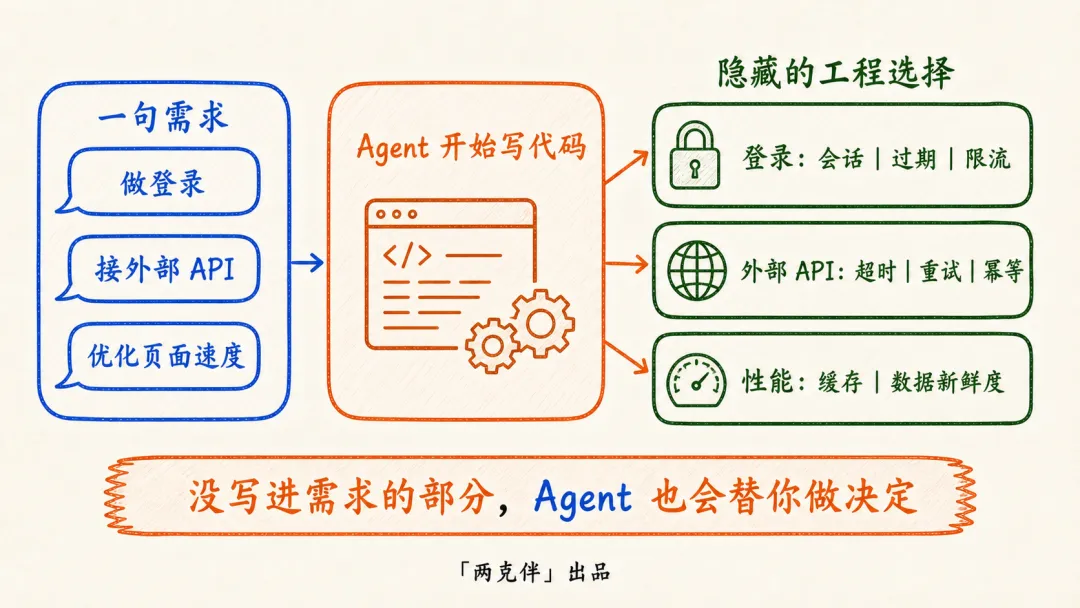
你让它做登录,它要决定会话怎么保存、Token 多久过期、连续登录失败是否限流;你让它接一个外部 API,它要选择超时时间、重试次数和错误处理;你让它优化页面速度,它可能增加缓存,也可能让用户看到没有及时更新的数据。
让 Agent 给支付接口加自动重试就是个典型例子。代码几分钟就能写完,也可能通过正常路径测试。但没有幂等控制,第一次请求其实已经成功,只是响应超时,第二次重试就可能造成重复扣款。Agent 完成了“失败后重试”,却不会替业务承担多扣一次钱的后果。
没有写进上下文的部分不会一直空着。Agent 会根据训练数据中的常见模式、框架默认值和代码库里的现有写法把它们补上。代码开始生成时,那些工程决定也已经悄悄发生了。
Andrew Ng 在文中写,新手有时甚至 “didn't know such tradeoffs even existed”——根本不知道这些权衡存在
我觉得这句话比“AI 时代基础仍然重要”更准确。会不会背语法的差距在缩小,能不能发现隐藏选择的差距反而露了出来。成熟工程师也不可能每次都提前知道答案,但他会追问:这次更在乎延迟还是一致性?失败时宁可中断服务还是返回旧结果?这个改动需要哪些测试,才能证明它没有破坏其他功能?
软件工程判断力没那么玄。看见选择,理解代价,最后给出能够被验证的决定,基本就是这三件事。
麻烦在于,Agent 的生产速度已经快到不能只靠资深工程师逐行兜底。一个人一天写几百行代码时,Code Review 还能捕捉不少问题;当几名工程师各自开着多个 Agent、不断提交完整 Diff,评审、安全和发布很快会排起队。代码快了,原来的控制方式却没有同步变快。
Anthropic 的上周刚发的 Playbook 就从这个难点写起。
三、代码不再是瓶颈,判断要放到哪里
Anthropic 在 8 月 21 日发布的文章完整名称是 《The AI-Native SDLC playbook: How to transform your software development lifecycle with AI—stage by stage》[4]。
文章第一节的标题就叫 “Code is no longer the bottleneck”(代码不再是瓶颈)。Anthropic 观察到,Agent 已经把 Build 阶段压缩到过去难以想象的速度,但 Plan、Review/Test 和 Deploy 仍按人的速度运行。安全团队仍按人工产出规模配置,评审者仍试图逐行看完代码,例外审批仍要等每周一次的会议。Agent 写得越快,队列越长。
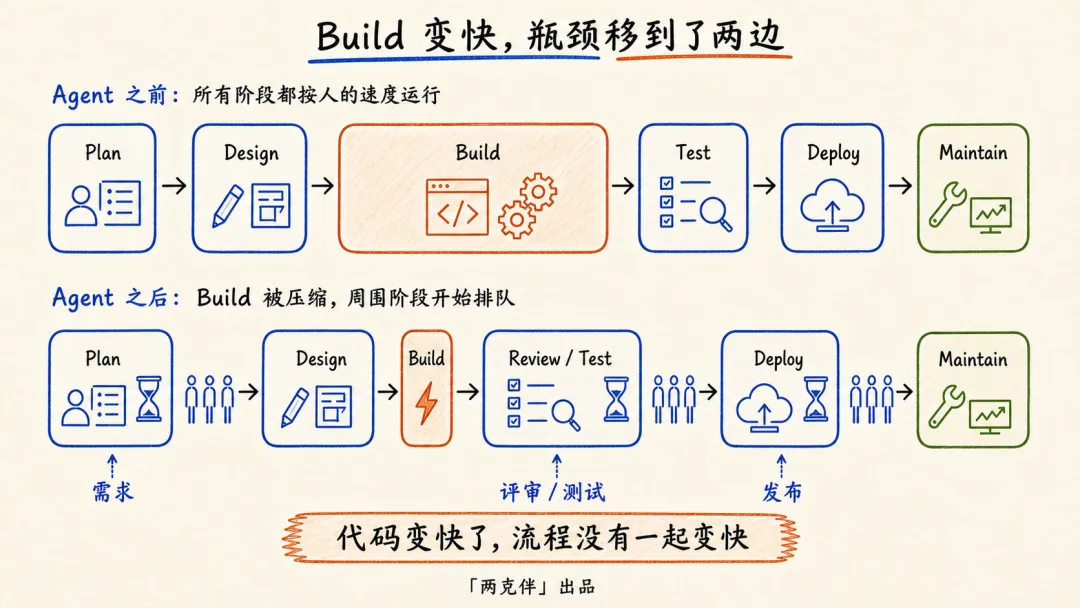
这和 Andrew Ng 讨论的是同一件事,只是视角从个人换到了团队。一个工程师需要知道哪些地方有 tradeoffs;一个团队还得决定,这些判断在流程中的哪个时点发生、由谁确认、留下什么证据。否则,判断力再强,也会被代码产量淹没。
Anthropic 沿用了 Plan、Design、Build、Test、Deploy、Maintain 六个阶段。六个名字大家都熟,变化发生在每个阶段交出的东西上。
Plan 阶段生成 intent.md,保留发起人想解决的问题、目标、影响范围、约束和未决问题。Design 把它推进到 spec.md,安全、合规、品牌和 UX 规则在设计时就参与约束。Build 先形成 plan.md,工程师可以在代码出现之前检查会改哪些文件、风险在哪里、用什么测试证明结果。
Anthropic 给出的 plan.md 示例很具体:它要写明修改哪些文件、按什么顺序实施、已知风险是什么、最后拿什么证明改动成立。过去这些内容可能只存在于工程师脑中,评审者第一次看到的已经是完整 Diff。Plan mode 把检查点往前挪了一步,改错方案只需要改文档,不必等代码写完再返工。
后面的 Test、Deploy 和 Maintain 继续读前面的产物。持续 evals 跟着实现运行,PR 评审和 Hooks 卡住不允许发生的动作,高风险变更交给人批准。生产环境出现异常后,诊断结果重新写成新的 intent.md,再进入下一轮。
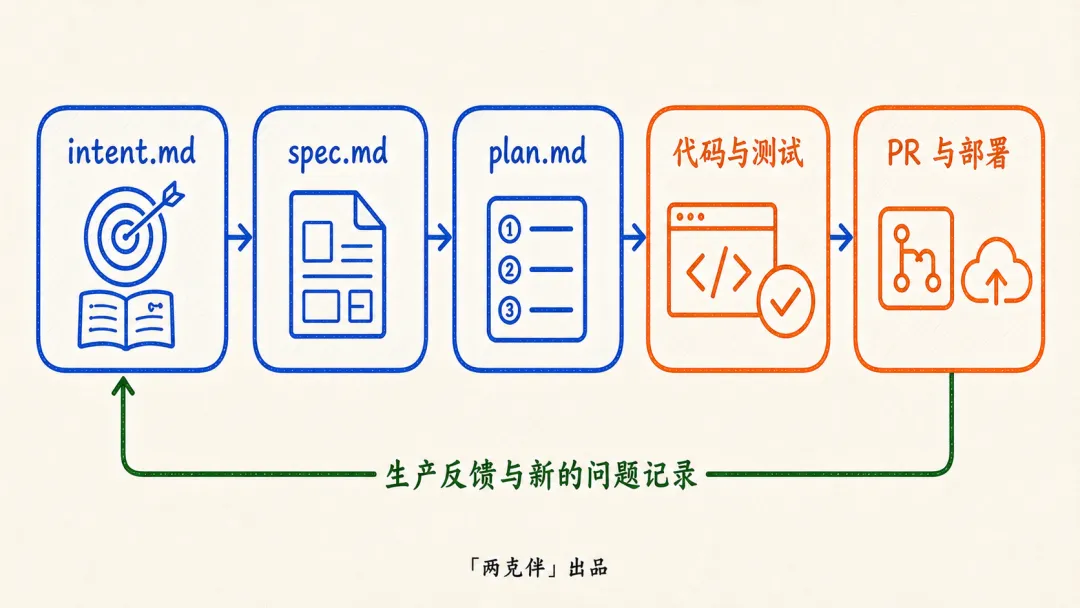
这条链路有一个很实际的作用:谁提出了需求,Agent 产出了什么,人批准了哪一步,都能回溯。Anthropic 把它称为 committed artifact chain。团队不再等代码全部写完,才第一次看到 Agent 对需求和架构的理解。
这也不代表所有公司都要抛弃 Jira、ServiceNow 或现有审批系统。Anthropic 专门提醒,每类产物应该确定一个 source of truth,其他系统保存副本或原始链接。对已经受监管的企业来说,这个边界很重要:AI-Native SDLC 可以接进现有流程,不能为了追求新形式,反而破坏已经被审计机构接受的记录。
文章里还有一个我很喜欢的小规则:当 Claude 把同一个问题犯到第二次,就把纠正写进 CLAUDE.md;同时让文件保持在一页以内,避免过期内容白白占用上下文。这个细节很像真实工程经验。它没有试图一次写出完美规范,而是把已经发生过的错误逐渐变成下一次会被读取的约束。
Anthropic 也没有把所有判断都交给 Agent。它明确写道,需要判断的决定仍由人负责。人的工作位置变了:少盯一些机械编辑,多看 intent 是否准确、spec 是否遗漏约束、plan 是否接受了错误取舍,以及验证证据够不够。
Andrew Ng 讲的五个模块,到这里就不再只是一组“工程师应该掌握的知识”。全栈、数据、架构、安全和运维经验,会进入 spec、测试、Hooks、Skills、CLAUDE.md 和审批门槛。个人脑中的经验,开始变成 Agent 也必须遵守的工作条件。
四、企业买完AI Coding工具,事情才刚开始
现在不少国内企业把采购 Trae 或 Workbuddy 企业版当成 AI Coding 的主要动作。工具当然值得买,代码产出也很可能马上增加。但如果需求、设计、测试、评审和发布仍按原来的方式运转,团队很快会看到另一种结果:等待评审的 Diff 变多,安全检查排队,出了问题却说不清 Agent 当时为什么这样改。
我最近做 AI 陪跑时更关心的,也是工具之后的这些事。团队有没有把需求边界讲清楚?哪些数据绝对不能交给 Agent 自由处理?什么修改必须经过人工批准?一次上线究竟要拿出什么证据,才能说它可以进生产?
如果这些答案只在几位老员工脑中,每个 Agent 会话都会重新猜一遍。有人给了完整上下文,结果就好一点;有人只说“帮我把这个功能做完”,Agent 便沿用默认配置。最后看上去是模型表现不稳定,实际差异可能来自团队从未把自己的工程规则写清楚。
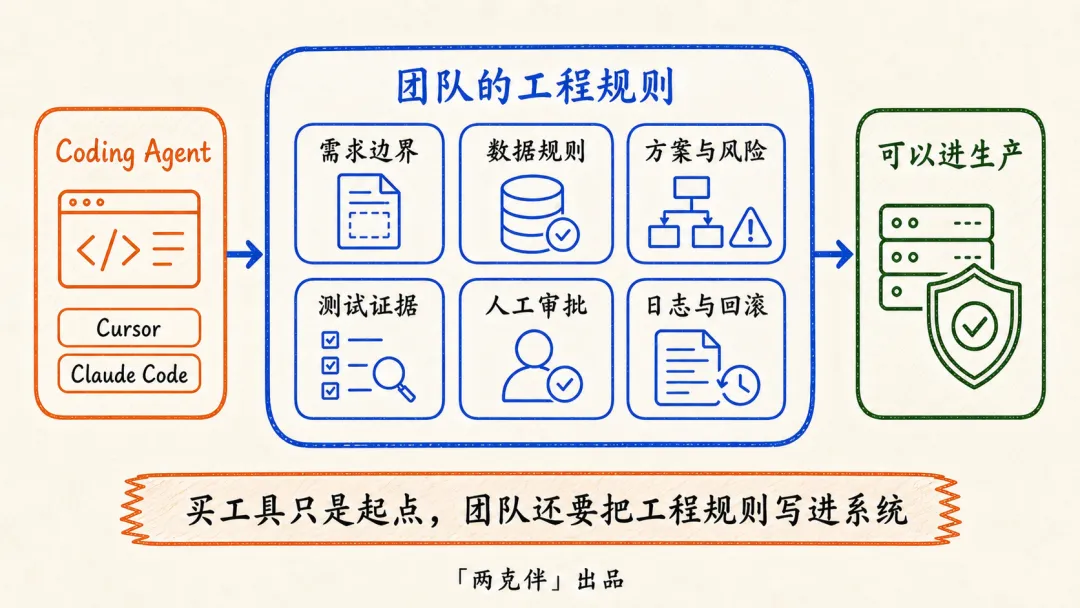
这些问题不酷,也没有“十倍工程师”那么抓眼球,却决定了企业拿到的是更快的 Demo,还是一套能长期运行的软件。
对个人来说,会用 Coding Agent 也不能只看 Prompt 写得多漂亮。让 Agent 动手之前,能不能让它说清方案、备选项、风险和验证方法;代码生成之后,能不能发现它偷偷接受了哪些默认值;生产出问题时,能不能沿着日志、测试和变更记录找到原因。这些能力以前就重要,只是过去常被写代码本身遮住了。
看完 Andrew Ng 的三篇文章,再读 Anthropic 的 Playbook,我对“软件工程基础不过时”这句话有了更具体的理解。过时的可能是背语法、手写模板代码和记住每个 API。留下来的,是对系统如何工作、如何失败、该相信什么证据的判断。
在AI编程已经非常成熟的今天,对于企业来说已经不太需要关心一个人能让 Agent 一次写出多少代码。但有另外一件事值得我们留意:当 Agent 很自信地给出一个可以运行的答案时,作为工程师的我们能不能知道哪里还不能放心。
我理解的差别就在这里。
以上是我今天分享的内容。如果你觉得有帮助,欢迎点赞、转发、收藏。
References
[1] 《The AI Engineering Skills Map》: https://x.com/AndrewYNg/status/2088302050706686198[2] 《AI Engineering Skills Map: Building and Deploying AI Applications》: https://x.com/andrewyng/status/2090840747738374568[3] 《AI Engineering Skills Map: Software engineering fundamentals》: https://x.com/AndrewYNg/status/2093388974194872781[4] 《The AI-Native SDLC playbook: How to transform your software development lifecycle with AI—stage by stage》: https://claude.com/blog/the-ai-native-sdlc-playbook