ARTICLE · 989562
上周的 8 个插件没白装:DeepSeek Harness 10 天迭代 5 次,这 3 个新能力今天就能用
上周我们跑通了 DeepSeek Harness,装了 8 个必装插件。文章发出到现在,这个项目又干了一件让人措手不及的事——8 月 17 日到 27 日,10 天发了 5 个版本(GitHub Releases 全部可查,均为 immutable tag)。
别人的开源项目是按月发版的,DeepSeek 是按天。它补齐了多模态、把 Claude Code 和 Codex"招安"成了自家子代理、让模型自己写多 Agent 编排脚本,写稿当天(8/27)又追加了 alpha 版,把子代理的模型调度权也放开了。上次教的插件还热乎,新玩法就来了。这篇把 5 次迭代里真正能上手的 3 个新能力讲透。
一、先看这一周它干了什么
dsh-v0.1.0-rc.7 | ||
dsh-v0.1.0-rc.8 | ||
dsh-v0.1.1-rc.1 | deepseek-v4-flash-vision-exp 上线;修复沙箱漏洞 | |
dsh-v0.1.1-rc.2 | ||
dsh-v0.1.2-alpha.1 |
两个容易看漏的细节:
版本号跳到了 0.1.1 再到 0.1.2。8/21 的两个 rc 其实是 v0.1.1 系列,不是 v0.1.0 的尾巴——功能性版本(视觉模型、Workflow)和修复版本分开走,说明它的发版是按里程碑推进的,不是攒一堆混着发。 每个 tag 都是 immutable 的(绑死 release 不可复用),配合"固定版本 + 记录 profile"的回退策略,版本管理是认真做的。
一个背景数字:上周文章写的时候 Star 是 4 万出头,现在到了18 万+。10 天迭代 5 次,还都是在预发布(pre-release)状态下的高速演进。
先说结论:这 5 个版本里,有三个能力值得你现在就动手用起来——看图、招安、编排。下面逐个实操。
二、新能力一:看图(多模态),两条通道任选
这是 rc.8 的重头戏,也是社区讨论最激烈的一项。先说清楚一个容易误会的点:这次补的是"通道",不是"眼睛"。具体看配置和模型。
2.1 通道一:原生看图(真视觉)
如果你的模型本身支持图片输入,图片会直接送进模型。操作上就三步:
升级到 rc.8+(安装命令见文末) 在模型配置里给视觉模型声明图片模态 用 /goal、/plan直接发图文,或输入框@引用本地图片
模型配置长这样(DeepSeek 适配器的 dsh.yml 或对应提供方配置):
- id: llm-deepseekname: '@deepseek-ai/dsh-llm-deepseek'config:apiKeyEnv: DEEPSEEK_API_KEYbaseURL: https://api.deepseek.commodels:- id: deepseek-v4-flash-vision-expname: DeepSeek V4 Flash Vision ExpinputModalities: [text, image]
关键就一行:inputModalities: [text, image]。没声明这行的模型,Harness 在发请求前就拒绝图片。
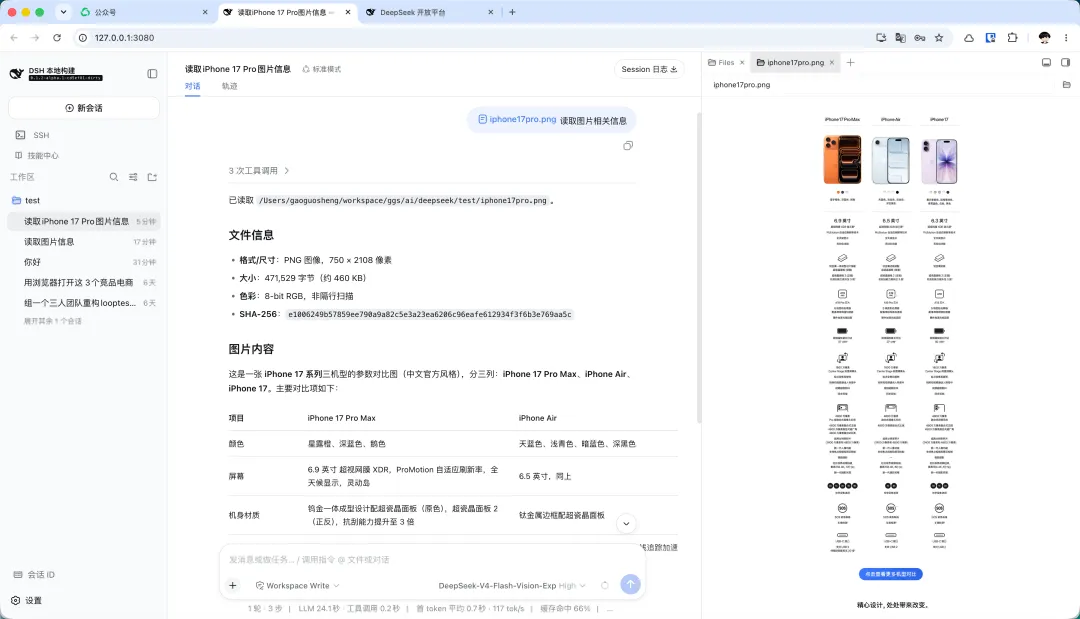
一个必须知道的限制:DeepSeek 默认公共 chat-completions 路由仍然是纯文本,不能靠本地配置硬开出视觉。目前官方可用的视觉路线是实验模型 deepseek-v4-flash-vision-exp——同 V4 Flash 价格,但没出技术报告和 benchmark,属于"先占坑"状态。
2.2 通道二:工具层"伪视觉"(纯文本模型也能看图)
这是 rc.8 最骚的设计,也是社区实测扒出来的隐藏逻辑。
当你用的是不支持图片的纯文本模型(比如默认的 V4 Flash),上传图片时 read_image 会先失败——但任务不会终止。Harness 自动降级到一条工具链:
上传图片↓ read_image 失败(模型不支持图片)↓ 自动降级,五步工具链:① OCR 文字识别 → 图中所有文字 + 坐标② 颜色统计 → 像素占比(如 白95.5% / 黑1.4% / 红0.9%)③ 像素行扫描 → 检测目标色像素位置(y=304, red=72)④ 图片元信息 → 尺寸、色彩模式、四角/中心颜色采样⑤ 拼成结构化证据 → ”白底黑字·樱桃红装饰·三段式布局”↓ 交给文本模型”脑补”
开发者实测的效果:对 PPT 截图、软件界面、流程图、报错截图这类结构清晰的图片,描述非常准;遇到真实照片、复杂空间关系就明显吃力。
为什么这个设计值得高看一眼?因为它把"视觉"从模型功能拆成了可编排的工作流环节——视觉大模型走原生通道,纯文本模型走工具层通道,两条路径并行。对 Coding Agent 来说,日常遇到最多的恰恰是截图、设计稿、报错界面这类"结构明确的图片",工具层完全够用。
2.3 实操提醒:图片是有"预算"的
图片不是无限塞的,本地附件层有两层预算:
超预算时,适配器会从最旧的图片开始用占位文字顶替,直到请求落回上限——被省略的图不会删除,但模型当前请求里看不到,需要时要重新读文件。
顺带一提,8/27 的 alpha.1 又把这块的体验补了一圈:图片发送后立即显示,压缩和上传挪到后台继续;上下文压缩时会把图片占用也计入(以前只算文字,图片会悄悄撑爆上下文);超长截图的压缩后清晰度也改善了。想要更顺滑的看图体验,直接上 alpha.1(注意它还没发 npm,源码运行方式见第五节)。
三、新能力二:把 Claude Code 和 Codex"招安"成子代理
这条一定要细看,因为它透露了 DeepSeek Harness 的真正野心:它正在从"DeepSeek 自己的 Agent 工具",变成一个 Agent 的统一调度层。
3.1 发生了什么
rc.7:Claude Code 和 Codex 的子代理任务接入任务面板(Job Panel) rc.8:两者升级为 Profile Bundle,按需安装——不再跟主体一起分发,需要时再装 Codex 特殊待遇:新增非交互权限模式,还支持同时跑多个命名实例 配套的 reportDelivery 机制:子代理干完活会主动唤醒父任务,父 Agent 不用干等
翻译成人话:你可以在一个任务里,让 DeepSeek 模型做规划和推理,派 Codex 子代理去处理特定代码库,再派一个 Claude Code 子代理干另一件事。它们不再是外部竞品,是你工作流里可以随时调度的"队友"。
8/27 的 alpha.1 又给这条线加了一块关键拼图:子代理可以指定模型了。启动子代理时能直接指定提供方、模型、推理力度(reasoning effort)和最大输出长度;更进一步,开启"子代理模型选择"后,Agent 自己能在授权范围内挑提供方、挑模型、挑推理力度——也就是说,主 Agent 可以判断"这个子任务用便宜模型就够、那个需要火力全开",自己完成成本和能力的分配。Claude Code、Codex 子代理同样支持配置模型。招安之后,连"用哪个脑子"都归你(和 Agent)管。
3.2 实操:怎么派活
DSH 内置了 4 个派活工具和 3 个后台管理工具,逐个说:
subagent | ||
subagent_fork | ||
workflow | ||
ralph |
后台管理三个:list_agents 查看运行状态、send_message 给某个子代理补充要求、interrupt_agent 中断当前任务。
@用户登录功能需求文档(简易版).md你的角色:总规划师。1. 先完整理解用户需求,做任务拆解,输出整体规划。2. 代码库阅读、代码实现、工程修改任务,不要自己写,派给【coding子代理】。3. 架构评审、风险评估、文档撰写、边界分析任务,派给【review子代理】。4. 使用@agent 指令派生子代理,把子任务完整打包下发,不要拆分细碎对话。5. 等待两个子代理返回结果,再做汇总、校验、冲突处理,输出最终结论。@agent(name=coding_agent, model=deepseek-v4-pro)任务:阅读本地代码库,完成XX模块编码实现,输出可落地代码。@agent(name=review_agent, model=qwen3.7-max)任务:对方案做架构评审,识别风险点,输出测试用例清单。
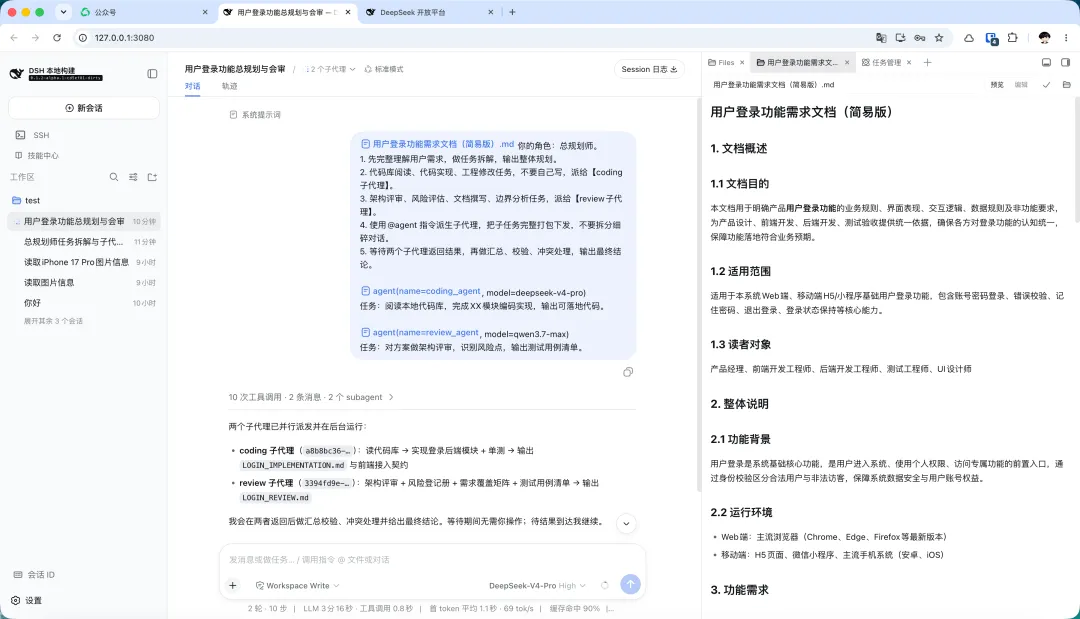
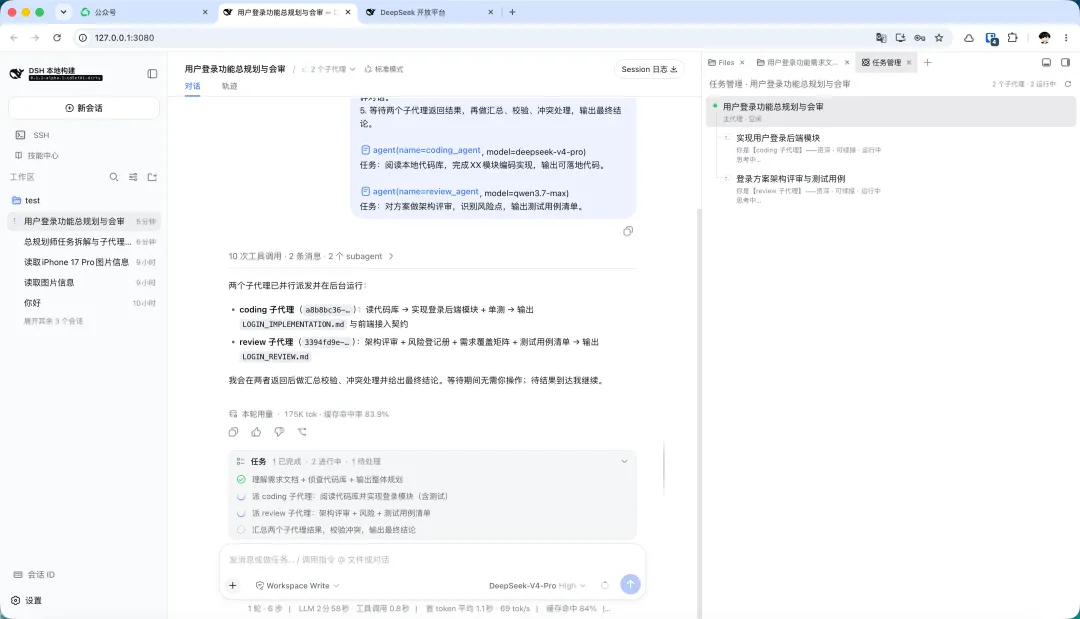
一个实战组合拳(实测过的场景):
用 subagent_fork 基于刚才的审查报告写总结(子代理自动继承了父会话的审查结果,不用重新贴一遍)→ list_agents 看到它在跑→ send_message 补一句:”重点检查触控区域和减弱动效的实现”→ interrupt_agent 停掉当前轮次,Agent 状态从 running 变 idle
注意:interrupt_agent 只中断当前这一轮,不销毁子代理,随时可以再唤醒。
3.3 一个反直觉的用法:ralph
ralph 的设计思路值得单独说——换人,比纠正人管用。
它每一轮都用全新的子代理推进同一个目标,每轮之间只传一份结构化交接报告,不继承对话历史。实测跑 3 轮检查一个提交:第二轮的子代理直接修正了第一轮的优先级判断,合并了重复内容,还补上了第一轮漏掉的问题——干完它自己判定目标已达成,第三轮都省了。
防"越干越钻牛角尖",这个工具就是答案。
四、新能力三:Workflow,让模型自己写多 Agent 编排脚本
这是 8 月 21 日 v0.1.1-rc.2 正式进入 Standard 预设的能力,也是我认为最值得把玩的一个。
4.1 它是干嘛的
以前你想并行派 4 个 Agent 干 4 件事,得自己反复发指令、等结果、再发下一轮。Workflow 的做法是:你给一个任务,模型先写一段 JavaScript 编排脚本,脚本负责派活和汇总,一次执行完。
脚本能调用的编排原语:
// 启动一个子 Agent,可按 JSON Schema 要求返回结构化结果const r1 = await agent(”审查模块边界”, { schema: auditSchema });// 并行放出一组任务,在同一屏障处等待全部返回const results = await parallel([taskA, taskB, taskC]);// 流水线:第一阶段输出喂给第二阶段const out = await pipeline([stage1, stage2]);// 标记阶段 + 上报进度phase(”审查中”);log(”3/4 完成”);
几个必须知道的边界:
脚本本身不能碰文件、网络、定时器或 Node API——它只负责排班,真正读文件查资料的是子 Agent 并发数和 Agent 总数受配置上限控制 脚本执行在独立 Node worker 线程里,返回 JSON 可序列化数据 脚本参数非法、Schema 不支持、超 Agent 上限,会直接中断 Workflow,不会变成普通子代理失败——这点对"区分干净审计和部分执行"很重要
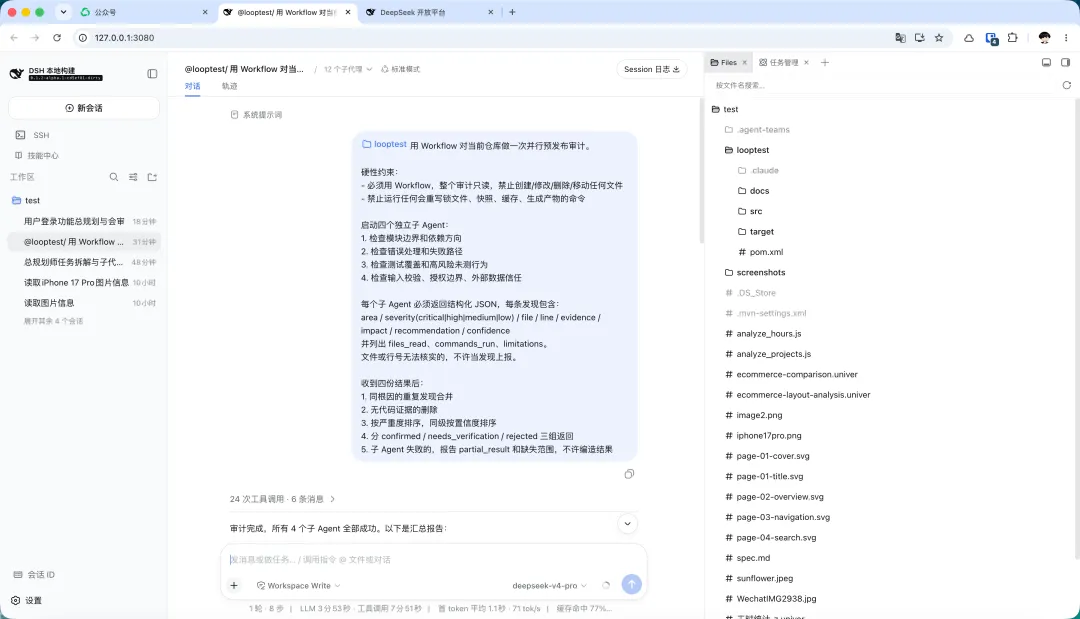
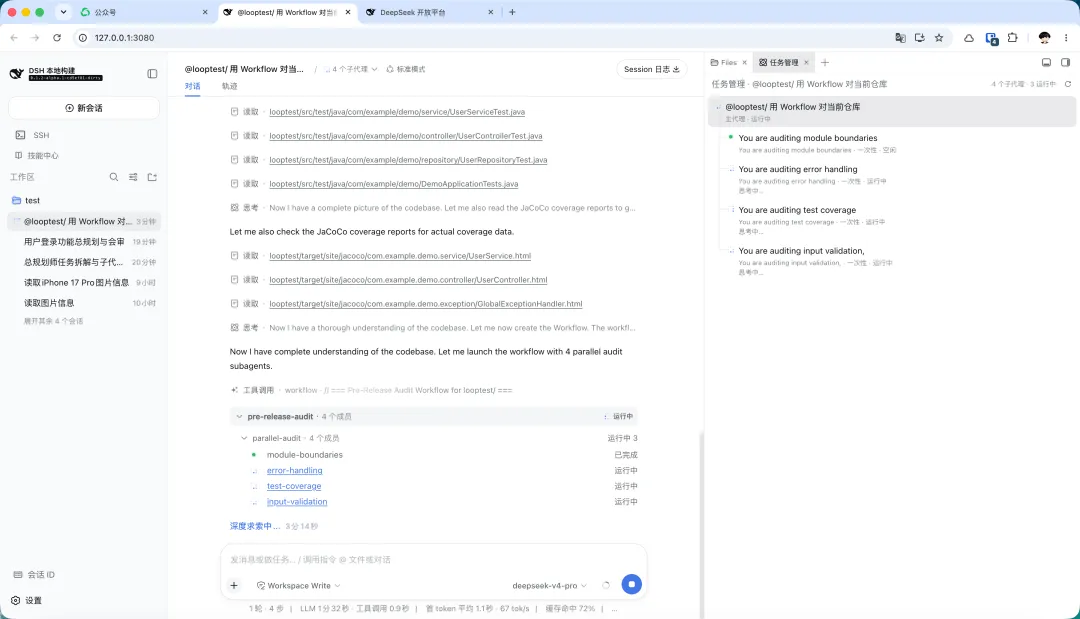
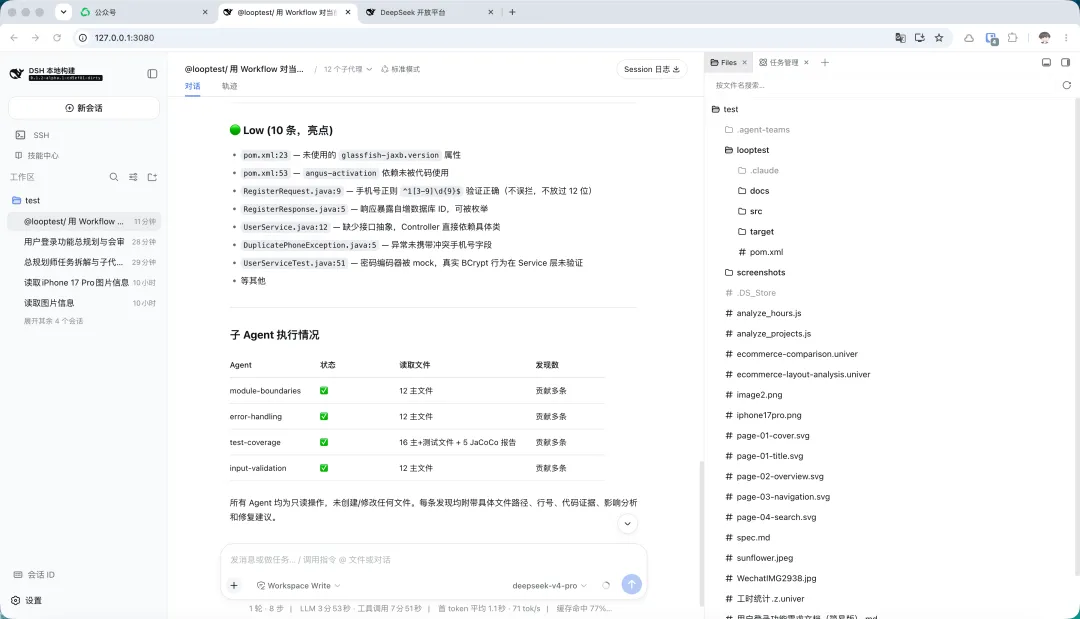
4.2 实操模板:四路并行 Code Review
官方社区给了一个四路并行只读审计的模板,我精简后贴出来,直接能用(先在小仓库上试,再调文件路径和命令):
用 Workflow 对当前仓库做一次并行预发布审计。硬性约束:- 必须用 Workflow,整个审计只读,禁止创建/修改/删除/移动任何文件- 禁止运行任何会重写锁文件、快照、缓存、生成产物的命令启动四个独立子 Agent:1. 检查模块边界和依赖方向2. 检查错误处理和失败路径3. 检查测试覆盖和高风险未测行为4. 检查输入校验、授权边界、外部数据信任每个子 Agent 必须返回结构化 JSON,每条发现包含:area / severity(critical|high|medium|low) / file / line / evidence / impact / recommendation / confidence并列出 files_read、commands_run、limitations。文件或行号无法核实的,不许当发现上报。收到四份结果后:1. 同根因的重复发现合并2. 无代码证据的删除3. 按严重度排序,同级按置信度排序4. 分 confirmed / needs_verification / rejected 三组返回5. 子 Agent 失败的,报告 partial_result 和缺失范围,不许编造结果
这个模板的关键设计是用 JSON Schema 钉死返回结构,四路并行产出统一格式的证据,主 Agent 去重、排序、分档——这套结构可以平移到任何"并行审计"场景:依赖安全检查、性能回归、配置核查……
4.3 100 文件审计的进阶版
官方示例里还有个更狠的玩法:审查 100 个源文件,每个高风险结论再由另一个 Agent 复核——
100 个文件├─ 为每个文件启动审计 Agent├─ 统一返回 { 文件, 风险, 证据, 严重度 }├─ 只把高风险项送给验证 Agent 复核└─ 主 Agent 去重汇总报告
人工干这事要协调几十次,模型自己写编排脚本,一次成。这就是"把 agent 调度从手动挡换成自动挡"。
五、升级前,五个坑必须先知道
新能力虽好,但这波版本是"开着飞机换引擎"式的迭代,动手前把雷区排了:
1. 先搞清楚 npm 上到底有什么。写稿时查了 dist-tags:latest 和 next都指向 0.1.1-rc.2(8/21 发布),也就是说现在直接装默认就能拿到多模态、子代理和 Workflow 这三大能力:
npm i -g @deepseek-ai/dsh# 或 @next,等效
但注意:8/27 的 v0.1.2-alpha.1 还没发 npm(registry 上最新就是 rc.2)。想尝鲜 alpha.1 的子代理模型调度,目前只能从源码跑:
git clone https://github.com/deepseek-ai/deepseek-harness.gitcd deepseek-harness && pnpm install && pnpm run buildpnpm dsh web
另外官方 README 给的零安装方式是 npx @deepseek-ai/dsh web,本地起 Web UI(默认 http://127.0.0.1:3080),SSH 远程只打印宿主机 URL,加 --no-open 可不弹浏览器。首次上手推荐这条路。
2. SQLite 存储格式不兼容,升级前备份。rc.8 重构了 SQLite 后端,读写和分叉性能变好、体积变小,但老数据结构的库读不了。生产环境务必先备份。
3. 视觉能力不随版本升级自动获得。默认模型目录还是纯文本的 V4 Flash / V4 Pro,想看图要自己配置视觉模型或依赖工具层降级,别以为升个级就自动"长眼睛"。
4. 这是开发者预览,会有 breaking changes。官方明确提示存在兼容性破坏变更,插件、配置、数据格式都可能变。当前正确的姿势是:固定版本 + 记录当前 profile 配置,方便随时回退。alpha.1 里已经有实际案例:Code Mode 正式更名 PTC mode(旧会话还能读),APIProxy 接口迁移后直接移除,要统一用 @Remote 网关——依赖旧接口的脚本升级即挂。
5. 安全预期要摆正。alpha.1 同步更新了官方安全说明:DeepSeek Harness尚未接受安全审计,沙箱、审批与权限控制不能保证隔离。本地把玩随便,放生产环境跑敏感代码库之前,先想清楚这条。顺带一提,alpha.1 默认开启了公网 WebFetch(内置 SSRF 防护,不再逐次审批),方便是方便了,边界也比以前更宽了。
六、一句话总结
DeepSeek Harness 的首周连更(截至写稿已经 10 天 5 版),证明了一件事:Agent 框架的竞争,正在从"谁的模型更强"转向"谁能把更多模型、工具和 Agent 编排进同一个工作环境"。
视觉可以靠工具链模拟 → 底座模型的边界被模糊 Claude Code、Codex 可以被"招安"成子代理,连模型都能逐个指定 → 竞品变成零件,成本自己分配 模型自己写编排脚本 → 调度从手动挡变自动挡
上周那 8 个插件,是让你适应"一切皆插件"的世界观;这周这 3 个新能力,是这个世界观的第一个完整演示。如果你还没升级,现在npm i -g @deepseek-ai/dsh就能拉到带 Workflow 的 rc.2,或者直接npx @deepseek-ai/dsh web零安装起一个 Web UI——先试"看图",再试 Workflow,这两个是今天收益最大的。