ARTICLE · 990267
你手机里的元宝AI刚换了脑子,AI正在变成像水电一样
这周我打开日常在用的 WorkBuddy 交周报,明显感觉它处理长表格稳了——以前丢一份带合并单元格的明细进去,合计经常对不上,这周居然一遍过。一查才知道,后台刚换上了腾讯新开源的混元 Hy4 preview。
这件跟我日常有关的小事,其实是一个更大变化的切片。过去这一周,中国大模型发生了一连串事,单独看都不稀奇,合在一起却指向一个我做了十年数据分析才敢下的判断:AI,正在从这周的某个节点开始,变成像水电一样的东西——按 token 计费、人人接得上、不再是谁的稀缺壁垒。
下面顺着几组数字,说它们背后到底发生了什么。
那张占比超过60%的图,背后是出钱的人
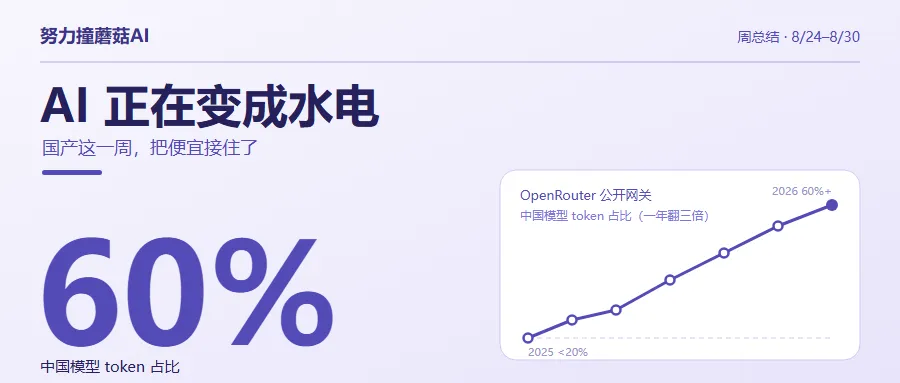
8月26号,一个不太起眼但很硬的数据被披露:在开发者最常用的模型网关 OpenRouter 上,中国模型的 token 消耗量占比,一年来翻了三倍多。
| 超过60% | 40%以下 |
数据来源:《观察者网:OpenRouter 数据显示中国模型 token 消耗量占比超 60%》
我第一眼看到"超过60%"就怀疑:这数谁家说的?但接着看下去,怀疑反而放下了——
“OpenRouter 不是厂商自己的后台,它是海外开发者接模型的公共网关,上面绝大多数调用者是用真金白银的 API 在投票。一个中国匿名模型(后来被确认是智谱的 GLM-5.3-Flash)能在上面登顶,靠的不是国内刷量,是海外用户真在调、真在付钱。
这一点比"国产第一"四个字重要得多。它意味着衡量标准从"厂商发布会上的跑分"换成了"开发者愿意为哪个模型掏钱"。跑分可以自嗨,掏钱不会。 所以当我说"这一周有变化",底气不是来自哪家的通稿,是来自出钱的人用脚投的那一票。
便宜,是被工程砸出来的
为什么是这一周拐过来?因为便宜又好用的牌,集中亮出来了。先把三家的底牌摊开看:
| 3200亿 | 180亿 | 100万 | |||
| 1250亿 | 60亿 | 26万(可扩100万) | |||
| 7700亿 | 490亿 | 约100万 |
把这张表读成一笔账,关键不是"便宜",是"同样的活,到底花多少钱"。我画了张对比:
同样一笔预算(比如 100 元) │ ┌─────────────┴─────────────┐ ▼ ▼ 调 Claude Opus 4.8 调 智谱 GLM-5.3 约 2-3 次(¥36/百万输入) 约 130-180 次(¥0.54/百万输入) │ │ └──────────┬────────────────┘ ▼ 同样的活,GLM 花的钱 ≈ Opus 的 1/40~1/100 (智谱自称 1/40;按公开绝对价,实际更低)1/40 到 1/100——这不是"便宜没好货"的便宜,是工程效率的真实跨越:靠的是模型结构瘦身(激活参数远小于总参数,比如 Qwen 总参 1250亿、每 token 只激活 60亿,激活比不到 5%)加国产算力把推理成本压下来。智谱自己也说,这个价是从架构里省出来的,不是降价降出来的。
我自己的体感最直观:混元这版给我最大的使用变化是 约100万 token 的上下文。以前喂一份完整季报 PDF 得先拆页,怕它中途忘;现在整本丢进去让它按章节提数,漏摘的情况明显少了。下面这个前后对比,是我这周真实 workflows 的变化:
便宜加上够用,才让我真敢把 token 接进日常。
底座那一步,才算把便宜接住了
但光说"模型便宜大碗"会漏掉最关键的一环。做数据的都懂:模型强、价格低,如果底层还卡在别人的芯片上,那不算真赢——别人一掐供应链,便宜就没了。
这一周补上了底座。智谱公开说,GLM-5.3-Flash 整套线上服务,完全跑在十万张国产算力卡上,而且是国产算力第一次大规模承接全球真实业务流量,不是实验室 demo,是海外用户真在调。
这点把前面两件事接成了一条因果链:
能造(国产卡扛住全球真实流量) │ ▼才便宜(推理成本被自己压下来) │ ▼才敢用(厂商默认开着 token 服务,我也敢接进日常流程)模型够用、成本能扛、底座不慌——三件事单看都不稀奇,恰好在这一周同框,才是拐点。也正因为底座自己攥住了,这份性价比才不会被别人反手拿走。
站在更长的时间看,AI正在变成水电
如果只盯着这一周,容易把它读成"国产逆袭"的热血故事。但我更愿意把它放进更长的技术史里看。每一次通用技术革命,都走过差不多的路:
当AI从一种稀缺资源,变成像水电一样打开就能用的东西,它的角色就彻底变了——不再是少数公司的壁垒,而是所有人脚下的地板。
这对普通人意味着什么?我列三件最具体的:
你每天用的 App,后台大脑可能已经在悄悄换成国产模型,因为便宜,厂商更愿意默认开着 token 服务; 你公司上一套智能客服的预算门槛被砸低,中小公司也用得起了; 极端情况下这条链路不会一夜断供——因为底座自己攥着。
但这些都还是"AI变水电"的表象。更深的落点在人身上。
AI变水电的那一周,我反而更清楚自己该守什么
说回我自己。这一周我把日常取数、格式化、写初稿这类标准化的活,切到了国产开源模型,API 成本的变化是这样的:
切国产开源前 [████████████████████████] 100%(取数+初稿环节,相对基准)切国产开源后 [███░░░░░░░░░░░░░░░░░░░░░░░] ~30% → 约 -70%但过程里也翻过车。一份带合并单元格的销售明细,它把"华东"和"华中"并到一起,合计对不上。我把排查过程画出来,其实就是一条链路:
交周报:销售明细合计对不上 │ ▼让它把每一步中间结果打出来 │ ▼冒出一个从没听过的「华」大区(华东 + 华中 被合并单元格粘成一格) │ ▼拉原始表核对 → 按合并区首行填充,修正规则 │ ▼重跑 → 合计对齐 ✓让它算各区域同比,它又把去年没数据的月份当 0 算,给了个虚高的增长率。同样走一遍核对链路才抓到:
让它算各区域同比 │ ▼把「去年无数据」的月份当 0 → 增长率虚高 │ ▼拉原始表对 → 抓到幻觉(模型编了数字) │ ▼铁律:凡对外、对老板的口径,我一定自己核一遍原始数模型给的是草稿,不是结论。省下来的七成不是白捡的——标准化活它接得住,判断活我得盯着,等于把省下的钱换成了我自己的审核时间。算总账还是划算,因为我更敢把 token 接进日常了。
这周当然有边界:最顶尖的训练芯片供给还是紧的,架构是不是真领先存疑,8月27号外媒说英伟达拟以约129亿美元收购开源社区 Hugging Face(交易还没正式签署,而 HF 是 Qwen、DeepSeek、GLM 共同的发布主场,入口一旦被锁,开源的"自由"要打问号),厂商自测的盲测数字也还得等独立复测。赢了这一周,不等于故事终局。
AI变成水电的那一周,我反而比任何时候都清楚自己该守住什么:
当AI便宜到像水一样,人的稀缺性,反而更清楚地落在"人"自己身上。
是专注 AI Agent深度实践的努力撞蘑菇AI,致力于分享真实可用的 AI 使用经验与工作流探索,欢迎你和我一起把 AI 玩明白,如果内容对你有帮助,欢迎关注、点赞、转发。