ARTICLE · 990265
律师自建 AI 技能的真实卡点:欠工程化与过度工程化之间,到底怎么走
律师自建 AI 技能的真实卡点 · 欠工程化与过度工程化之间
—— 一份关于“做不做、做多少、怎么平衡”的复盘与方案
署名:恒和信王律师 —— 反复在两个极端之间试错之后,一份关于技能工程化边界的复盘与方案
过去一段时间,我和身边几位同行都在尝试给律师工作装 AI 技能——合同审查、起诉状起草、尽调底稿。这个过程不是“做出来→失败→换思路”那么简单,而是一次次的反复试错。
最早做出来的版本最朴素:一段提示词告诉 AI“你是合同审查律师,重点看付款、违约、保密……”。这种“提示词版”装起来最快,但用几次就会发现,AI 的输出跟直接问它没本质区别——它只是在按通用清单做模板填空。
然后我们往工程化的方向走了一步:把风险清单做成表格、把合同类型做成分类表、把法条条款整理进本地索引。这次输出质量确实提升了,但接下来又出现了新问题——维护跟不上。法条变了、案例更新了、合同类型新增了,每一项变动都要回去改技能、改文档、测一遍。一个律师自己做这事,根本忙不过来。
接着我们又退回来——把表格换成外部数据库调用、风险清单走 API 而不是装在本地。这次轻了,但发现 AI 失去了一部分判断能力,因为外部检索返回的是通用知识,不带场景感。
这不是“失败→成功”的简单故事,而是反复在两端之间试错——每一种方案都有它的强项和软肋,没有哪个版本能直接说“这就是对的”。真正能做的,是把这些试错过程中观察到的现象提炼出来,看清楚每种设计选择的代价,再找到一个对大多数律师都成立的中间状态。
下文就是这个提炼的过程。
01
PART
现象:方案分布是连续的,但讨论常被简化成两端
OBSERVATION
先把观察到的情况摊开。
我看到的律师圈 AI 技能方案,按工程化深度从浅到深大致分布如下:
最浅一层:纯提示词版。一个 SKILL.md 写一段说明,告诉 AI“你是合同审查律师”“你重点关注 X、Y、Z”,让 AI 自由发挥。它的强项是装得快、上手简单、不需要工程基础;软肋是质量全押在 AI 模型本身,输出时好时坏。
中间层:流程脚本 + 表格配置。一个 SKILL.md 写流程骨架,配合 scripts/ 目录里的文档解析、要素提取脚本,data/ 目录里放配置性的 CSV/Markdown 表格(合同类型、风险模板、检查清单)。脚本读取表格做匹配和路由,但表格本身不进入 AI 上下文——它是被程序内部使用的“数据”,不是被 AI 读的“知识”。这种方案的强项是工程结构清晰、维护相对可控;软肋是表格驱动的匹配机制有天然上限(不典型条款匹配不上),而且表格的更新维护仍然是负担。
再深一层:本地知识库 + 脚本检索。把法条、案例、本地数据做成索引文件,配一个 search.py 之类的检索脚本,AI 通过调用脚本拿到按需检索的结果。这种方案的强项是知识体量大(几万条法条)但 AI 上下文不爆炸,因为检索是程序做的、不是 AI 读的;软肋是检索接口的设计有讲究——检索词太宽召回噪声,检索词太窄召回空集,AI 在这个环节的体验取决于接口设计质量。
最深一层:重型打包版。把所有可能用到的知识、检查点、流程门禁全塞进技能目录,期待“自包含”。这种方案的强项是开发者省事(不用设计外部接口);软肋是上下文负担大、维护成本高、长期使用容易过时。
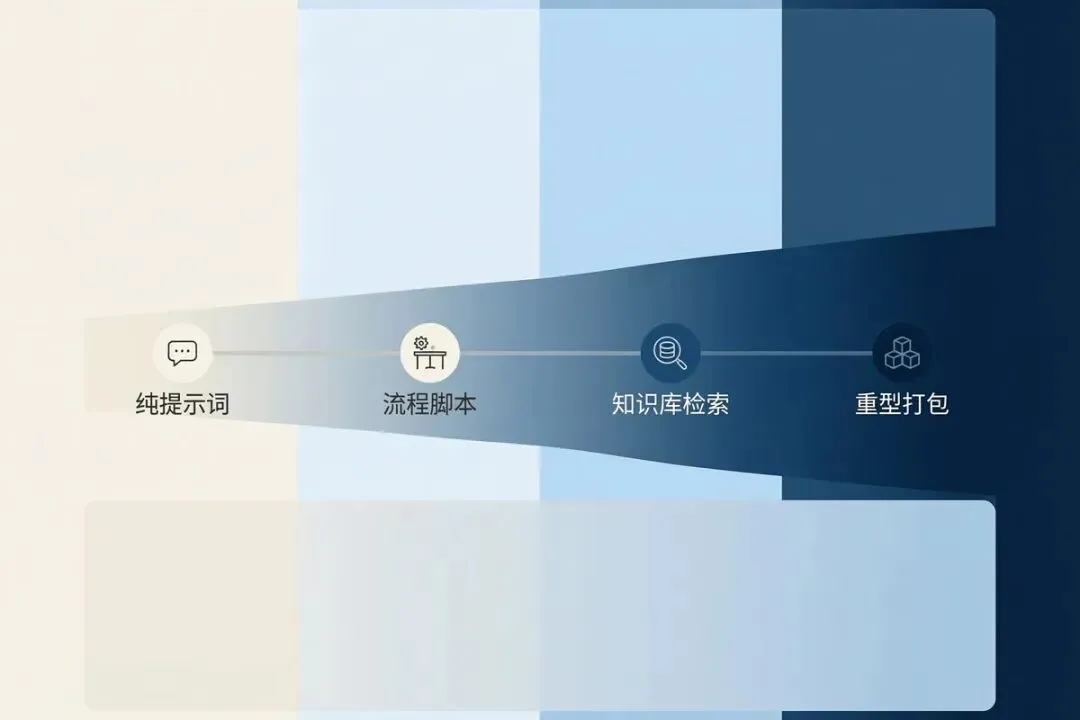
这四层在现实里都有项目存在(虽然命名各异)。但讨论时大家往往把它简化成“提示词 vs 重型版”两端——这简化掩盖了中间的工程化空间。
很多看似“过度工程化”的设计,恰恰是因为没做好“中间层”的接口设计而被迫堆出来;很多看似“欠工程化”的方案,恰恰是因为没意识到流程骨架需要单独固化。 把四种方案放在一起,中间那一段才是大多数技能的归宿。
下文讨论的“欠工程化 vs 过度工程化”,指的是这两个极端,而不是整个光谱。但读者要知道:中间层是真实存在的,是大多数律师自建技能时该去到的位置。
02
PART
厘清:AI 技能到底是什么,它有什么工程属性
CLARIFY
要把两端的代价看清楚,必须先厘清“AI 技能”到底是什么。它的工程属性决定了什么该做、什么不该做。
它有三条根本属性,每一条都是工程上的硬约束。
第一,技能是流程的执行单元,不是知识的容器。官方文档的定义很直白:当你反复把同样的检查清单、多步骤程序粘贴进对话时,就该把它做成技能。注意用词——程序、流程、方法。技能要沉淀的是“做事的方式”,不是“做事的材料”。
这条属性的实务含义:把一条法规装进技能目录是错的(那是知识),把“这条法规在你审到 X 条款时去查”写进技能流程是对的(那是方法)。前者是搬运,后者是方法。判断一个技能设计是否合理的第一个标尺,就是看它里面沉淀的是方法还是知识。
第二,技能的内容会持续占用上下文。一旦被加载,技能的指令、规范、参考文件会留在整个会话里——不只是触发那一刻,而是每次对话都占着位置。这意味着技能里的每一个字,都在和对话历史、其他技能、用户的具体问题抢占空间。
这条属性是上下文控制的根据。一个中等复杂度的合同审查技能,SKILL.md 加 references 加脚本说明,加起来约 30KB——已经占一次任务上下文的 15%。所以技能里的内容必须精简。判断标准是看每行字对当前任务是否必要——冗余的描述、过度的限定、无用的注释都应该删除。
但要注意:技能本身的内容占用上下文,与“技能通过脚本/接口访问的知识”是两回事。后者可以很大(几万条法条),因为它不进入 AI 上下文——AI 只看脚本/接口的输入输出契约,看不到背后数据。这是为什么“中间层”的设计可行。
第三,技能是渐进加载的。三层结构:最外层只有名字和一句话描述(始终占着上下文);触发后才加载正文;正文里提到的参考文件、脚本、模板,按需再读。官方对正文的建议是控制在500 行以内。
这条建议不是审美,是工程约束。AI 的会话是会被压缩的——压缩后每个技能只保留最近调用的前几千 token,太长会被截断,关键指令直接消失。我做过一个实验:一个 800 行的合同审查技能,跑了 30 轮对话后,AI 实际上能调用的指令只有开头那 100 行——后面 700 行几乎没被引用过。
该工程化的是方法,不是知识。 但要注意精确表述——这条判断不是说“知识不该进技能”,而是说“知识不该作为 AI 直接阅读的内容进技能”。知识可以通过脚本、通过接口、通过外部数据库访问,只要 AI 不直接读它就行。
这是后文所有方案的立论基础。
03
PART
从属性看设计代价——四种方案各自的取舍
TRADEOFFS
回到引子里那个观察——不同方案各有强项和软肋。现在可以从技能的工程属性出发,分析每种方案的代价。
纯提示词版:轻但不稳
它的 SKILL.md 可能只有 30-50 行——只占上下文 1%。这是它的强项:极轻、不占资源、装上就能用。
代价是:它只给了 AI 一个“角色”和一份“通用清单”,没有给出审查的工程逻辑。AI 凭训练记忆和运气输出,质量时好时坏。没有立场门禁——AI 默认输出对谁都不痛不痒;没有类型化的检查点——审查股权转让和审查服务合同用的是同一份清单;没有边界——AI 可能编造法条、越权修改、给“应当修改”的判断却没有依据。
律师用几次就会发现“和直接问 AI 没区别”。但这种方案的失败不是“做得太少”,是“做得不对”——它没把流程固化下来,只给了 AI 一个起点。
流程脚本 + 表格配置:克制但有上限
SKILL.md 写流程骨架(解析、确认立场、检索、激活检查点、生成意见、门禁),scripts/ 里有文档解析、要素提取、报告组装脚本,data/ 里放配置性 CSV(合同类型表、风险模板、检查清单)。
关键点:CSV 不入上下文。我具体核实过几份代码,CSV 是被脚本读成 pandas DataFrame 在程序内部使用的——比如从 contract_types.csv 读出“支持的合同类型列表”返回字符串数组,AI 看到的是列表,不是表格原文。表格的体量再大,也不直接挤占 AI 推理空间。
这种方案的强项:工程结构清晰(方法在 SKILL.md,数据在 data/,动作在 scripts/,三者分工),维护相对可控(表格更新不需要重新训练 AI)。
代价:表格驱动的匹配机制有天然上限。风险识别靠关键词匹配、模板命中——条款稍微不典型,就匹配不上。比如一份简短的 NDA 可能根本不含风险表里的关键词,AI 反而判定“无重大风险”,但 NDA 真正的风险点(保密范围宽窄、期限长短、例外条款)一个都没查。这种“不命中就跳过”是表格方案的本质局限。
再有一个代价:表格本身需要维护。CSV 加一行、删一条、修订条款,都需要回去改文件、测一遍。对个人律师来说,这是持续负担。
本地知识库 + 脚本检索:体量大但接口设计决定成败
把几万条法条做成 provision-index.json(一个 39MB 的 JSON 文件),配一个 search.py 脚本提供命令行检索。AI 不直接读这 39MB——它通过 shell 调用脚本,传入检索词,脚本返回按 tier 排序的前 N 条结果。
我具体看了一段检索脚本的实现:检索时按“关键词 AND 匹配”在法条全文里搜,按 tier(核心/近期/稳定/不确定)和状态(有效/已修改/未生效)排序,最后返回前 15 条左右。每个检索词返回的结果只有几百字节到几 KB,不是 39MB。
这种方案的强项:知识体量大但 AI 上下文干净;按需检索、即时返回、不依赖外部服务(断网也能用)。
代价:接口设计决定体验。检索词太宽召回太多无关法条,AI 又要在噪声里筛选,反而费 context;检索词太窄召回空集,AI 拿不到想要的依据。检索词的层次设计(主词 + 法律层 + 司法解释层 + 类案层 + 排除词)就成了关键工程点。
还有一个代价:法条有时效问题。核心法律每次都要验证状态,新法律要入库,旧法律要标注已修改或已废止。索引文件本身可能过时。这是设计“中间层”绕不开的长期工程。
重型打包版:理论上自包含,实操中代价高
把流程、表格、检索脚本、知识库全部打包进技能目录,期待“装上就能用、不依赖外部”。
它的代价前面分析过——上下文负担、维护成本、压缩截断风险——都是真实的。但也要承认:在某些场景下(如离线环境、内部合规要求不能连外网),这种“自包含”恰恰是设计目标,不是错误。
所以讨论的关键不是“重型版是不是错的”,而是“在大多数律师场景下,是不是必要”。答案是:大多数时候不必要。一个连 pku-law MCP 都连得上的律师,没必要把法条全文装进技能——按需检索更轻、更准、更易维护。
取舍的轴
把四种方案放在一起看,取舍其实是沿着几条轴变化的:
轴一:知识放哪里?在 SKILL.md 里(错误)、在 data/ 表格里(程序读)、在外部接口里(脚本调用)、在 AI 上下文里(最差)。 轴二:流程固化多少?一段提示词(最差)、流程骨架(基本)、流程骨架 + 门禁(推荐)、流程骨架 + 门禁 + 反馈循环(高级)。 轴三:检索谁做?AI 自己查(最差)、脚本检索(推荐)、专业 API(更佳)。
每条轴往哪边偏,决定了方案的强项和软肋。
04
PART
平衡方案:四层架构——从律师工作流的约束推出来
ARCHITECTURE
方案的每一条都不是凭空设计的,而是从律师工作流的实际约束推导出来的。律师工作的核心约束有三条:
高频重复
合同审查、起诉状起草、尽调底稿,每天都在做同样的事
必须可复核
每条意见都要能追溯依据,否则律师要担责
有立场
每个任务都明确站哪边,影响审查重点
这三个约束联合起来,决定了技能的设计边界。下面是一个完整的四层架构,配图里看会更清晰。
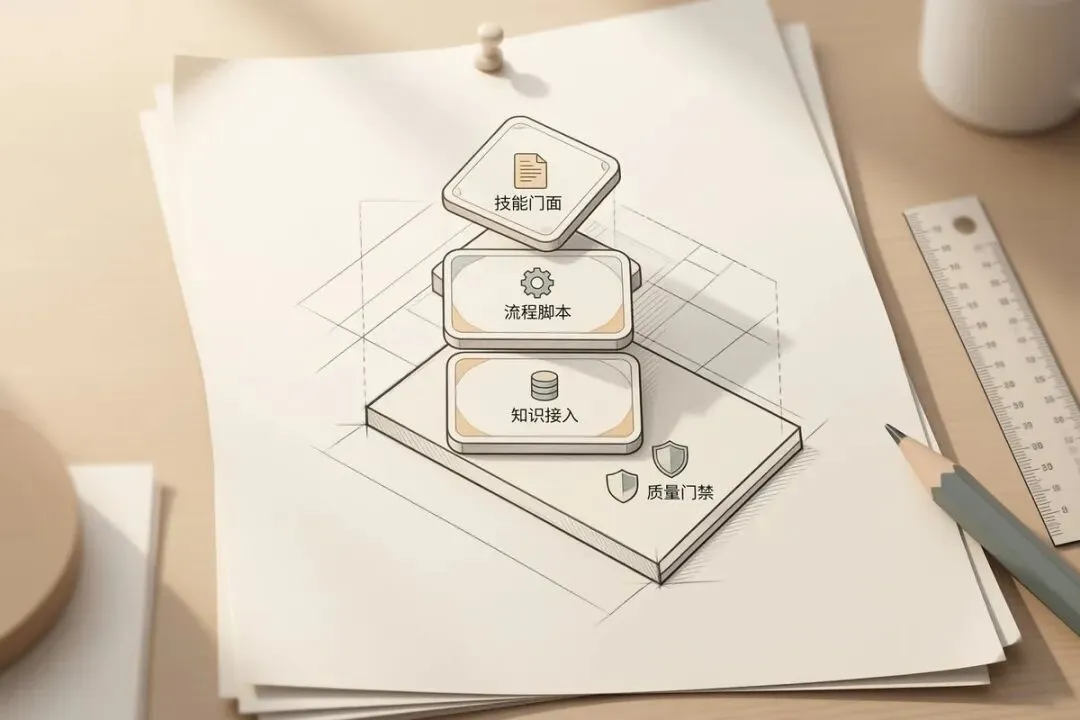
第一层 · 技能门面(SKILL.md)
职责只有一个:定义“我是什么、怎么用我、什么场景触发、什么场景不触发”。
一份合格的合同审查技能骨架示例:
# 合同审查技能
## 角色
为执业律师提供合同审查支持,输出结构化审查意见。
本技能不构成法律意见,所有结论需律师复核。
## 触发条件
- 用户提供了合同文本 + 至少一条立场信息
- 用户明确要求“审查”“找风险”“出意见”
## 输入要求
1. 合同全文(DOCX/PDF/纯文本)
2. 立场(甲方/乙方/中立),未明确则询问
3. 关注重点(可选)
## 流程
1. 解析文档,提取结构化要素
2. 确认立场,未确认则询问
3. 接入知识层检索相关法条
4. 按合同类型激活对应检查点
5. 生成审查意见
6. 通过四项门禁 → 交付;未通过 → 阻断
## 输出格式
{合同名}_审查意见.md
- 立场:甲方
- 审查依据:法条 N 条(每条标注来源 + 时效)
- 风险清单:分级 + 定位 + 依据 + 建议
- 未决事项:单独列出
## 关键门禁(任一未过,阻断交付)
- [ ] 立场未确认
- [ ] 依据未标注来源
- [ ] 输出超出范围
- [ ] 未决事项未单独标注
正文 80 行以内,但这套技能该有的约束都在。
设计原则:
每加一行都要问:这行是“方法”还是“知识”?是“方法”才留下,是“知识”就该走第三层 不要在 SKILL.md 里复制法条、复制风险清单、复制案例——那是数据,不是方法 流程骨架的颗粒度:每一步都能用一个动词短语描述(解析、确认、检索、激活、生成、门禁)
第二层 · 流程脚本(scripts/)
这一层干“动作”——文档怎么读、要素怎么提、输出怎么组。不干“判断”。
典型脚本:
doc_parser.py:DOCX/PDF 转纯文本 + 段落定位 element_extractor.py:主体、标的、价款、期限、管辖、违约责任等结构化字段 report_assembler.py:把 AI 返回的审查意见按标准格式写入文档 docx_exporter.py:调用 python-docx 生成带修订痕迹的批注版合同
设计原则:
每个脚本只干一件事,单文件 100-200 行以内 脚本之间通过标准输入输出对接,不共享内存 AI 只看脚本的输入输出契约(“调用 doc_parser.py,输入文件路径,返回纯文本 + 段落列表”),不看脚本内部实现 脚本可以独立运行、单独调试,不需要 AI 介入
这样做的好处:AI 不需要理解脚本怎么写,它只需要知道这个脚本能干什么、输入输出是什么。脚本放在 scripts/ 目录里按需调用,AI 的注意力不会被打断。
第三层 · 知识接入——三种形式各有所长
这是最关键的一层:知识不直接进 AI 上下文,而是通过三种形式接入。
形式 A:配置表(CSV/Markdown)适用于合同类型表、风险检查清单、条款标准这类配置性数据。脚本读取数据做匹配和路由,结果返回给 AI。
data/
contract_types.csv # 合同类型表(程序读)
review_checklists.md # 检查清单(程序读)
clause_standards.csv # 条款标准(程序读)
关键:CSV 是程序数据,不是 AI 阅读材料。一个 30KB 的 CSV 经过程序筛选后,可能只返回500 字节给 AI——是列表、是判断结果、不是表格原文。
形式 B:MCP 接口调用适用于法规库、案例库、企业信用信息这类外部数据源。通过 MCP 协议调用专业服务,按需检索,按需返回。
关键设计:接口返回精炼版,不返回全文。检索“公司法 第71条”,接口返回:
条文要点:股东向股东以外的人转让股权,应当经其他股东过半数同意
适用情形:股权转让场景
出处:公司法(2023 修订)第71条
时效:现行有效
关联:公司法司法解释(三)第24-28条
200-500 字节,不是 50KB。这是上下文控制的关键。
形式 C:本地检索脚本适用于离线场景或自建索引的情况——几万条法条做成 provision-index.json,配 search.py 提供命令行检索。
laws/
provision-index.json # 39MB 法条索引
currency-manifest.json # 时效清单
dependency-graph.json # 依赖图谱
law-index.json # 元数据
AI 不读这 39MB——它通过 shell 调用脚本,传入检索词,脚本返回按 tier 排序的前 N 条结果。我具体核实过这种检索脚本的实现:每个检索词返回几百字节到几 KB,不是 39MB。
关键设计:检索词要有层次。
主检索词:对赌协议 效力
法律层:公司法 / 民法典
司法解释层:九民纪要 / 合同法司法解释
类案层:对赌纠纷 最高法 判决
排除词:股权激励 / 业绩奖励 / 一般合同违约
每一层都有限定,多层组合后召回精确度显著提升。
三种形式怎么选?
配置表:知识体量小(几百条)、更新频率低(半年一次)、需要程序匹配(关键词、规则路由)——首选 A MCP 接口:知识体量大、更新频繁、有专业服务可用——首选 B 本地检索脚本:离线场景、不能连外网、有自建索引——选 C
律师场景大多数情况下首选 B(pku-law MCP 是现成的),其次是 A(配置类数据),C 是少数情况。
第四层 · 质量门禁
这一层贯穿整个流程,不是一个独立文件,而是一组硬约束。
门禁的双轨实现原则:
SKILL.md 里写一份(人读):用自然语言说清楚门禁规则 脚本里实现一份(机读):用代码硬检查,自动阻断
两轨不一致时,以脚本为准——因为脚本是真的在执行。
门禁的力度可调:
严苛模式:任一门禁未过 → 立即阻断 提示模式:门禁未过 → 标注警告,但仍交付(律师自己决定要不要采纳)
律师用 AI 技能,最怕的不是 AI 错,而是 AI 错得自己不知道。门禁的价值就是让 AI 知道自己错在哪。
落地清单(2-3 天跑通)
跑通之后,先用一两周,看哪些门禁实际生效、哪些是冗余;哪些脚本被反复调用、哪些被绕过。根据真实使用数据迭代,而不是一开始就堆功能。
05
PART
方案的边界:不是所有任务都需要完整四层
BOUNDARY
上一节讲的是完整架构,但并不是所有律师任务都需要做到这个程度。
判断要不要做完整架构,看三个问题。
问题一:这个任务的“方法”是否稳定?任务的方法稳定(每次审查都按同样的步骤看同样的要点),适合做技能。任务的方法不稳定(每次情况都不一样),不适合——硬做成技能反而会限制 AI 的判断。
自检
你能在不查具体案例的情况下,把这个任务的步骤列出来吗?能,方法稳定;不能,别急着做技能。
问题二:这个任务的“知识”是否高频复用?任务需要的知识高频复用(合同审查天天查公司法、民法典),适合接入 MCP——技能本身保持轻量,知识按需取。任务需要的知识低频复用(偶尔查一次特殊行业规范),连接口都不用接,AI 自己查就行。
自检
这个任务每个月要查的法规/案例超过 50 条吗?是,接接口;否,AI 临时查。
问题三:这个任务的输出是否需要“可复核”?律师交付物必须可复核——每条意见都能追溯依据,否则风险不可控。这种任务必须有“依据门禁”“立场门禁”等硬约束。普通一次性任务(如生成营销文案)不需要门禁,AI 自己把好质量就行。
自检
这个任务的输出会被律师直接给客户吗?是,必须有门禁;否,可以先跑 MVP。
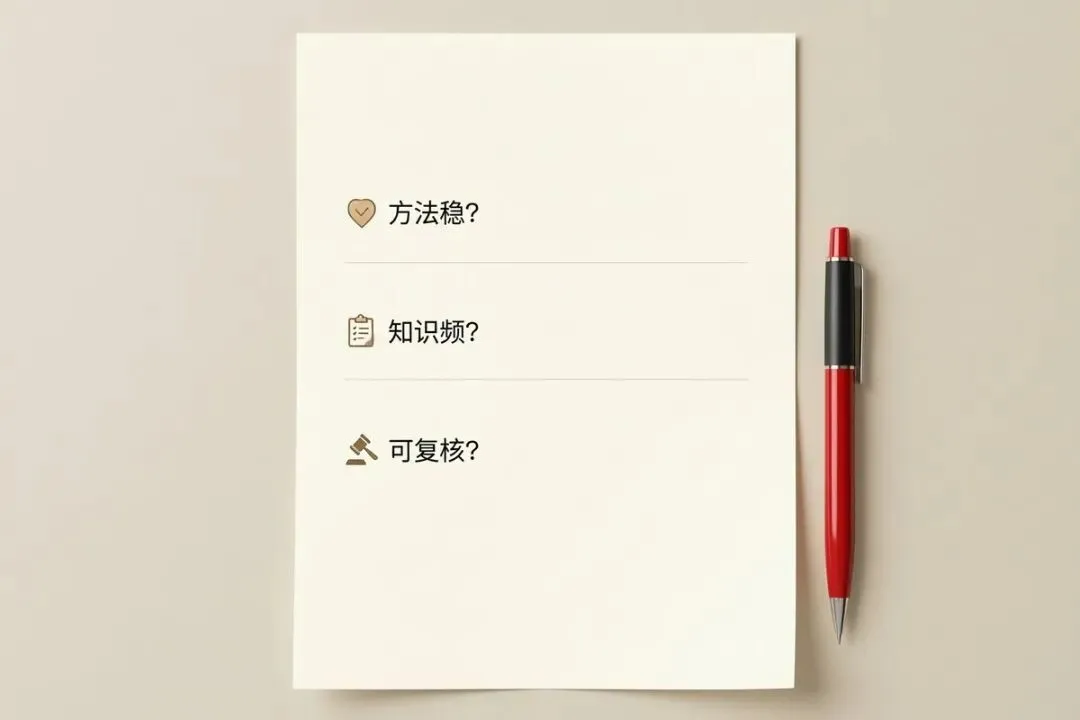
把这三个问题答完,工程的边界就有了。任务不同,工程的颗粒度也不同——这不是“做多做少”的问题,是“该不该做”的问题。
06
PART
给自建技能律师的实操建议
GUIDE
四条原则,来自上面的分析和落地的验证:
原则一:技能骨架要薄,知识接入要厚。SKILL.md 是门面,不是仓库。把方法写完,把知识接入层(配置表 + 接口 + 检索脚本)做好。骨架控制在 500 行以内,更保守 300 行。
原则二:先用纯方法跑通,再决定加知识层。哪怕前两周不接 MCP,技能也该能跑——只是输出会标注“未检索法条”。跑通后再接接口,比一开始就堆完整栈容易。
原则三:门禁比能力重要。边界比能力更能决定交付质量。未确认立场不出报告、依据未标注不构成结论、越权修改自动回滚——这些门禁加起来,决定了这个技能能不能被律师信任。
原则四:用真实使用数据迭代,不用想象堆功能。跑通后看哪些门禁实际生效、哪些脚本被反复调用、哪些流程被 AI 跳过。根据真实使用调整,而不是一开始就追求“功能完整”。
07
PART
最后的判断
VERDICT
回到引子里的观察——AI 技能方案分布在四个层级,每个有强项有软肋。讨论时常被简化成“提示词 vs 重型版”两端,掩盖了中间工程化的空间。
真正能做的,是从技能的工程属性出发,看清每种设计选择的代价,然后对大多数律师场景,找到一个“让人能用、让机器能跑、让维护能持续”的中间状态。
这个状态长这样:
技能的 SKILL.md 只有几百行,写的是流程和门禁,不装知识 知识通过三种形式接入:配置表(程序读)、MCP 接口(按需取)、本地检索脚本(离线用),AI 都不直接读大体积数据 脚本干“动作”,不干“判断”,AI 决定怎么用脚本的结果 门禁双轨实现(人读 + 机读),不通过就阻断
这条路不性感——没有 39MB 本地数据库硬塞进上下文,也没有十几个专项子技能的复杂调度。但它两三天能跑通,跑通后能持续用,而且每次任务的上下文是干净的。
技术架构的本质,是让人能用、让机器能跑、让维护能持续。三个“能”都满足的架构,不需要 3-4 周,也不需要堆功能——它只需要把这三个问题答清楚。
THE MIDDLE PATH
这就是欠工程化与过度工程化之间的那条路。它不宽,但走起来稳。
SOURCES · 来源清单(供核验)
01 / Anthropic 官方合同审查技能(playbook + 三档风险 + 升级路径):github.com/anthropics/knowledge-work-plugins (legal/skills/review-contract/SKILL.md)
02 / 官方文档《Skills》定义与渐进加载机制:code.claude.com/docs/zh-CN/skills
03 / 《Skills 开发规范:4 原则、5 维度、5 层检查》(2026-06):developer.cloud.tencent.com/article/2689796
04 / 《Skill 的局限和常见坑》:01mvp.com/docs/skills/skill-pitfalls
05 / 合同审查类公开数据集(CUAD,41 类风险,510 份合同归纳):github.com/evolsb/claude-legal-skill
06 / 合同审查 + 企查查 MCP 实时核验(“Token 开销直降 96%”为其 README 原文):github.com/duhu2000/legal-assistant-skills
07 / 《律师如何用好AI智能体》(观典律师事务所):risinglawyer.com/page54?article_id=7485
本文为方法论探讨,案例仅作技术论证使用,不针对任何项目或作者。
我是恒和信王律师,一名把律师工作方法沉淀成 AI 技能的执业律师。这里的每一条,都是从真实案件和真实试错里长出来的。该工程化的是方法,不是知识。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见
THANKS FOR READING