ARTICLE · 990891
开源 5 天 1.1 万 Star:把 PDF、Word、PPT、Excel 变成 AI 能读的 Markdown
你不是没有资料,而是把 PDF、Word、PPT、Excel 一股脑塞给 AI 了。
很多人搭知识库的第一步就错了:先买向量数据库、配模型、写复杂工作流,却没有解决一个更朴素的问题——AI 收到的到底是不是一份有结构、可引用、可追溯的文本。
一份 Word 里有标题、表格、批注;一份 PPT 的重点藏在每页结构和备注里;Excel 又有列、行、公式和图表。你直接把文件拖给 AI,它有时能读,有时读得支离破碎。于是你以为模型不够聪明,其实输入还没有准备好。
最近 Firecrawl 开源的 anydoc,做的事情很简单也很实用:把 Word、PPT、Excel、PDF、EPUB、CSV 等办公文件,统一转成 GitHub-Flavored Markdown。
截至 2026 年 8 月 8 日,它创建 5 天、GitHub 约 1.13 万 Star,MIT 许可。热度不是你该安装它的理由;真正值得看的是,它把“文件能不能被 Agent 稳定读取”变成了一个独立、可替换的步骤。
官方链接
GitHub 官方仓库 / README:https://github.com/firecrawl/anydoc 官方安装与命令说明:https://github.com/firecrawl/anydoc#quick-start
先看它解决的真实问题
资料包:会议纪要.docx + 产品方案.pptx + 数据表.xlsx + 报告.pdf ↓ anydoc 统一转换 ↓ Markdown 文件 + 原始文件路径/来源 ↓ Codex 做总结、对比、提取待办、建立索引它不是替你做决定,也不是自动把资料变成“智能知识库”。它只是先把不同格式的文件,变成更适合 AI 处理的共同语言。
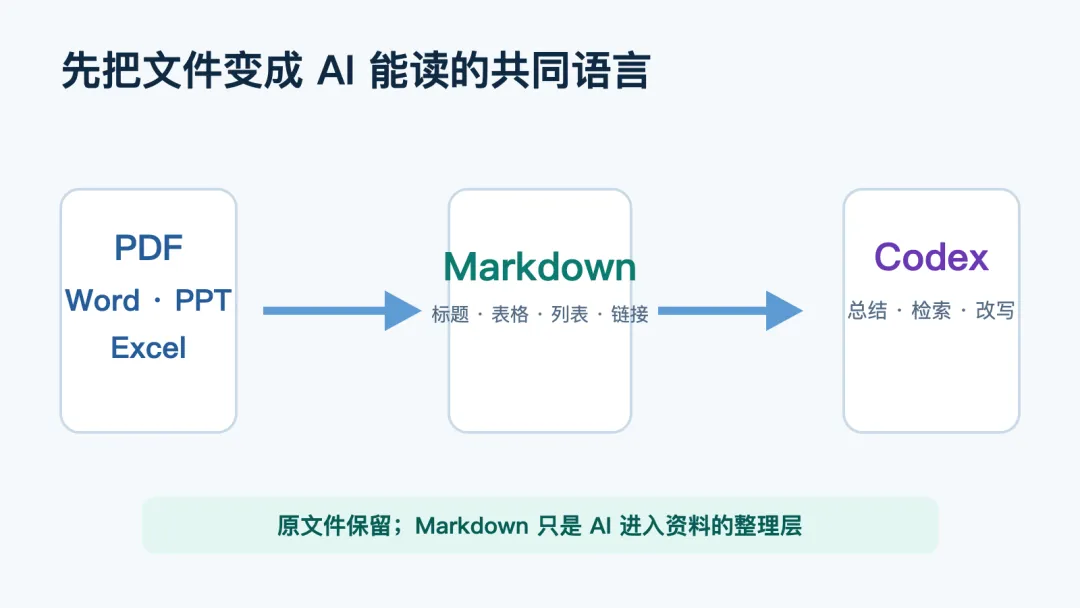
三步接进你的 Codex 工作流
第一步:先拿一份可公开的资料试
先别把客户资料、合同或私人文件丢进去。选一份自己写的会议纪要、公开白皮书,或者你自己的 PPT。你要先观察:标题有没有保留、表格有没有变形、列表与链接是否可读。
第二步:用一条命令转 Markdown
官方给出的最小 CLI 用法如下:
npx @firecrawl/anydoc report.docx -o report.md它也支持 .pptx、.xlsx 与文本型 PDF。第一次通过 npx 运行会下载对应平台的预编译二进制;长期使用再考虑是否安装为固定命令。
第三步:把 Markdown 和任务一起交给 Codex
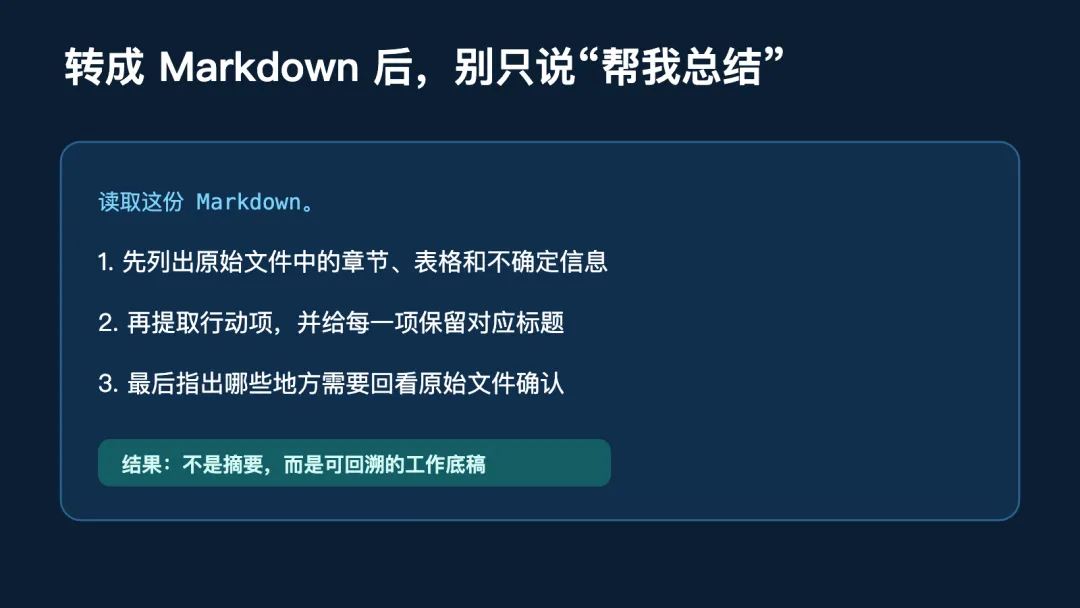
不要只说“帮我总结这个文件”。更好的任务是:
读取这份 Markdown。先列出原始文件中的章节、表格和不确定信息;再提取行动项,并给每一项保留对应标题;最后告诉我哪些地方需要回看原始文件确认。这样做的好处是:输出不只是一个流畅摘要,而是能回到原资料位置的工作底稿。
它能转什么?又不能解决什么?
官方 README 列出的输入包括 Word、PowerPoint、Excel、OpenDocument、RTF、EPUB、CSV 与文本型 PDF。项目使用统一的文档模型与 Markdown 序列化器,因此标题、列表、表格、脚注等结构会按同一套规则输出。
但这三件事要分开看:
这一点非常重要:Markdown 是资料进入 AI 工作流前的整理层,不是知识库终点。 原始文件必须保留;转换后的 Markdown 要带原文件名、日期、来源与权限标签。
我会把它放在哪?
如果后面将它接进 AI-Knowledge-OS,我会把它放在“资料进入长期知识库之前”:
原始资料(保留) → anydoc 转换副本 → 人工快速检查结构/敏感信息 → 带来源的 Markdown → Codex 检索、总结、写内容或生成任务这样当 AI 的结论有问题时,我们仍能回到原始 PPT、Word 或 PDF,而不是只剩一段不知道从哪里来的摘要。
最后给你一个入库前检查表
[ ] 文件是否允许进入当前项目? [ ] 原始文件是否保留、命名清楚? [ ] 转出的标题、表格、列表是否还可读? [ ] 扫描件是否需要 OCR,而不是硬转? [ ] 给 Codex 的任务是否要求它标出不确定信息与来源章节?
先把输入变干净,再谈 AI 能不能替你干活。这类工具的价值,不是多了一个命令,而是让你把“文件 → 可用知识”这一步变得可检查、可替换、可复用。
来源与说明
能力、格式范围、安装方式和基准数据来自官方链接:
GitHub 官方仓库 / README:https://github.com/firecrawl/anydoc 官方安装与命令说明:https://github.com/firecrawl/anydoc#quick-start
README 的速度和质量对比是项目方基准,本文不把它当作唐伯猫本机性能实测;扫描型 PDF 的 OCR 需求以官方说明为准。