ARTICLE · 991594
手机里的AI视觉助手:1.3B参数的MiniCPM-V 4.6开源,6G内存就能玩转图像视频理解!
你有没有发现,现在的AI模型越来越"胖"了?动不动几十亿、上百亿参数,没张4090都不敢说自己玩AI。但就在今年五月,面壁智能联合清华NLP实验室扔出来一颗"小钢炮"——MiniCPM-V 4.6。这玩意只有1.3B参数,却能看懂图片、理解视频、读文档,甚至在你手机里流畅跑起来。
先说说它有多猛。在Artificial Analysis的评测榜单上,MiniCPM-V 4.6拿了13分,直接把Qwen3.5-0.8B(10分)甩在身后。更离谱的是,它达成这个分数只花了对方1/19的token成本。用大白话讲,就是又聪明又省电。
它到底能干啥?
别看体积小,本事一点不少。拍张照问它"这上面写的啥",它能OCR识别;丢个视频进去,它能告诉你视频里发生了啥;你甚至可以同时扔好几张图,让它对比分析。文档理解、数学推理、视觉定位,这些以前需要云端大模型才能干的活,现在本地就能搞定。
而且它有俩模式。Instruct版本适合日常问答,Thinking版本则会像人一样"琢磨"一下再回答,做复杂推理更靠谱。
为啥它能在手机里跑?
秘密在于LLaVA-UHD v4技术。传统视觉模型处理高分辨率图片时,计算量会爆炸式增长。MiniCPM-V 4.6搞了个"ViT内部早压缩",把视觉编码的计算量砍掉了一半以上。
更绝的是它支持4倍和16倍两种视觉token压缩率。要精度选4倍,要速度选16倍,一个模型两种性格。
上手跑起来,比你想象的简单
方法一:HuggingFace Transformers(最快体验)
如果你只是想试试效果,几行代码就搞定。
先装环境:
pip install transformers>=5.7.0 pillow torch然后跑这个脚本:
from transformers import AutoModelForImageTextToText, AutoProcessormodel_id = "openbmb/MiniCPM-V-4.6"processor = AutoProcessor.from_pretrained(model_id)model = AutoModelForImageTextToText.from_pretrained( model_id, torch_dtype="auto", device_map="auto")# 准备图片和提问messages = [ {"role": "user","content": [ {"type": "image", "url": "你的图片.jpg"}, {"type": "text", "text": "描述这张图片的内容"}, ], }]inputs = processor.apply_chat_template( messages, tokenize=True, add_generation_prompt=True, return_dict=True, return_tensors="pt", downsample_mode="16x", # 16倍压缩,速度飞快 max_slice_nums=36,).to(model.device)generated_ids = model.generate(**inputs, downsample_mode="16x", max_new_tokens=512)response = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]print(response)想跑视频的话,改几个参数就行:
inputs = processor.apply_chat_template( messages, tokenize=True, add_generation_prompt=True, return_dict=True, return_tensors="pt", downsample_mode="16x", max_num_frames=128, # 最大采样帧数 stack_frames=3, # 每秒采几帧 max_slice_nums=1, use_image_id=False, # 视频建议关了这个).to(model.device)方法二:vLLM部署成服务(适合生产环境)
想做成API给别人用?vLLM安排上。
vllm serve openbmb/MiniCPM-V-4.6 \ --port 8001 \ --trust-remote-code \ --dtype bfloat16 \ --tensor-parallel-size 1 \ --gpu-memory-utilization 0.9启动后测一下:
curl http://localhost:8001/v1/chat/completions \ -H "Content-Type: application/json" \ -d '{ "model": "openbmb/MiniCPM-V-4.6", "messages": [ {"role": "system", "content": "你是一个人工智能助手。"}, {"role": "user", "content": "请简要介绍一下什么是深度学习?"} ], "temperature": 0.7 }'方法三:Ollama本地跑(最简单)
今年六月,MiniCPM-V 4.6已经进了Ollama官方模型库。
ollama run minicpm-v4.6一句话,完事。
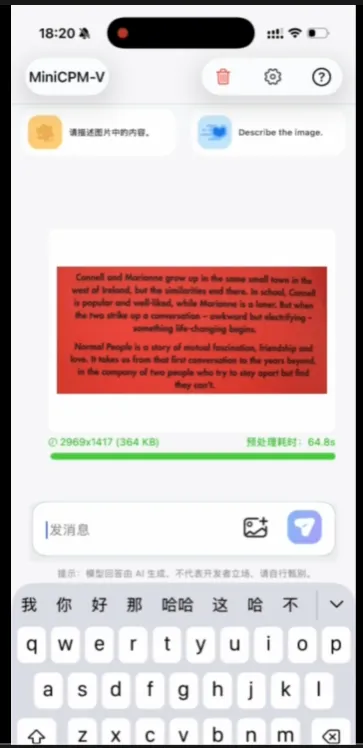
方法四:手机端部署(最酷)
这才是重头戏。面壁智能把iOS、Android、鸿蒙的端侧适配代码全开源了,甚至还有现成Demo。
先去GitHub克隆移动端项目:
git clone https://github.com/OpenBMB/MiniCPM-V-Apps.gitcd MiniCPM-V-Appsgit submodule update --init --recursiveiOS用户用Xcode打开MiniCPM-V-demo/MiniCPM-V-demo.xcodeproj,连上手机点Run就行。Android用户进MiniCPM-V-demo-Android目录,执行./gradlew assembleDebug编译安装包。鸿蒙用户用DevEco Studio打开MiniCPM-V-demo-HarmonyOS工程,配好签名后跑起来。
模型文件也不大。语言模型GGUF约0.5GB,视觉模型mmproj约1.1GB,加起来才1.6GB。首次启动时,App里点"下载"就会自动拉取。如果你嫌慢,也可以用adb或hdc手动推送到手机里。
量化版本怎么选?
官方给了好几种"瘦身"方案:
GGUF格式:CPU就能跑,2GB内存搞定 BNB/AWQ/GPTQ:GPU显存3GB左右,适合老显卡 Thinking版本:带深度推理,适合复杂任务
实际能用在哪?
想象空间挺大的。比如你是个学生,上课拍张PPT,它直接帮你整理成笔记。你是个运维,拍张报错截图,它告诉你哪行代码有问题。或者你纯粹不想把照片传到云端,那本地跑这个模型,隐私完全在自己手里。
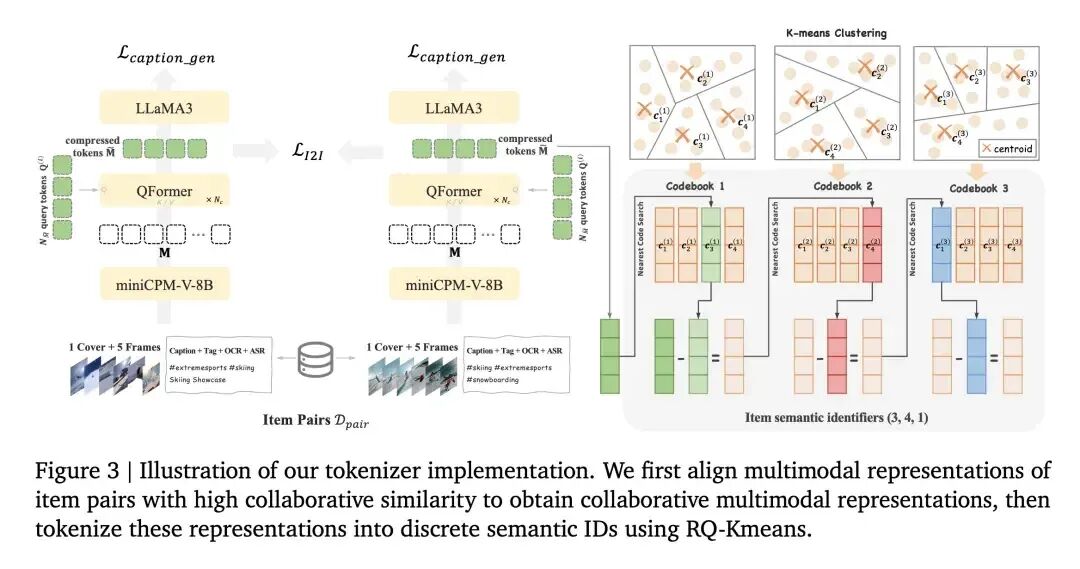
快手已经在他们的推荐大模型里用了MiniCPM-V系列的技术,支撑了主场景25%的流量。
写在最后
MiniCPM-V 4.6的出现,说明了一件事:AI不一定非要堆参数。1.3B的体量,Apache 2.0协议随便商用,从手机到PC到服务器都能跑。对于想做多模态应用又没钱买显卡的开发者来说,这简直是雪中送炭。
如果你也想试试,可以直接去HuggingFace在线体验,或者把模型拉下来本地折腾。端侧AI的时代,真的来了。
guthub地址:https://github.com/OpenBMB/MiniCPM-V