ARTICLE · 991757
AI 工具突然换模型,之前的工作还能继续吗?
8 月 28 日,OpenAI 发布了一则公告:在 Cursor 被 SpaceX 收购后,OpenAI 将逐步结束向 Cursor 提供模型的合同。
这不等于 Cursor 马上不能用了,也不代表用户原来的代码和项目会突然消失。具体会怎样调整,还要看 Cursor 后续的产品安排。
严格来说,这是一则供应关系调整的公告,不是 Cursor 已经停用 OpenAI 模型。但对使用者来说,真正值得关心的是同一个问题:如果 AI 工具背后的模型发生变化,原来的工作还能不能接着做?
但这件事也带来了一个很现实的问题:
你每天使用的 AI 工具,和它背后调用的模型,不一定永远绑定在一起。
模型可能下线,套餐可能调整,接口可能变化,工具也可能更换合作方。
如果之前的工作全都留在一个聊天窗口里,换工具时就容易从头再来。
真正需要保留下来的,不是某个模型的名字,而是你的任务规则、原始资料、输出格式和验收标准。
先说结论:工作可以继续,但不能把整套工作只留在某个聊天窗口里。
先分清:工具、工作流和模型不是一回事
平时打开一个 AI 工具,你看到的通常只有输入框和回答。
但一项完整工作,至少可以拆成五层:
1.使用入口:你从网页、客户端或聊天窗口发起任务。
2.任务规则:AI 要做什么,不能做什么,输出成什么样。
3.工作流程:先读哪些资料,再做哪些处理,什么时候交给人确认。
4.模型接入:这次任务实际调用哪个模型或服务商。
5.人工验收:结果是否准确、完整,能不能继续使用。
很多人把这五层一起塞进一次对话里。
于是,模型一换,前面的解释要重新说;聊天记录一丢,原来的规则也找不到;工具不能导出,资料和结果就散在不同页面里。
更稳妥的做法,是把模型放回它应该在的位置:
模型负责完成当前这次处理,但任务规则、原始资料、流程和验收标准由自己保留。
这样一来,模型只是工作链路中的一个处理环节。它可以更换,但任务目标、资料边界和交付标准不应该跟着消失。
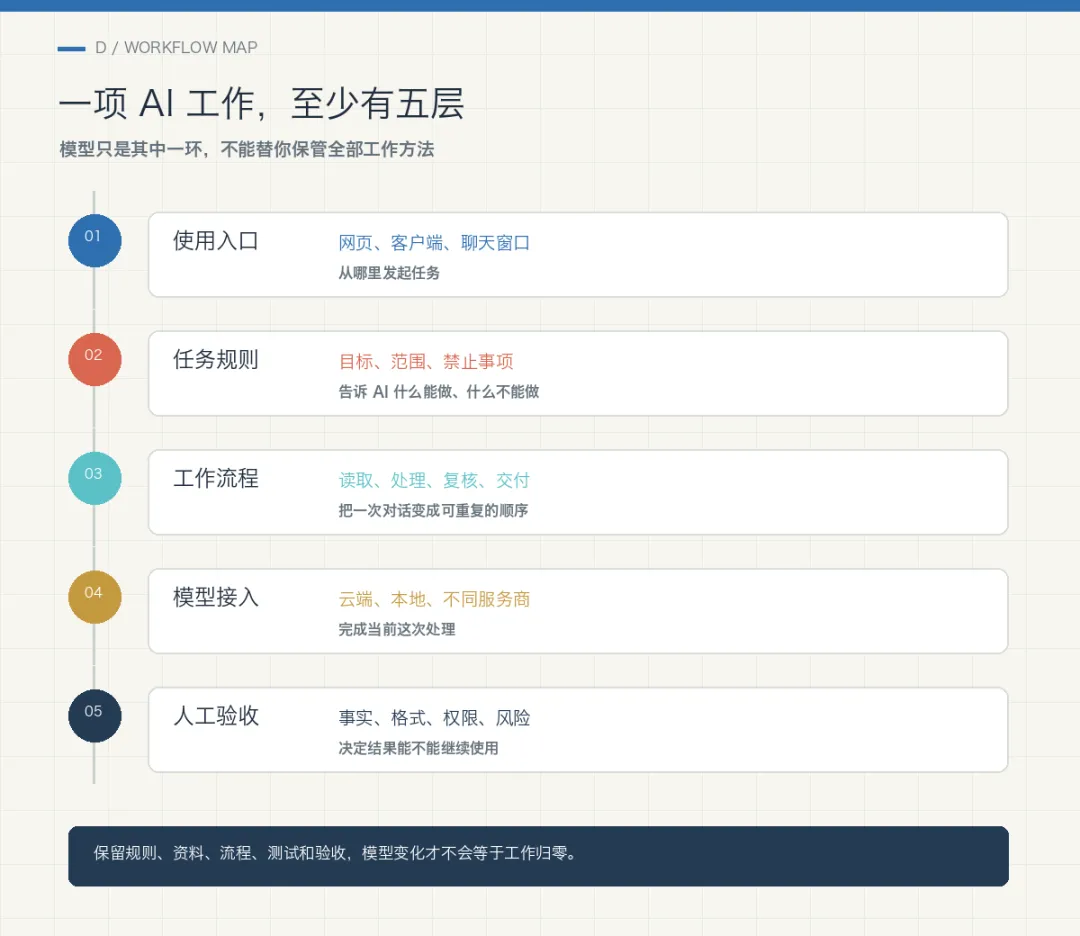
五层工作链路:入口、规则、流程、模型、人工验收
把这五层拆开,工具为什么可以替换
现实里,已经有一些公开的开源工具,分别在解决入口、工作流和模型接入的问题。
不需要马上安装它们。先看清它们各自解决什么问题,就能理解一套 AI 工作为什么不必绑定在某一个模型上。
Open WebUI:把聊天入口和模型分开
Open WebUI 是一个可以部署在自己的电脑或服务器上的 AI 使用界面。它既可以连接本地 Ollama 模型,也可以连接兼容 OpenAI 接口的云端服务。
它说明了一件事:
你每天看到的聊天窗口,不等于后面只能使用一个模型。
入口可以保持相对统一,背后的模型和服务可以根据需要调整。
但“可以连接”不等于“所有模型效果一样”。换模型后,文件支持、上下文长度、工具调用和回答质量仍然要重新检查。
Dify:把流程从聊天记录里拿出来
Dify 把模型管理、资料检索、工作流和 Agent 等能力放在一个可视化平台里。
相比在聊天窗口里反复解释,它更接近一条可以保存的工作流程:
•资料从哪里来;
•先做什么,再做什么;
•哪一步调用模型;
•输出要整理成什么格式;
•哪些结果需要人工确认。
模型可以是流程中的一个节点,而不是整项工作的全部。
这样做的价值,不是“点一下就能换模型”,而是模型变化时,不必重新发明整套工作方法。
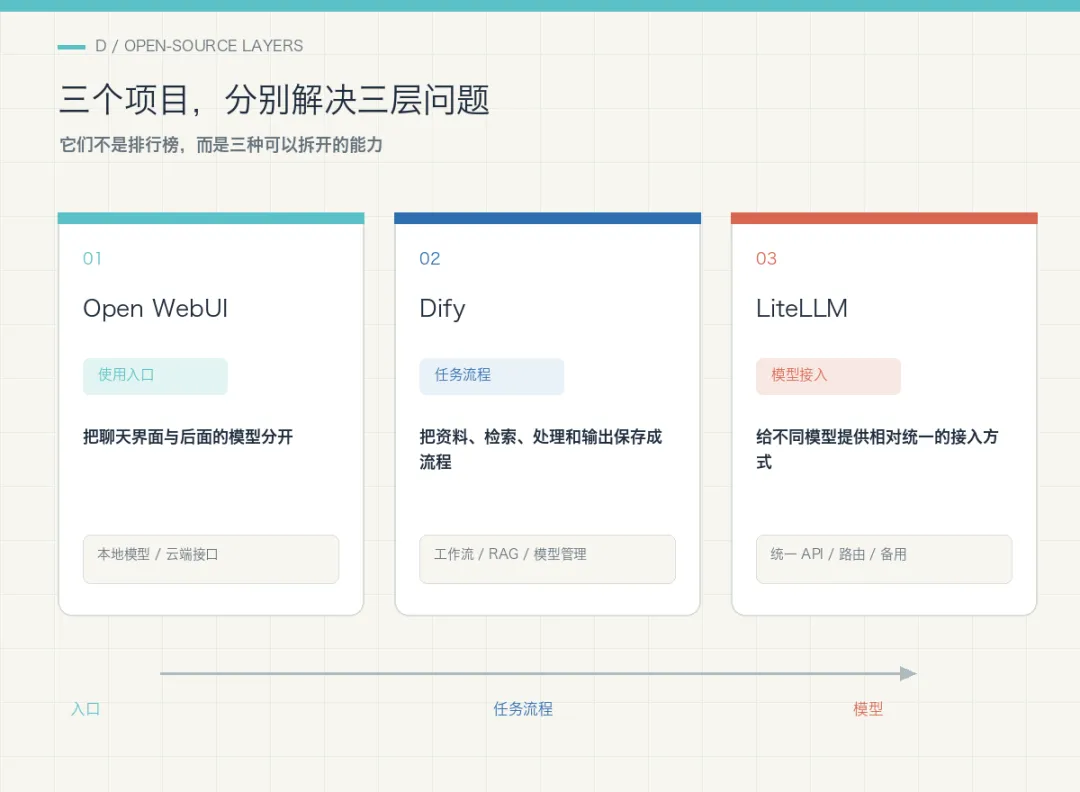
三个开源项目分别解决入口、流程和模型接入
LiteLLM:让模型接入独立出来
不同模型服务的接口、认证方式和错误信息可能不一样。
LiteLLM 的思路,是在应用和模型之间提供一套相对统一的接口,并支持路由、重试和备用模型等能力。这样,业务工具不必为每个模型分别适配一套连接方式。
可以把它理解成一个转接台:
业务工具 → 统一接入层 → 模型 A / 模型 B / 本地模型
不过,转接台只能减少接入上的重复工作,不能抹平模型能力的差异。一个擅长长文档的模型换成另一个模型后,原来的任务仍然需要重新验收。
以一个具体任务为例:什么才应该留下
假设你要让 AI 处理三份供应商方案,最后整理成一张选型表。
如果只在聊天框里写一句:
帮我比较一下这三份方案,看看选哪家。
这次也许能得到一个答案。
但换个模型、换个同事,结果就可能变成另一种格式,甚至开始猜测资料里没有写的内容。
更稳妥的做法,是先建立一张与模型无关的任务卡。
可迁移任务卡
【任务目标】 把三份供应商方案整理成选型对比表,供负责人初步评估。 【输入资料】 三份供应商提交的原始方案及报价附件。 【输出字段】 供应商|报价|报价口径|交付周期|服务范围|售后承诺|主要风险|待确认事项|原文依据。 【处理规则】 1. 只能依据提供的资料,不补写供应商没有承诺的内容。 2. 报价口径不一致时,不直接比较总价,先标记差异。 3. 找不到的信息写“资料未说明”,不要自行推测。 4. 每个重要判断都要保留文件名和对应页码或段落。 5. 最终选择由负责人确认,AI 只负责整理和提示风险。 【验收标准】 字段完整;金额与原文一致;没有遗漏附件;没有把推测写成事实;所有待确认事项单独列出。
这张任务卡可以保存在文档里,也可以放进 Dify 之类的工作流中。
以后换模型时,不需要靠回忆重新解释任务,只需要把同一份资料、同一张任务卡和同一套验收标准重新跑一遍。
如果结果仍然满足字段、依据和风险要求,说明这项工作具备一定的可迁移性;如果结果变化很大,也能很快定位是模型能力、资料处理还是任务规则出了问题。
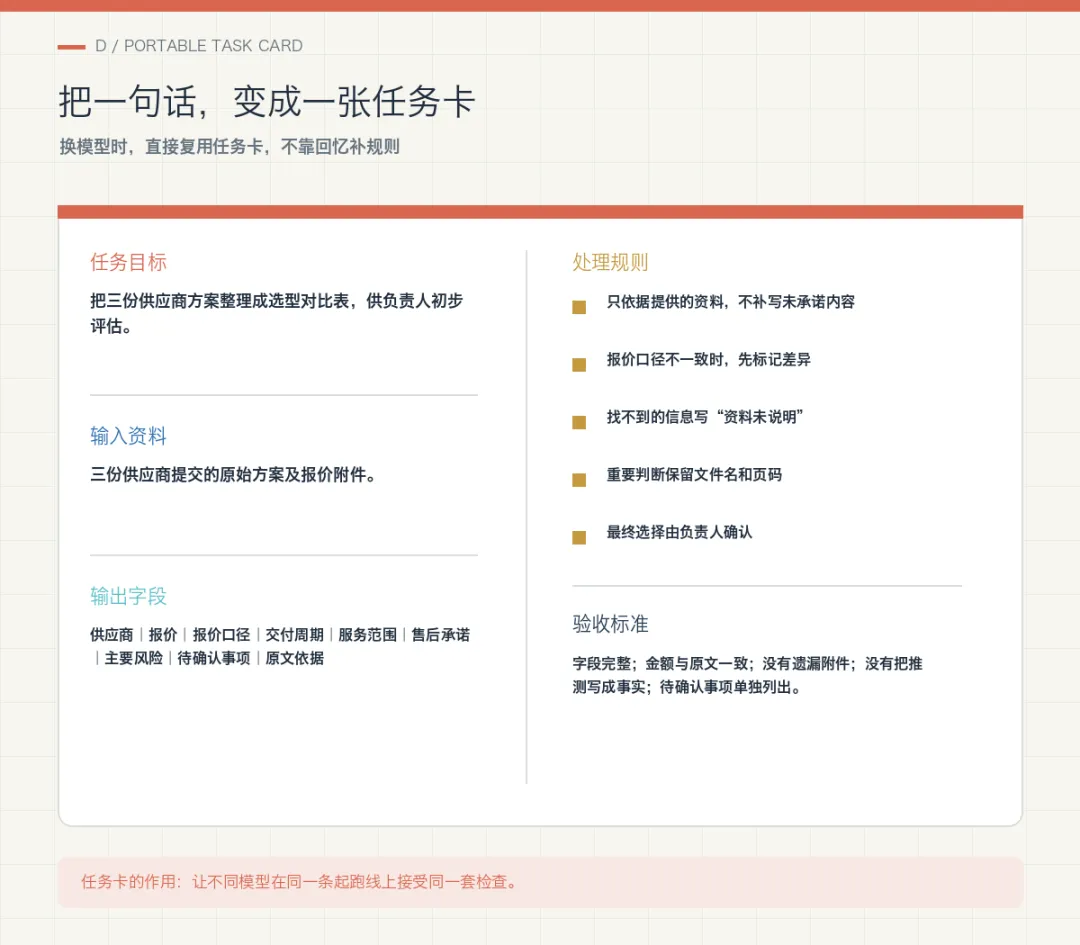
可迁移任务卡:把一次对话变成可重复的工作单元
只保存 Prompt,还不够:要保存整套任务
一套真正可迁移的 AI 工作,至少要留下五样东西。
1. 原始资料
不要只把文件上传到 AI 工具里,自己也要保留原始版本、文件名和日期。
如果资料会更新,还要区分当前版本和历史版本。否则换模型后,即使答案不同,也很难判断是模型变化,还是输入资料已经变了。
2. 任务卡
任务目标、输入范围、禁止事项和人工确认点,应该单独保存,不要散落在几十轮聊天记录里。
3. 输出模板
表格字段、报告结构和必须保留的依据要固定下来。
否则,换一个模型就可能换一种写法,很难比较结果是否真的变好。
4. 固定测试样例
保留一两份已经人工确认过的输入和合格输出。
换模型后,先用固定样例测试,再决定是否处理新的业务资料。固定样例的作用,是让不同模型在同一条起跑线上比较。
5. 验收清单
不要只看回答顺不顺,还要检查事实、数字、遗漏、权限和下一步动作。
模型越容易更换,验收标准越不能省。
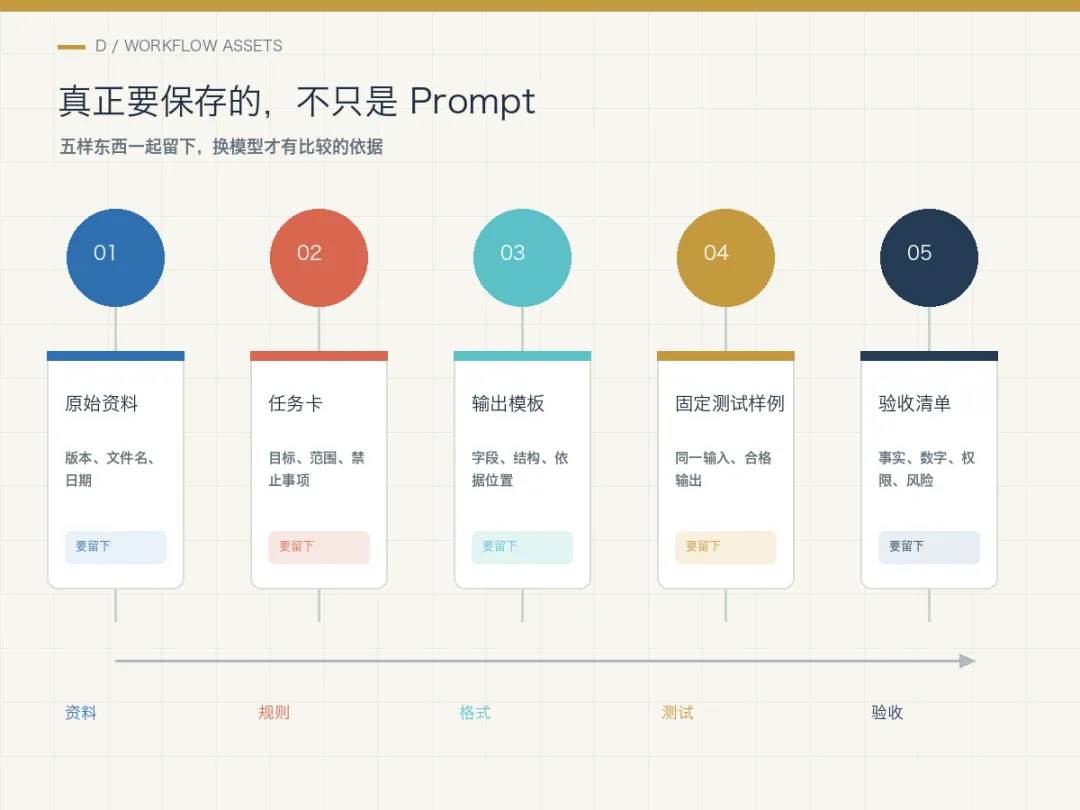
一套可迁移工作需要留下的五样东西
“可以换模型”不等于“无成本切换”
这是最容易被忽略的地方。
即使两个模型使用相似接口,也可能存在这些差异:
•能处理的上下文长度不同;
•对 Word、PDF、图片和表格的支持不同;
•是否支持工具调用不同;
•固定格式和 JSON 输出的稳定性不同;
•对中文、长指令和专业术语的理解不同;
•速度、额度、价格和数据策略不同。
所以,模型切换后至少要重新做三件事:
1.用固定样例重新测试;
2.核对输出格式和关键事实;
3.检查资料是否会被发送到新的服务商。
如果任务涉及合同、客户资料、财务数据或外部发送,不能因为系统自动切换了备用模型,就跳过人工确认。自动切换解决的是“任务有没有机会继续”,不是“结果已经可以直接使用”。
换工具前,可以检查这 8 项
1.原始资料是否已经保存在自己可控的位置?
2.任务规则是否独立于聊天记录?
3.输出格式是否固定?
4.是否保留了一组固定测试样例?
5.哪些模型、接口和工具正在被调用,是否有记录?
6.新模型是否支持原来的文件、上下文和工具能力?
7.敏感资料是否会进入新的服务商?
8.重要结果是否仍然有人负责验收?
如果这八项都只存在某个工具的内部页面里,那套工作流仍然很难迁移。
如果任务卡、资料、模板、测试样例和验收标准都掌握在自己手里,模型变化就更像替换一个处理节点,而不是把整项工作推倒重来。
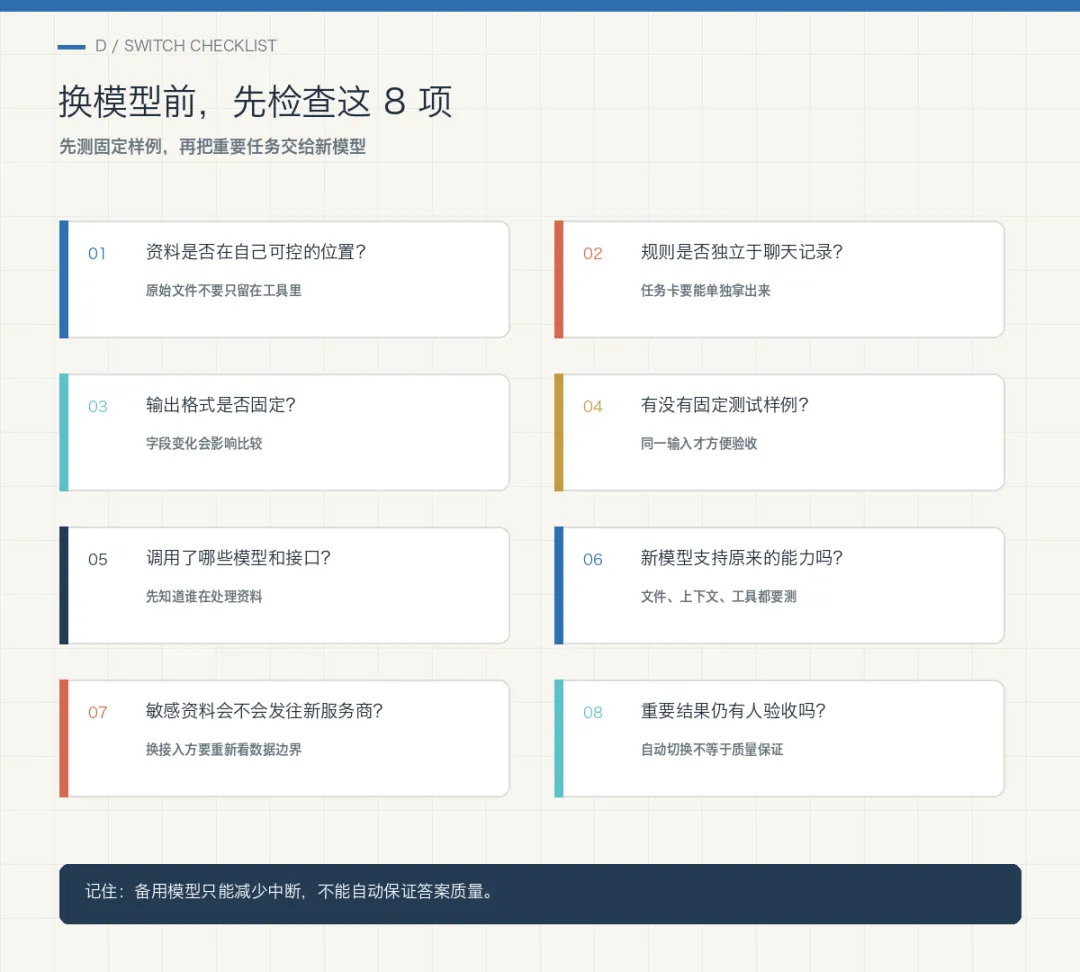
换模型前的八项检查
最后
一次合作关系发生变化,并不意味着要立刻停止使用某个 AI 工具。
但可以借这个机会检查一下:你留下的是一堆聊天记录,还是一套能重复执行的工作方法?
把三者放在一起看,可以得到一个实用结论:入口可以统一,流程可以保存,模型接入可以单独管理。
对大多数用户来说,不一定要马上部署这些项目。
更重要的是养成一个习惯:
把任务和模型分开,把资料和工具分开,把结果和验收分开。
小拓提醒:备用模型只能减少服务中断,不能自动保证答案质量。模型换了,重要任务一定要重新验收。