ARTICLE · 991877
如何借助 AI 逐步重构软件开发生命周期
企业已经开始使用 AI 以一种一年前难以想象的速度编写代码,但围绕代码建立的开发流程,却没有以同样的速度发生变化。
许多工程团队仍然沿用过去相同的审批节点、代码评审、工作交接和管理政策,导致生产力提升被这些流程所拖慢——即使团队已经开始使用诸如 Claude Code 这样的 Agentic Coding(智能代理编程)解决方案。
软件开发生命周期(SDLC,Software Development Lifecycle),是指软件从创意产生一直到最终投入生产环境的完整过程。大多数企业仍然采用类似的六个阶段,涵盖:
规划(Planning)
设计(Design)
开发/构建(Building)
测试(Testing)
部署(Deploying)
维护(Maintaining)
传统上,每一个阶段都是一个相对独立的环节,并由不同的角色负责:
产品经理编写需求;
技术架构师将需求转化为技术设计;
工程师根据设计进行开发;
在受监管行业的企业中,QA 团队负责验证;
发布团队负责将软件上线;
运维团队监控已经运行的软件。
工作通过文档、tickets和审批签字(sign-offs)在不同阶段之间流转。
传统 SDLC 之所以流程繁重,是为了确保每一个环节都有明确的责任归属和控制机制。然而,传统 SDLC 的设计目标,是在一个最耗时、最昂贵的环节是编写和实现代码的时代,最大化开发效率。
而现在,这种情况已经发生了变化。
PRD、估算会议以及产品安全评审等流程,本质上都是为了在过去那种可能持续数周、数月甚至数个季度的开发工作中,强制各方保持一致。
传统 SDLC 中的许多控制机制,还建立在一个基本假设之上:每一个步骤都是由人来完成的。
如今,那些真正能够从 AI 中获得最大价值的企业,已经开始围绕 Agentic AI 当前能够完成的工作能力重新设计开发流程,同时确保人类始终处于决策和监督环节(human in the loop)。
在本指南中,我们将介绍 Applied AI 团队的一些最佳实践,展示如何在 SDLC 的每一个阶段内部集成 Claude,从而加速软件开发,让整个流程运行得更快。这些实践也受到我们与客户合作经验的启发。
当代码不再是瓶颈,会发生什么?
当代码不再是瓶颈,并且 AI 驱动的构建/开发阶段运行速度已经超过传统 SDLC 所能承受的速度时,会出现三个重要变化:
1. 瓶颈会转移到开发阶段的前后环节
新的瓶颈会转移到 Build(开发/构建)阶段左右两侧的流程。
主要包括:
Plan(规划)
Review / Test(评审 / 测试)
Deploy(部署)
这些环节目前仍然主要按照人类的工作速度运行。
也就是说,AI 已经能够非常快速地写代码,但需求规划、代码评审、测试和部署等流程仍然需要人来完成,因此整个系统的吞吐能力反而被这些环节限制。
2. 原有的控制机制开始与现实脱节,并最终变得难以执行
传统的流程控制机制开始无法适应新的开发方式。
例如:
逐行人工审查代码
过去这是合理的,因为代码是由人一行一行写出来的。
但当 AI Agent 已经能够生成大部分代码变更(diff)时,人工逐行审查就无法跟上代码产生的速度。
换句话说,代码生成速度发生了数量级提升,但代码审核机制仍然停留在过去。
3. 治理成本不断上升
企业的治理成本也会增加,因为各种例外情况仍然需要按照传统流程,提交到:
会议;
审批委员会;
跨部门评审机制。
而这些会议往往每周甚至每月才召开一次。
因此,当 AI 将代码生成速度大幅提升之后,如果企业仍然使用传统的审批和治理机制,就会出现一个明显的问题:
代码生产速度已经进入“机器时代”,但组织流程仍然停留在“人工时代”。
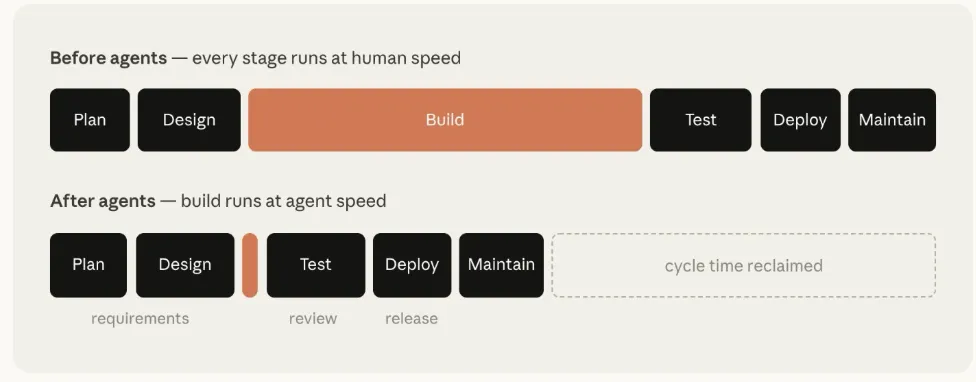
构建环节已不再是瓶颈,真正的制约来自其周边需按人力节奏推进的步骤。
以安全瓶颈为例,安全团队按人类产出规模配置人员,当智能体使代码产出倍增,评审队列会变长或代码审查不足就上线,受监管组织无法接受,故安全和策略检查须跟上智能体节奏。为更好实现智能体 AI 的效率提升并确保安全,传统 SDLC 生命周期需像开发实现环节一样接受系统性改造。
时保持不变,而构建环节已压缩至数小时。
什么是 AI 原生 SDLC?
AI 原生 SDLC(AI-native SDLC) 是一种重新构想的软件开发流程,它将传统 SDLC 中原有的控制目标(control objectives)与新的执行/管控机制(enforcement)结合起来。
与传统 SDLC 的线性流程不同,AI 原生 SDLC 将整个开发过程变成一个闭环(loop),并在每一个环节中嵌入 AI。
AI 原生 SDLC 推动自动化的工作交接(handover)以及对后续流程的自动触发(triggering),从而解决传统 SDLC 各阶段之间依赖人工交接、流程繁琐且效率低下的问题。
你也可能会听到人们使用以下不同的名称来描述这一变化:
Agentic SDLC(智能代理驱动的软件开发生命周期)
AI SDLC
Agentic Software Development(智能代理驱动的软件开发)
虽然这些名称有所不同,但它们描述的本质是同一种软件开发模式的转变。
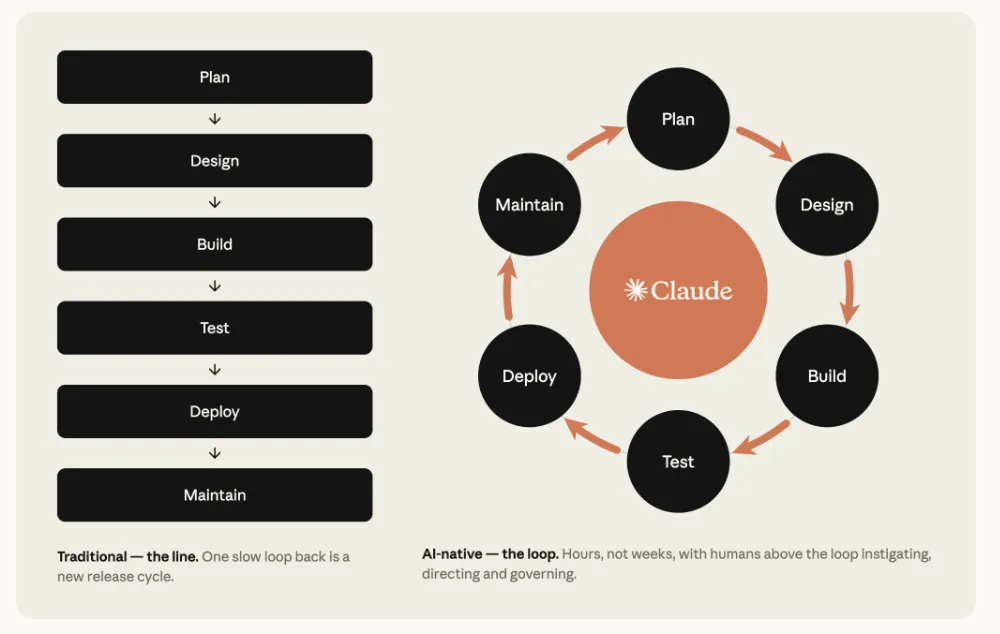
AI 原生 SDLC 六个阶段的变化
下表展示了传统 SDLC 与由 Claude 支持的 AI 原生 SDLC 两个极端状态之间的差异。大多数组织实际上处于这两种模式之间。
| Plan 规划 | intent.md 中;该文件既便于人阅读,也能够被机器执行 | |
| Design 设计 | ||
| Build 构建 | CLAUDE.md 文件和 Skills 进行维护 | |
| Test 测试 | ||
| Deploy 部署 | ||
| Maintain 维护 | intent.md |
右侧 AI 原生 SDLC 的核心贯穿着一个概念:已提交并版本化的工作成果(committed artifact)。
每个阶段结束时,都会将一个成果写入版本控制系统,包括:
intent.mdspec.mdplan.md代码 diff 及其测试
包含 Review 结果的 PR
Incident Record(事件记录)
下一阶段则从读取上一个阶段的成果开始。
在早期阶段,.md 文件是主要成果形式,因为产品负责人和 Agent 都能够读取同一个文件,并基于它采取行动。从 Build 阶段开始,成果主要变成代码及其相关记录。
整个 Commit 链同时也是一条审计轨迹:
谁提出了什么需求 → Agent 产生了什么 → 谁进行了批准。
对于所有需要判断的决策,人类仍然承担最终责任。
在 Agentic SDLC 中,人的关注点会随着需要审查的成果发生转移。
每个阶段都会提交一个下阶段可以读取的成果。intent、spec、plan、diff 和 review findings 共同构成完整的审计记录。
Plays:六个核心实践
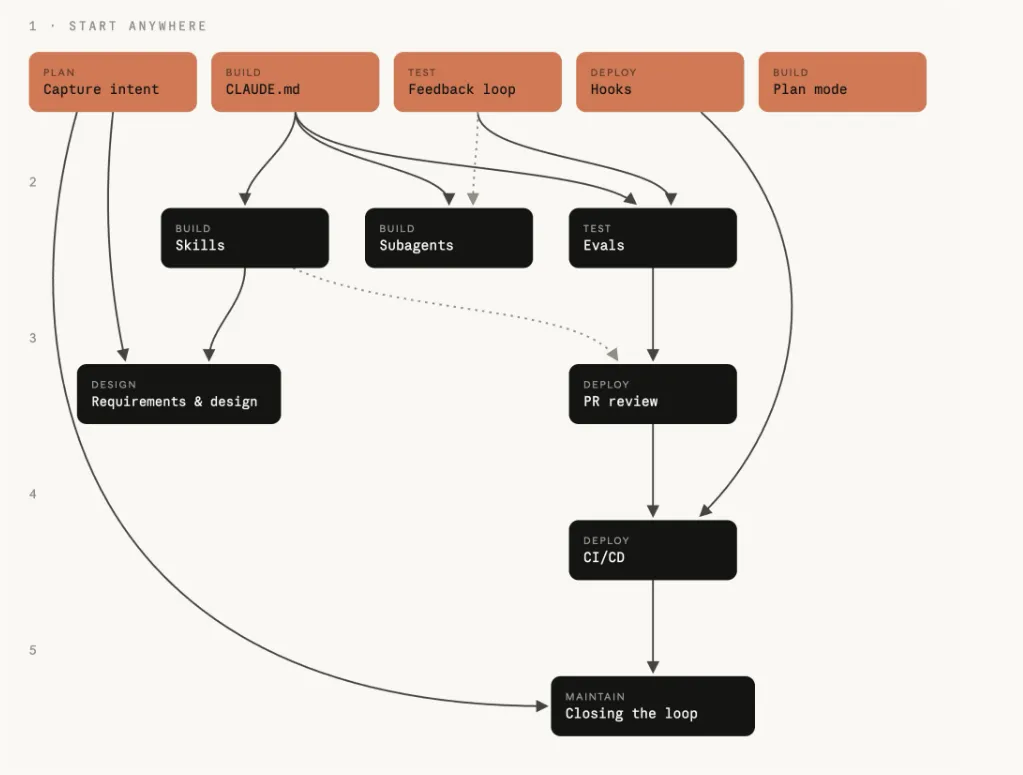
这些 Plays 是整个实践指南的核心,被划分为六个非线性的阶段:
Plan → Design → Build → Test → Deploy → Maintain
六个阶段共同覆盖完整的软件生命周期。
每个 Play 都包括:
发生了什么变化;
如何开始;
具体实施步骤;
治理方面的考虑;
如何衡量是否有效。
这些步骤是模块化的。不同组织可以根据自身需求,在不同时间优先改造不同阶段。
每个 Play 都会在 Prerequisites(前置条件) 中说明依赖关系,而依赖关系图进一步展示这些依赖。
一个阶段结束时,会提交一个成果,而这个 Commit 会触发下一个阶段。
例如:
接受
intent.md→ 触发需求与设计阶段;批准
spec.md→ 触发 Plan Mode;Merge PR → 触发 Pipeline;
生产环境中的控制区间被突破 → 生成新的
intent.md;
于是整个流程重新进入循环。
最开始,这些步骤需要人工逐个触发。最终目标则是形成一个闭环:
每一个被接受的成果,都自动触发下一个 Gate。
人的注意力集中在这些 Gate 上,重点审查 Agent 标记出来的问题,而不是每次都从零开始执行一个完整阶段。
01 Plan —— 规划
过去,一个想法需要等待某个人把它正式写出来。
AI 原生 SDLC 中,Intent 只需要被捕捉一次:使用提出者自己的语言,将其保存为一个版本化成果,供下一阶段直接使用。
Capture as intent.md
启动软件开发流程的 intent.md 可以来自不同入口:
某个人产生了一个想法;
创建了一张 Ticket;
监控系统通过 Alert 发现了一个 Incident。
当一个人产生想法时,他可以与 Claude 进行头脑风暴,并形成一个 Markdown Proto-spec。
传统 SDLC 中,这个人随后还需要找到产品团队成员,与其一起或者让其代为正式整理这个想法。
而 Claude 生成的 Proto-spec:
人可以阅读;
可以进行版本控制;
下一阶段可以立即使用。
这个 Proto-spec 被保存为 intent.md。
无论 Intent 是来自事件触发还是 Agent,流程都是一样的:
产品负责人必须在提交之前审查并修正 Agent 编写的
intent.md。
Traditional:传统方式
一个想法需要经历:
Backlog → User Story → Story Point → Refinement Meeting → Engineering
在每一次交接过程中,责任都会发生转移,因此最终到达工程团队的信息,可能已经与最初提出者的真实意图相差了好几层。
AI-native:AI 原生方式
提出者与 Claude 进行头脑风暴,并将结果直接写入 intent.md。
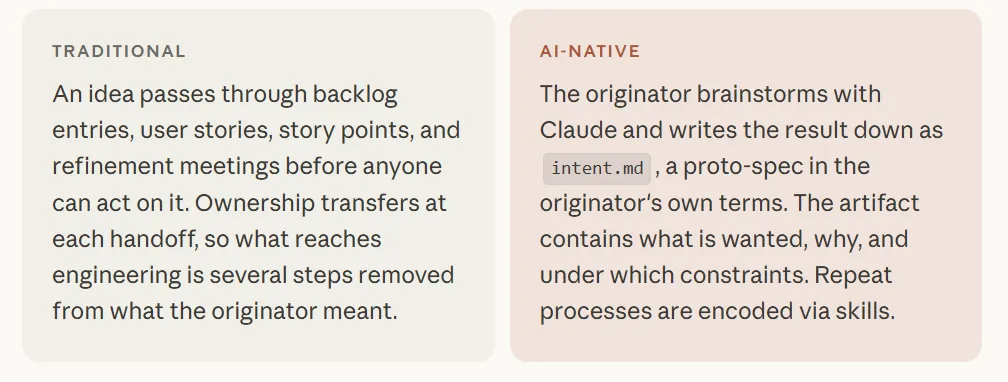
它是一份使用提出者自身语言编写的 Proto-spec,包含:
想要实现什么;
为什么需要它;
有哪些约束。
重复性的流程则通过 Skills 进行编码。
如何开始?
Prerequisites:无。
基础设施:
需要:
为非工程人员提供 Claude 访问权限;
一个统一的
intent.md模板;一个共享、版本化的 Intent 存储位置。
对于单个产品,最简单的方式是在产品 Repo 中建立:
intent/
这样可以让整个成果链与由它产生的代码处于同一个位置。
如果 Intent 跨越多个 Repo,才值得考虑单独建立 Intent Repo;如果使用 Monorepo,则可以直接使用其中一个目录。
平台或工程团队只需要一次性完成这项设置。
一旦 Repo 建好,没有 Git 使用经验的人员也不需要直接操作 Git,可以通过 GitHub Connector,让 Claude 从 claude.ai 或 Cowork 代表他们提交 Markdown 文件。
如何执行
1. 提出者用自己的语言向 Claude 描述问题。
2. 与 Claude 进行头脑风暴,直到想法足够具体。
3. 要求 Claude 按组织模板生成 intent.md。
4. 提出者纠正 Claude 理解错误的地方。
5. 将 intent.md 提交到共享位置。
Governance 治理
最重要的证据就是已经 Commit 的 intent.md。
它包含:
作者;
时间戳;
完整修改历史。
产品负责人进行批准,接受或拒绝的结果通过 Merge 或关闭 Review 来记录。
如何衡量
领先指标:
从第一次对话到 intent.md 被提交的时间。
目标是从原来数周的需求收集与 refinement 周期缩短到数小时。
滞后指标:
intent.md 的接受率,即有多少 Intent 被产品负责人接受并进入 Design 阶段,而不是被关闭。
同时观察在同一变更的第一个 spec.md Commit 之后,intent.md 是否还发生大量修改。
02 Design —— 设计
在 AI 原生 SDLC 中,需求和设计合并成一次工作会话。
策略不是在几周后的 Review 中才被发现,而是在编写 Spec 时就直接应用。
Requirements and Design
产品负责人批准 intent.md 后,Claude 将其转换成需求和设计规格说明。
这个过程受到组织 Skills 的指导,包括:
品牌规范;
安全;
合规;
UX。
产品负责人负责 Review Spec,但不再亲自编写 Spec。
目标是形成一份工程团队可以直接据此制定 Plan 的 Spec,并明确标记潜在问题。
对于前端开发,这是最明显的例子:
intent.md 被接受后,产品负责人可以使用 Claude Design 根据 intent.md 创建 Mockup,不断迭代,然后导出给 Claude Code 进行开发。
Traditional
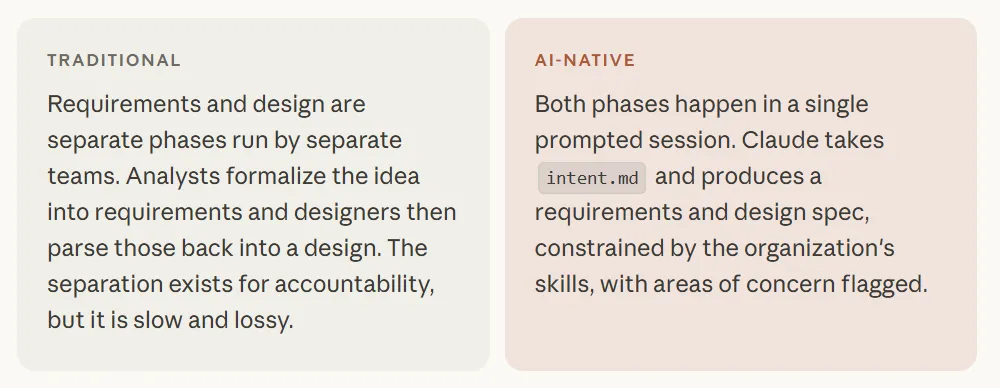
需求和设计是两个独立阶段,由两个不同团队负责。
分析师将想法正式化为需求,设计师再将需求解析为设计。
这种分工有利于责任追踪,但速度慢,而且信息会发生损失。
AI-native
两个阶段发生在同一个 Prompt Session 中。
Claude 读取 intent.md,生成需求和设计 Spec,同时受到组织 Skills 的约束,并标记潜在问题。
如何执行
产品负责人开启一个拥有组织 Skills 的 Claude Session,并附上
intent.md。Prompt 指向
intent.md,明确约束条件,并要求标记风险。产品负责人根据原始想法 Review Spec。
优先解决 Claude 标记的问题。
将
spec.md与intent.md一起 Commit。产品负责人决定是否进入 Build;高风险事项需要咨询技术负责人。
Governance
传统方式是在几周后的 Review 中才发现政策问题。
AI-native SDLC 则是在 Spec 编写时直接读取并应用当前政策。
Spec、生成它的 Prompt 以及当时生效的 Skill 版本全部进入版本控制。
03 Build —— 构建
没有经过接受的 Plan,就不能开始实现。
组织知识被转化为 Agent 可以读取的文件,而 Guardrails 则从“团队习惯”变成真正运行的代码。
Claude Code Plan Mode 成为默认起点
工程师在 Claude Code 中进入 Plan Mode,将 Design 阶段批准的 spec.md 提供给 Claude。
Claude 可以询问工程师问题,并不断迭代 Plan,直到工程师满意。
Traditional
工程师读取设计,然后开始写代码。
具体如何实现:
哪些文件需要修改;
修改顺序;
使用哪些测试;
通常都存在工程师自己的脑子里,最多写在 Ticket Comment 中。
Reviewer 第一次看到完整计划时,往往已经是最终 Diff,到了这个时候再返工就非常慢。
AI-native
工作从一个书面化 Plan 开始。
Claude 在 Plan Mode 中可以读取整个代码库,但不会修改任何内容。
工程师先修改和批准 Plan,然后将其保存为:
plan.md
后续阶段可以基于它进行检查。
如何执行
工程师以 Plan Mode 开始 Claude Session。
提供
intent.md和spec.md。要求 Claude 给出实现计划,包括:
修改哪些文件;
工作顺序;
如何测试。
询问:
什么可能被破坏?
哪一步风险最大?
Claude 放弃了哪些其他方案?
迭代 Plan。
将批准后的 Plan 保存为
plan.md。接受 Plan 后让 Claude 开始实现。
如果实现偏离 Plan,同时更新
plan.md。
Claude Code Auto Mode
Claude Code 还可以运行在 Auto Mode。
工程师批准 Plan 后,Claude 可以自动执行修改,而不需要每次修改都等待人工 Prompt。
随着后续 Guardrails 越来越成熟:
调优后的
CLAUDE.md编码组织政策的 Skills
阻止不安全操作的 Hooks
Claude 可以运行的测试套件
对于以下类型的常规工作,Auto-accept 可以成为默认方式:
spec.md清晰;影响范围小;
已有测试能够覆盖代码。
这意味着人的角色发生变化:
从“盯着 Agent 一次次修改代码”,转变为“在更长时间的自主运行之后审查成果”。
结合 Git Worktrees,Auto-accept 还能够让个人和团队同时运行多个并行任务。
Legacy Systems:遗留系统与唯一事实来源
传统 SDLC 已经拥有很多成果记录,只不过不一定是 Markdown:
Jira 中保存 Work Item;
Requirements Tool 中保存需求;
Figma 中保存设计;
Change Board 中保存变更审批。
这些系统很难被完全替代,因为:
审计员已经认可;
监管机构已经认可;
其他团队仍然依赖这些系统。
因此 AI-native SDLC 必须与现有系统共存。
对于每一个成果,需要指定一个唯一事实来源(Source of Truth)。
主要有三种模式:
1. Repo 作为 Source of Truth
Markdown 文件是权威记录,Legacy System 只引用 Commit 中的文件。
2. Legacy System 作为 Source of Truth
例如:
Jira
ServiceNow
Requirements Tool
这些系统保存权威记录,而 Markdown 作为工作副本。
Claude 在 Session 开始时读取记录,并通过 MCP 将结果写回原系统。
3. Linkage 作为最低要求
所有成果记录 Record ID,同时 Legacy Record 保存 Markdown 文件的 Commit SHA。
在迁移过程中,这是一个不错的起点。
Legacy System 和 Markdown-first System 可以并存,只要:
两者之间存在链接,或者明确声明其中一个是 Source of Truth。
CLAUDE.md:组织知识的载体
CLAUDE.md 提供一个新员工加入团队时需要了解的上下文,包括:
开发规范;
命令;
架构;
团队最常见的错误。
过去存在于人的大脑和 Wiki 中的知识,现在变成 Agent 每次 Session 开始时都可以读取的文件。
团队共同维护它,并在出现错误时不断更新。
一个核心规则是:
Claude 犯同一个错误两次,就应该把纠正方法写入
CLAUDE.md。
同时建议保持简短,最好控制在一页以内。
Skills:把组织知识变成可执行能力
Skills 是组织将制度性知识(institutional knowledge)转化为可执行规则的方式。
这些指令:
明确;
版本化;
广泛应用;
可以集中更新。
一个简单原则:
需要组织持续一致执行的知识 → Skill。
而属于具体 Repo 工作上下文的内容,则应该放在 CLAUDE.md。
如何执行
找出目前执行不一致的一项知识,例如安全标准。
将它写成 Skill。
放入
.claude/skills/<name>/。测试 Skill 是否能够正确触发。
政策变化时更新 Skill。
工程师下一次 Session 自动获得新版本。
Skill 本身是一种建议性控制(advisory control)。
如果某项政策必须 100% 执行,就需要在 Skill 后面增加确定性的机制:
Skill 让违规变少,Hook 让违规接近不可能。
Hooks:Build 阶段的 Guardrails
Skill 是建议性控制,而 Hook 是背后的确定性控制层。
Build 阶段大量操作都是:
文件编辑;
Shell Command。
因此 Hook 可以在这里发挥非常大的作用。
Build Hook 可以:
阻止修改受保护路径;
自动运行 Formatter 和 Linter;
防止 Credentials 出现在 Diff 中。
如果某项政策必须无条件满足,就应该使用 Hook。
但是:
需要人工批准的 Hook 应该放在 Deploy 阶段,而不是 Build 阶段。
否则每次 Agent 操作都需要人批准,会重新把人放回所有并行 Session 的关键路径。
Parallel Sessions & Subagents
一个工程师可以同时驱动多个工作流。
Parallel Session:
每一个都是一个完整的 Claude Code 实例,在独立 Git Worktree 中处理独立任务。
Subagent:
在一个 Session 内运行的辅助 Agent,拥有自己的 Context Window 和 Tool 限制。
Traditional
一个工程师一次处理一个任务。
AI-native
一个工程师同时运行多个 Claude Session,每个 Session:
一个独立 Worktree;
一个独立任务。
重复性任务可以变成 Subagent。
工程师的工作逐渐从:
写代码 → 协调多个 Agent → 最终构建和监控整个 Loop
04 Test —— 测试
每个 Session 都应该在人工看到成果之前自己验证自己的工作。
同时,驱动 Agent 的配置本身也需要像代码一样接受回归测试。
给 Claude 一个 Feedback Loop
始终给 Claude 一种验证自己工作的方式,例如:
测试;
Build;
Screenshot Diff。
Claude 应该在工程师看到结果之前:
自己检查 → 发现问题 → 自己修复。
传统模式中,代码是否正确的信号通常来得很晚:
CI 几分钟后 → Tester 几天后 → Production 几周后
当 Agent 大量生成代码时,这种延迟意味着一个人必须检查 Agent 的全部输出,于是这个人变成新的瓶颈。
AI-native 模式则是:
Agent 写 → Agent 测 → Agent 修 → 人 Review
Continuous Evals in CI
Evals 是 AI-native SDLC 中与传统 Stage-gate QA 对应的机制。
它本质上是一套持续运行的测试:
当模型、Prompt、Skill、Hook 等配置发生变化时,Eval 判断 Agent 是否仍然能够以同样标准完成任务。
Evals 应该是一个不断更新的实时测试套件。
随着模型能力提高:
原来的测试案例可能不再具有区分度;
需要不断加入新的案例;
每一个生产 Incident 都应该转化成一个新的 Eval。
因此:
Production Incident → Eval → Regression Test
05 Deploy —— 部署
Review 同时向两个方向运行,治理机制在 Agent 执行动作时直接实施。
核心原则:
Agent 可以执行到 Production Gate,但不能通过 Production Gate。
AI 进入 PR Review Loop
Claude 同时可以:
Review 别人的 PR;
Review 自己创建的 PR;
根据 Review Comment 自动修改自己的 PR。
这样工程师可以把注意力集中在:
Intent 和 Risk
而不是逐行检查代码。
Traditional
PR Review 能力按照人的速度规划。
PR 等待 Reviewer,Review 质量受到 Reviewer 工作负荷影响。
AI-native
所有 PR 都得到一致的 Review Pass:
Bugs;
Security;
Compliance。
并按照 Severity 排序。
人的关注点上移:
这个变化是否实现了 Plan 中的目标?风险是否可接受?
Hooks 作为 Approval Gates
Build 阶段的 Hook 可以允许或阻止 Agent 行动。
在 Deploy 阶段,Hook 还可以:
暂停 Agent,等待指定人员批准。
这就是 Release Gate。
例如:
Change Management Approval;
Release Authorization;
修改受保护路径。
Hook 每次都会执行,并且:
Allow;
Ask;
Block
都会被记录。
CI/CD Integration and Deployment
AI-native SDLC 中,Claude Code 可以:
在 CI/CD Pipeline 中非交互运行;
在 Sandbox 中运行;
通过 MCP 接入 Deployment Tool;
执行部署;
执行 Rollback。
Traditional
Pipeline 执行确定性脚本。
任何需要判断的事情都需要人工处理,例如:
判断 Flaky Test;
编写 Changelog;
判断 Build 为什么失败。
AI-native
Claude 在 Pipeline 中处理这些需要判断的工作。
Deployment Tool 通过 MCP 暴露给 Agent,因此:
负责编写和测试代码的 Workflow,也可以在组织规定的 Gate 内完成部署和回滚。
自主程度可以按照环境分级:
Rollback 应该是 Pipeline 中最经过演练的路径。
06 Maintain —— 维护
Loop 在这里闭环。
Trigger 可以在没有人参与启动的情况下调用 Claude。
Claude 发现的问题重新进入 Pipeline,并形成新的:
intent.md
Maintenance & Closing the Loop
前五个阶段主要讨论如何将 Claude 引入 SDLC 的各个阶段。
但第六阶段发生一个关键变化:
Claude 开始自主运行,整个 SDLC 真正形成闭环。
例如:
一个持续运行的 Monitoring Agent 发现 Bug Ticket:
监控 → Intent → Requirements → Plan → Build → Test → Review → Deploy
第六阶段可以完全 Headless 运行。
阶段之间设置独立的 Confidence Gate:
Deterministic Check;
Adversarial Review Agent;
Human Escalation。
Traditional
Maintenance 是一个 Reactive Phase。
Alert 出现后等待人处理。
凌晨 3 点的 Alert 可能被错过;Ticket 可能一直躺在 Backlog;Post-mortem Action 甚至可能最终没有进入代码库。
AI-native
任何 Trigger 都可以调用 Claude:
Control-band breach;
Ticket;
Slack/Teams Message;
Schedule。
Claude:
Diagnose;
通过 Gate 执行操作;
生成
intent.md;重新进入 Stage 1。
人类负责:
Triage + Review
而不再负责“启动整个流程”。
自主闭环的一个例子
一个确定性的监控脚本持续观察生产环境。
当某个 Control Band 被突破时:
Monitoring → Claude → Diagnosis → intent.md → Plan → Build → Test → Review
检测本身保持 Deterministic:
Detection 不使用模型;模型只在控制区间被突破后被调用。
例如:
1:只记录;
2:Claude 只读诊断;
3:Claude 可以采取行动,但只能:
创建 PR;
触发预批准 Runbook。
Recurring Codebase Scans —— 周期性代码库扫描
传统安全扫描通常是一次性的:
扫描 → 报告 → 人工处理 → 下一次扫描
问题在于:
代码每周都在变化;
新一代模型能够发现上一代模型没发现的漏洞。
AI-native 方法是:
定期自动扫描,不需要人工启动,并将发现结果通过与其他代码变更相同的 Gate。
每一个 Finding:
小型修复 → PR → Review Gate;
大型问题 →
intent.md→ Stage 1 Plan。
这样安全覆盖率根据最近一次扫描时间计算,而不是根据第一次扫描时间。
Claude Tag:让 Claude 参与 On-call
Incident 还可能来自:
Slack;
Teams;
Ticket;
工作沟通渠道。
例如晚上 10 点,Incident Channel 中出现一个紧急修复请求。
Claude Tag 可以让 Claude 以自己的身份加入 Channel。
因此每一个 Incident 都有一个:
First Responder
Claude 可以:
阅读历史;
诊断问题;
测试假设;
探索解决方案;
通过 MCP 验证指标是否恢复;
将 Post-mortem 写入版本化 Lessons 文件。
整个 Channel 本身就是 Audit Trail:
Request → Diagnosis → Human Authorization → Fix
模型和 Agent Harness 已经变得越来越先进。
这使企业能够改变的不再只是:
如何生产代码
而是:
整个软件开发生命周期。
这种转型仍然将:
Human Judgment(人类判断)
放在流程核心,同时考虑大型企业所需要满足的:
治理;
安全;
合规;
监管要求。
这份指南总结了 Applied AI 团队每天为客户实践的大量经验。
最终目标不是让 AI 完全取代人。
而是:
让 AI 运行整个 Loop,而人类的判断始终位于 Loop 之上。
最终的 AI-native SDLC
可以把整个理念浓缩成:
传统 SDLC:
Plan → Design → Build → Test → Deploy → Maintain
每个阶段:
人完成 → 人交接 → 人审批 → 人启动下一阶段
而 AI-native SDLC 变成:
Intent → Spec → Plan → Code/Test → Review → Deploy → Monitor
并形成:
Artifact → Gate → Artifact → Gate → Artifact → …… → Incident → 新 Intent
其中:
AI Agent 负责执行
Artifacts 负责传递上下文
Skills 负责组织知识
Hooks 负责确定性控制
Evals 负责持续验证
Git/PR 负责审计
Human 负责判断和最终授权
因此,AI-native SDLC 的本质并不是:
“让 AI 写更多代码。”
而是:
“重新设计整个软件开发操作系统,使 AI Agent 能够在治理框架内自主推动软件从 Intent 一直走到 Production,再从 Production 的反馈重新回到 Intent。