ARTICLE · 993187
202609关于关键样本线的若干补充说明
一、关键样本线是你个人独立提出的吗?
是的。笔者本人原名杨业昊,身份证号310XXX19990916XXXX,2026年教育部认定的上海市高中数学教师,证书号码2026310XXXXXXXXXX。
笔者金融从业期间笔名金谷笛;现从教高中数学,笔名齐锻烨,寓意“不怕苦累,和各位学生、各位老师一起锻打出青春绚烂之花”,也和本公众号的主要任务相一致,请见:
2020年春,笔者时年约21岁,恰逢疫情,便独自琢磨了一些东西——关键样本线只是其中最有价值的一部分。笔者当初做此研究,本为华东师范大学大夏杯竞赛努力,不幸在学院内落榜,甚未曾得鼓励奖。后尝试投稿,幸得统计学院金融工程系吴老师的认可,但最终笔者因没能找到合适的实证问题,遂自己放弃,终未能帮助自己成功推免保研。
两岸猿声啼不住,轻舟已过万重山。多年已过,终是善因得善果,回首往日情景,起起伏伏,仍历历在目。今以此系列研究与我学生、同事分享,旨在锻炼学生独立思考探究问题的胆识,与同事共同进步,也算实现了我当年研究的一点价值,聊以慰籍。正是:
当年春江万户封,蓬窗独坐守微灯。
千回点画抽玄缕,无人知有此年轻。
已惯蝇头书咄咄,凝神屏思暗自成。
浮霾蔽日天如墨,不见青山不见晴。
雨打青萍风卷絮,黄钟毁弃瓦釜鸣。
终教长夜吞星去,拂衣了断旧缰行。
今携后学开新胆,并与同侪共远征。
若问寒窗何所证,满襟星火照群英!
二、关键样本线是对“拟合得好的样本元素”的刻画吗?
这样的理解是不准确的。
关键样本线方程其实是在找那些“加入或删除会对相关系数造成最大影响,从而对‘贝塔系数通过t检验与否’构成最大影响”的样本元素,具体推导请见:
什么样的样本会对贝塔系数的显著性起到“极大”的影响?——原创数学概念关键样本线的提出
给定变量X、变量Y的一个样本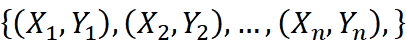 ,关键样本线方程如下:
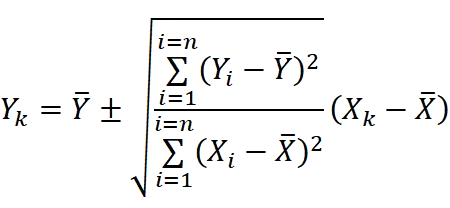
式中,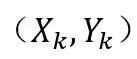 为满足关键样本线方程的样本元素取值,不一定指代真实的样本元素。满足这一方程的样本的“加入或删除”会对相关系数造成最大影响,从而对“贝塔系数通过t检验与否”构成最大影响——越“靠近”该方程取值的样本元素对的显著性来说越“不可或缺”。
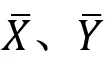 指代样本中X、Y各自的平均值(算术平均数)。
n为样本容量。
三、对运用OLS线性回归做实证研究的警醒
关键样本线方程揭示了,并非所有样本点都对统计显著性做出同等贡献。只要样本中存在大量靠近这两条“关键样本线”的观测值,即便整体变量之间完全独立,统计量也会在超大样本下被这些关键样本“绑架”,从而轻易落入拒绝域。
关键样本线方程说明,如果学者为了追求R²或贝塔系数的显著性,完全可以剔除所谓“极端值”,而这样的操作实际上很可能把真正的随机证据错误地剔除掉了,只留下人为的结构假象。或者,如果一篇论文的总体样本(10000例)不显著,研究者常会做亚组分析(如分年龄段、分地区)。这相当于在数据中寻找不同的“关键样本线”。而关键样本线的核心警示正在于此——只要有约20%的特定子样本恰好落在极值影响区域内,研究者便有能力通过样本切割或亚组筛选,使整体结论“起死回生”。
在实证研究的标准化流程中,缺失值插补与极端值清洗往往被视为“数据预处理”这一无关痛痒的技术环节。然而,关键样本线揭示了,任何对样本元素的遗漏、删减、增加或替换,都可能改变样本元素相对于关键样本线的位置,也即:这样的操作不仅改变了样本容量,更在不知不觉中篡改了样本点相对于“关键样本线”的分布。
如果在数据预处理过程中使用了“均值/中位数插补”(Mean Imputation),即将缺失值替换为中心趋势量(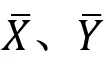 ),实质上是向数据集中人为注入大量位于两条关键样本线交点(
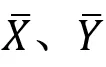 )附近的点。这些点虽然不改变协方差的分子(
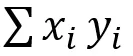 贡献为0),但显著增大了样本量。根据t统计量绝对值的推导式:
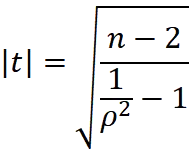
即使样本相关系数因插补而略有稀释,膨胀后的仍会使上式增大,从而更容易落入拒绝域,使得原本不显著的弱相关错误地越过显著性门槛。
更可怕的问题在于,数据预处理通常仅以文字形式说明处理方式,而不会像回归结果那样在论文中详细披露。这使得缺失值处理成为研究者自由裁量权最大的“灰色地带”——通过更改插补方法或清洗阈值,完全可以在不触碰原始显著结果的前提下,反复调试直至获得期望的p值。也就是说,关键样本线方程揭示了,对于大量缺失的数据集而言,数据清洗并非中立的“去噪”,而是在无形中对样本进行了“选择”——若清洗后的样本分布恰好偏向于这两条极值影响线,则后续所有显著的回归结论,都可能只是数据预处理步骤的人为结果。