ARTICLE · 994481
20 毫秒,让 PDF扫描件开口说人话,免费开源OCR神器快了近500倍
复制即乱码,只能一页页手敲?
20 毫秒,让扫描件
开口说人话
OCR It · 完全离线 · 免 API Key · 浏览器插件
Firecrawl 团队出品 · GitHub 已开源
📦 4 Parts + Conclusion
👉 滑动
PART 01
快到没感知
20ms 与 300 倍
PART 02
三分钟上手
手动档与自动档
PART 03
四个自动刹车
不会跑飞
PART 04
别急着梭哈
还啃不动的骨头
PART ///
写在最后
墙变成了门
关于 PDF,我们几乎都经历过这三件事——
复制即乱码、AI 读不懂、手敲到崩溃,这三种死法终于被一次性埋了
先别急着要链接,我们把伤口撕开看看。
第一种死法,复制即乱码。你选中一段文字按下 Ctrl+C,粘贴进 Word,出来的却是方框、空白和莫名其妙的断行。扫描版更绝——它压根不让你选,因为里面根本不是文字,是一整张图片。
第二种死法,AI 读不懂。你好不容易把字抠出来塞给大模型,它回你一句“内容似乎不完整”,或者一本正经地胡说八道。问题不在模型,在你喂进去的那一坨:没有标题层级、没有段落结构、表格早已散架。
第三种死法,人肉重敲。前两种死法逼到最后,只剩这一个办法。敲到第 47 页的时候,你会开始认真思考人生的意义。
而最近刚刚开源的一个工具,把这三种死法,一次性埋了。
01
PART
20 毫秒,快到你没感知
SPEED · 快了近 300 倍
它叫OCR It,出自Firecrawl 团队——那个被 Y Combinator 孵化、专门做网页抓取的明星项目。联合创始人兼 CTO Nicolas Camara 这次放了个大招。
把一份不可复制的 PDF里的所有文字提炼完、转成干净的 Markdown,只要 20 毫秒。
20 毫秒是什么概念?你刚点完确定、还没眨完眼,一份处理好的 Markdown 就已经清清爽爽躺在那儿了,而且是 AI 读完马上能懂的那种格式。
更狠的是对比数据:作者表示,在处理质量与 Docling 基本持平的前提下,它的速度快了近 300 倍。
它靠的是内置打包的 Tesseract 引擎,100% 离线跑,不联网、不要 API Key、安装时也不索取任何网站权限。
02
PART
三分钟上手:手动档与自动档
TUTORIAL · STEP BY STEP
OCR It 是一款免费的 Chrome / Firefox 浏览器插件,装完就能用。它有两种驾驶模式,先说手动档。
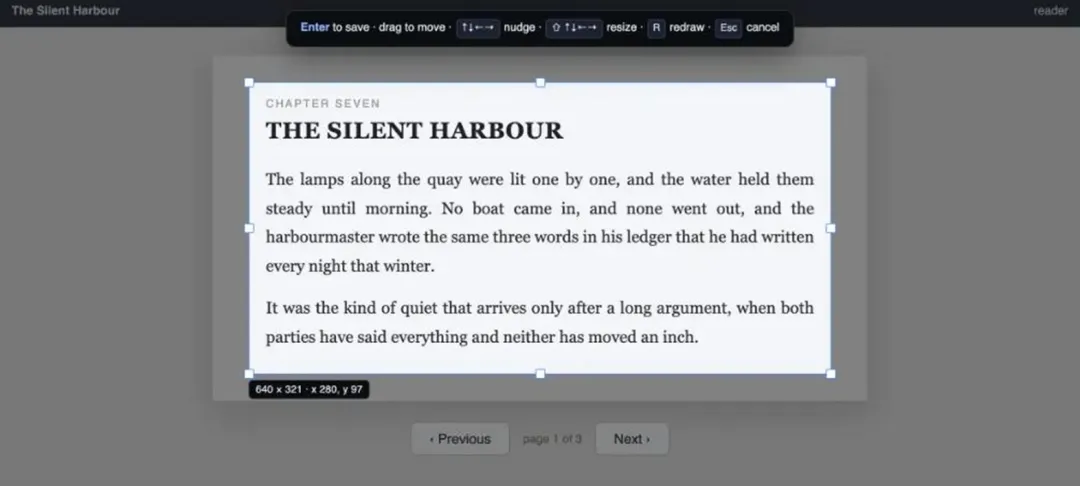
框选一次区域
框出你要识别的文字区域,回车保存。整本书、整份文档,只框这一次就够了。
CMDOption + Shift + R
!踩坑提示 🕳
Windows 和 Linux 用户请把 Option 换成 Alt,否则快捷键无效。
逐页识别,边翻边排队
按一次识别快捷键,它就识别当前页,完成后自动翻到下一页。想省时间的话,可以一边翻页一边在每页按一次——系统会立即截图,并在后台自动排队执行识别任务,完全不堵你的手。
CMDOption + Shift + S
检查与导出
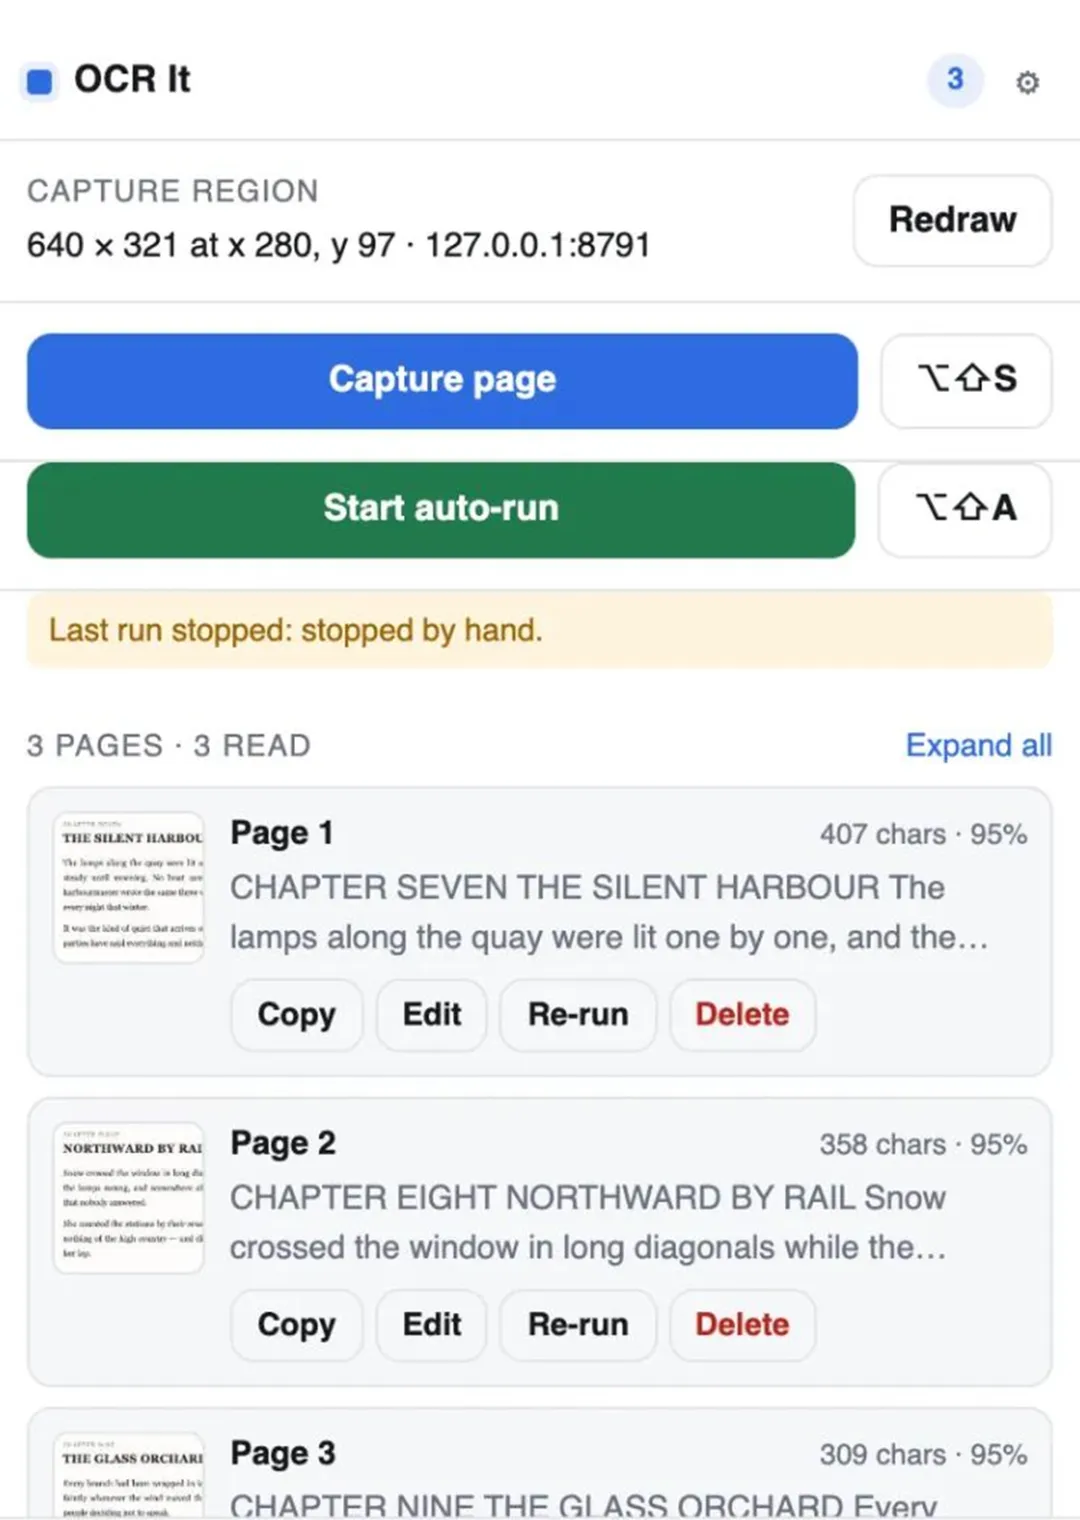
全部识别完,在插件面板里检查、修改文本,也能单独重识别某一页。最后选择Copy all或Download .txt,全文到手。
懒人模式:挂自动档
截图
自动抓取当前页
OCR
离线识别成文本
翻页
循环到文档结束
按 Option + Shift + A 或点击 Start auto-run,中途按 ESC 即停
03
PART
它比你想象中“懂事”
SMART · 四个自动刹车
自动跑最怕什么?跑到最后一页还不停,反复抓同一页,无限循环。OCR It 内置了四个停止条件,任一触发立即收工。
连续识别到两张相同页面
无法继续翻页
OCR 识别失败
达到 300 页上限
✦ 隐私这块,它做得很克制
它既不需要 API Key,也不需要联网,安装时不索取任何网站权限——只有在需要自动运行、或操作跨域 iframe 时,才会按需申请当前站点的权限。
04
PART
别急着梭哈
LIMIT · 还啃不动的硬骨头
说了这么多优点,必须给你泼一盆冷水。
网友实测下来基本形成一个共识:它目前对付版式简单、文字清晰的文档相当顺手,但遇到标题、脚注、表格、数学公式和正文段落混排的复杂页面,就容易翻车。
实战坑:浏览器内置的 PDF 阅读器暂时不支持自动翻页,处理这类文档时,老老实实用手动档。
所以正确的姿势是:简单的活儿放心交给它,复杂的活儿自己复核一遍。别把它当成万能钥匙。
///
LAST
写在最后
SUMMARY · 墙变成了门
PDF 这件事,本质上是“人类的阅读格式”与“机器的理解格式”之间的一道墙。
过去我们用人肉去翻这道墙,现在有人把墙拆成了一扇门——20 毫秒,一推就开。
工具会继续迭代,但至少从今天起,你不用再对着扫描件敲到凌晨两点了
感兴趣的话,去 GitHub 搜「ocr-it」就能找到它,欢迎回来告诉我你的实测结果。
 点击下载一人公司0-100w自由职业修订指南.PDF

 更多内容,可访问
