ARTICLE · 995621
只有一张临床Excel,医学AI论文到底怎么做?从问题卡到独立验证的7步
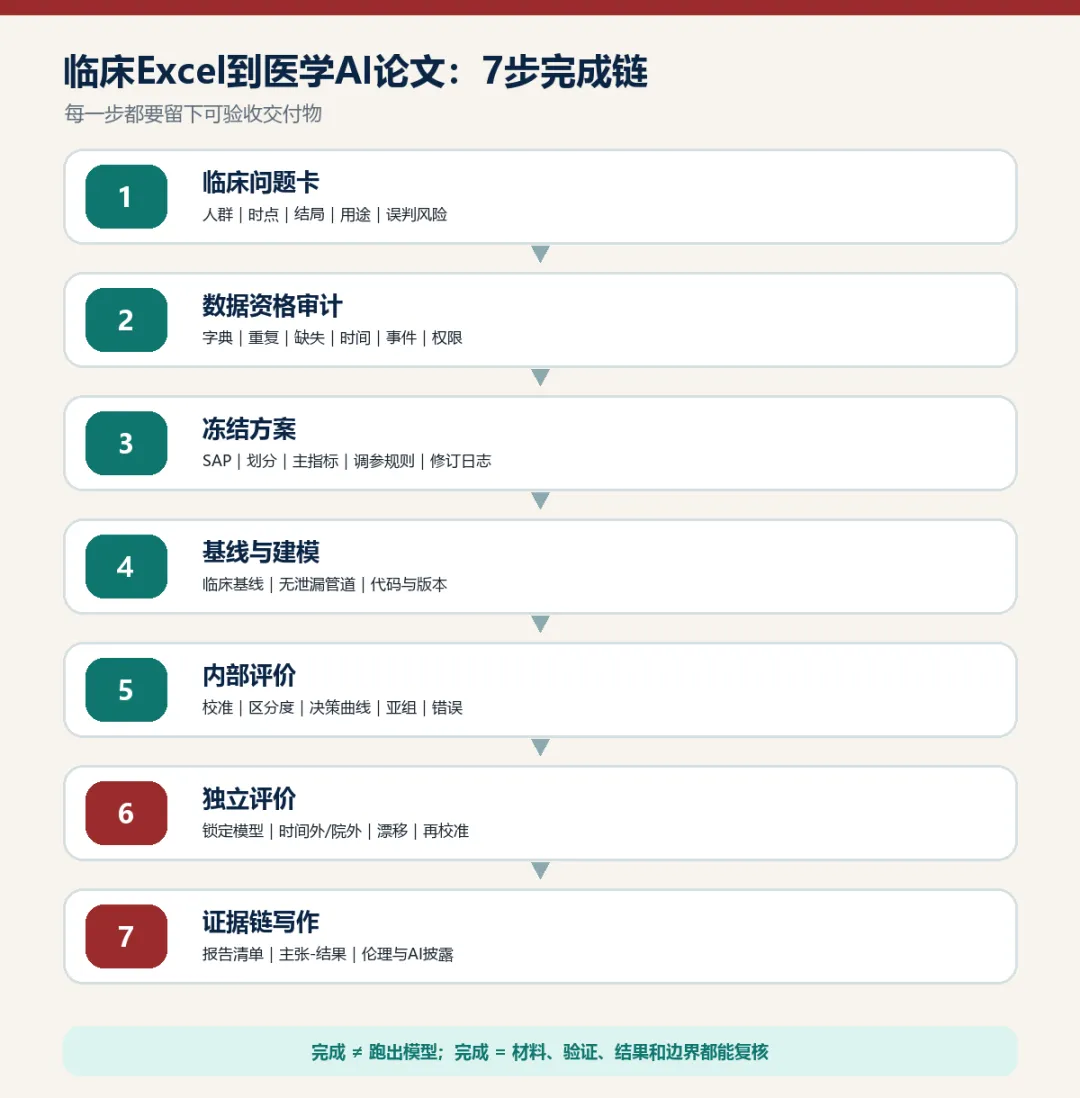
上一篇讲医学与计算机可以做哪些方向,这一篇不再重复列方向,只拆最常见的一条:一张临床Excel如何经过问题定义、数据审计、方案冻结、无泄漏建模、内部评价、独立评价和证据链写作,形成可核验的医学AI研究。
但医学AI论文最难的地方,往往不在建模。预测时点错了、结局定义不清、同一患者进入训练集和测试集、结局发生后的指标被模型提前看见……这些问题一旦存在,模型分数越漂亮,结论反而越危险。
先把方向说清楚:医学×计算机不止一种文章
这个交叉领域可以做公共数据库复现与外部评价、临床风险预测、真实世界因果分析、医学影像与数字病理、临床文本和医疗大模型评测、连续生命体征与可穿戴设备、多组学、药物警戒,以及前瞻性人机协作研究。上一篇已经讲过这些方向,今天不再换一套分类重复介绍,而是深入最常见、也最容易被做错的一条:结构化临床数据风险预测。
开始之前,先让Excel过五道资格门
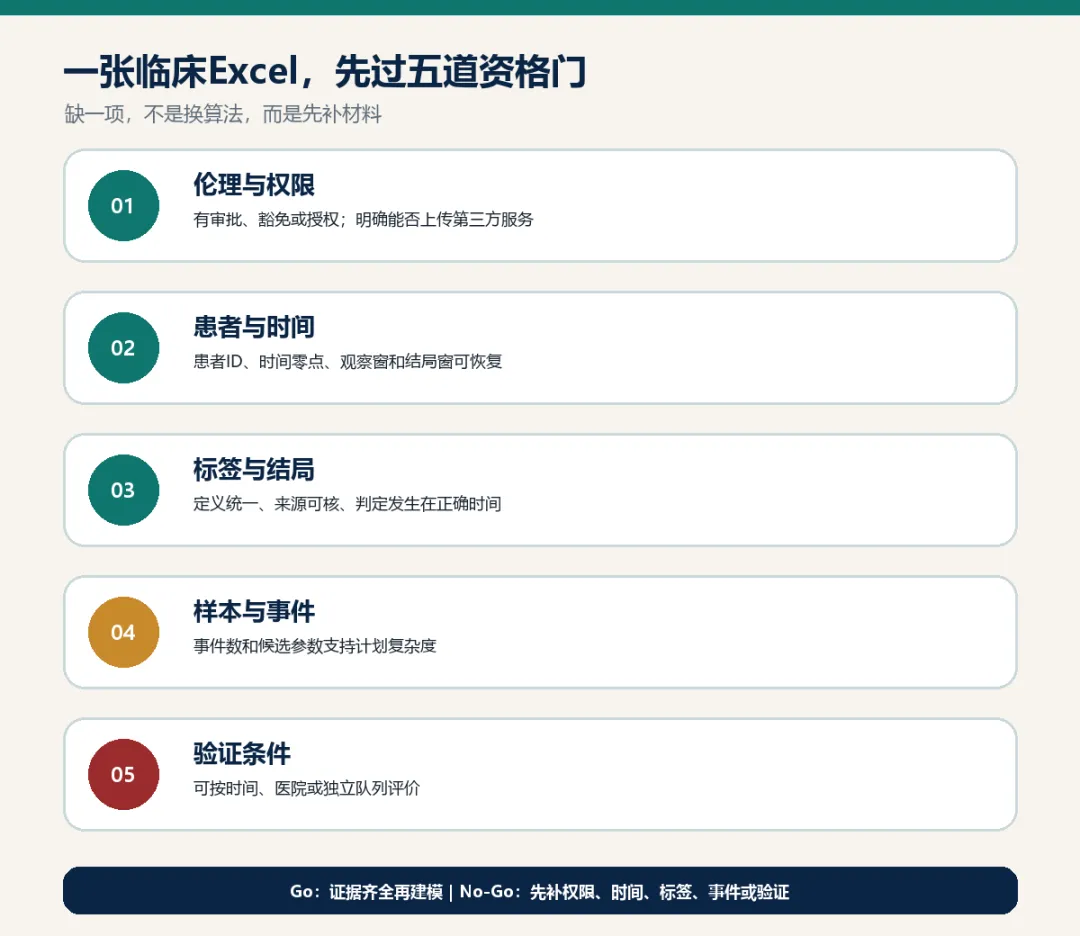
五道门分别是:伦理与使用权限;患者ID和时间零点;可靠且统一的结局;足以支撑候选参数复杂度的样本与事件;以及真正独立的时间、医院或队列评价条件。缺一项,正确动作通常不是换算法,而是先补材料、缩小问题或改变研究类型。
第一步:先写临床问题卡,不要先打开建模软件
一个医学预测模型,必须先回答:服务哪类患者、谁使用、在什么时间点使用、输入哪些当时已经能够获得的信息、预测未来多长时间内的什么结局、结果会影响哪项临床决策,以及预测错误最主要的风险是什么。
第二步:给Excel做数据资格审计
先确认一行代表一个患者、一次住院还是一次检查;再检查患者ID、重复住院、变量采集时间、结局来源、缺失含义、异常值、事件与非事件数,以及伦理和数据使用权限。空白、零、未检查和未知不能混成同一种缺失。
第三步:冻结方案,再看模型结果
正式分析前,先固定纳入排除、时间零点、预测时间窗、结局、候选变量、缺失处理、数据划分、基线模型、候选模型、主指标、亚组和敏感性分析。否则研究者很容易看完结果后不断换人群、改结局、删变量和调阈值,只留下最好看的一组。
第四步:先做临床基线,再做机器学习
先建立一个可解释的基线,例如临床常用评分、少量公认变量的逻辑回归或当前诊疗规则,再评价机器学习是否真正增加价值。数据有限时,简约回归或惩罚回归往往比复杂神经网络更合适。
第五步:内部评价不能只看AUC
AUROC反映排序能力,却不能回答预测概率是否准确,也不能回答模型是否值得用于临床决策。完整评价通常还要考虑AUPRC、敏感度、特异度、预测值、校准曲线、校准截距与斜率、Brier评分、决策曲线、置信区间、关键亚组和错误病例。
第六步:独立评价时,必须把模型锁住
独立评价可以使用后续年份、另一医院、不同地区或设备,或另一个公开数据库。开始前必须锁定变量、预处理规则、模型参数和风险计算方式;评价数据只能测量表现,不能继续参与开发。
第七步:把论文写成一条可审计证据链
论文要让读者追溯:临床问题从哪里来,患者怎样进入队列,变量何时采集,缺失如何处理,模型怎样训练,评价数据是否独立,以及每条结论对应哪项结果。TRIPOD+AI可用于核对报告完整性,PROBAST+AI可帮助审视参与者与数据源、预测变量、结局和分析中的偏倚风险与适用性。
最容易让研究失效的7个问题
看完结果后才定义研究问题;同一患者进入训练和测试;模型使用预测时点之后的信息;事件有限却比较大量变量和算法;划分数据前完成预处理;只报告最高AUC;把随机切分的内部测试写成外部验证。
AI能帮什么,不能替代什么
AI可以帮助生成代码框架、检查数据管道、整理变量字典和运行日志、复现图表、核对正文与表格、提示报告遗漏;但不能编造样本量、结局、显著性、外部验证或临床效果,不能替代临床专家、统计人员、伦理审查和真实独立评价承担责任。
这七步真正走完,得到的不只是一个模型分数,而是一项能够被核验、复现并继续验证的研究。它不能保证发表或录用,但可以减少方向错误、数据泄漏和结论越界。
来源与使用边界
TRIPOD协作组:TRIPOD+AI Statement
预测模型开发、外部评价和模型更新的透明报告|https://www.tripod-statement.org/scope/
PROBAST+AI工作组:PROBAST+AI
从参与者与数据源、预测变量、结局和分析评价质量、偏倚风险与适用性|https://www.bmj.com/content/388/bmj-2024-082505
Riley等:预测模型开发样本量方法
样本需求取决于事件比例、候选参数和预期模型性能,不能机械套固定事件数比例|https://www.bmj.com/content/368/bmj.m441
Riley、Collins等:临床预测模型外部验证
独立数据上的总体拟合、校准、区分度和临床效用评价|https://www.bmj.com/content/384/bmj-2023-074820