ARTICLE · 996290
企业AI工具赋能:基于codex的插件分析管理平台
当 AI 编程助手进入企业,真正需要管理的并不是“员工用了多少次”,而是数据是否完整、身份是否可信、访问是否受控,以及每一次处理能否被追踪和审计。以及我们如何快速去实践加速ai落地。
1. 能分析用户重点的使用场景
2. 基于内容做AI知识库
3. 后续可以给员工提供更好的ai赋能
Codex 正在从个人效率工具走向企业研发基础设施。员工会在不同设备、项目和会话中持续产生任务记录、工具调用、文件变更与同步状态,这些数据对排障、运营和合规都很重要,但也可能包含代码、路径、命令输出和敏感信息。
codex-plugin 正是在这个背景下诞生的。它面向企业员工,构建了一条从本地授权采集、加密队列、分片上传,到服务端解析、员工维度查询和数据治理的完整链路。
01 背景介绍:企业需要的不是“多采集”,而是“可信采集”
当 Codex 只由少数开发者尝试时,大家关心的是好不好用;当它开始规模化部署,企业会很快遇到另一组问题:插件到底覆盖了多少人?设备是否正常运行?数据最近一次什么时候同步?断网后是否丢失?重复上传会不会造成重复记录?管理员能否看到不该看到的内容?员工离职后,相关数据是否能够按规则删除?
传统日志采集思路很难直接回答这些问题。Codex 数据首先产生在员工本机,网络不一定稳定,源文件格式也可能变化;数据还天然带有员工、设备、项目和会话上下文,一旦归属错误,就可能造成跨员工串写或串读。
因此,项目从一开始就确定了三个边界。
第一,只采集员工授权、客户端可读且协议明确支持的数据,不扫描整台电脑,不读取未授权目录、剪贴板、浏览器历史或个人聊天。
第二,不从操作系统用户名、目录名或内容本身推断员工身份。数据归属必须来自企业身份、一次性激活码、设备凭证与服务端验证后的可信上下文。
第三,企业管理员默认只能查看运行状态和 L0/L1 元数据。脱敏内容和原始内容必须经过独立审批、短时授权和完整审计。
这个项目要解决的,本质上不是“怎样拿到更多数据”,而是怎样让每条数据都能回答:谁授权、从哪里来、经过哪些处理、现在处于什么状态,以及谁曾经访问或处置过它。
02 功能简介:从员工本机到管理控制台的完整闭环
整个系统由本地插件与 Collector Agent、服务端平台和 Ant Design Pro 管理端三部分组成。
本地采集与员工控制
Codex 生命周期 Hook 负责捕获会话开始、用户提交、工具调用、回合结束和会话结束等事件。Hook 不直接上传,而是把事件快速交给本地常驻 Agent,写入加密 SQLite 队列。
Agent 支持首次全量与持续增量同步。全量过程中出现的新事件会继续进入增量缓冲区,快照成功后再从冻结游标继续,避免出现“扫描期间的数据窗口”。网络中断、进程重启或分片上传失败时,系统会复用原来的包 ID、幂等键和上传会话继续恢复。
员工可以查看采集状态、暂停或恢复采集、立即同步、重新生成全量,并通过一次性激活码完成设备绑定。访问令牌、刷新令牌和设备私钥只保存在 macOS Keychain,不写入普通配置、日志或命令参数。
服务端接入、解析与投影
服务端把接收和解析拆开。ingest-api 负责设备鉴权、上传会话、对象校验与原始包落盘;parser-worker 负责防御性解包、协议选择、标准化与原子提交;projection-worker 负责员工摘要、日指标、会话摘要以及治理任务;control-api 则作为管理端唯一的查询与控制入口。
原始包进入私有对象存储,标准记录与状态进入 MySQL 8.0,Kafka 负责传递最小化的生命周期事件。即使解析服务暂时不可用,只要配额允许,接入层仍可继续保存新包,不会把服务端故障直接传导到员工本机。
管理、审计与数据治理
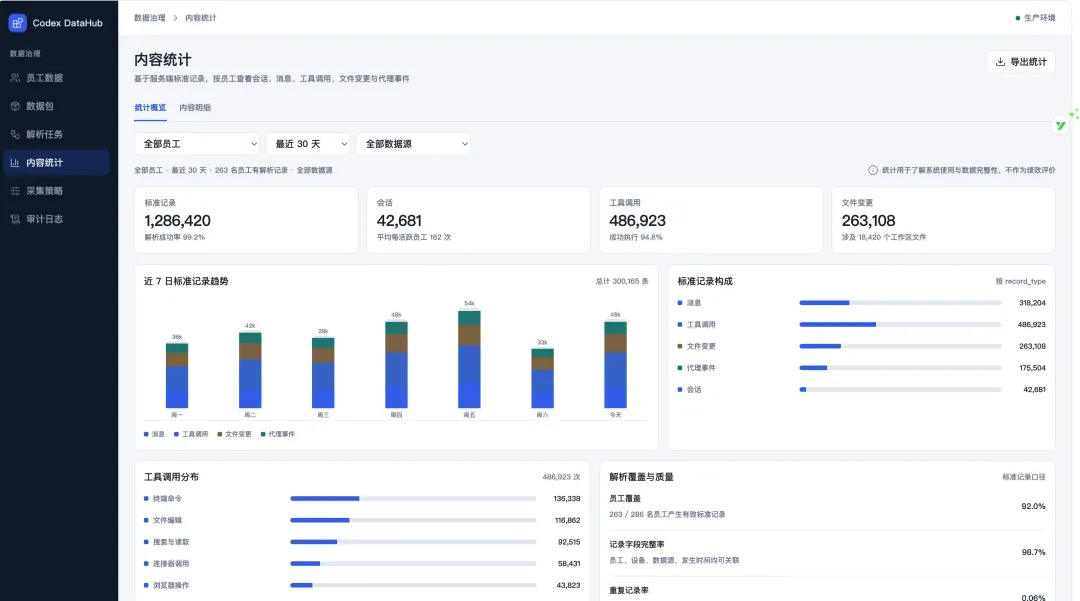
管理端覆盖员工、部门、设备、数据源、数据包、解析任务、策略、异常、审计、激活码、受控内容和数据治理。
管理员可以看到某位员工的设备是否可信、最近是否心跳、数据是否积压、策略是否真正应用、包停在哪个状态,以及一次同步命令从下发到成功或失败的完整状态链。
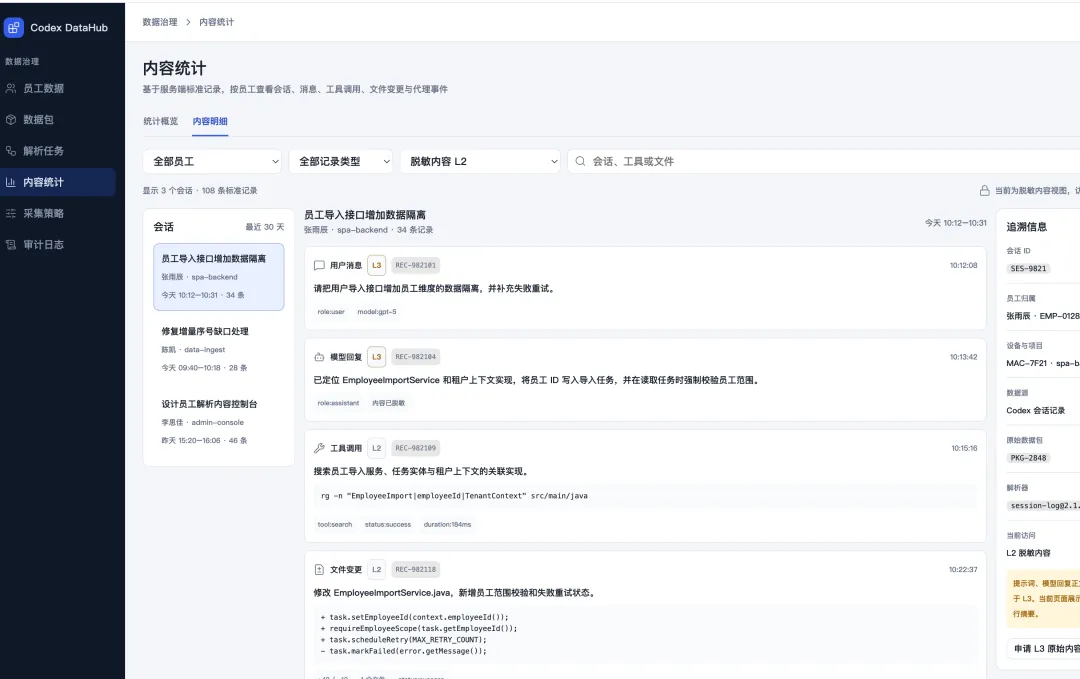
内容访问按 L0、L1、L2、L3 分层。L2 提供经过脱敏的标题、摘要和标准记录;L3 原始内容只保存在 KMS 加密对象存储中。员工导出、删除、法律保留和内容访问都需要独立权限、原因、审批与审计,不能依赖一个“超级管理员”按钮绕过流程。
03 核心技术:可靠性、安全性与可治理性同时成立
90 毫秒 Hook 与本地可靠队列
Hook 总预算为 90 毫秒,其中 Unix Socket 快速连接预算为 25 毫秒。它只做输入上限校验、稳定事件 ID 生成和本地投递;扫描、脱敏、压缩、加密及网络上传全部在后台完成。
Agent 只有在加密 SQLite 事务提交后才返回 ACK。Socket 暂时不可用时,同一个事件信封会使用相同事件 ID 回退到 SQLite 短事务,避免丢失,也避免重试生成第二条记录。
SQLite 使用 WAL 和严格同步策略。敏感载荷按记录使用 AES-256-GCM 加密,队列主密钥只进入 Keychain;目录、数据库和 Socket 权限分别限制为 0700、0600 和 0600。达到磁盘配额时系统明确暂停采集,保留已有未确认数据,不会静默覆盖旧记录。
白名单、脱敏与信封加密
数据离开设备前,先经过字段白名单、路径相对化、凭据识别和企业敏感规则。系统根据策略执行 DROP、MASK 或 BLOCK,规则命中只记录规则 ID 和数量,不记录原始敏感值。
通过过滤的内容被组织为 manifest.json + JSONL + blobs,压缩成 tar.zst。每个包使用随机 AES-256-GCM 数据密钥整体加密,数据密钥再由服务端 KMS 公钥封装,最后对密文计算 SHA-256。
服务端会重新核对密文大小、摘要、Manifest、文件集合、单文件哈希、记录数与身份作用域。归档中的绝对路径、目录穿越、符号链接、压缩炸弹、超大文件和未知字段都会被拒绝。只有服务端确认包达到 STORED 状态,本地才推进已上传游标。
四个部署单元
项目没有为了微服务数量而过度拆分,而是保持 ingest-api、control-api、parser-worker、projection-worker 四个部署单元,并通过 OpenAPI、Kafka 事件和明确的应用端口协作。
数据包状态、状态历史和 Outbox 在同一事务提交。Kafka 采用至少一次投递,消费者先写 consumed_event:相同事件与相同摘要属于安全重放;相同事件 ID 却出现不同摘要,则进入一致性错误,不能静默覆盖。
解析器是纯转换组件,不访问任意宿主文件、外部网络、数据库或系统凭据。未知源格式进入 UNSUPPORTED,原始包继续保留,等待兼容版本,而不是猜测字段含义。
租户员工隔离与分级授权
系统以 tenant_id + employee_id 作为员工数据隔离主键,并贯穿设备、数据源、包、标准记录、缓存 Key、对象路径和审计上下文。
服务端不信任请求 Body、Query、Path、Manifest 或 Kafka Header 直接声明的租户身份。Repository 必须接收可信作用域,员工数据 SQL 显式携带租户和员工条件;越权访问统一返回 404,并记录安全审计。
L2 内容至少需要一名独立审批人;L3 需要两名不同管理员审批,Grant 最长 300 秒且只能使用一次。成功读取时,Grant 消耗、访问计数和审计在同一事务提交;任何一步失败,都不能返回正文。
项目当前使用 65 张 MySQL 表且不使用外键,一致性由应用事务、唯一索引、状态机、删除编排和自动巡检共同保证。员工删除被拆成 10 个可重入步骤,每一步都会重新检查 legal_hold,最终只有在 MySQL 和对象存储员工范围都归零后,才生成验证哈希。
04 使用场景:谁会真正需要这套系统
企业部署覆盖与健康运营
研发平台团队可以按员工、部门和设备查看插件覆盖率、版本、心跳、队列深度、策略版本和最近同步时间,快速识别“已安装但未运行”“设备在线但策略未应用”“数据持续积压”等问题。
数据包排障与解析运维
当上传、验包或解析失败时,运维人员可以从员工下钻到数据源、数据包和解析尝试,查看稳定错误码、重试次数、序号缺口和处理状态。解析器升级后,还可以对保留的历史原始包进行受审计重解析。
安全与合规审计
安全团队可以管理采集白名单、敏感规则、保留期和灰度策略,查看设备证明、策略回执、内容访问与管理操作审计。审批、Grant、导出、删除和法律保留都拥有独立状态机与证据链。
受控内容查看
需要排查具体会话问题时,普通管理员仍只能看到 L0/L1 状态。经过审批后,指定人员可以在有限字段、有限次数和有限时间内查看 L2 脱敏内容;确需读取 L3 原始记录时,必须双人审批、单次授权并展示短时水印。
员工入职、停用与离职治理
管理员通过一次性激活码把员工与设备绑定。员工停用时,系统同步禁用设备、撤销凭证和激活码,并取消未完成任务;重新启用不会恢复旧信任,必须重新绑定。离职删除还要经过审批、恢复窗口、法律保留检查和零残留验证。
这部分对ai重度使用企业有帮助可以把上一个员工ai上下文快速给下一个交接人。
小规模企业试点
项目提供 Docker Compose 单机试点配置、企业 OIDC、SCIM 风格目录同步、macOS Universal Binary 构建、Developer ID 签名、公证与 MDM 安装模板,适合先在 5~20 人范围内验证真实网络、权限、运维和升级流程。
05 后续迭代:代码闭环走向试点
目前项目已经完成 F覆盖本地采集、设备绑定、分片上传、防御性解析、标准化投影、员工管理、内容审批和数据治理。
第一阶段是受控试点。接入真实企业 IdP 与员工目录,使用正式 KMS、私有对象存储和 Apple 企业签名环境,在 5~20 名员工范围内验证安装、激活、同步、积压恢复、策略灰度、告警和回滚。
第二阶段是生产可运维性。补齐 SLO 看板、容量基线、备份恢复演练、密钥轮换、故障手册、数据治理运行手册,以及 Collector 版本从 1%、5%、25%到 100%的灰度证据。
第三阶段是平台扩展。逐步支持 Windows、Linux,更丰富的数据源适配器,以及项目目录、Git 与 IDE 事件;同时保持 Parser 纯转换、未知格式失败关闭和员工授权边界不变。
第四阶段是数据价值探索。在不突破授权和隐私边界的前提下,建设数据质量评分、搜索、团队报表和管理洞察。
这套系统最终想沉淀的,并不是一个“上传 Codex 记录”的插件,而是一种企业级 AI 工具治理方法:本地采集不打扰用户,数据流转可验证,员工边界不模糊,敏感访问有审批,删除与保留都有证据。