ARTICLE · 997337
AI 诊断最容易做错的一步,就是先做聊天框
再贴一段日志,它还能解释错误码,顺手给出几条排查命令。演示做到这里,已经很像一位经验丰富的运维工程师了。
说实话,这种效果很容易让人兴奋。
我以前做大数据 SRE,现在转到 AI 运维平台,平时接触的工作集中在 AI 诊断、AI Agent 和提效工具上。站在这个位置看,我越来越在意一个问题。
诊断产品如果从聊天框开始设计,团队很容易把注意力放在回答像不像专家。证据从哪里来、查询是否完整、结论能不能复现,这些更费力的部分往往被排到了后面。
聊天框没有错。把它放在第一步,后面的路很容易走偏。
一、聊天框为什么总是先出现
原因很简单,它做起来快,效果也直观。
接一个大模型,写一段提示词,再放一个输入框,用户就能把告警、日志和截图贴进来。模型擅长理解文字,也擅长把零散信息整理成一段顺畅的解释。
这种能力确实有价值。刚接触某类故障的人,可以借它理解术语。熟悉系统的人,也能让它帮忙压缩日志、整理排查方向。
它的上限同样很清楚。
聊天框里有什么,取决于用户贴了什么。用户没有贴服务拓扑,它就不知道上下游关系。用户只给了某一分钟的日志,它也看不到故障发生前后的发布和配置变更。
这意味着什么?
用户需要先知道该查什么,才能把材料交给 AI。到了这一步,排障最吃经验的那段工作仍然留给了人。
二、回答和诊断差在哪里
一段回答可以很完整。
CPU 升高可能来自流量突增、死循环、频繁 GC,也可能来自下游超时带来的重试。模型可以把这些可能性解释得很清楚。
可线上只有一个正在发生的故障。
诊断要继续往前走。它得先确认哪项服务受影响,随后查看相关指标和日志,再结合调用链、部署记录和依赖关系提出假设。假设出来以后,还要找下一条证据去确认或排除。
一项面向微服务故障诊断 Agent 的公开研究,使用了两个数据集,合计包含超过 500 个专家标注的故障案例。
研究把诊断能力拆成了三个问题。故障发生在哪里,属于哪一种故障,推理过程有没有得到相关证据支持。
我比较在意第三个。
模型可以写出一段听起来很合理的分析,语言越顺,读者越容易放下戒心。可它引用的指标有没有覆盖故障时段,日志是不是来自同一个实例,调用链是否属于同一次请求,这些细节才决定结论能不能用。
站在 SRE 的工作方法里,我更信一条带着时间、对象和来源的证据,少信一段没有出处的漂亮解释。
三、Agent 要自己去找证据
一篇公开文章把 AI SRE 形容成带工具的调查员。这个说法很贴切。
调查员不能坐在桌前等别人递材料。他要知道去哪里找,找到以后还得判断材料能不能互相印证。
诊断 Agent 也一样。
它至少要能访问告警、指标、日志、调用链和服务关系。实际环境里还会碰到发布记录、配置变更、工单和历史故障。
这些数据不会整齐地放在一个地方。指标可能在 Prometheus,日志可能进了 Elasticsearch 或其他日志平台,调用链又在另一套 APM 系统里。
服务名、实例名和资源标识经常对不上。
Agent 得先把对象对应起来,再决定查询顺序。告警指向哪个服务,服务跑在哪些实例上,异常从哪个时间点开始,附近有没有发布,哪条调用链最能代表问题,这些步骤都需要工具参与。
这才是一段完整的调查过程。
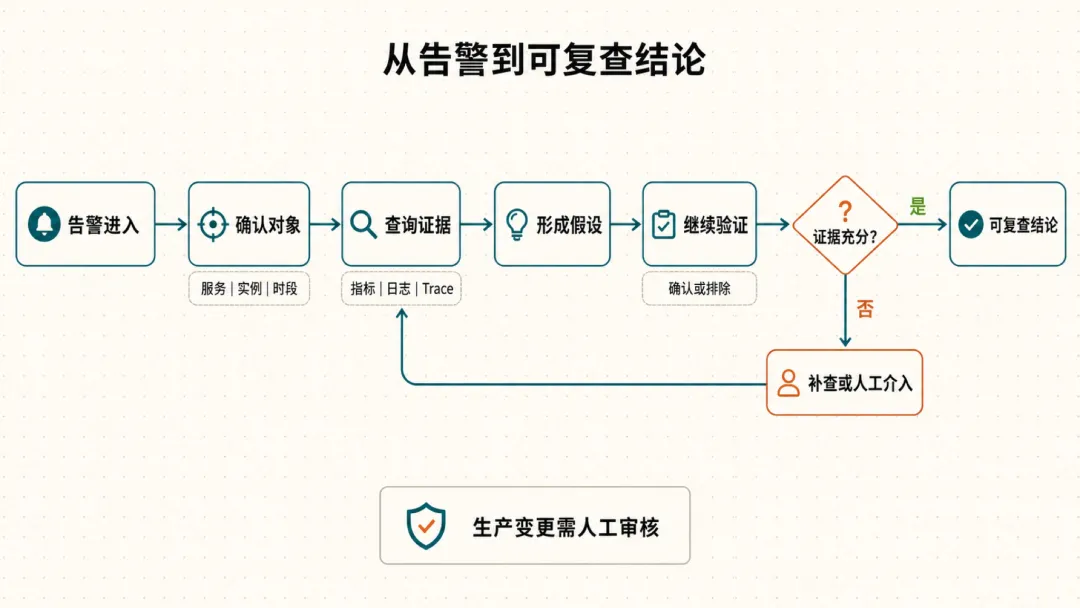
从告警进入,到证据充分后输出可复查结论
四、工具接上只是开始
一套公开的告警排查 Agent 实践,给 Agent 接入了日志、指标和调用链查询工具,还专门处理工具超时和结论校验。
这个细节很重要。
外部查询一定会遇到失败。日志平台会超时,指标接口会限流,某个服务也可能暂时没有 Trace。
Agent 遇到缺失数据时,需要把缺口写出来,继续使用已有证据,或者停下来请求人工介入。它不能悄悄跳过失败的查询,再把猜测写成根因。
工具调用结束以后,生产环境还会继续追问。
为什么先查日志,随后查指标?查询用了哪个时间范围?中间有没有走错服务?一次工具调用失败以后,后面的结论受了多大影响?
另一项公开实践把 Agent 评测分成结果、过程、效率和风险四个方向。这个划分放在 AI 诊断里很实用。
结果要看故障有没有定位准。过程要看排查路径是否稳定,工具调用能不能复现。效率包括耗时、Token 和查询次数。风险则关系到越权访问、误操作和敏感信息。
所以我觉得,AI 运维平台需要记录完整的排查轨迹。
每次用了什么输入,调用了哪个工具,工具返回了什么,哪条证据改变了当前假设,最后为什么停下来,都应该能够回看。
少了这条轨迹,团队只能看到一份结论。结论偶尔错一次,连修哪里都不知道。
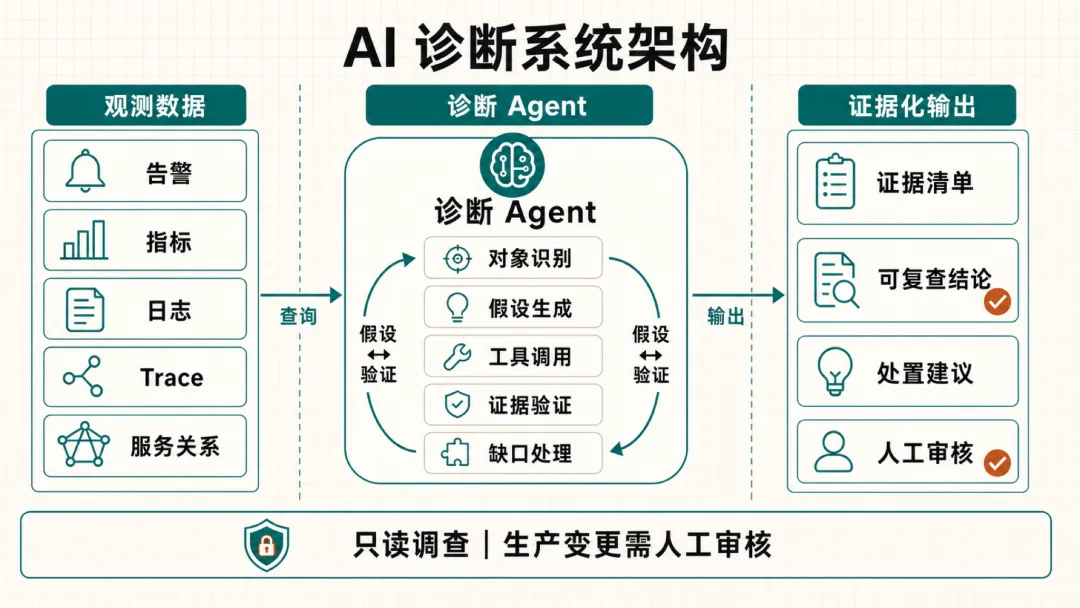
观测数据、诊断 Agent、证据化输出与生产权限边界
五、第一阶段先停在只读调查
诊断完成以后,下一步通常是生成处置建议。再往前一步,Agent 就会开始执行命令、改配置、重启服务。
这一步要慢一点。
公开研究对 Agentic AIOps 的建议很一致。Agent 从收集证据走向执行动作时,需要权限、策略、校验和回滚。
每项写操作都要落在明确的范围内,执行前能检查,执行后能验证,出了问题还能撤回。
我对第一阶段产品的倾向很明确。
先让 Agent 做好只读调查,输出证据、判断和建议。涉及生产变更时,把命令、影响范围和回滚办法交给人审核。
这会损失一点演示上的刺激感,却更接近运维团队愿意采用的方式。
聊天框仍然可以留下。人需要补充背景,也需要追问 Agent 为什么这样判断。它更适合放在调查过程的入口和出口,底下接着工具、证据、状态和权限。
六、写在最后
AI 诊断的价值,不取决于它能列出多少种故障原因。运维工程师随手搜索一下,也能拿到一长串可能性。
我更关心它能否面对一条真实告警,自己找到相关数据,让证据和假设互相对应,承认缺失的信息,并给出可以复查的结论。
先把调查过程做好,再谈自动处置。
如果你也在做 AI 运维或诊断 Agent,欢迎留言说说,你现在最难接入的是哪一类工具。
参考资料
微服务故障诊断 Agent 评测论文[https://arxiv.org/abs/2606.29193]
Agentic NetOps 与 AIOps 综述[https://arxiv.org/abs/2605.12729]