ARTICLE · 997342
又一个文档转换神器,开源了!一个skill搞定Word/PPT/Excel/PDF全转md
现在让 AI 读文档,基本是这么个流程。
手里一份 Word 报告,或者一份 PPT,先想办法转成纯文本,再丢给 AI。
转的时候要么找个在线网站,要么写段 Python 脚本,要么干脆复制粘贴。
每一步都没什么问题。
真正麻烦的是转完之后你会发现,表格散了,标题层级没了,公式变成一堆乱码,脚注不知道跑哪去了。
AI 读到的东西,跟你看到的那份文档已经不是一回事了。
最近在 GitHub 上看到一个项目,专门解决这件事。
它叫 anydoc,Firecrawl 团队做的,目前 19586 个 Star。
Firecrawl 自己的文档解析服务就跑在这套代码上,所以它不是做出来放着的实验品,是在生产环境上跑的东西。
说白了,就是把 Word、PPT、Excel、PDF 这些 office 文档,转成干净的 Markdown。
支持八大类,具体到扩展名有十几种:.doc.docx.ppt.pptx.xls.xlsx.odt.ods.odp.rtf.epub.csv.pdf 都能吃。
八种格式进去,出来的 Markdown 长得一模一样。
01
PART
下面先看一下转出来什么样
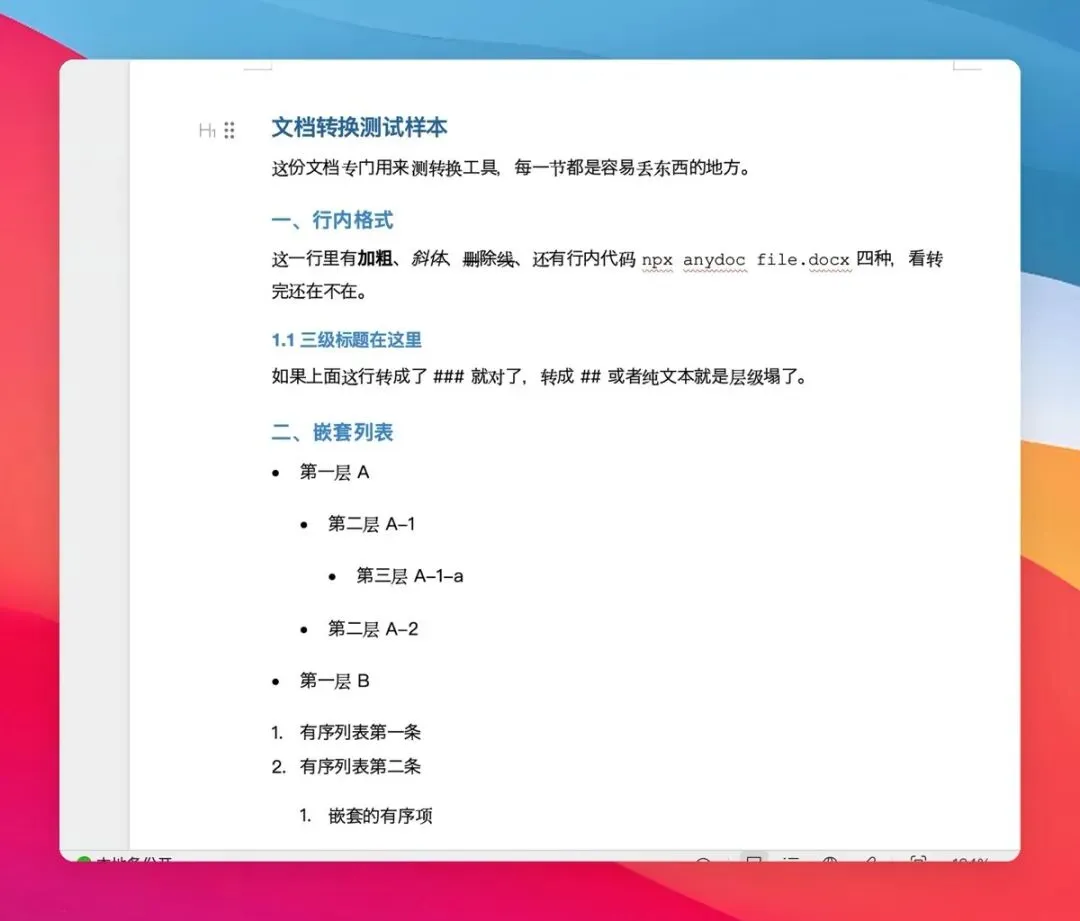
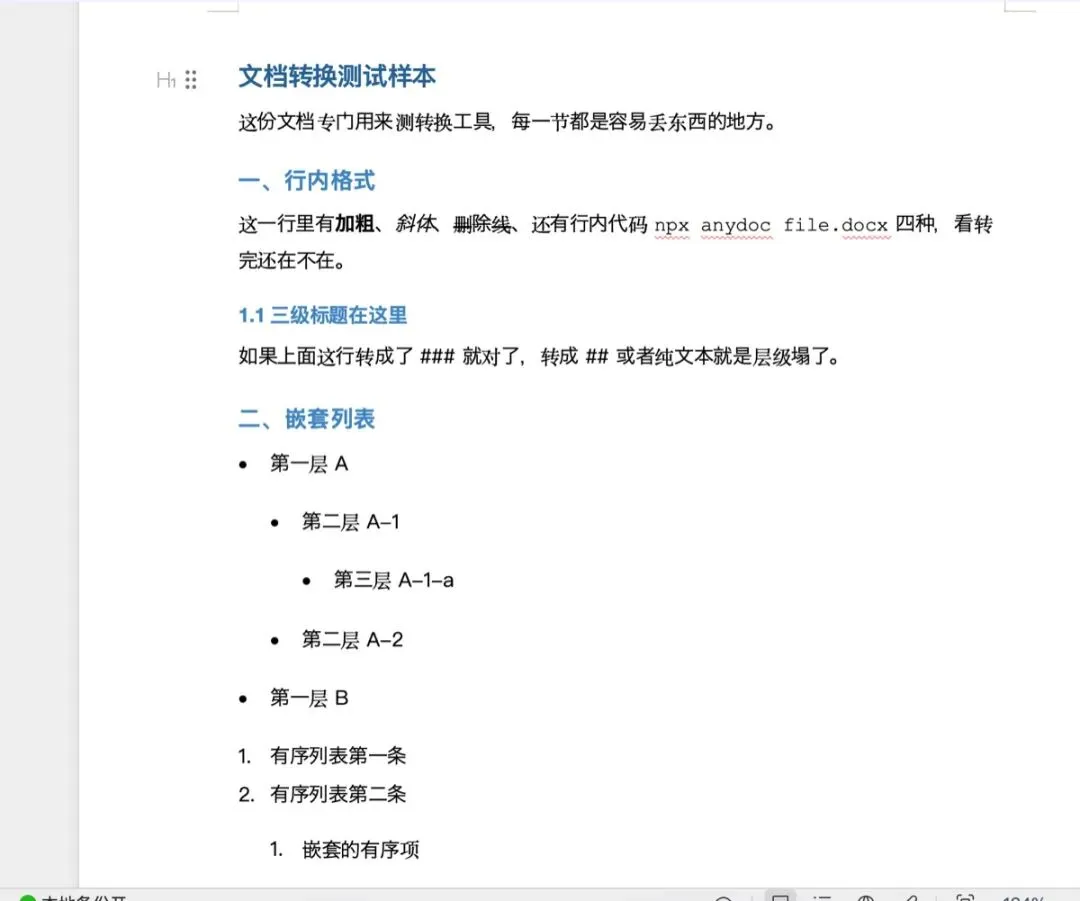
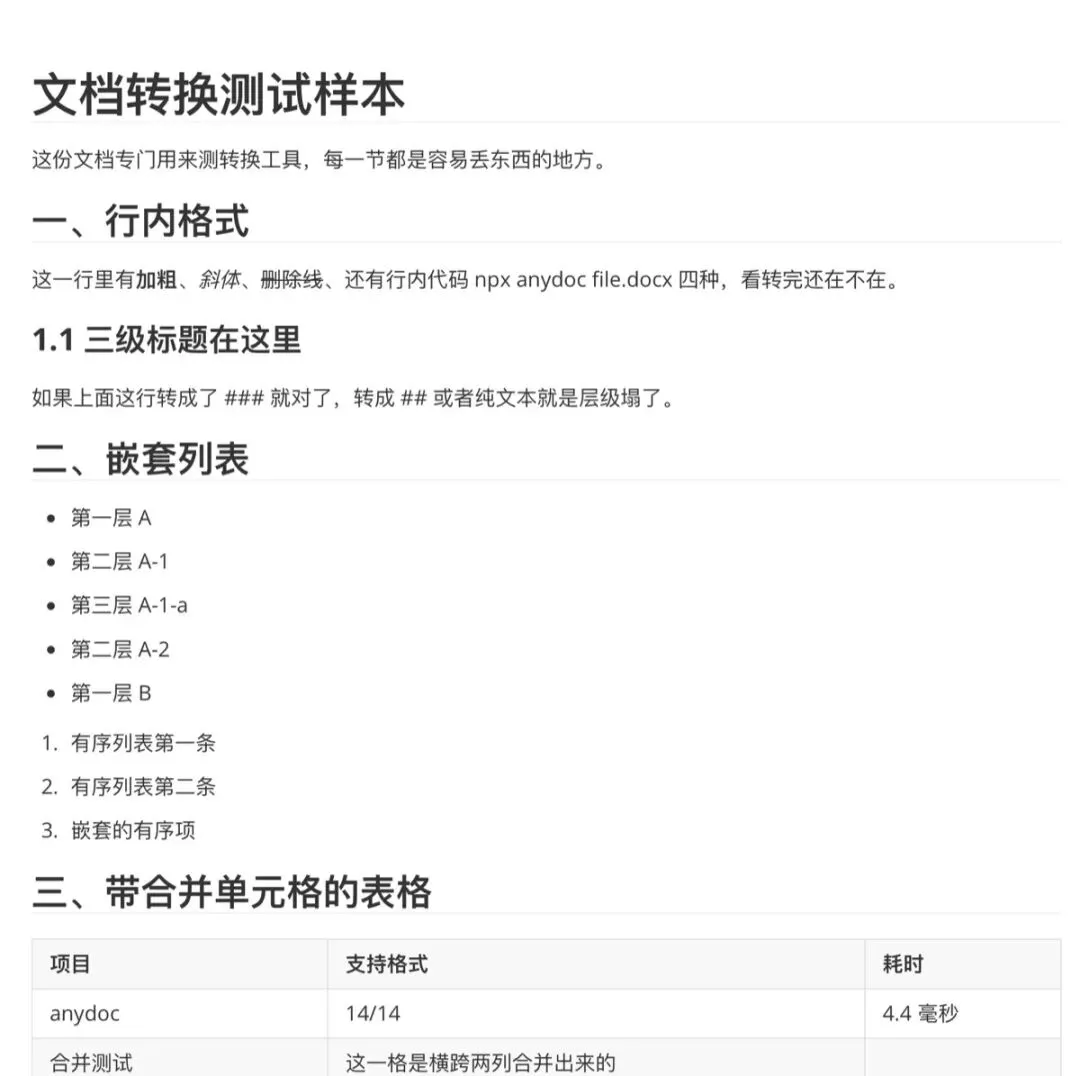
我自己做了一份 Word 来测,专门挑转换工具容易翻车的地方写:三级标题、三层嵌套列表、带合并单元格的表格、单元格内换行、空单元格、代码块。
用 WPS 打开长这样。
转换就一条命令:
npx @firecrawl/anydoc 测试文档.docx > 测试文档.md
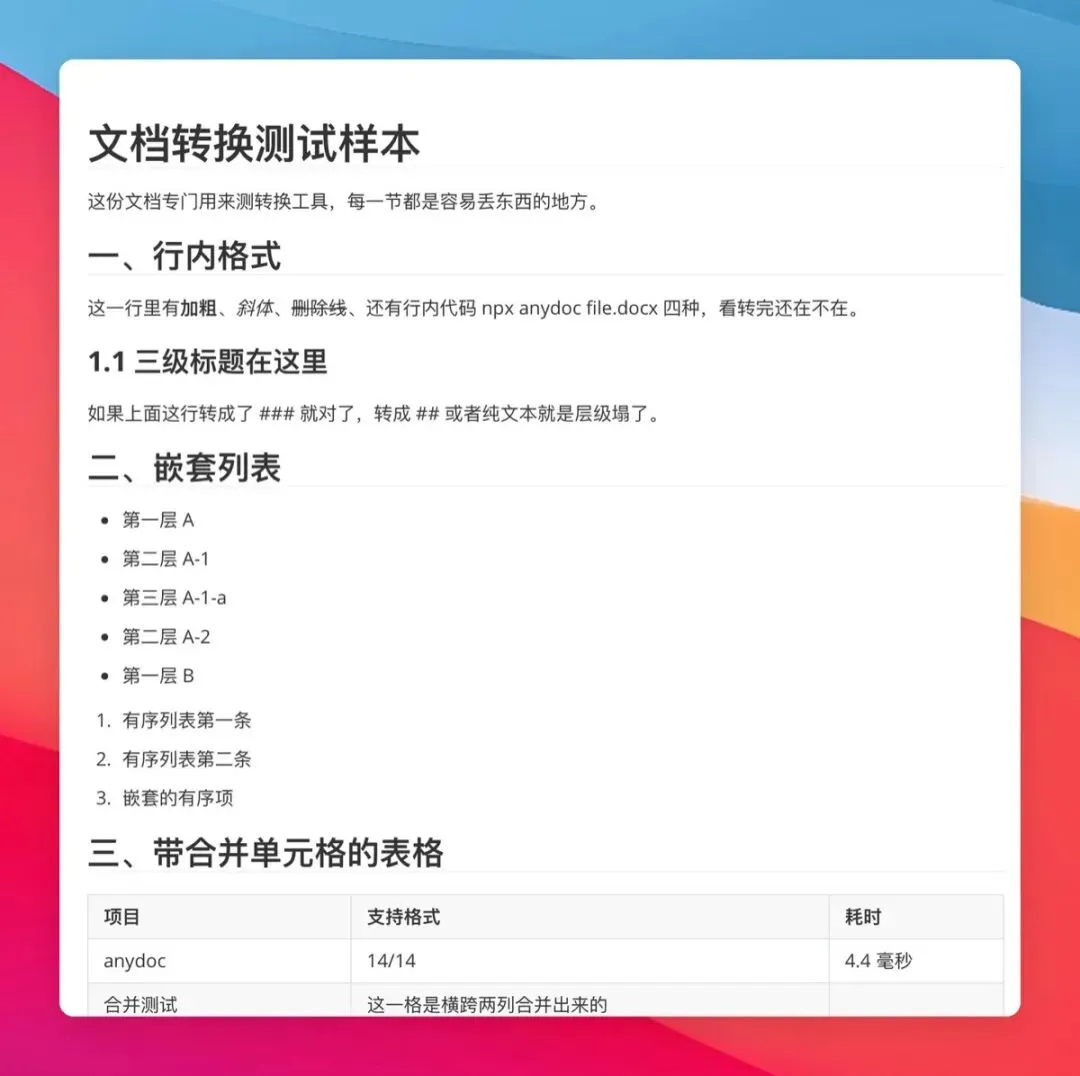
跑完不到一秒,出来的 Markdown 是这样:
## 三、带合并单元格的表格
| 项目 | 支持格式 | 耗时 |
| --- | --- | --- |
| anydoc | 14/14 | 4.4 毫秒 |
| 合并测试 | 这一格是横跨两列合并出来的 | |
| 单元格内<br>有换行 | | 尾列 |
表格后面这段文字,看有没有被吸进表格里。
表格这块是真保住了。
横跨两列的合并格没塌,单元格里的换行转成了 <br>,空格子老老实实留着位置没少一列。表格后面紧跟的那段文字也独立成段,没被吸进最后一格。
这四样是我见过转换工具最容易出错的地方,它一样没丢。
标题层级也对,一级二级三级三层都在。加粗、斜体、删除线也都转成了对应的 Markdown 写法。
再看美元符号:
下面这行是价格不是公式:A price of $5 or $6 is not math.
「$5 or $6」原样留着,没被当成公式起止符。很多工具在这儿会翻车,把美元符号当成数学公式的开头,后面整段就乱了。
想让 AI 直接读文档,装成 skill 就行:
npx skills add firecrawl/anydoc
Claude Code、Codex、Cursor、OpenCode 都支持。装完你丢一份 docx 给 AI,它自己会调 anydoc 转好再读。
它还有个网页版,浏览器里拖文件进去就能转,文件不上传,全在本地跑。
浏览器版跟命令行版走的是同一份 Rust 代码,只是编译成了浏览器能跑的格式,转出来的结果一模一样。
02
PART
具体是怎么做到的
01 所有格式走同一条路。 八种格式先解析成同一个文档模型,再用同一个 Markdown 渲染器输出。
以前每个格式一套转换逻辑,docx 转出来是一个样,pptx 转出来又是另一个样,转义规则、表格写法、标题锚点全不统一。
现在不管进去的是 2003 年的 .doc 还是昨天的 .pptx,出来的 Markdown 格式一致。
02 结构保住了。 标题带锚点、粗体斜体删除线、链接和内部交叉引用、合并单元格的表格、引用块、脚注尾注、演讲者备注。
以前这些东西转完基本就没了,尤其是合并单元格,十个工具九个转丢。
我自己测下来,表格那几样确实都保住了,标题层级也对。
03 公式转成 LaTeX。 Word、PPT、EPUB、RTF 里的公式,不管原来用的哪套格式,统一转成 GitHub 支持的数学写法,行内用 $ 包起来,独立成块用 $$。
以前公式转完是一堆方框和乱码,学术文档、技术手册基本没法用。
公式一乱,整份材料基本就废了,做知识库的应该有体会。
04 认字节不认后缀。 格式是从文件内容里读出来的,PDF 看文件头,RTF 看开括号,Office 看 ZIP 包里的 mimetype。
以前文件后缀被人改错了,工具就懵了。 现在改错也能正确转换。
03
PART
跑分是跟六个工具一起测的
它把对手全列出来了,拿 100 份真实文档、十四种格式同台测:
libreoffice 转一份要一秒多,anydoc 是 4.4 毫秒,差了两百多倍。
我觉得这个差距对单份文档没意义,一秒还是四毫秒你都感觉不到。但要是批量处理一万份,一个跑三个小时,一个跑一分钟。
原因是它用 Rust 写的,不加载任何模型,也不调外部服务。
分格式看也是全面领先。docx 88 分对 markitdown 的 71 分,pptx 74 对 66,rtf 88 对 unstructured 的 46。
有几种格式干脆只有它一家能转,比如 .docm、.odp、.ods、.ppt 这些,表格里其他工具那一栏全是横杠。
04
PART
扫描版 PDF 要单独说一下
文字版 PDF 它本地就能转,但扫描件不行,会直接报 NeedsOcr。
想转扫描件得开 OCR,加个参数:
npx @firecrawl/anydoc scan.pdf --ocr hosted
这一步会把文档传到 Firecrawl 的服务器上做识别。
注意两点:一是只有需要 OCR 的文档才会离开你的电脑,普通文档全程本地;二是传的是整份文档,因为那个服务不支持只传某几页。
不开 OCR 的话,纯 Rust 版本一次网络请求都不会发。
05
PART
想试的话,安装并不复杂
最省事的办法是让 AI 自己装,打开你的 AI 工具直接说:
帮我装 https://github.com/firecrawl/anydoc
这个 skill,装完告诉我怎么用
自己动手就一条命令:
npx skills add firecrawl/anydoc
想在自己代码里调,三种语言都有包:
npm install @firecrawl/anydoc # Node.js
pip install firecrawl-anydoc # Python
cargo add anydoc # Rust
Node 版本转换时不会卡住主线程,Python 版本转换时也不占着解释器锁。
转一千份文档不会把服务卡死。
06
PART
到这有几个注意点也提一下
嵌套列表会被压平。这是我自己测出来的,三层嵌套的无序列表转完全变成了同一层,缩进关系没了。层级信息对 AI 理解文档结构挺重要的,这块可惜了。
行内代码和代码块的标记会丢。原文里用等宽字体标的行内代码,转完变成了普通文字,反引号没了。代码块也一样,变成了普通段落。
扫描版 PDF 本地转不了,得开 OCR 传到云端。介意数据出本机的要留意。
图片只保留替代文字。图片和嵌入对象在 Markdown 里只剩 alt text,原始字节留在文档模型里,要自己取。
Rust 版本没有 OCR 选项,只有 Node、Python 和命令行能开。
跑分是官方自己做的,虽然把对手和方法都列出来了,但毕竟是自己测自己。
///
LAST
写在最后
SUMMARY · 值不值得装
我比较关注这个项目,不是因为它又多支持了几种格式。
而是它把文档转换从「能转就行」推到了「转得准」这一步。
以前评价一个转换工具,标准是能不能打开、会不会报错。
现在开始比谁保得住表格、保得住公式、保得住嵌套列表。
以前转文档是给人看的,人看到乱码能自己脑补回去。现在是给 AI 看的,输入什么样它就读到什么样。
有兴趣的朋友可以试试看。
开源地址:https://github.com/firecrawl/anydoc
如果本文对您有帮助,也请帮忙点个 赞👍 + 在看 哈!❤️
在看你就赞赞我!
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING