ARTICLE · 998931
经济学实证研究的AI Stata skill:操作指南
经济学实证研究的AI Stata skill:操作指南
AI+Stata2.0红宝书-2026Stata寒假班--精彩片段回顾
本文主要针对Stata skill,给出一些相关资源,并且给出创建AI Stata skill的一些技巧以及模板。
关于AI Stata skill,可以参考Pedro H. C. Sant’Anna ClaudeCode工作流
https://psantanna.com/claude-code-my-workflow/ https://psantanna.com/claude-code-my-workflow/workflow-guide.html https://github.com/pedrohcgs/claude-code-my-workflow
另外,Claude Code 对应Stata Skill 可以在如下市场网址进行检索
Skills Marketplace :https://skillsmp.com/ 官方 Skill 仓库 :https://github.com/anthropics/skills Skills 市场(含 58925 个 Skills) :https://skillsmp.com/zh 扣子商店(含 6 万 9 千多个 Skills) :https://skillsmp.com 精选合集 awesome-claude-skills :https://github.com/ComposioHQ/awesome-claude-skills Claude 中文社区 :https://claudecn.com/
另外计量云课堂如何在Claude Code中创建Stata skills一文里面也推荐了如何在Claude Code中创建Stata新技能,
AI Stata Skill 创建指南
Stata-package:描述Description
安装 / Installation
ssc install Stata-package* 或net install Stata-package, from("https://...")概述 / Overview
简要描述该软件包的功能及其适用场景。并说明它与内置替代方案的不同之处。
基本用法 / Basic Usage
* Examplehelp cie关键选项 / Key Options
option1 | |
option2 |
常见工作流程 / Common Workflows
展示 2-3 个实际用例,并附上完整的代码示例。
注意事项
列出常见错误、版本差异等 说明该软件安装包对其他软件包的依赖关系
参见 / AlsoSee
相关的内置命令 相关的社区软件包
指南 / Guidelines
保持实用性。专注于语法、选项和可运行的示例。跳过任何大型语言模型(LLM)已知的通用理论。 包含注意事项。非直观的行为是您可以记录的最有价值的内容。 每个文件对应一个软件包。不要将多个软件包合并到一个文件中。 测试您的示例。确保代码块确实能在 Stata 中运行。 为任何超过 100 行的文件添加目录## 目录。在 H1 标题后添加一个章节,其中包含指向每个 H2 章节的 Markdown 链接。 不要包含个人信息。不要在示例中包含特定电脑的路径、名称或凭证。请使用像 "$data/myfile.dta"这样的通用路径。
模板
下面给出VS-Code中创建psm.md的结果
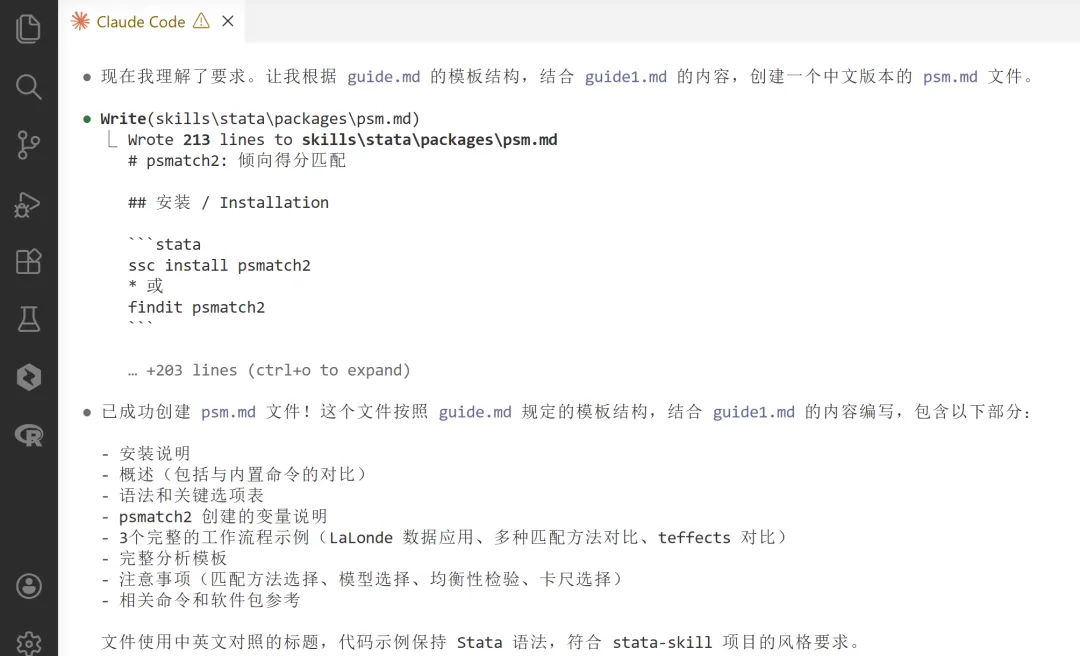
该psm.md文件内容如下(其中该模板主要参考资源有:倾向匹配得分教程【pscore、psmatch2、官方命令Teffects操作及应用】、SCM、RD、PSM代码合集(免费公开)):
# psmatch2: 倾向得分匹配## 安装 / Installation```statassc install psmatch2* 或findit psmatch2```## 概述 / Overview`psmatch2` 是 Edwin Leuven 和 Barbara Sianesi 开发的 Stata 包,用于倾向得分匹配(Propensity Score Matching, PSM)。它通过匹配处理组和对照组在倾向得分或协变量距离上的相似性来估计平均处理效应。**与内置命令 `teffects psmatch` 相比的优势:**- 多种匹配算法(最近邻、核匹配、局部线性回归、半径匹配)- 马氏距离匹配选项- 可同时处理多个结果变量- 详细的匹配诊断(通过创建的变量提供个体匹配信息)- 灵活的共同支持控制## 语法 / Syntax```statapsmatch2 depvar [indepvars] [if exp] [in range] [, outcome(varlist) pscore(varname) neighbor(integer) radius caliper(real) mahalanobis(varlist) ai(integer) population altvariance kernel llr kerneltype(type) bwidth(real) spline nknots(integer) common trim(real) noreplacement descending odds index logit ties quietly w(matrix) ate]```## 关键选项 / Key Options| 选项 | 描述 ||------|------|| `depvar` | 处理变量(0=对照组,1=处理组) || `indepvars` | 协变量,用于估计倾向得分 || `outcome(varlist)` | 结果变量 || `logit` | 使用 logit 模型拟合(默认是 probit) || `neighbor(#)` | 指定最近邻匹配的邻居数,如 `neighbor(1)` 为 1:1 匹配 || `radius` | 半径匹配 || `kernel` | 核匹配 || `llr` | 局部线性回归匹配 || `spline` | 样条匹配 || `mahalanobis(varlist)` | 马氏距离匹配 || `caliper(real)` | 卡尺(最大倾向得分距离) || `common` | 限制在共同支持区域 || `ate` | 同时估计 ATE(平均处理效应) |## psmatch2 创建的变量匹配后,psmatch2 自动生成以下变量:- `_pscore`:每个观测值的倾向得分- `_id`:自动生成的每个观测对象的唯一 ID- `_treated`:指示某个对象是否为处理组- `_n1`:匹配到的对照对象的 `_id`(如果是 1:3 匹配,还会生成 `_n2`、`_n3`)- `_pdif`:一组匹配的观察对象倾向得分的差- `_weight`:对照单元被用作匹配的次数- `_support`:是否在共同支持区域内## 常见工作流程 / Common Workflows### 示例 1:LaLonde (1986) 数据应用这是国家支持工作示范(NSW)处理组数据的子样本和当前人口调查(CPS)的比较样本。```stata* 1. 加载数据并查看结构use "ldw_exper.dta", cleardescribe* 2. 描述性分析tabstat age edu black hisp married re74 re75 u74 u75, statistics(mean) by(t)* 3. 使用 psmatch2 进行倾向得分匹配psmatch2 t age edu black hisp married re74 re75 u74 u75, /// out(re78) neighbor(1) ate ties logit common* 4. 查看匹配后数据list _id _treated _n1 _pscore _pdif _weight in 1/20* 5. 均衡性检验local v2 "age edu black hisp married re74 re75 u74 u75"pstest $v2, both graph* 6. 共同取值范围图示psgraph* 7. 核密度函数图 - 匹配前twoway (kdensity _pscore if _treat==1, legend(label(1 "Treat"))) /// (kdensity _pscore if _treat==0, legend(label(2 "Control"))), /// xtitle(Pscore) title("Before Matching")* 8. 核密度函数图 - 匹配后twoway (kdensity _pscore if _treat==1, legend(label(1 "Treat"))) /// (kdensity _pscore if _weight!=1 & _weight!=., legend(label(2 "Control"))), /// xtitle(Pscore) title("After Matching")```### 示例 2:多种匹配方法对比```statalocal v1 "t"local v2 "age edu black hisp married re74 re75 u74 u75"global x "`v1' `v2'"* 最近邻匹配,k=1psmatch2 $x, out(re78) neighbor(1) ate ties logit commondisplay "1:1 匹配 ATT = " r(att)* 最近邻匹配,k=4psmatch2 $x, out(re78) neighbor(4) ate ties logit commondisplay "1:4 匹配 ATT = " r(att)* 半径匹配psmatch2 $x, out(re78) radius caliper(0.01) ate ties logit commondisplay "半径匹配 ATT = " r(att)* 核匹配(默认核函数和带宽)psmatch2 $x, out(re78) kernel ate ties logit common quietlydisplay "核匹配 ATT = " r(att)```### 示例 3:使用 teffects 对比```stata* psmatch2 方法psmatch2 t age edu black hisp married re74 re75 u74 u75, /// out(re78) neighbor(1) ate ties logit common* teffects psmatch 方法teffects psmatch (re78) (t age edu black hisp married re74 re75 u74 u75, logit), /// atet nneighbor(1)```## 完整分析模板```stata*-------------------------------------------------------------------------------* 倾向匹配得分完整分析模板*-------------------------------------------------------------------------------* 1. 外部命令配置ssc install psmatch2, replacewhich psmatch2* 2. 加载范例数据use "ldw_exper.dta", cleardescribe* 3. 描述性分析tabulate t, summarize(re78) means standard* 4. 设定宏变量local v1 "t"local v2 "age edu black hisp married re74 re75 u74 u75"global x "`v1' `v2'"* 5. 倾向匹配得分 - 1:1 匹配psmatch2 $x, out(re78) neighbor(1) ate ties logit common* 6. 均衡性检验pstest $v2, both graph* 7. 共同取值范围psgraph* 8. 最近邻匹配,k=4psmatch2 $x, out(re78) neighbor(4) ate ties logit common* 9. 计算倾向得分sum _pscore* 10. 半径匹配psmatch2 $x, out(re78) neighbor(4) caliper(0.01) ate ties logit common* 11. 核匹配,使用默认的核函数和带宽psmatch2 $x, out(re78) kernel ate ties logit common quietly*-------------------------------------------------------------------------------```## 注意事项- **匹配方法选择**: - 最近邻匹配(Neighbor):最常用,`neighbor(1)` 为 1:1 匹配 - 半径匹配(Radius):匹配所有在卡尺内的对照 - 核匹配(Kernel):使用加权平均,效率更高 - 局部线性回归匹配(LLR):边界性质更好- **模型选择**: - 默认使用 probit 模型 - 使用 `logit` 选项指定 logit 模型- **均衡性检验**: - `pstest` 主要对连续变量有效 - 对分类变量建议使用 χ² 检验或秩和检验 - 匹配后标准化偏差应 < 5%- **卡尺选择**: - 常见经验法则:卡尺 = 0.25 × 倾向得分标准差 - 可通过敏感性分析测试不同卡尺值## 参见 / Also See- **相关内置命令**:`teffects psmatch`- **相关社区软件包**: - `pscore`:倾向得分估计 - `nnmatch`:最近邻匹配 - `cem`:广义精确匹配(Coarsened Exact Matching) - `rbounds`:敏感性分析【可回放+可复现】2026Stata寒假班-- AI × Stata2.0 红宝书