ARTICLE · 998975
AI 编程与软件复杂度的流动——两个经典理论的当代重读
关于 AI 编程,网络上流传着一些说法:
• 程序员会消失——AI 都会写代码了,还要工程师做什么; • 人人都可以编写软件——几句话就能生成一个应用,软件工程时代结束了; • AI 写的代码不可维护——交给它,迟早变成没人敢碰的屎山。
过于简单、绝对化的说法总是很有传播的效果,却也令人生疑。今天,我们站在软件复杂度的视角,重读软件工程的两个经典理论——Brooks 的复杂度二分与 Tesler 的复杂度守恒定律:前者回答"复杂度能否消除",后者回答"复杂度能否转移"。希望对以上问题能有更深的认识。
一、Brooks:有些复杂度,消不掉
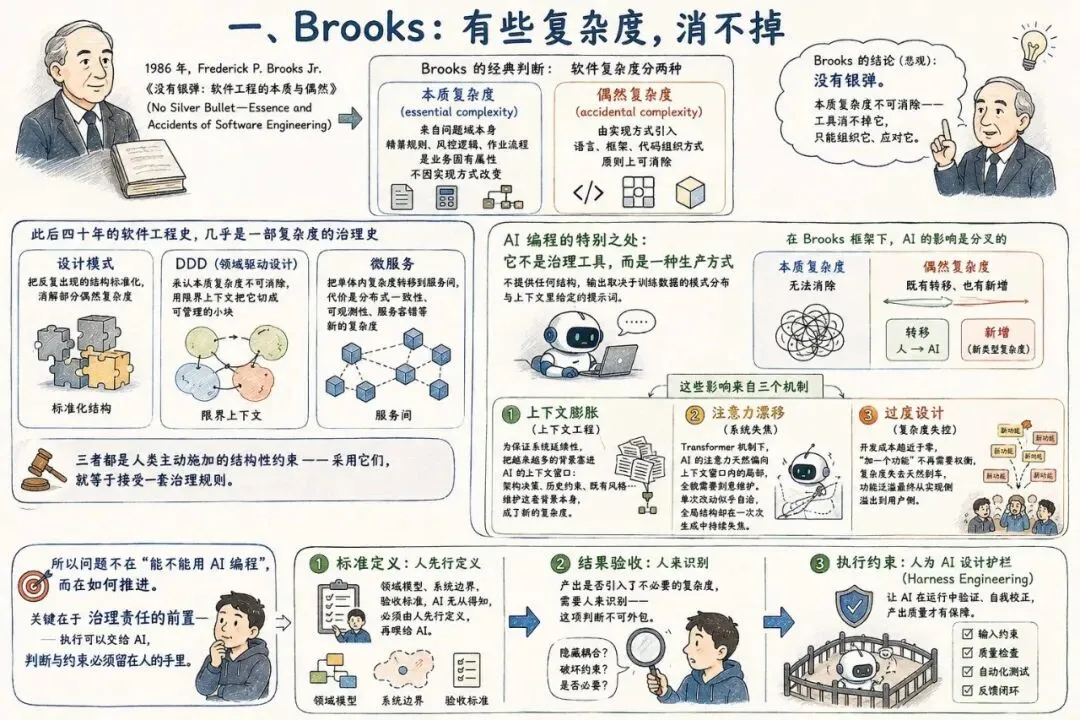
1986 年,Frederick P. Brooks Jr. 在《没有银弹:软件工程的本质与偶然》(No Silver Bullet—Essence and Accidents of Software Engineering)中提出一个至今仍是主流的判断:
软件的复杂度分两种。本质复杂度(essential complexity)来自问题域本身——精算规则、风控逻辑、作业流程,是业务固有属性,不因实现方式改变;偶然复杂度(accidental complexity)由实现方式引入——语言、框架、代码组织方式,原则上可消除。
Brooks 的结论是悲观的:没有银弹。本质复杂度不可消除——工具消不掉它,只能组织它、应对它。
此后四十年的软件工程史,几乎是一部复杂度的治理史。涌现了很多工具,例如:
• 设计模式:把反复出现的结构标准化,消解部分偶然复杂度; • DDD(领域驱动设计):承认本质复杂度不可消除,用限界上下文把它切成可管理的小块; • 微服务:把单体内复杂度转移到服务间,代价是分布式一致性、可观测性、服务容错等新的复杂度。
三者都是人类主动施加的结构性约束——采用它们,就等于接受一套治理规则。
AI 编程的特别之处在于,它不是治理工具,而是一种生产方式:不提供任何结构,输出取决于训练数据的模式分布与上下文里给定的提示词。因此在 Brooks 框架下,它对两类复杂度的影响是分叉的——本质复杂度无法消除,偶然复杂度则既有转移、也有新增。这些影响来自三个机制:
1. 上下文膨胀:为了保证系统的延续性,我们得把越来越多的背景塞进 AI 的上下文窗口——架构决策、历史约束、既有风格;维护这套背景本身,成了新的复杂度(上下文工程,Context Engineering)。 2. 注意力漂移:Transformer 机制下,AI 的注意力天然偏向上下文窗口内的局部,系统全貌需要刻意维护,才能保持在它的视野里。这导致单次改动似乎总能自洽,而全局结构却在一次次生成中持续失焦。 3. 过度设计:开发成本趋近于零之后,"加一个功能"不再需要权衡,复杂度失去天然刹车,功能泛滥最终从实现侧溢出到用户侧。
所以问题不在"能不能用 AI 编程",而在如何推进。其关键在于治理责任的前置——执行可以交给 AI,判断与约束必须留在人的手里:
• 标准定义:领域模型、系统边界、验收标准,AI 无从得知,必须由人先行定义,再喂给 AI; • 结果验收:产出是否引入了不必要的复杂度,需要人来识别——这项判断不可外包; • 执行约束:人负责为 AI 设计护栏(Harness Engineering)——让 AI 在运行中验证、自我校正,产出质量才有保障。
二、Tesler:复杂度不消失,只换人承担
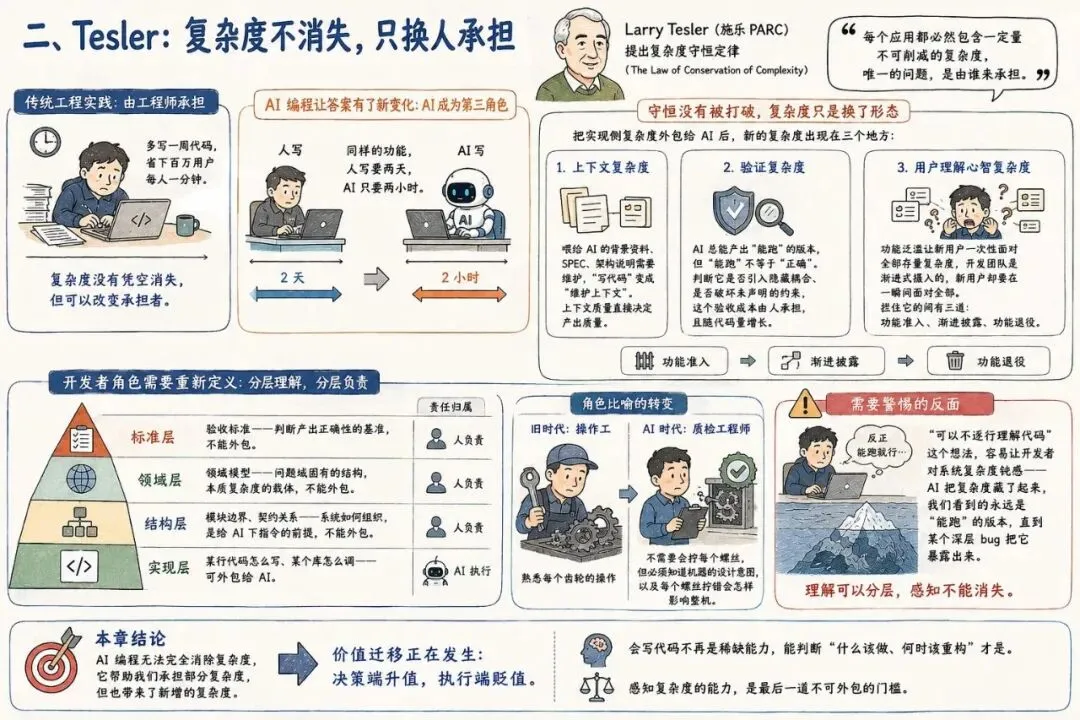
1980 年代初,Larry Tesler 在施乐 PARC 提出复杂度守恒定律(The Law of Conservation of Complexity):
每个应用都必然包含一定量不可削减的复杂度,唯一的问题,是由谁来承担。
传统工程实践的回答是工程师——多写一周代码,省下百万用户每人一分钟。复杂度没有凭空消失,但可以改变承担者。
AI 编程让这个答案有了新的变化——它成为了用户与开发者之外的第三角色。实现侧的复杂度,现在可以由 AI 承担:同样的功能,人写要两天,AI 只要两小时。
然而守恒没有被打破,复杂度只是换了形态。把实现侧复杂度外包给 AI 后,新的复杂度出现在三个地方:
• 上下文复杂度:喂给 AI 的背景资料、SPEC、架构说明需要维护,"写代码"变成"维护上下文",上下文质量直接决定产出质量; • 验证复杂度:AI 总能产出"能跑"的版本,但"能跑"不等于"正确"——判断它是否引入了隐藏耦合、是否破坏了未声明的约束,这个验收成本由人承担,且随代码量增长; • 用户理解心智复杂度:功能泛滥让新用户一次性面对全部存量复杂度:开发团队对需求是渐进式摄入的,每次加一点门槛不高;新用户则要在一瞬间面对全部——拦住它的闸有三道:功能准入、渐进披露、功能退役。
于是,开发者角色需要重新定义:不再强调对代码逐行级的了解,但必须对系统保持分层理解:
• 实现层:某行代码怎么写、某个库怎么调——可外包给 AI; • 结构层:模块边界、契约关系——系统如何组织,是给 AI 下指令的前提,不能外包; • 领域层:领域模型——问题域固有的结构,本质复杂度的载体,不能外包; • 标准层:验收标准——判断产出正确性的基准,不能外包。
旧时代的开发者是熟悉每个齿轮的操作工,AI 时代的开发者更像质检工程师——不需要会拧每个螺丝,但必须知道机器的设计意图,以及每个螺丝拧错会怎样影响整机。
这里有一个需要警惕的反面:恰恰是"可以不逐行理解代码"这个想法,容易让开发者对系统复杂度钝感——AI 把复杂度藏了起来,我们看到的永远是"能跑"的版本,直到某个深层 bug 把它暴露出来。理解可以分层,感知不能消失。
结语
AI 编程无法完全消除复杂度,它帮助我们承担部分复杂度,但也带来了新增的复杂度。
对于开发者来说,价值的迁移正在发生:决策端升值,执行端贬值。 会写代码不再是稀缺能力,能判断"什么该做、何时该重构"才是。感知复杂度的能力,是最后一道不可外包的门槛。