ARTICLE · 998977
删掉的文档还能被搜出来:我用 24 毫秒给索引做了个体检
上一篇讲了 BM25 的 5 个坑,检索终于把正确答案排到第 1 名了。我以为能消停一阵。
结果没过几天,同事跑来问我一件事:他把一篇部署文档整个删了,可在知识库里搜相关问题时,那篇文档照样出现在候选列表里,点进去才报错。
我第一反应是不信。查了一遍才确认:索引里还留着那篇文档的完整记录,磁盘上的文件早没了。
更要命的是,这个过程没有任何报错。检索照常返回候选,分数照常好看,直到你真的去读内容,才抛一个 FileNotFoundError。
我给这种东西起了个名字,叫幽灵文档。它是索引过期最狠的一种症状,因为它不是「查不到」,而是「查到了一个不存在的东西」——你以为它有,它其实早没了。
三类症状,一个共同点:不报错
索引过期不是一个 bug,是三类。我把它们全踩了一遍:
| 改 | 改了内容查不到 |
| 增 | 新增文档不可见 |
| 删 | 删除后返回幽灵文档 |
这三类症状的共同点很讨厌:全都不报错。没有异常、没有警告、没有红色日志。它们只是安静地给你一个错的结果。缺失会被发现,错误会被执行——这话我在系列一里说过,在索引这一层照样成立。
为什么会这样:索引是快照,不是活视图
根因只有一句话:索引是磁盘在某一时刻的投影,不是一个实时视图。
建索引那一刻,我扫了全库的 Markdown,解析 frontmatter 和正文,算好 BM25 需要的词频、字段长度、df 统计,写进一个 kb-index.json。之后所有的检索,都发生在这份快照上。
这是必须的设计。因为检索要快,就得把能预计算的东西全预计算掉(系列二里那个 48.7 秒降到毫秒级的优化,靠的就是这个)。可一旦预计算了,索引和磁盘之间就有了距离。你改磁盘,索引不会自己知道。
所以问题不是「要不要快照」,而是「快照什么时候过期,你怎么知道」。
天真方案:每次查询都重扫全库
最直觉的解法是:别存快照了,每次查询前重新扫一遍全库,现算现用。
我认真算过这笔账。在我的知识库(184 篇)上,一次全量扫描意味着:读 184 个文件、解析 frontmatter、对每个字段做中英文混合分词、重建倒排和 BM25 统计。系列二里测过,光是分词这一项,184 篇 × 7 字段 ≈ 每次 1.2 万次 tokenize。全量跑一次是几十秒量级。
注意,是判断「是否不一致」,不是「把不一致修好」。前者可以很便宜,后者才需要重建索引。这两件事必须分开——检测到过期只是提醒你该重建了,检测本身不该顺手把活干了。
三个字段,够用了:mtime_ns + size + content_hash
我的解法是给每篇文档记一份磁盘指纹,建索引的时候顺手写进去。反正 collect 阶段本来就要读文件,多一次 os.stat 和一次哈希的成本可以忽略。
为什么是三个,不是一个?
只存 content_hash 行不行?理论上最准,内容变了哈希一定变。但算哈希得把文件全文读一遍。检测一次要读 184 个文件的全文,这就把「便宜」这个前提丢了——我想要的检测成本是毫秒级,不是重新读一遍全库。
只存 mtime_ns 行不行?很便宜,os.stat 一下就行。但 mtime 会说谎,而且是常态说谎,后面那一节细说。
所以是三者的组合:mtime_ns + size 做快路径,绝大多数文档在这一步就判定「没变」,根本不用读文件;只有快路径说「可能变了」的少数派,才走慢路径——读全文算哈希,用 content_hash 决胜。
哈希用的是 blake2b,摘要长度取 16 字节。128 位对个人知识库这个量级足够,而且 Python 标准库就有,不引入任何第三方依赖。
三向比对:changed / deleted / added
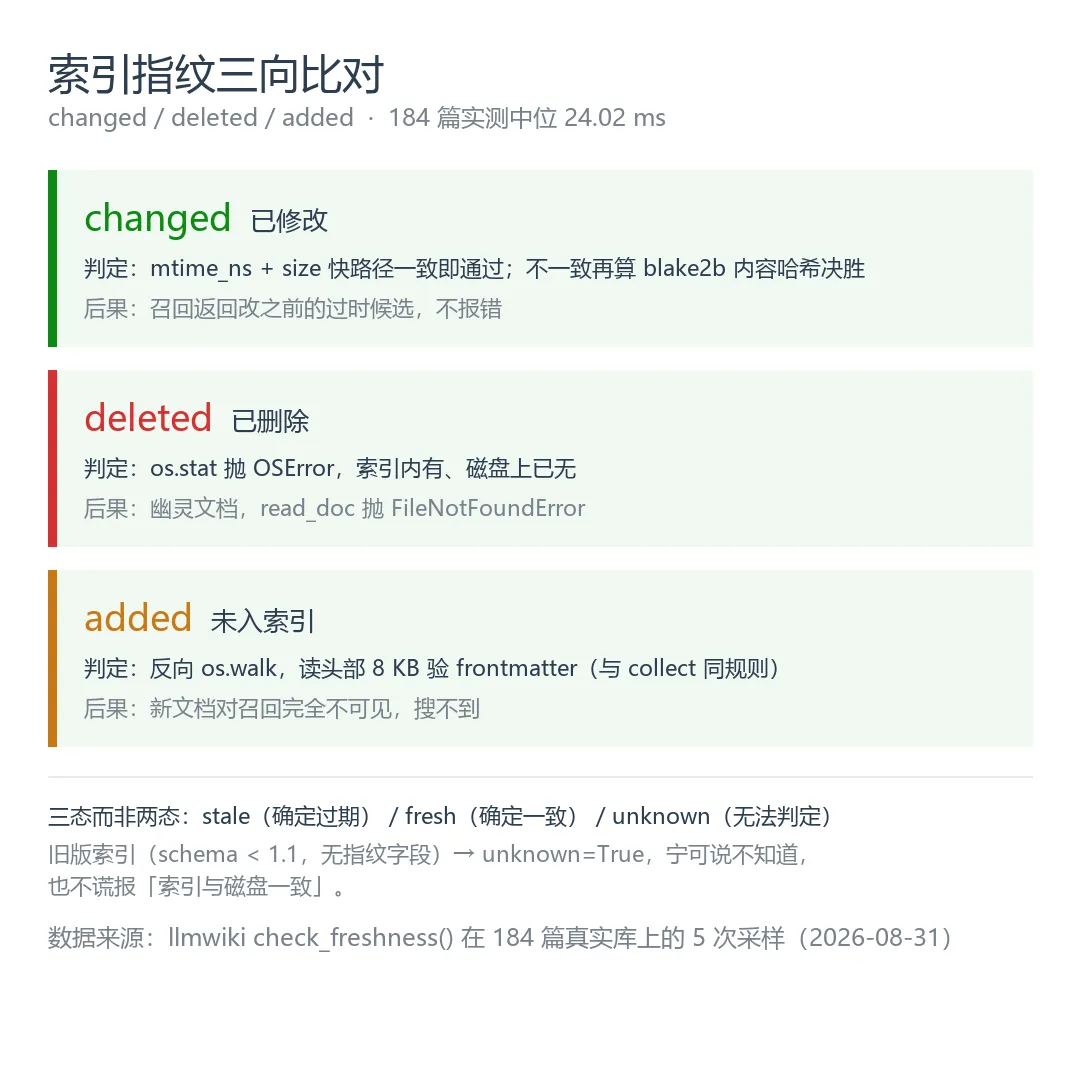
有了指纹,检测就是一次三向比对。注意方向——不是单向「检查索引里的文档」,而是两个方向都要扫:
changed(索引内有、内容变了):遍历索引里的文档,逐个比对磁盘指纹。文件 stat 不到就算 deleted,指纹不一致再算哈希决胜。
deleted(索引内有、磁盘上没了):os.stat 抛 OSError 就归到这一类。这就是幽灵文档的来源。
added(磁盘上有、索引里没有):这个方向容易漏。得反过来 os.walk 全库,找出所有不在索引里的 .md。但不能见一个 .md 就算——仓库里的 CHANGELOG.md、CONTRIBUTING.md 这些没有 frontmatter 的附带文件不算数。所以判定规则要和建索引时的 collect 保持一致:读文件头部 8 KB,用同样的 frontmatter 正则验一遍,匹配上才算 added。
三向合一,任何一类非空就是 stale=True。
真正的坑:只看 mtime,会常态误报
上面的设计里,最容易想错的地方是「慢路径到底有没有必要」。我一开始也觉得 mtime + size 够了,直到被现实教育。
git 会刷新 mtime。你 git checkout 切个分支、git pull 拉一下代码、或者把文件恢复了——文件内容一个字没变,但 mtime 全被刷新了。这时候如果只看 mtime,系统会理直气壮地告诉你:「你有 100 多篇文档都改过了,赶紧重建索引吧。」
实际上呢?一个字都没改。
这不是边缘场景,这是每天都会发生的常态工作流。一个天天喊狼来了的检测,很快就会被你忽略——然后真出事那天,你也不会看它了。
所以我做了个对照实验。在隔离沙箱里建 6 篇文档,建好索引,然后只对其中一篇执行 touch(刷新 mtime,内容一字不改),再看两种判定方式的差异:
(顺带说一句,对照结果里的 category-index.md 是个特殊角色,下面单独讲。)这 1 条规则的价值,比前面所有代码加起来都大。检测系统的可信度不取决于它多灵敏,而取决于它多不撒谎。
实测:184 篇,24 毫秒
设计定完,我最关心的是成本。检测如果本身很贵,就只能偶尔跑一次,那就失去了意义——我想要的是「每次查询前都能顺手查一下」。
在我的真实知识库上实测(184 篇,schema 1.1):
沙箱实录:四类场景逐个验
数字好看不代表抓得住问题。我在隔离沙箱里把四类场景全跑了一遍,下面是真实输出,没做任何修饰。
场景 1:改了一篇内容
场景 2:删了一篇文件
场景 3:新增一篇文档
三类同时命中,摘要句把它们合并成一句话:索引已过期:1 篇已修改、1 篇未入索引、1 篇已删除。这句文案是直接给用户看的,所以必须写清楚每一类的数量,不能只说「索引已过期」。
场景 4:touch 刷新 mtime(内容未变)
不该报的没报。这条和场景 1-3 同样重要。
那个必须豁免的文件:category-index.md
工程里有个细节,不处理就会天天误报。
category-index.md 是分类导航页,由 gen_index 在 collect 之后写盘的——也就是说,它是索引的派生产物,不是输入。
这会制造两个假信号:第一次建索引时它还没生成,检测会报它「未入索引」(假 added);之后再重建,它的内容由同一份 collect 结果决定,但写盘时间晚于快照,又会报「已修改」(假 changed)。内容其实完全由同一份数据决定,报它没有任何意义,只会污染信号。
所以代码里给它开了个豁免,按 kind 字段识别:
规则很简单:派生产物不参与过期判定。它不是输入,不该被当成输入来监控。
旧索引怎么办:宁可说不知道,不能说没问题
还有个兼容问题。指纹是 schema 1.1 才加的,那 1.0 时代建的索引里根本没有 mtime_ns 字段。
最危险的处理方式是「字段缺失就当没变」——那等于对着一堆没有指纹的旧索引,每次都自信满满地报告「索引与磁盘一致」。这是撒谎,比不检测还糟,因为它给了你虚假的安全感。
我的处理是引入第三个状态 unknown:
索引里一篇指纹都没有 → unknown=True,明确告诉你「这索引是旧版生成的,我判断不了,请重建后再说」。三态而不是两态:stale(确定过期)、fresh(确定一致)、unknown(无法判定)。第三个状态是这类检测系统的诚实底线。
检测到之后:告警,但不阻断
检测到过期,下一步该干什么?
我的选择是只告警,不阻断。CLI 里是这样的:
为什么不直接自动重建?两个原因。
一是成本不对称。重建索引是几十秒的事,检测是 24 毫秒的事。让每次查询都承担几十秒,不合理。
二是语义问题。索引过期意味着结果「可能」过时,不意味着「一定」错。你改的那篇文档,跟当前这个查询可能毫无关系。因为一个无关文档的变更,就拒绝回答用户的问题,这是过度反应。
所以正确的做法是:把信息交给人,让人决定。命令行打一行警告;长驻服务(比如微信桥接)把它作为一个字段返回,前端自己决定要不要提示。
还有个细节:长驻进程不能只查一次。服务启动时的检测结果,几个小时后可能就过时了。所以检测做成了可重入的方法,长驻进程可以在每个请求上重新调用一次——反正只要 24 毫秒。
库层保持安静——不打印、不抛错、不自己决定怎么办。检不检测、检出来告不告警,交给调用方。这是库该有的分寸。
回头看:这类问题为什么难发现
写完这个 feature 之后我复盘了一下,索引过期这类问题之所以容易被忽略,是因为它有三个特点叠加:
它不报错。没有异常栈,没有红色告警,你不会在日志里看到它。它是「沉默的正确」——系统以为自己是对的。
它的症状看起来像别的问题。改了内容查不到,你会以为是检索算法不行(我一度真的回头去调 BM25 参数);新增文档搜不着,你会以为是分词没覆盖。真正的根因在完全另一个层面。
它在小规模时不明显。库里 10 篇文档的时候,你记得住改了什么,也不太依赖检索。等你攒到快 200 篇、开始真正依赖它回答问题的时候,它才变成一个问题——而那时候你已经习惯了它的存在。
下一篇
系列四讲多通道接入:同一份知识库,怎么同时接进微信、企业微信、飞书和 Telegram,以及长驻进程里那些只有在跑起来之后才会暴露的问题。
如果你也在做知识库或 RAG,建议现在就给自己的索引加一次检测。成本是 24 毫秒,收益是——你终于知道自己的检索结果还作不作数。
把这篇转发给正在搭知识库的同事,他们大概率也在用一份自己都不知道有多旧的索引。如果对你有帮助,欢迎关注我的微信公众号「王小c」,回复「llmwiki」领取开源地址和快速上手命令。