第七讲:查找
主讲人:刘财政
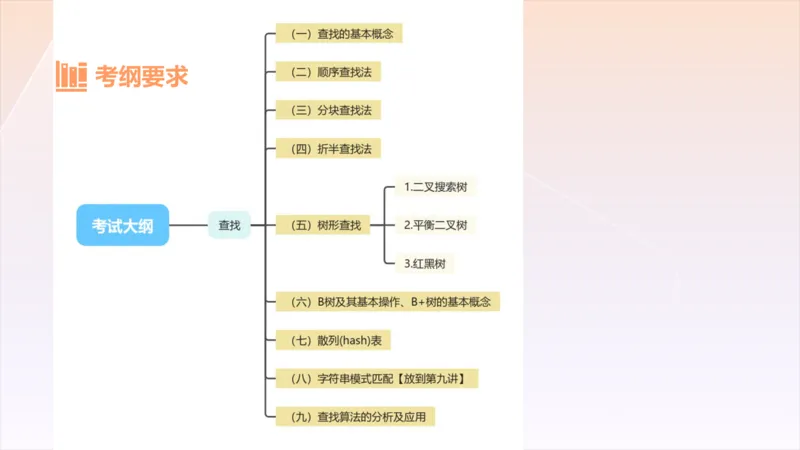
B站:@计算机考研刘财政考纲要求CON T EN T S
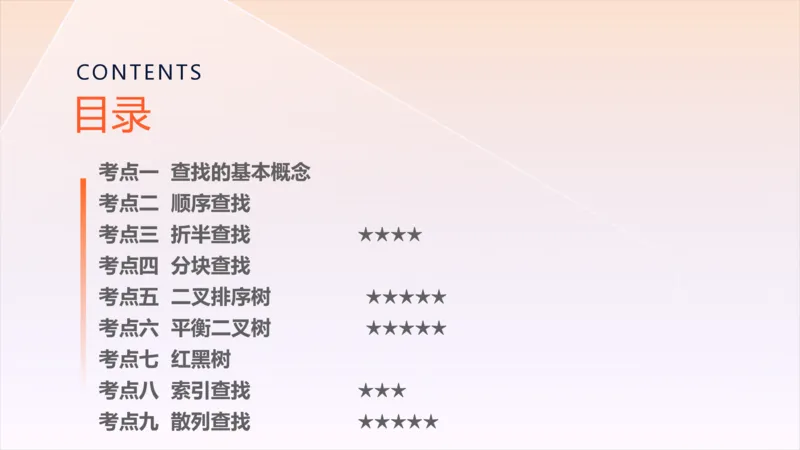
目录
考点一 查找的基本概念
考点二 顺序查找
考点三 折半查找 ★★★★
考点四 分块查找
考点五 二叉排序树 ★★★★★
考点六 平衡二叉树 ★★★★★
考点七 红黑树
考点八 索引查找 ★★★
考点九 散列查找 ★★★★★CON T EN T S
目录
考点一 查找的基本概念
考点二 顺序查找
考点三 折半查找 ★★★★
考点四 分块查找
考点五 二叉排序树 ★★★★★
考点六 平衡二叉树 ★★★★★
考点七 红黑树
考点八 索引查找 ★★★
考点九 散列查找 ★★★★★考点框架考点框架
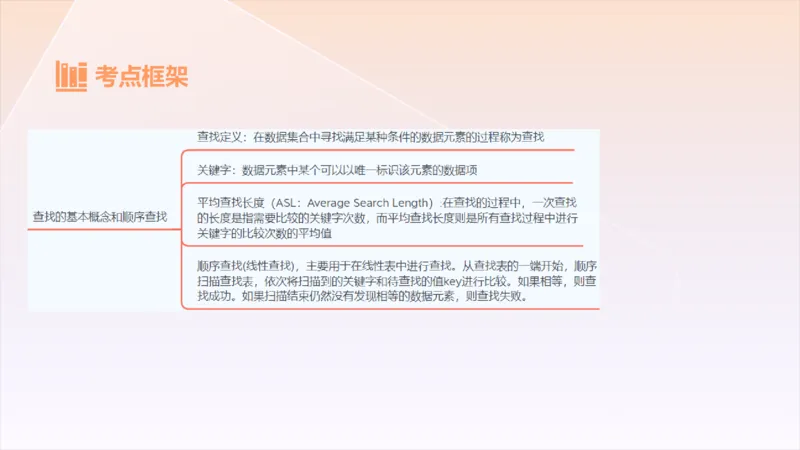
查找的基本概念
查找的分类
查找的性能计算【查找的基本概念】考点一: 查找的基本概念
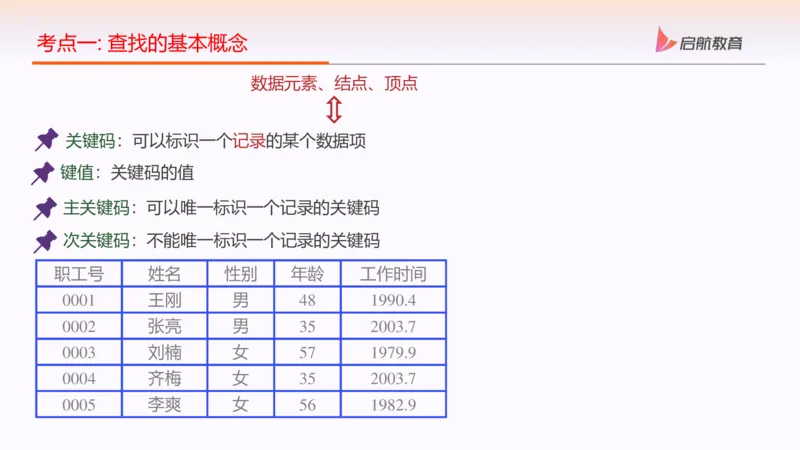
数据元素、结点、顶点
关键码:可以标识一个记录的某个数据项
键值:关键码的值
主关键码:可以唯一标识一个记录的关键码
次关键码:不能唯一标识一个记录的关键码
职工号 姓名 性别 年龄 工作时间
0001 王刚 男 48 1990.4
0002 张亮 男 35 2003.7
0003 刘楠 女 57 1979.9
0004 齐梅 女 35 2003.7
0005 李爽 女 56 1982.9考点一: 查找的基本概念
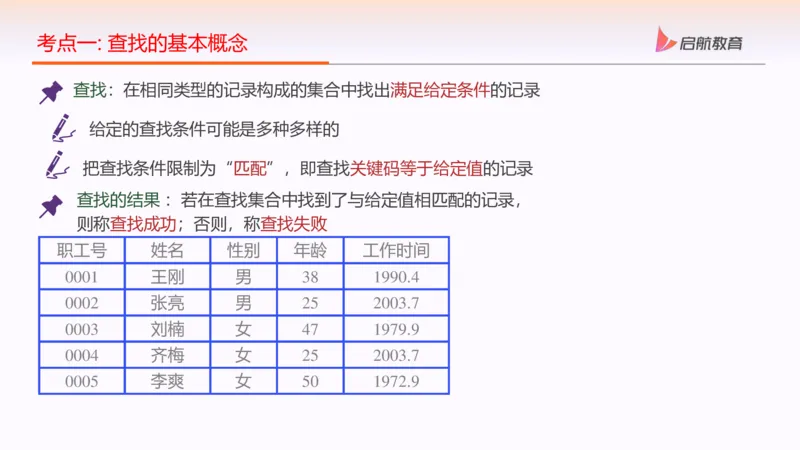
查找:在相同类型的记录构成的集合中找出满足给定条件的记录
给定的查找条件可能是多种多样的
把查找条件限制为“匹配”,即查找关键码等于给定值的记录
查找的结果 :若在查找集合中找到了与给定值相匹配的记录,
则称查找成功;否则,称查找失败
职工号 姓名 性别 年龄 工作时间
0001 王刚 男 38 1990.4
0002 张亮 男 25 2003.7
0003 刘楠 女 47 1979.9
0004 齐梅 女 25 2003.7
0005 李爽 女 50 1972.9考点一: 查找的基本概念
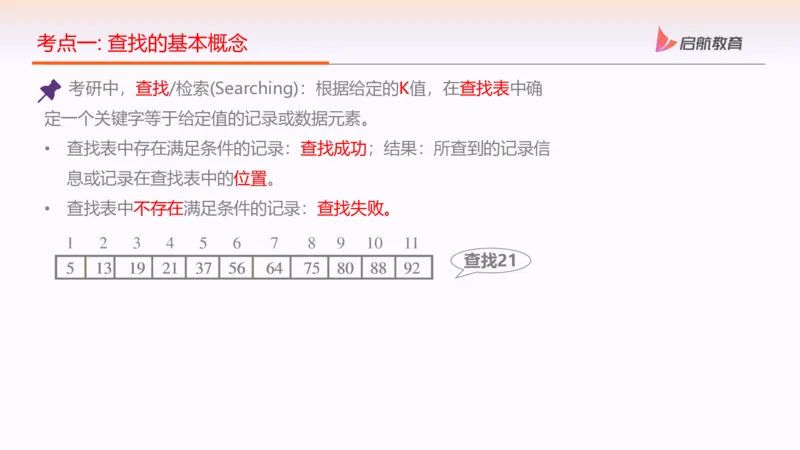
考研中,查找/检索(Searching):根据给定的K值,在查找表中确
定一个关键字等于给定值的记录或数据元素。
• 查找表中存在满足条件的记录:查找成功;结果:所查到的记录信
息或记录在查找表中的位置。
• 查找表中不存在满足条件的记录:查找失败。
1 2 3 4 5 6 7 8 9 10 11
查找21
55 1133 1199 2211 3377 5566 6644 7755 8800 8888 9922【查找的分类】考点一: 查找的基本概念
静态查找 :不涉及插入和删除操作的查找
静态查找只注重查找效率,适用于:
(1)查找集合一经生成,便只对其进行查找,而不进行插入和删除操作
(2)经过一段时间的查找之后,集中地进行插入和删除等修改操作考点一: 查找的基本概念
动态查找 :涉及插入和删除操作的查找
动态查找要求插入、删除、查找均有较好的效率,适用于:查找与插
入和删除操作在同一个阶段进行
例如:当查找成功时,要删除查找到的记录
当查找不成功时,要插入被查找的记录考点一: 查找的基本概念
查找结构 :面向查找操作的数据结构 ,即查找基于的数据结构
已经有了数据结构的概念,为什么要强调查找结构?
(1)几乎所有的数据结构都提供了查找作为基本操作,但对于数据结
构整体来说,查找并不是最重要的操作
(2)对于查找结构来说,查找是最重要的基本操作,重要的是查找效率
(3)数据结构 + 算法 = 程序:不同的查找结构,会获得不同的查找效率
查找结构 查找方法考点一: 查找的基本概念
查找基于的数据模型是什么? 集合
线性表:适用于静态查找,顺序查找、折半查找等技术
集合 树 表:适用于动态查找,二叉排序树的查找技术
散列表:静态查找和动态查找均适用,采用散列技术
注意到,都是把集合组织成XXX表,为什么?
理解起来,集合最常用的表示法是列举法,习惯上,也称为表考点一: 查找的基本概念
根据存储结构的不同,查找方法可分为四大类:
① 顺序表的查找:将给定的K值与查找表中记录的关键字进行比较, 找
到要查找的记录;
② 链表的查找:将给定的K值与查找表中记录的关键字逐个进行比较,
找到要查找的记录;
③ 散列表的查找:根据给定的K值直接访问查找表, 从而找到要查找的
记录;
④ 索引表的查找:首先根据索引确定待查找记录所在的块 ,然后再从块
中找到要查找的记录【查找的性能计算】考点一: 查找的基本概念
查找结构最关注的是什么? 查找效率
如何评价查找算法的效率呢? 和关键码的比较次数
关键码的比较次数与哪些因素有关呢?
平均查找长度:查找算法进行的关键码比较次数的数学期望值
其中:n:问题规模,查找集合中的记录个数
n
ASL = p c p:查找第 i个记录的概率
i i i
i = 1 c:查找第 i个记录所需的关键码的比较次数
i考点一: 查找的基本概念
• 成功情况下(概率相等)的平均查找长度ASL 是指找到T中任一元
成功
素平均需要的关键字比较次数。
• 例如,n=9:
关键字 5 1 4 8 7 9 2 4 3
找到时的比较
1 2 3 4 5 6 7 8 9
次数
1+2+3+4+5+6+7+8+9
ASL = = 5
成功
9考点一: 查找的基本概念
• 不成功情况下的平均查找长度ASL 是指查找失败(在T中未查找到)平均
不成功
需要的关键字比较次数。
x T
通过关键字比较后确定不在T中
平均关键字比较次数
• 例如,n=9:
关键字 5 1 4 8 7 9 2 4 3
找到时的比
1 2 3 4 5 6 7 8 9
较次数
• 按顺序查找, ASL =n=9
不成功考点一: 查找的基本概念
• 成功情况下(概率相等)的平均查找长度ASL 是指找到T中任一元素平均需
成功
总的比较次数
1
要的关键字比较次数,即:ASL = =
σ𝑛
𝐶
成功 元素个数 𝑛 𝑖=1 𝑖
• C :查找第i个记录需要进行比较的次数;n是元素个数。
i
• 不成功情况下的平均查找长度ASL 是指查找失败(在T中未查找到)平均
不成功
总的比较次数
1
需要的关键字比较次数,即 ASL = =
σ𝑘
𝐶
不成功 不成功的情形个数 𝑘 𝑖=1 𝑖
• C :查找第i个记录需要进行比较的次数;k是不成功的情形的个数。
iTHANKSCON T EN T S
目录
考点一 查找的基本概念
考点二 顺序查找
考点三 折半查找 ★★★★
考点四 分块查找
考点五 二叉排序树 ★★★★★
考点六 平衡二叉树 ★★★★★
考点七 红黑树
考点八 索引查找 ★★★
考点九 散列查找 ★★★★★考点框架考点框架
顺序查找的概念
查找的性能计算【顺序查找的概念】考点二: 顺序查找
顺序查找(线性查找):从线性表的一端向另一端逐个将记录与
给定值进行比较,若相等,则查找成功,给出该记录在表中的位
置;若整个表检测完仍未找到与给定值相等的记录,则查找失败,
给出失败信息
查找64
0 1 2 3 4 5 6 7 8 9 10
5 13 19 21 37 56 64 75 80 88 92
p
顺序查找示例考点二: 顺序查找
顺序查找(线性查找):从线性表的一端向另一端逐个将记录与
给定值进行比较,若相等,则查找成功,给出该记录在表中的位
置;若整个表检测完仍未找到与给定值相等的记录,则查找失败,
给出失败信息
查找64
0 1 2 3 4 5 6 7 8 9 10
5 13 19 21 37 56 64 75 80 88 92
p
顺序查找示例考点二: 顺序查找
顺序查找(线性查找):从线性表的一端向另一端逐个将记录与
给定值进行比较,若相等,则查找成功,给出该记录在表中的位
置;若整个表检测完仍未找到与给定值相等的记录,则查找失败,
给出失败信息
查找64
0 1 2 3 4 5 6 7 8 9 10
5 13 19 21 37 56 64 75 80 88 92
p
顺序查找示例考点二: 顺序查找
顺序查找(线性查找):从线性表的一端向另一端逐个将记录与
给定值进行比较,若相等,则查找成功,给出该记录在表中的位
置;若整个表检测完仍未找到与给定值相等的记录,则查找失败,
给出失败信息
查找64
0 1 2 3 4 5 6 7 8 9 10
5 13 19 21 37 56 64 75 80 88 92
p
顺序查找示例考点二: 顺序查找
顺序查找(线性查找):从线性表的一端向另一端逐个将记录与
给定值进行比较,若相等,则查找成功,给出该记录在表中的位
置;若整个表检测完仍未找到与给定值相等的记录,则查找失败,
给出失败信息
查找64
0 1 2 3 4 5 6 7 8 9 10
5 13 19 21 37 56 64 75 80 88 92
p
顺序查找示例考点二: 顺序查找
顺序查找(线性查找):从线性表的一端向另一端逐个将记录与
给定值进行比较,若相等,则查找成功,给出该记录在表中的位
置;若整个表检测完仍未找到与给定值相等的记录,则查找失败,
给出失败信息
0 1 2 3 4 5 6 7 8 9 10 查找64
5 13 19 21 37 56 64 75 80 88 92
p
顺序查找示例考点二: 顺序查找
顺序查找(线性查找):从线性表的一端向另一端逐个将记录与
给定值进行比较,若相等,则查找成功,给出该记录在表中的位
置;若整个表检测完仍未找到与给定值相等的记录,则查找失败,
给出失败信息
0 1 2 3 4 5 6 7 8 9 10 查找64
5 13 19 21 37 56 64 75 80 88 92
p
顺序查找示例考点二: 顺序查找
int SeqSearch(int a[], int n, int key) {
for (int i = 0; i < n; ++i) {
if (a[i] == key) {
return i; // 找到key,返回下标
}
}
return -1; // 未找到key,返回-1
}
查找成功:
n n
n +1
p c = p (n − i +1) = = O(n)
i i i
2
i=1 i=1
查找不成功:
n +1 = O(n)考点二: 顺序查找
• 可以在R的末尾增加一个关键字为k的元素,称之为哨兵。
• 增加哨兵后查找过程不再需要判断i是否超界,从而提高查找速度。考点二: 顺序查找考点二: 顺序查找【查找的性能计算】考点二: 顺序查找考点二: 顺序查找考点二: 顺序查找
0 1 2 3 4 5 6 7 8 9 10
查找64
5 13 19 21 37 56 64 75 80 88 92
p
p
顺序查找示例
比较次数:
查找第1个元素: 1
……….
查找第i个元素: i
查找第n个元素: n
查找失败: n+1考点二: 顺序查找
int SeqSearch(int a[], int n, int key) {
for (int i = 0; i < n; ++i) {
if (a[i] == key) {
return i; // 找到key,返回下标
}
}
return -1; // 未找到key,返回-1
}
查找成功:
n n
n +1
p c = p (n − i +1) = = O(n)
i i i
2
i=1 i=1
查找不成功:
n +1 = O(n)考点二: 顺序查找
顺序查找的缺点:查找效率较低
特别是当待查找集合中元素较多时,不推荐使用顺序查找
顺序查找的优点:算法简单而且使用面广
(1)对表中记录的存储没有任何要求,顺序存储和链接存储均可
(2)对表中记录的有序性也没有要求,无论记录是否按关键码有序均可
0 1 2 3 4 5 6 7 8 9 10
5 13 19 21 37 56 64 75 80 88 92
head
bat cat eat fat hat ⋀THANKSCON T EN T S
目录
考点一 查找的基本概念
考点二 顺序查找
考点三 折半查找 ★★★★
考点四 分块查找
考点五 二叉排序树 ★★★★★
考点六 平衡二叉树 ★★★★★
考点七 红黑树
考点八 索引查找 ★★★
考点九 散列查找 ★★★★★考点框架考点框架
折半查找的概念
折半查找的过程
折半查找的代码实现
折半查找的性能分析【折半查找的概念】考点三: 折半查找
顺序查找(线性查找):从线性表的一端向另一端逐个将记录与给
定值进行比较,若相等,则查找成功,给出该记录在表中的位置;
若整个表检测完仍未找到与给定值相等的记录,则查找失败,给出
失败信息
0 1 2 3 4 5 6 7 8 9 10
查找64
5 13 19 21 37 56 64 75 80 88 92
p p
顺序查找示例考点三: 折半查找
折半查找(对半查找、二分查找):在有序表中,取中间记录作为
比较对象,若给定值与中间记录相等,则查找成功;若给定值小于
中间记录,则在有序表的左半区继续查找;若给定值大于中间记录,
则在有序表的右半区继续查找。不断重复上述过程,直到查找成功,
或查找区域无记录,查找失败
1 2 3 4 5 6 7 8 9 10 11
查找64
5 13 19 21 37 56 64 75 80 88 92
p考点三: 折半查找
折半查找(对半查找、二分查找):在有序表中,取中间记录作为
比较对象,若给定值与中间记录相等,则查找成功;若给定值小于
中间记录,则在有序表的左半区继续查找;若给定值大于中间记录,
则在有序表的右半区继续查找。不断重复上述过程,直到查找成功,
或查找区域无记录,查找失败
1 2 3 4 5 6 7 8 9 10 11
查找64
5 13 19 21 37 56 64 75 80 88 92
p考点三: 折半查找
折半查找(对半查找、二分查找):在有序表中,取中间记录作为
比较对象,若给定值与中间记录相等,则查找成功;若给定值小于
中间记录,则在有序表的左半区继续查找;若给定值大于中间记录,
则在有序表的右半区继续查找。不断重复上述过程,直到查找成功,
或查找区域无记录,查找失败
1 2 3 4 5 6 7 8 9 10 11
查找64
5 13 19 21 37 56 64 75 80 88 92
p考点三: 折半查找
• 折半查找也称为二分查找,要求线性表中的元素必须己按关键字值
有序(递增或递减)排列。
• 思路:
k和R[mid].key比较
R[0] … R[mid] … R[n-1]
k<R[mid].key k>R[mid].key
k=R[mid].key
左区间 成功 右区间【折半查找的过程】考点三: 折半查找
查找21
0 1 2 3 4 5 6 7 8 9 10
5 13 19 21 37 56 64 75 80 88 92
Low Mid High
21 < 56, 因此查找56的左边
(a) 查找示例考点三: 折半查找
查找21
0 1 2 3 4 5 6 7 8 9 10
5 13 19 21 37 56 64 75 80 88 92
Low Mid High
21 > 19, 因此查找19的右边
(a) 查找示例考点三: 折半查找
查找21
0 1 2 3 4 5 6 7 8 9 10
5 13 19 21 37 56 64 75 80 88 92
Low Mid High
21 = 21, 因此查找成功
(a) 查找示例考点三: 折半查找
查找71
0 1 2 3 4 5 6 7 8 9 10
5 13 17 23 38 46 56 65 78 81 92
Low Mid High
71 > 46, 因此查找46的右边
(b) 查找不成功示例考点三: 折半查找
查找71
0 1 2 3 4 5 6 7 8 9 10
5 13 17 23 38 46 56 65 78 81 92
Low Mid High
71 < 78, 因此查找78的左边
(b) 查找不成功示例考点三: 折半查找
查找71
0 1 2 3 4 5 6 7 8 9 10
5 13 17 23 38 46 56 65 78 81 92
Low Mid High
56 < 71, 因此查找56的右边
(b) 查找不成功示例考点三: 折半查找
查找71
0 1 2 3 4 5 6 7 8 9 10
5 13 17 23 38 46 56 65 78 81 92
Low Mid High
56 < 71, 因此查找56的右边
(b) 查找不成功示例考点三: 折半查找
查找71
0 1 2 3 4 5 6 7 8 9 10
5 13 17 23 38 46 56 65 78 81 92
Low High
Mid
65 != 71 ; 查找失败
(b) 查找不成功示例【折半查找的代码实现】考点三: 折半查找
用low,high和mid表示待查找区间的下界、上界和中间位置指针,初值为low =
0,high = n-1。
(1) 取中间位置mid:mid = (low + high) / 2 ;
(2) 比较中间位置记录的关键字与给定的key值:
① 相等: 查找成功;
② 大于:待查记录在区间的前半段,修改上界指针: high = mid - 1,转⑴;
③ 小于:待查记录在区间的后半段,修改下界指针:low = mid + 1,转⑴;
直到越界(low > high),查找失败。其算法实现过程如下,考点三: 折半查找
1 int bin_Search(int a[], int n, int key) { (1) 对 应 代 码 第 1 行 , n = 11 , 数 组
a={5,13,19,21,37,56,64,75,80,88,92},key是21;
2 int low = 0, high = n - 1, mid;
对应第2行high = 10;low = 0;
3 while (low <= high) {
(2) 对应代码第3行,low <= high成立,进入循环。
4 mid = (low + high) / 2;
(3) 对应代码第4行 mid = (0+10)/2 = 5, a[5] = 56 > 21, 对应代码第
5 if (a[mid] == key) return mid;
9和10行,让high = mid -1;此时low = 0;high = 4。如图所示。
6 else if (a[mid] > key) high = mid - 1;
7 else low = mid + 1;
8 }
9 return -1;
10 }考点三: 折半查找
1 int bin_Search(int a[], int n, int key) { (4) 对应代码第3行,此时low = 0,high = 4; low <= high成立,
再次进入循环。
2 int low = 0, high = n - 1, mid;
(5) 对应代码第4行 mid = (0+4)/2 = 2, a[2] = 19 < 21, 对应代码第
3 while (low <= high) {
7和8行,让low = mid +1;此时low = 3;high = 4。如图所示。
4 mid = (low + high) / 2;
5 if (a[mid] == key) return mid;
6 else if (a[mid] > key) high = mid - 1;
7 else low = mid + 1;
8 }
9 return -1;
10 }考点三: 折半查找
1 int bin_Search(int a[], int n, int key) { (6) 对应代码第3行,此时low = 3,high = 4; low <= high成立,
再次进入循环。
2 int low = 0, high = n - 1, mid;
(7) 对应代码第4行 mid = (3+4)/2 = 3, a[3] = 21 = 21, 对应代码第
3 while (low <= high) {
5和6行,返回21的位置3。如图所示。
4 mid = (low + high) / 2;
5 if (a[mid] == key) return mid;
6 else if (a[mid] > key) high = mid - 1;
7 else low = mid + 1;
8 }
9 return -1;
10 }【折半查找的性能分析】考点三: 折半查找
判定树(折半查找判定树):描述折半查找判定过程的二叉树
设查找区间是[low, high],判定树的构造方法:
(1)当low>high时,判定树为空;
(2)当low ≤ high时,判定树的根结点是有序表中序号为
mid=(low+high)/2的记录,根结点的左子树是与有序表r[low]~r[mid-
1]相对应的判定树,根结点的右子树是与有序表r[mid+1] ~ r[high]相对
应的判定树。考点三: 折半查找
当取mid = (low + high) / 2 ;
5 13 17 23 38 46 56 65 78 81 92
Low High
Mid考点三: 折半查找
当取mid = (low + high) / 2 ;
46
< >
=
5 13 17 23 38 56 65 78 81 92
High
Low Mid
Low Mid High考点三: 折半查找
当取mid = (low + high) / 2 ;
< 46 >
=
17 78
<
= > < = >
5 13 23 38 56 65 81 92
Low
High Low High Low High Low High
Mid
Mid Mid Mid考点三: 折半查找
当取mid = (low + high) / 2 ;
< 46 >
=
17 78
<
= > < = >
56
5 23 81
= >
> > > =
=
=
13 38 65 92考点三: 折半查找
当取mid = ⌈(low + high) / 2⌉ ;
5 13 17 23 38 46 56 65 78 81 92
Low Mid
High考点三: 折半查找
当取mid = ⌈(low + high) / 2⌉ ;
46
< >
=
5 13 17 23 38 56 65 78 81 92
Low Mid High
Low Mid High考点三: 折半查找
当取mid = ⌈(low + high) / 2⌉ ;
< 46 >
=
17 78
<
= > < = >
5 13 23 38 56 65 81 92
Low
High Low High Low High Low High
Mid
Mid Mid Mid考点三: 折半查找
当取mid = ⌈(low + high) / 2⌉ ;
< 46 >
=
17 78
<
= >
> < =
65
13 92
< 38
<
<
< =
= = =
5
23 81
56考点三: 折半查找
5 13 17 23 38 46 56 65 78 81 92
当取mid = ⌈(low + high) / 2⌉ ;
当取mid = (low + high) / 2 ;
< 46 >
< 46 >
=
=
17 78
17 78
<
< = > < = > = > < = >
5 23 56 81 < 13 38 65 92
= > = > = > = > = < = < = < =
13 38 65 92 5 23 81
56
左少右多 左多右少
向右偏 向左偏考点三: 折半查找
给定结点个数(查找集合的记录个数)为11的判定树
查找第 78 个元素比较多少次?
< 46 >
=
17 78
< = > < = > 46
>
5 23 56 81
= > = > = > = > 78
13 38 65 92
查找成功,比较2次考点三: 折半查找
给定结点个数(查找集合的记录个数)为11的判定树
查找第 13 个元素比较多少次?
< 46 >
=
17 78
< = > < = > 46
<
5 23 56 81
17
= > = > = > = >
<
13 38 65 92
5
>
13
查找成功,比较4次考点三: 折半查找
给定结点个数(查找集合的记录个数)为11的判定树
查找第 15 个元素比较多少次?
< 46 >
=
17 78
< = > < = > 46
<
5 23 56 81
17
= > = > = > = >
<
13 38 65 92
5
>
13
查找失败,比较4次考点三: 折半查找
给定结点个数(查找集合的记录个数)为11的判定树
< 46 >
=
17 78
< = > < = >
5 23 56 81
= > = > = > = >
13 38 65 92
折半查找任一记录的过程,即是判定树中从根结点到该记录结点
的路径,和给定值的比较次数等于该记录结点在树中的层数考点三: 折半查找
给定结点个数(查找集合的记录个数)为11的判定树
< 46 >
=
17 78
< = > < = >
5 23 56 81
= > = > = > = >
13 38 65 92
折半查找任一记录的过程,当查找成功时,即是判定树中从根结
点到该记录结点的路径;层次路径,该路径有且只有一条。考点三: 折半查找
给定结点个数(查找集合的记录个数)为11的判定树
< 46 >
=
17 78
< = > < = >
5 23 56 81
= > = > = > = >
13 38 65 92
折半查找任一记录的过程,当查找成功时,即是判定树中从根结
点到该记录结点的路径;层次路径,该路径有且只有一条。考点三: 折半查找
查找成功情况下,与判定树的深度有关,判定树的深度是多少呢?
< 46 >
=
17 78
< = > < = >
5 23 56 81
= > = > = > = >
13 38 65 92
log n +1 log n +1
判定树深度为 比较次数至多为
2 2
时间复杂度为O(log n)
2考点三: 折半查找
如何确定查找失败呢?例如查找的元素比元素5大比元素14个小?
< 46 >
=
17 78
>
< =
> < =
81
5 23 56 >
= > =
= > = >
46 ~ 56
13 17 ~23 38 65 78 ~ 81 92
~ 5
5 ~ 13 13 ~17 23 ~ 38 38 ~ 46 56 ~ 65 65 ~ 78 81 ~ 92 92 ~
查找不成功的过程是从根结点到外部结点的路径,和给定值进行的比较次数等
于该路径上内部结点的个数。考点三: 折半查找
查找成功的平均比较次数 = (1×1+2×2+3×4+4×4)/11 = 3
< 46 >
=
17 78
< = > < = >
5 23 56 81
= > = > = > = >
13 38 65 92考点三: 折半查找
查找不成功的平均比较次数 = (3×4+4×8)/12 = 11/3
< 46 >
=
17 78
>
< =
> < =
81
5 23 56 >
= > =
= > = >
46 ~ 56
13 17 ~23 38 65 78 ~ 81 92
~ 5
5 ~ 13 13 ~17 23 ~ 38 38 ~ 46 56 ~ 65 65 ~ 78 81 ~ 92 92 ~考点三: 折半查找
查找成功情况下,与判定树的深度有关,判定树的深度是多少呢?
< 46 >
=
17 78
< = > < = >
5 23 56 81
= > = > = > = >
13 38 65 92
log n +1 log n +1
判定树深度为 比较次数至多为
2 2
时间复杂度为O(log n)
2考点三: 折半查找
l o g
2
n + 1
判定树深度为 比较次数至多为
时间复杂度为O(log n)
2
l o g
2
n + 1
折半查找的判定树中,只有最下⾯的层是不满的 因此,元素个
数为n时树⾼h = ⌈log(n + 1)⌉ ,因此复杂度是O(h);
2
➢ 我们可以得到,复杂度只和元素的个数n有关,而与元素的值无关;
➢ 也就说只要是n个元素,
5 13 17 23 38 46 56 65 78 81 92
3 6 9 11 15 17 19 21 23 25 27考点三: 折半查找
折半查找和顺序查找谁快?
5 13 17 23 38 46 56 65 78 81 92
3 6 9 11 15 17 19 21 23 25 27
看具体元素在哪里?【政哥题型总结】考点三: 折半查找
假定对有序表(3,4,5,7,24,30,42,54,63,72,87,95)进行折半查找,试回答下列问题。
(1)画出描述折半查找过程的判定树。
(2)若查找元素54,需依次与哪些元素比较?
(3)若查找元素90,需依次与哪些元素比较?
(4)假定每个元素的查找概率相等,求查找成功时的平均查找长度(ASL)。考点三: 折半查找
3 , 4 , 5 , 7 , 2 4 , 3 0 , 4 2 , 5 4 , 6 3 , 7 2 , 8 7 , 9 5
(1)首先需要构造一个判定树,根据给定的元素序列,构造的判定树如图所示(默认
采用的是向下取整的方法)。考点三: 折半查找
(2)若查找元素54,需依次与哪些元素比较?
查找元素54,比较的元素是30、63、42、54,查找成功。考点三: 折半查找
(3)若查找元素90,需依次与哪些元素比较?
查找元素90,比较的元素是30、63、87、95,查找失败。考点三: 折半查找
(4)假定每个元素的查找概率相等,求查找成功时的平均查找长度(ASL)。
总的比较次数 11+22+34+45 37
查找成功的
ASL= = =
元素个数 12 12考点三: 折半查找
(4)假定每个元素的查找概率相等,求查找成功时的平均查找长度(ASL)。
3∗3+10∗4
查找失败的ALS =
13THANKSCON T EN T S
目录
考点一 查找的基本概念
考点二 顺序查找
考点三 折半查找 ★★★★
考点四 分块查找
考点五 二叉排序树 ★★★★★
考点六 平衡二叉树 ★★★★★
考点七 红黑树
考点八 索引查找 ★★★
考点九 散列查找 ★★★★★考点框架
分块查找的定义
分块查找的实例
分块查找的性能分析【分块查找的定义】考点四: 分块查找
分块查找(block search)是一种性能介于顺序查找和折半查找之间的查找方法。
它要求按如下的索引方式来存储线性表:将表R[0..n-1]均分为b块,前b-1块中的
元素个数为s=⌈n/b⌉,最后一块(即第b块)的元素数小于等于s;每一块中的关键字
不一定是有序的,但前一块中的最大关键字必须小于后一块中的最小关键字,即
要求整个表是“分块有序’(block order)的。考点四: 分块查找
思 路 数据整体无序
分块后按块有序【分块查找的实例】考点四: 分块查找
• 设有一个线性表,其中包含25个元素,其关键字序列为:
• 8,14,6,9,10,22,34,18,19,31,40,38,54,66,46,
71,78,68,80,85,100,94,88,96,87
• 分块:将n=25个元素分为b=5块,每块中有s=5个元素。
数据特性:
每块建立一个索引项 索引表考点四: 分块查找
查找关键字为80的元素
索引表
14 34 66 85 100 key
0 5 10 15 20 link
主数据表
1
1 1 2 3 1 1 3 4 3 5 6 4 7 7 6 8 8 9 8 9 8
8 6 9 0
4 0 2 4 8 9 1 0 8 4 6 6 1 8 8 0 5 4 8 6 7
0
1 1 1 1 1 1 1 1 1 1 2 2 2 2 2
0 1 2 3 4 5 6 7 8 9
0 1 2 3 4 5 6 7 8 9 0 1 2 3 4
分块查找的索引存储结构
• (1)顺序查找索引表,比较4次
• (2)在对应块中查找,比较4次,共比较8次。考点四: 分块查找
查找关键字k为80的元素
索引表
14 34 66 85 10 key
0
link
0 5 10 15 20
在I中从前向后查找刚好大于等于k的索引元素
折半查找索引表
在I中查找≥k的最左边的索引元素【分块查找的性能分析】考点四: 分块查找
分块查找含两次查找过程(所以分块查找最少需要2次关键字比较)
整个查找过程的平均查找长度,是两次查找的平均查找长度之和
• 若以折半查找来确定元素所在的块,则成功时的平均查找长度为:
• 若以顺序查找来确定元素所在的块,则成功时的平均查找长度为:THANKSCON T EN T S
目录
考点一 查找的基本概念
考点二 顺序查找
考点三 折半查找 ★★★★
考点四 分块查找
考点五 二叉排序树 ★★★★★
考点六 平衡二叉树 ★★★★★
考点七 红黑树
考点八 索引查找 ★★★
考点九 散列查找 ★★★★★考点框架考点框架
二叉排序树的定义
二叉排序树的查找
二叉排序树的插入
二叉排序树的删除
二叉排序树的构造
二叉排序树查找性能分析【二叉排序树的定义】考点五: 二叉排序树
顺序查找(线性查找):从线性表的一端向另一端逐个将记录与给
定值进行比较,若相等,则查找成功,给出该记录在表中的位置;
若整个表检测完仍未找到与给定值相等的记录,则查找失败,给出
失败信息
查找64
0 1 2 3 4 5 6 7 8 9 10
5 13 19 21 37 56 64 75 80 88 92
p p
顺序查找示例考点五: 二叉排序树
折半查找(对半查找、二分查找):在有序表中,取中间记录作为
比较对象,若给定值与中间记录相等,则查找成功;若给定值小于
中间记录,则在有序表的左半区继续查找;若给定值大于中间记录,
则在有序表的右半区继续查找。不断重复上述过程,直到查找成功,
或查找区域无记录,查找失败
1 2 3 4 5 6 7 8 9 10 11
查找64
5 13 19 21 37 56 64 75 80 88 92
p考点五: 二叉排序树
如何在一个大型的数据集合上进行动态查找?
顺序查找:不要求元素的有序性,插入、删除的性能是O(1)
查找性能是O(n)
折半查找:查找性能是O(log n)
2
为保证元素的有序性,插入、删除要移动元素,性能是O(n)
有没有一种查找结构,使得插入、删除、查找均具有较好效率?
树表:将查找集合组织成树的结构 二叉查找树
什么是动态查找? 要求插入、删除、查找均具有较好的效率考点五: 二叉排序树
二叉查找树(二叉查找树):或者是一棵空的二叉树,或者是具有下列
性质的二叉树:
(1)若它的左子树不空,则左子树上所有结点的值均小于根结点的值
(2)若它的右子树不空,则右子树上所有结点的值均大于根结点的值
(3)它的左右子树也都是二叉查找树
63 63
55 90 55 60
42 58 70 42 58 70
25 45 65 85 25 45 65 85考点五: 二叉排序树
二叉查找树(二叉查找树):或者是一棵空的二叉树,或者是具有下列
性质的二叉树:
(1)若它的左子树不空,则左子树上所有结点的值均小于根结点的值
(2)若它的右子树不空,则右子树上所有结点的值均大于根结点的值
(3)它的左右子树也都是二叉查找树
63
注意:二叉排序树中没有相同关键字的结点。
55 90
42 58 70
25 45 65 85考点五: 二叉排序树
二叉查找树是记录之间满足某种大小关系的二叉树
写出二叉查找树的中序序列? 升序序列 二叉查找树
25 42 45 55 58 63 65 70 85 90 63
55 90
42 58 70
25 45 65 85考点五: 二叉排序树
63
55 90
最右下结点,即为
42 58 70
关键字最大的结点
25 45 65 85
最左下结点,即为
关键字最小的结点
中序序列:25 42 45 55 58 63 65 70 85 90考点五: 二叉排序树
特点:
二叉排序树的中序序列是一个递增有序序列
根结点的最左下结点是关键字最小的结点
根结点的最右下结点是关键字最大的结点考点五: 二叉排序树
63
如何存储二叉查找树? 二叉链表
63
55 90 ∧
55 90
42 ∧ 58 ∧ 70
42 58 70
25 45 65 85
∧ 25 ∧ ∧ 45 ∧ ∧ 65 ∧ ∧ 85 ∧考点五: 二叉排序树
如何存储二叉查找树? 二叉链表 typedef int ElemType;
typedef struct BSTNode {
63 ElemType key;
struct BSTNode *lchild, *rchild;
55 90 ∧
} BSTNode, *BSTree;
42 ∧ 58 ∧ 70
∧ 25 ∧ ∧ 45 ∧ ∧ 65 ∧ ∧ 85 ∧【二叉排序树的查找】考点五: 二叉排序树
在二叉查找树中查找给定值 k的过程是
(1)若root是空树,则查找失败; 二叉查找树的查找效率在于
只需查找二个子树之一
(2)若k=root->data,则查找成功;
(3)若k<root->data,则在root的左子树上查找;
(4)若k> root->data,在root的右子树上查找。
bt
N
k<bt->key
k>bt->key
每一层只和一个结点进行关键字比较!考点五: 二叉排序树
在二叉查找树中查找给定值 k的过程是
(1)若root是空树,则查找失败; 二叉查找树的查找效率在于
只需查找二个子树之一
(2)若k=root->data,则查找成功;
(3)若k<root->data,则在root的左子树上查找;
(4)若k> root->data,在root的右子树上查找。
63
5555 90
4422 58 70
25 4455 65 85考点五: 二叉排序树
// 在二叉排序树t中查找关键字为key的结点,递归实现
BSTree SearchBST(BSTree t, ElemType key) {
63
if (!t) {
return NULL;
5555 90
}
if (t->key == key) {
4422 58 70
return t;
}
25 4455 65 85
if (t->key > key) {
return SearchBST(t->lchild, key);
}
return SearchBST(t->rchild, key);
}考点五: 二叉排序树
// 在二叉排序树t中查找关键字为key的结点,非递归实现
BSTree SearchBST2(BSTree t, ElemType key) {
while (t && t->key != key) {
if (t->key > key) {
t = t->lchild; // 在左子树中查找
63
} else {
t = t->rchild; // 在右子树中查找
5555 90
}
}
4422 58 70
return t;
}
25 4455 65 85【二叉排序树的插入】考点五: 二叉排序树
在二叉排序树中插入一个关键字为k的新结点,要保证插入后仍满足BST性质。
插入过程:
(1)若二叉排序树T为空,则创建一个key域为k的结点,将它作为根结点。
(2)否则将k和根结点的关键字比较,若k<T->key,则将k插入根结点的左子树中。
(3)若k>T->key,将它插入右子树中。
(4)若k==T->key,说明树中已有此关键字k,无须插入。考点五: 二叉排序树
如何在二叉查找树中插入一个元素?例如,插入98
63
63
55 90
∧ 55 90 ∧
58 70 98
∧ 58 ∧ ∧ 70 ∧ ∧ 98 ∧
若二叉查找树为空树,则新插入的结点为新的根结点;
否则,新插入的结点必为一个新的叶子结点,其插入位置由查找过程得到。考点五: 二叉排序树
每次插入的新结点都是BST树的叶子结点,即在插入时不必移动
其它结点,仅需修改某个结点的指针。
12
16
12 24
4 15 18 27
图二叉排序树考点五: 二叉排序树
每次插入的新结点都是BST树的叶子结点,即在插入时不必移动
其它结点,仅需修改某个结点的指针。
16 12
12 24
4 15 18 27
图二叉排序树考点五: 二叉排序树
每次插入的新结点都是BST树的叶子结点,即在插入时不必移动
其它结点,仅需修改某个结点的指针。
16 12
12 24 已经存在,不插入,返回
4 15 18 27
图二叉排序树考点五: 二叉排序树
每次插入的新结点都是BST树的叶子结点,即在插入时不必移动
其它结点,仅需修改某个结点的指针。
16 13
12 24
4 15 18 27
图二叉排序树考点五: 二叉排序树
每次插入的新结点都是BST树的叶子结点,即在插入时不必移动
其它结点,仅需修改某个结点的指针。
16 13
12 24
4 15 18 27
图二叉排序树考点五: 二叉排序树
每次插入的新结点都是BST树的叶子结点,即在插入时不必移动其
它结点,仅需修改某个结点的指针。
16 13
12 24
4 15 18 27
图二叉排序树考点五: 二叉排序树
每次插入的新结点都是BST树的叶子结点,即在插入时不必移动
其它结点,仅需修改某个结点的指针。
16
12 24
4 15 18 27
13
图二叉排序树考点五: 二叉排序树
// 在二叉排序树t中插入一个关键字为key的结点,递归实现
bool InsertBST(BSTree& t, ElemType key) {
if (!t) {
t = (BSTree)malloc(sizeof(BSTNode)); // 申请新结点
if (!t) {
return false;
}
t->key = key;
t->lchild = t->rchild = NULL; // 初始化新结点
return true;
}
if (t->key == key) {
return false; // 如果关键字已存在,插入失败
}
if (t->key > key) {
return InsertBST(t->lchild, key); // 插入到左子树中
}
return InsertBST(t->rchild, key); // 插入到右子树中
}考点五: 二叉排序树
// 在二叉排序树t中插入一个关键字为key的结点,非递归实现
bool InsertBST2(BSTree& t, ElemType key) {
BSTree* p = &t;
while (*p) {
if ((*p)->key == key) {
return false; // 如果关键字已存在,插入失败
}
if ((*p)->key > key) {
p = &(*p)->lchild; // 在左子树中查找
} else {
p = &(*p)->rchild; // 在右子树中查找
}
}
*p = (BSTree)malloc(sizeof(BSTNode)); // 申请新结点
if (!*p) {
return false;
}
(*p)->key = key;
(*p)->lchild = (*p)->rchild = NULL; // 初始化新结点
return true;
}考点五: 二叉排序树
// 在二叉排序树t中插入一个关键字为key的结点,非递归 ①
12
实现
bool InsertBST2(BSTree& t, ElemType key) {
②
BSTree* p = &t; 8 15
while (*p) {
if ((*p)->key == key) {
19
6 10 13
return false; // 如果关键字已存在,插入失败
③
}
if ((*p)->key > key) { 9 14
p = &(*p)->lchild; // 在左子树中查找
} else {
我们插入10,其比较的元素我们用标号
p = &(*p)->rchild; // 在右子树中查找
} 标出,如图所示。
}
(1) 代码第1行调用插入函数,函数中有
*p = (BSTree)malloc(sizeof(BSTNode)); // 申请新结点
两个参数第一个是BST的根节点指针T,
if (!*p) {
return false; 第二个是待插入的关键字key。代码第2
}
行设置工作指针p,q,x,
(*p)->key = key;
(2) 代码第3,4和5行创建一个新的结点,
(*p)->lchild = (*p)->rchild = NULL; // 初始化新结点
存储被插入的关键字,并且将该节点的左
return true;
} 右子树置为空。考点五: 二叉排序树
// 在二叉排序树t中插入一个关键字为key的结点,非递归 ①
12
实现
bool InsertBST2(BSTree& t, ElemType key) {
②
BSTree* p = &t; 8 15
while (*p) {
if ((*p)->key == key) {
19
6 10 13
return false; // 如果关键字已存在,插入失败
③
}
if ((*p)->key > key) { 9 14
p = &(*p)->lchild; // 在左子树中查找
} else {
我们插入10,其比较的元素我们用标号
p = &(*p)->rchild; // 在右子树中查找
} 标出,如图所示。
}
(3) 代码第6行,如果根节点T为空,新插
*p = (BSTree)malloc(sizeof(BSTNode)); // 申请新结点
入的点将作为根节点。图中根节点是12,
if (!*p) {
return false; 不为空
}
(*p)->key = key;
(*p)->lchild = (*p)->rchild = NULL; // 初始化新结点
return true;
}考点五: 二叉排序树
// 在二叉排序树t中插入一个关键字为key的结点,非递归 ①
12
实现
bool InsertBST2(BSTree& t, ElemType key) {
②
BSTree* p = &t; 8 15
while (*p) {
if ((*p)->key == key) {
19
6 10 13
return false; // 如果关键字已存在,插入失败
③
}
if ((*p)->key > key) { 9 14
p = &(*p)->lchild; // 在左子树中查找
} else {
p = &(*p)->rchild; // 在右子树中查找
(4) 要插入的关键字是10,执行代码7和8行,
}
} 将根节点赋给工作指针p;此时p是12
*p = (BSTree)malloc(sizeof(BSTNode)); // 申请新结点
(5) 执行第9行,p是12,不为空,进入循环;
if (!*p) {
return false;
}
(*p)->key = key;
(*p)->lchild = (*p)->rchild = NULL; // 初始化新结点
return true;
}考点五: 二叉排序树
// 在二叉排序树t中插入一个关键字为key的结点,非递归 ①
12
实现
bool InsertBST2(BSTree& t, ElemType key) {
②
BSTree* p = &t; 8 15
while (*p) {
if ((*p)->key == key) {
19
6 10 13
return false; // 如果关键字已存在,插入失败
③
}
if ((*p)->key > key) { 9 14
p = &(*p)->lchild; // 在左子树中查找
} else {
p = &(*p)->rchild; // 在右子树中查找
(6) 执行代码第10行,插入的关键字key
}
} 值是13不等于12①;执行第11行,p赋
*p = (BSTree)malloc(sizeof(BSTNode)); // 申请新结点
值给q,因为要想插入结点,必须找到
if (!*p) {
结点的父结点,因此q就是执行被插入
return false;
} 点的父节点。
(*p)->key = key;
(7) 执行代码第11和12行,因为要插入
(*p)->lchild = (*p)->rchild = NULL; // 初始化新结点
的关键字10小于12,因此p执行p的左
return true;
} 子树,此时p是8考点五: 二叉排序树
// 在二叉排序树t中插入一个关键字为key的结点,非递归 ①
12
实现
bool InsertBST2(BSTree& t, ElemType key) {
②
BSTree* p = &t; 8 15
while (*p) {
if ((*p)->key == key) {
19
6 10 13
return false; // 如果关键字已存在,插入失败
③
}
if ((*p)->key > key) { 9 14
p = &(*p)->lchild; // 在左子树中查找
} else {
(8) 回到代码第9行,p不为空,并且key
p = &(*p)->rchild; // 在右子树中查找
} 值是10不等于8②;执行第11行,p赋
}
值给q
*p = (BSTree)malloc(sizeof(BSTNode)); // 申请新结点
(9) 执行代码第11和12行,因为关键字
if (!*p) {
return false; 10大于8,因此p执行p的右子树,此时
}
p是10;
(*p)->key = key;
(9) 回到代码第9行,p不为空,并且key
(*p)->lchild = (*p)->rchild = NULL; // 初始化新结点
return true; 值是10等于10③;执行第10行,结点
}
已经存在,直接返回不做出入操作考点五: 二叉排序树
// 在二叉排序树t中插入一个关键字为key的结点,非递归 ①
12
实现
bool InsertBST2(BSTree& t, ElemType key) {
②
BSTree* p = &t; 8 15
while (*p) {
if ((*p)->key == key) {
19
6 10 13
return false; // 如果关键字已存在,插入失败
③
}
if ((*p)->key > key) { 9 14
p = &(*p)->lchild; // 在左子树中查找
} else {
(1) 代码第1行调用插入函数,函数中有两个
p = &(*p)->rchild; // 在右子树中查找
} 参数第一个是BST的根节点指针T,第二个是
}
待插入的关键字key。代码第2行设置工作指
*p = (BSTree)malloc(sizeof(BSTNode)); // 申请新结点
针p,q,x,
if (!*p) {
return false; (2) 代码第3,4和5行创建一个新的结点,存储
}
被插入的关键字,并且将该节点的左右子树
(*p)->key = key;
置为空。
(*p)->lchild = (*p)->rchild = NULL; // 初始化新结点
return true; (3) 代码第6行,如果根节点T为空,新插入的
}
点将作为根节点。图中根节点是12,不为空考点五: 二叉排序树
// 在二叉排序树t中插入一个关键字为key的结点,非递归 ①
12
实现
bool InsertBST2(BSTree& t, ElemType key) {
②
BSTree* p = &t; 8 15
while (*p) {
if ((*p)->key == key) {
19
6 10 13
return false; // 如果关键字已存在,插入失败
③
}
if ((*p)->key > key) { 9 14
p = &(*p)->lchild; // 在左子树中查找
} else {
(4) 要插入的关键字是11,执行代码7和8行,将
p = &(*p)->rchild; // 在右子树中查找
} 根节点赋给工作指针p;此时p是12
}
(5) 执行第9行,p是12,不为空,进入循环;
*p = (BSTree)malloc(sizeof(BSTNode)); // 申请新结点
(6) 执行代码第10行,插入的关键字key值是11
if (!*p) {
不等于12①;执行第11行,p赋值给q,因为要
return false;
} 想插入结点,必须找到结点的父结点,因此q就
(*p)->key = key;
是执行被插入点的父节点。
(*p)->lchild = (*p)->rchild = NULL; // 初始化新结点
(7) 执行代码第11和12行,因为要插入的关键字
return true;
} 11小于12,因此p执行p的左子树,此时p是8考点五: 二叉排序树
// 在二叉排序树t中插入一个关键字为key的结点,非递归 ①
12
实现
bool InsertBST2(BSTree& t, ElemType key) {
②
BSTree* p = &t; 8 15
while (*p) {
if ((*p)->key == key) {
19
6 10 13
return false; // 如果关键字已存在,插入失败
③
}
if ((*p)->key > key) { 9 14
p = &(*p)->lchild; // 在左子树中查找
} else {
p = &(*p)->rchild; // 在右子树中查找
(8) 回到代码第9行,p不为空,插入的关键
}
字key值是11不等于8②;执行第11行,p赋
}
*p = (BSTree)malloc(sizeof(BSTNode)); // 申请新结点 值给q
if (!*p) {
(9) 执行代码第14和15行,因为关键字11大
return false;
于8,因此p执行p的右子树,此时p是10;
}
(10) 回到代码第9行,p不为空,进入循环;
(*p)->key = key;
(*p)->lchild = (*p)->rchild = NULL; // 初始化新结点
return true;
}考点五: 二叉排序树
// 在二叉排序树t中插入一个关键字为key的结点,非递归 ①
12
实现
bool InsertBST2(BSTree& t, ElemType key) {
②
BSTree* p = &t; 8 15
while (*p) {
if ((*p)->key == key) {
19
6 10 13
return false; // 如果关键字已存在,插入失败
③
}
if ((*p)->key > key) { 9 14
p = &(*p)->lchild; // 在左子树中查找
} else { (11)执行代码第10行,插入的关键字key值
p = &(*p)->rchild; // 在右子树中查找
是11不等于10①;执行第11行,p赋值给
}
q,
}
*p = (BSTree)malloc(sizeof(BSTNode)); // 申请新结点 (12) 执行代码第14和15行,因为key值是
if (!*p) {
11大于10③,因此p执行p的右子树,此时
return false;
p是NULL
}
(*p)->key = key; (13) 回到代码第9行,p为空,循环结束;
(*p)->lchild = (*p)->rchild = NULL; // 初始化新结点
此时p为空,q是p的父节点;
return true;
(14) 执行第19和20行,将x赋值为q的右子
}
树。考点五: 二叉排序树
// 在二叉排序树t中插入一个关键字为key的结点,非递归 ①
12
实现
bool InsertBST2(BSTree& t, ElemType key) {
②
BSTree* p = &t; 8 15
while (*p) {
if ((*p)->key == key) {
19
6 10 13
return false; // 如果关键字已存在,插入失败
③
}
if ((*p)->key > key) { 9 14
p = &(*p)->lchild; // 在左子树中查找
} else {
p = &(*p)->rchild; // 在右子树中查找 ①
12
}
}
②
*p = (BSTree)malloc(sizeof(BSTNode)); // 申请新结点 8 15
if (!*p) {
return false;
19
6 10 13
}
③
(*p)->key = key;
(*p)->lchild = (*p)->rchild = NULL; // 初始化新结点 9 11 14
return true;
}【二叉排序树的删除】考点五: 二叉排序树
如何在二叉查找树中删除一个元素?
(1)从二叉查找树中删除一个结点之后,要仍然保持二叉查找树的特性;
(2)当删除分支结点时破坏了二叉查找树中原有结点之间的链接关系,
需要重新修改指针,使得删除结点后仍为一棵二叉查找树。
63
55 90
42 58 70
25 45 65 85考点五: 二叉排序树
二叉查找树中删除的四种情形
从BST树上删除一个结点,仍然要保证删除后满足BST的性质。对
于一棵二叉树而言,结点类型有三种,根结点,叶子结点以及中间结点,
而删除根节点和中间结点的情形一致,所以我们可以归纳为四种情形:
(1) 删除叶子结点
(2) 删除只有左子树的结点
(3) 删除只有右子树的结点
(4) 删除同时具有左子树和右子树的结点考点五: 二叉排序树
不失一般性,设待删除结点为p,其双亲结点为f,且 p 是 f 的左孩子,
情况 1——被删除的结点是叶子结点
63
63
55 90
55 90 f
f
42 58 70
42 58 70
p 25 45 85
25 45 65 85
操作:将双亲结点中相应指针域的值改为空。考点五: 二叉排序树
情况 2——被删除的结点只有右子树
63
63
f
f
55 90
55 90
p
p
42 58 70 42 58 85
25 45
25 45 85
操作:将双亲结点中相应指针域指向被删除结点的右子树考点五: 二叉排序树
情况 3——被删除的结点只有左子树
被删关键字=40
例如:
50
30 80
20 40 90
35 85
32 88
操作:其双亲结点的相应指针域的值改为“指向被删除结点的左孩子”。考点五: 二叉排序树
情况 4——被删除的结点既有左子树也有右子树
p
p
58
63 par
par
55 90
55 90
s
s
42 56 70
42 58 70
25 45 85
25 45 56 85
操作:以其左子树中的最大值结点替换之,然后再删除该结点考点五: 二叉排序树
情况 4——被删除的结点既有左子树也有右子树
p
par p
63 55
s
s
42
55 90 90
42 70 25 45 70
25 45 85 85
操作:以其左子树中的最大值结点替换之,然后再删除该结点【二叉排序树的构造】考点五: 二叉排序树
创建一棵二叉排序树是从一个空树开始(T =NULL)。
每插入一个关键字k,就调用一次InsertBST(T ,k)算法将k插入到当前已生成
的二叉排序树中。考点五: 二叉排序树
(1)每次插入的新结点都是二叉查找树上新的叶子结点;
(2)找到插入位置后,不必移动其它结点,仅需修改某个结点的指针;
(3)在左子树/右子树的查找过程与在整棵树上查找过程相同;
(4)新插入的结点没有破坏原有结点之间的关系。考点五: 二叉排序树
例如,给定查找集合{63, 55, 42, 45, 58, 90, 70, 25, 85, 65},构造二叉
查找树
63
55 90
42 58 70
25 45 65 85考点五: 二叉排序树
如果按照序列a={6, 24, 29,36,50 ,60 ,66, 76}建立BST,可以得到
一个新的二叉排序树。
6
24
29
36
50
60
66
76考点五: 二叉排序树
如果按照序列a={76,66,60, 50,36, 29, 24,6 }建立BST,可以得到一个新的
二叉排序树。
76
66
60
50
36
29
24
6【二叉排序树查找性能分析】考点五: 二叉排序树
在二叉查找树中查找给定值 k的过程是
(1)若root是空树,则查找失败; 二叉查找树的查找效率在于
只需查找二个子树之一
(2)若k=root->data,则查找成功;
(3)若k<root->data,则在root的左子树上查找;
(4)若k> root->data,在root的右子树上查找。
63
5555 90
4422 58 70
25 4455 65 85考点五: 二叉排序树
二叉查找树的查找性能取决于什么?
比较次数不超过树的深度
63
5555 90
4422 58 70
25 4455 65 85考点五: 二叉排序树
在二叉查找树中执行插入和删除操作
查找插入和删除的位置
修改相应指针
插入、删除、查找的时间复杂度相同考点五: 二叉排序树
二叉查找树的深度是多少?取决于什么?
例如,给定查找集合{40, 35, 30, 25, 20, 15},构造的二叉查找树深度为 n
40
35
30 平均比较次数 = (1+2+3+4+5+6)/6 = 21/6
25
20
15考点五: 二叉排序树
二叉查找树的深度是多少?取决于什么?
log n +1
例如,给定查找集合{15, 20, 25, 30, 35, 40},构造的二叉查找树深度为
2
30
平均比较次数 = (1×1+2×2+3×3)/6 = 14/6
20 35
15 25 40考点五: 二叉排序树
12
76
8 15
66
6 10 13
60
50
9 14
36
29
最好情况:n个结点的二叉树最小
24
高度为log n+ 1。平均查找长度=
2
6
O(log n)
2
最坏情况:每个结点只有一
个分支,树高h=结点数n。
平均查找长度=O(n)考点五: 二叉排序树
12
76
8 15
66
6 10 13
60
50
9 14
36
29
24
6
BST是一种查找效率比较高的组织形式,但其平均查找长度受树的形态
影响较大,形态比较均匀时查找效率很好,形态明显偏向某一方向时其
效率就大大降低。【政哥题型总结】考点五: 二叉排序树
1.输入一个正整数序列{53,17,12,66,58,70,87,25,56,60},试完成下列各题。
(1)按次序构造一棵二叉排序树BST。考点五: 二叉排序树
1.输入一个正整数序列{53,17,12,66,58,70,87,25,56,60},试完成下列各题。
(1)按次序构造一棵二叉排序树BST。
(1)从空树开始,构造一棵BST树,如图所示,其中标号代表的是元素的插入顺序。考点五: 二叉排序树
1.输入一个正整数序列{53,17,12,66,58,70,87,25,56,60},试完成下列各题。
(2)依此二叉排序树,如何得到一个从大到小的有序序列?考点五: 二叉排序树
1.输入一个正整数序列{53,17,12,66,58,70,87,25,56,60},试完成下列各题。
(2)依此二叉排序树,如何得到一个从大到小的有序序列?
依此二叉排序树,按照右根左的方式进行遍历,可以得到一个从大到小的
有序序列。考点五: 二叉排序树
1.输入一个正整数序列{53,17,12,66,58,70,87,25,56,60},试完成下列各题。
(3)画出在此二叉排序树中删除“66”后的树的结构。考点五: 二叉排序树
1.输入一个正整数序列{53,17,12,66,58,70,87,25,56,60},试完成下列各题。
(3)画出在此二叉排序树中删除“66”后的树的结构。
66既有左子树又有右子树,我们可
以采用它的中序直接前驱或中序直
接后继代替它。根据中序遍历结果,
得 到 中 序 遍 历 序 列 是
12,17,25,53,56,58,60,66,70,87 ,
那么可以采用60或70代替66,如
图所示。考点五: 二叉排序树
1.输入一个正整数序列{53,17,12,66,58,70,87,25,56,60},试完成下列各题。
(3)画出在此二叉排序树中删除“66”后的树的结构。
(a)用60代替66的位置;考点五: 二叉排序树
1.输入一个正整数序列{53,17,12,66,58,70,87,25,56,60},试完成下列各题。
(3)画出在此二叉排序树中删除“66”后的树的结构。
(b)用70代替66的位置,此时需要用87代替原70的位置考点五: 二叉排序树
1.输入一个正整数序列{53,17,12,66,58,70,87,25,56,60},试完成下列各题。
(4)求在等概率情况下,查找成功和查找失败时的平均查找长度。考点五: 二叉排序树
1.输入一个正整数序列{53,17,12,66,58,70,87,25,56,60},试完成下列各题。
(4)求在等概率情况下,查找成功和查找失败时的平均查找长度。
对于原BST,我们进行查找,在等概率
的情况下,计算查找成功和查找失败时
的平均查找长度。
11+ 2 2 + 3 4 + 43 29
ASL = =
成功
10 10
53+ 6 4 39
ASL = =
失败
11 11考点五: 二叉排序树
2. 一 棵 二 叉 排 序 树 (BST , Binary Search/Sort Tree) 的 后 序 遍 历 序 列 是
15,10,23,25,20,35,42,39,30。请给出这棵树的前序遍历序列。考点五: 二叉排序树
2. 一 棵 二 叉 排 序 树 (BST , Binary Search/Sort Tree) 的 后 序 遍 历 序 列 是
15,10,23,25,20,35,42,39,30。请给出这棵树的前序遍历序列。
中序遍历 + 层次遍历:其中层次遍历确定根,中序遍历确定左右子树
中序遍历 + 后序遍历:其中后序遍历确定根,中序遍历确定左右子树
中序遍历 + 先序遍历:其中先序遍历确定根,中序遍历确定左右子树
大家记得一点,要想确定一棵二叉树,一定需要中序遍历,区分左右子
树,其他三种方式无法确定左右子树。考点五: 二叉排序树
2. 一 棵 二 叉 排 序 树 (BST , Binary Search/Sort Tree) 的 后 序 遍 历 序 列 是
15,10,23,25,20,35,42,39,30。请给出这棵树的前序遍历序列。
【解析】 30,20,10,15,25,23,39,35,42 要想构造一棵二叉树,需
要中序遍历和前序遍历,中序遍历和后序遍历,中序遍历和层次遍历。在本题
中给定的是后序序列,但是提供了一个额外的信息,这棵二叉树是二叉排序树,
即在二叉排序树中,每个结点的关键字都比所有的左孩子关键字大,比所有的
右孩子关键字小。考点五: 二叉排序树
2. 一 棵 二 叉 排 序 树 (BST , Binary Search/Sort Tree) 的 后 序 遍 历 序 列 是
15,10,23,25,20,35,42,39,30。请给出这棵树的前序遍历序列。
【解析】 根据给定的序列,30是根结点,15,10,23,25,20是左子树,35,42,39是
右子树,如图(a)所示;考点五: 二叉排序树
2. 一 棵 二 叉 排 序 树 (BST , Binary Search/Sort Tree) 的 后 序 遍 历 序 列 是
15,10,23,25,20,35,42,39,30。请给出这棵树的前序遍历序列。
【解析】对于15,10,23,25,20,其中20是根,15,10是左子树,23,25是右子树;
对于35,42,39,其中39是根,35是左子树,42是右子树,如图(b)所示;考点五: 二叉排序树
2. 一 棵 二 叉 排 序 树 (BST , Binary Search/Sort Tree) 的 后 序 遍 历 序 列 是
15,10,23,25,20,35,42,39,30。请给出这棵树的前序遍历序列。
【解析】对于15,10,其中10是根,15是右子树;对于23,25,其中25是根,23
是左子树;(c)所示。其前序遍历是30,20,10,15,25,23,39,35,42。考点五: 二叉排序树
3.对于给定序列(56,74,38,25,68,70,83,62,78)。
(1)按给定顺序构造一棵二叉排序树,画出此树。考点五: 二叉排序树
3.对于给定序列(56,74,38,25,68,70,83,62,78)。
(1)按给定顺序构造一棵二叉排序树,画出此树。
(1)二叉排序树构建时,每次新插入的结点都将作为叶子的身份插入,根据结点的
先后顺序构建二叉排序树,考点五: 二叉排序树
3.对于给定序列(56,74,38,25,68,70,83,62,78)。
(2)删除二叉排序树中值为74的结点,画出删除后的排序树。考点五: 二叉排序树
3.对于给定序列(56,74,38,25,68,70,83,62,78)。
(2)删除二叉排序树中值为74的结点,画出删除后的排序树。
【解析】构造的二叉排序树的中序序列是25,38,56,62,68,70,74,78,83。当要删
除74时,74具有左、右子树,可以使用中序直接前驱或者中序直接后继代替,
当采用中序直接前驱代替时,即用70代替74,调整后如图(c)所示;考点五: 二叉排序树
3. 对于给定序列(56,74,38,25,68,70,83,62,78)。
(2)删除二叉排序树中值为74的结点,画出删除后的排序树。
【解析】当采用中序直接后继代替时,即用78代替74,调整后如图(d)所示。THANKSCON T EN T S
目录
考点一 查找的基本概念
考点二 顺序查找
考点三 折半查找 ★★★★
考点四 分块查找
考点五 二叉排序树 ★★★★★
考点六 平衡二叉树 ★★★★★
考点七 红黑树
考点八 索引查找 ★★★
考点九 散列查找 ★★★★★考点框架考点框架
平衡二叉树的概念
平衡二叉树的旋转(实现)
平衡二叉树删除
平衡二叉树的性能分析【平衡二叉树的概念】考点六: 平衡二叉树
1、AVL树的引入
BST是一种查找效率比较高的组织形式,但其平均查找长度受树的形态影响较
大,形态比较均匀时查找效率很好,形态明显偏向某一方向时其效率就大大降低。
15
12
14
13 8 15
12
6 10 13
10
9 14
9
8
6考点六: 平衡二叉树
1、AVL树的引入
有更好的二叉排序树,其形态总是均衡的,查找时能得到最好的效率,这
就是平衡二叉排序树。平衡二叉排序树(Balanced Binary Tree或Height-
Balanced Tree)是在1962年由Adelson-Velskii和Landis提出的,又称AVL树。
15
12
14
8 15
13
6 10 13
12
9 14
10
9
8
6考点六: 平衡二叉树
平衡因子:该结点的左子树的深度减去右子树的深度
平衡二叉树:或者是一棵空的二叉查找树,或者是具有下列性
质的二叉查找树:
(1)根结点的左子树和右子树的深度最多相差 1;
(2)根结点的左子树和右子树也都是平衡二叉树
1
在平衡二叉树中,
5
结点的平衡因子是1、0 或 -1 1 0
4 8
0
2
平衡二叉树考点六: 平衡二叉树
平衡因子:该结点的左子树的深度减去右子树的深度
平衡二叉树:或者是一棵空的二叉查找树,或者是具有下列性
质的二叉查找树:
(1)根结点的左子树和右子树的深度最多相差 1;
(2)根结点的左子树和右子树也都是平衡二叉树
2
在平衡二叉树中, 5
2 0
结点的平衡因子是1、0 或 -1
4 8
-1
2
0
非平衡二叉树
1考点六: 平衡二叉树
29 BST AVL
29
BBST
24 (数值) (树形) 24 6
6
如果一棵二叉树既是二叉排序树又是平衡二叉树,称为平衡二叉排序树。我们
在考研中主要考察平衡二叉排序树。考点六: 平衡二叉树
插入一个结点会影响哪些结点的平衡因子?
最小不平衡子树:以距离插入结点最近的、且平衡因子的绝对值
1
大于 1 的结点为根的子树
0
5
2
1 0
且入且判断,一旦失衡立即调整
44 8
-1
0 0 0
2 6 9
只调整最小不平衡子树,并且不影响其他结点 0
3【平衡二叉树的旋转(实现)】考点六: 平衡二叉树
插入一个结点会影响哪些结点的平衡因子?
最小不平衡子树:以距离插入结点最近的、且平衡因子的绝对值
1
大于 1 的结点为根的子树
0
5
2
1 0
且入且判断,一旦失衡立即调整
44 8
-1
0 0 0
2 6 9
只调整最小不平衡子树,并且不影响其他结点 0
3考点六: 平衡二叉树
一般的二叉排序树是不平衡的,若能通过某种方法使其既保持有序性,又具
有平衡性,就找到了构造平衡二叉排序树的方法,该方法称为平衡化旋转。
AVL树的实现有以下几个重要问题:
(1)什么原因导致AVL树的不平衡。
(2)AVL树的不平衡的情形有哪些。
(3) 如何判断AVL的树的不平衡属于哪种情形。
(4) AVL树的不平衡的情形如何调整。考点六: 平衡二叉树
(1)什么原因导致AVL树的不平衡。
为了对去实现AVL的平衡化调整,我们首先明确哪些操作会导致AVL树不
平衡,AVL操作包括查找,插入和删除,其中查找只是对于现有AVL树进行查
找,不会带来树形结构的变化;
而在对AVL树进行插入或删除一个结点后,通常会影响到从根结点到插入或
删除结点的路径上的某些结点,这些结点的子树可能发生变化。因此插入和删
除结点会导致AVL不平衡。考点六: 平衡二叉树
12
12
8 15
8 15
6 11 13 14
6 11 13 14
9
9
10
(a) (b)
插入结点考点六: 平衡二叉树
12 12
8 14 8 14
6 10 13 15 10 13 15
9 9
(a)
(b)
删除结点考点六: 平衡二叉树
(2)AVL树的不平衡的情形有哪些。
面对AVL的不平衡,我们需要明白哪些操作回音有几种不平衡的情形,如
图所示,AVL树的不平衡的情形有四种:
9
11
11 9
10 9 10 11
9 10 10
11
(a) LL
(b)LR (c)RR (d)RL考点六: 平衡二叉树
(3) 如何判断AVL的树的不平衡属于哪种情形。
为了方便讨论,我们也分为插入和删除两种情况讨论。
① 在对AVL树进行插入一个结点后,通常会影响到从根结点到插入结点的路径上的
某些结点,这些结点的子树可能发生变化。在图(a)中插入10,那么如何确定呢,其
方法是从新插入的点开始向上,寻找第一个不平衡的点,以该点为根,画一条从该
点到新插入点的路径,首先经过的三个点的结构就是不平衡的结构。在图(b)中新
插入的点是10,向上寻找,10是平衡的,9是平衡的,11是不平衡的;以11为根,
画一条到10的路径,依次经过11,9,10,得到不平衡的结构是LR,如图(c)所示。
12
12
11
8 15
8 15
9
6 11 13 14
6 11 13 14
10
9
9
(a) 10 (c) LR
(b)考点六: 平衡二叉树
②在对AVL树进行删除一个结点后,通常会影响到从根结点到删除结点的兄弟路
径上的某些结点,这些结点的子树可能发生变化。
12 12
8
8 14 8 14
10
6 10 13 15 10 13 15
9
9 (a) 9
(b) (c) RL
在图(a)中删除6,那么如何确定呢,其方法是从被删除的点兄弟的最小面的叶子
向上找,寻找第一个不平衡的点,以该点为根,画一条从该点到被删除的点的兄
弟的路径,首先经过的三个点的结构就是不平衡的结构。在图(b)中被删除的
点兄弟的最小面的叶子9向上找,9是平衡的,10是平衡的,8是不平衡的;以8
为根,画一条到9的路径,依次经过8,10,9,得到不平衡的结构是LR,如图(c)
所示。考点六: 平衡二叉树
(4) AVL树的不平衡的情形如何调整。
在对AVL树进行插入或删除一个结点后,通常会影响到从根结点到
插入结点的路径上的某些结点,这些结点的子树可能发生变化。
11
10
10
9 11
9
LL考点六: 平衡二叉树
(4) AVL树的不平衡的情形如何调整。
那么这里会有问题,10成为调整以后的根结点,那么如果10有右子树
怎么办呢?我们具体分析一下,因为10成为根节点,10的右子树比10
大,需要放入到调整以后的10的右子树,但是10的右子树比11小,所
以要把10的右子树放入到11的左子树考点六: 平衡二叉树
在对AVL树进行插入或删除一个结点后,通常会影响到从根结点
到插入结点的路径上的某些结点,这些结点的子树可能发生变化。
11
11
10
9
10
9 11
10
9
LR考点六: 平衡二叉树
10成为调整以后的根结点,那么如果10有左子树和右子树怎么办呢?我们
具体分析一下,因为10成为根节点,10的右子树比10大,需要放入到调整以后
的10的右子树,但是10的右子树比11小,所以要把10的右子树放入到11的左子
树。10的左子树比10小,需要放入到调整以后的10的左子树,但是10的左子树
比9大,所以要把10的右子树放入到9的右子树。考点六: 平衡二叉树
在对AVL树进行插入或删除一个结点后,通常会影响到从根结点到
插入结点的路径上的某些结点,这些结点的子树可能发生变化。
9
10
10
9 11
11
RR考点六: 平衡二叉树
那么这里会有问题,10成为调整以后的根结点,那么如果10有左子树怎么
办呢?我们具体分析一下,因为10成为根节点,10的左子树比10小,需要放
入到调整以后的10的左子树,但是10的左子树比9大,所以要把10的右子树放
入到9的右子树。考点六: 平衡二叉树
在对AVL树进行插入或删除一个结点后,通常会影响到从根结点到
插入结点的路径上的某些结点,这些结点的子树可能发生变化。
9 9
10
10
11
9 11
11
10
RL考点六: 平衡二叉树
那么这里会有问题,10成为调整以后的根结点,那么如果10有左子树和右
子树怎么办呢?我们具体分析一下,因为10成为根节点,10的右子树比10大,
需要放入到调整以后的10的右子树,但是10的右子树比11小,所以要把10的
右子树放入到11的左子树。10的左子树比10小,需要放入到调整以后的10的
左子树,但是10的左子树比9大,所以要把10的右子树放入到9的右子树。考点六: 平衡二叉树
设序列{40, 35, 20,15, 25, 10},构造平衡二叉树
2
2
4400 3355 20
1 1
35 20 40 15 35
0
1
20 15 25 10 25 40
0
10
新插入结点10和最小不平衡子树根结点35之间的关系——LL型
扁担原理:将根结点看成是扁担中肩膀的位置
旋转优先:旋转下来的结点作为新根结点的孩子考点六: 平衡二叉树
设序列{20, 35, 40, 38, 45, 50},构造平衡二叉树
-2
40
3355
2200
-1
20 40 35 45
35
0
38 45 20 38 50
40
50
新插入结点50和最小不平衡子树根结点35之间的关系——RR型
扁担原理:将根结点看成是扁担中肩膀的位置
旋转优先:旋转下来的结点作为新根结点的孩子考点六: 平衡二叉树
设序列{35, 45, 20, 50, 40, 38} ,构造平衡二叉树
3355
35
20 45
20 40
40 50
第 1 次调整
38 45
38
50
新插入结点38和最小不平衡子树根结点35之间的关系——RL型
扁担原理:将根结点看成是扁担中肩膀的位置考点六: 平衡二叉树
设序列{35, 45, 20, 50, 40, 38} ,构造平衡二叉树
3355
35
20 45 40
20 40
40 50
第 1 次调整 第 2 次调整 35 45
38 45
38
20 38 50
50
新插入结点38和最小不平衡子树根结点35之间的关系——RL型
扁担原理:将根结点看成是扁担中肩膀的位置
旋转优先:旋转下来的结点作为新根结点的孩子考点六: 平衡二叉树
设序列{35, 20, 30},构造平衡二叉树
3355
35
30
20
30
20 35
第 1 次调整 第 2 次调整
30
20
新插入结点30和最小不平衡子树根结点35之间的关系——LR型
扁担原理:将根结点看成是扁担中肩膀的位置考点六: 平衡二叉树
输入关键字序列(16,3,7,11,9,26,18,14,15),给出构造一棵AVL
树的步骤。
1
0
16
插入3
插入16
16 0
3
2
16
0
-1 7
插入7 LR调整
0
3
0
3 16
0 7考点六: 平衡二叉树
-1
0 7
7
0
插入11
0
1
3 16
0
3 16
0
11
-1
7 7
0
2 0
插入9 3 16 3 11
LL调整
1 0 0
11 9 16
0
9考点六: 平衡二叉树
-1
-2
7 7
0
插入26
0 -1
3 11 3 11
1 0 -1
9 16 9 16
0
26
0
11
0
-1
7 16
0 0 0
3 9 26考点六: 平衡二叉树
11
0
11
-2
0
7 16
-1
插入18
7 16
-1
3 9 26
0 0 0
3 9 26
0
18
0
11
0
0
7 18
0
0
0 0
3 9 16 26考点六: 平衡二叉树
-1
0
11 11
0
0 插入14 1
7 18 7 18
0
0
0 0 1
3 9 16 26 3 9 16 26
0
14考点六: 平衡二叉树
-1
11 11
0
1
7 18 7 18
插入15
0
0
0 1 2
3 9 16 26 3 9 16 26
0 -1 -1
14 14
11
0
0
1
15
7 18
0
0
0 0
3 9 15 26
0
0
AVL树构造完毕
14 16【平衡二叉树删除】考点六: 平衡二叉树
平衡二叉树中删除关键字为k的结点方式与二叉排序树删除相似。
但删除后可能破坏平衡二叉树的平衡性,解决方法是调整。考点六: 平衡二叉树
具体步骤
首先在AVL树中查找关键字为k的结点x(假定存在这样的结点并且唯一),
删除结点x的过程如下:
(1)如果结点x左子树为空,用其右孩子结点替换它,即直接删除结点x。
(2)如果结点x右子树为空,用其左孩子结点替换它,即直接删除结点x。考点六: 平衡二叉树
(3)如果结点x同时有左右子树(这种情况下,结点x是通过值替换间接删
除的,称为间接删除结点),分为两种情况:
① 若结点x的左子树较高,在其左子树中找到最大结点q,直接删除结
点q,用结点q的值替换结点x的值。
② 若结点x的右子树较高,在其右子树中找到最小结点q,直接删除结
点q,用结点q的值替换结点x的值。考点六: 平衡二叉树
(4)当直接删除结点x时,沿着其双亲到根结点方向逐层向上求结点的平衡
因子,若一直找到根结点时路径上的所有结点均平衡,说明删除后的树仍然是
一棵平衡二叉树,不需要调整,删除结束。若找到路径上的第一个失衡结点p,
就要进行调整。考点六: 平衡二叉树
图所示是一棵平衡二叉树,画出从树中删除22、删除3、删除10与9后树的形
态和旋转的类型,要求以被删关键字的中序下的直接前驱替补该被删关键字。考点六: 平衡二叉树
(1)删除22后,用20代替22的位置,17,13和9构成LL型调整,调整过程如
图所示。考点六: 平衡二叉树
(1)删除22后,用20代替22的位置,17,13和9构成LL型调整,调整过程如
图所示。考点六: 平衡二叉树
(2)删除3后,9,12和10构成RL型调整,调整过程如图所示。考点六: 平衡二叉树
(2)删除3后,9,12和10构成RL型调整,调整过程如图所示。考点六: 平衡二叉树
(4)删除10后,用9代替,此时可以让不做调整,如图所示。考点六: 平衡二叉树
(3)删除9后,用12代替,此时可以让13,17,20构成RR型调整,或者
13,17,16构成RL型调整,我们用13,17,20构成RR型调整,如图所示。考点六: 平衡二叉树
(3)删除9后,用12代替,此时可以让13,17,20构成RR型调整,或者
13,17,16构成RL型调整,我们用13,17,20构成RR型调整,如图所示。【平衡二叉树的性能分析】考点六: 平衡二叉树
设深度为h的平衡二叉排序树所具有的最少结点数为N ,则由平衡
h
二叉排序树的性质知:
N =0,N =1,N =2,… ,N = N +N + 1
0 1 2 h h-1 h-2
含有n个结点的平衡二叉树的最大深度为O(log n) ,平衡二叉树的
2
平均查找长度为O(log n)
2【政哥题型总结】考点六: 平衡二叉树
1.已知关键字的集合{56,8,15,80,10,22,28,50,60,40,90},试按给出的序列构
造一棵平衡二叉树。考点六: 平衡二叉树
1.已知关键字的集合{56,8,15,80,10,22,28,50,60,40,90},试按给出的序列构
造一棵平衡二叉树。
【解析】根据元素的顺序,插入元素,当出现不平衡时,进行调整。
如图7(a)所示,插入56、8、15,会出现LR调整,将15作为根,如图7-(b)所
示。考点六: 平衡二叉树
1.已知关键字的集合{56,8,15,80,10,22,28,50,60,40,90},试按给出的序列构
造一棵平衡二叉树。
【解析】接着插入10、22、80,如图(c)所示,考点六: 平衡二叉树
1.已知关键字的集合{56,8,15,80,10,22,28,50,60,40,90},试按给出的序列构
造一棵平衡二叉树。
【解析】再插入28,如图(d)所示,此时不需要调整。考点六: 平衡二叉树
1.已知关键字的集合{56,8,15,80,10,22,28,50,60,40,90},试按给出的序列构
造一棵平衡二叉树。
【解析】如图(e)所示,插入50,此时22、28、50满足RR调整,如图(f)所示。考点六: 平衡二叉树
1.已知关键字的集合{56,8,15,80,10,22,28,50,60,40,90},试按给出的序列构
造一棵平衡二叉树。
【解析】如图(g)所示,插入60、40,此时15、56、28满足RL调整,此时28成
为根,28的原左子树成为15的右子树,28的原右子树成为56的左子树,如图(h)
所示。考点六: 平衡二叉树
1.已知关键字的集合{56,8,15,80,10,22,28,50,60,40,90},试按给出的序列构
造一棵平衡二叉树。
【解析】如图 (i)所示,插入90,构建结束。考点六: 平衡二叉树
2.将关键码DEC FEB NOV OCT JUL SEP AUG APR MAY JUN JAN依次插入
到一棵初始为空的AVL树中。
(1)画出得到的AVL树。考点六: 平衡二叉树
2.将关键码DEC FEB NOV OCT JUL SEP AUG APR MAY JUN JAN依次插入
到一棵初始为空的AVL树中。
(1)画出得到的AVL树。
【解析】(1)根据关键码的序列,从一棵空树开始构造一个AVL树,其构造顺序和
调整方式如图所示,在图中省略了每一个结点插入的细节,大家注意按照序列的
先后顺序依次插入各个结点。考点六: 平衡二叉树
2.将关键码DEC FEB NOV OCT JUL SEP AUG APR MAY JUN JAN依次插入
到一棵初始为空的AVL树中。
(1)画出得到的AVL树。
【解析】(1)根据关键码的序列,从一棵空树开始构造一个AVL树,其构造顺序和
调整方式如图所示,在图中省略了每一个结点插入的细节,大家注意按照序列的
先后顺序依次插入各个结点。考点六: 平衡二叉树
2.将关键码DEC FEB NOV OCT JUL SEP AUG APR MAY JUN JAN依次插入
到一棵初始为空的AVL树中。
(1)画出得到的AVL树。
【解析】(1)根据关键码的序列,从一棵空树开始构造一个AVL树,其构造顺序
和调整方式如图所示,在图中省略了每一个结点插入的细节,大家注意按照序
列的先后顺序依次插入各个结点。考点六: 平衡二叉树
2.将关键码DEC FEB NOV OCT JUL SEP AUG APR MAY JUN JAN依次插入
到一棵初始为空的AVL树中。
(1)画出得到的AVL树。
【解析】(1)根据关键码的序列,从一棵空树开始构造一个AVL树,其构造顺序
和调整方式如图所示,在图中省略了每一个结点插入的细节,大家注意按照序
列的先后顺序依次插入各个结点。考点六: 平衡二叉树
2.将关键码DEC FEB NOV OCT JUL SEP AUG APR MAY JUN JAN依次插入
到一棵初始为空的AVL树中。
(2)删除关键码MAY,为保持AVL树的特性,应如何进行删除和调整?考点六: 平衡二叉树
2.将关键码DEC FEB NOV OCT JUL SEP AUG APR MAY JUN JAN依次插入
到一棵初始为空的AVL树中。
(2)删除关键码MAY,为保持AVL树的特性,应如何进行删除和调整?
【解析】删除关键码MAY,为保持AVL树的特性,NOV,OCT,SEP满足RR调
整,如图(b)所示,调整后如图(c)所示。考点六: 平衡二叉树
2.将关键码DEC FEB NOV OCT JUL SEP AUG APR MAY JUN JAN依次插入
到一棵初始为空的AVL树中。
(2)删除关键码MAY,为保持AVL树的特性,应如何进行删除和调整?
【解析】删除关键码MAY,为保持AVL树的特性,NOV,OCT,SEP满足RR调
整,如图(b)所示,调整后如图(c)所示。考点六: 平衡二叉树
2.将关键码DEC FEB NOV OCT JUL SEP AUG APR MAY JUN JAN依次插入
到一棵初始为空的AVL树中。
(3)若接着删除关键码FEB,又应如何删除与调整?考点六: 平衡二叉树
2.将关键码DEC FEB NOV OCT JUL SEP AUG APR MAY JUN JAN依次插入
到一棵初始为空的AVL树中。
(3)若接着删除关键码FEB,又应如何删除与调整?
【解析】接着删除关键码FEB,根据替换规则,FEB具有左、右子树,可以使用中
序直接前驱或者中序直接后继代替,因为平衡二叉排序树属于二叉排序树。当采
用中序直接后继代替时,用JAN代替FEB,如图 (b)所示;考点六: 平衡二叉树
2.将关键码DEC FEB NOV OCT JUL SEP AUG APR MAY JUN JAN依次插入
到一棵初始为空的AVL树中。
(3)若接着删除关键码FEB,又应如何删除与调整?
【解析】接着删除关键码FEB,根据替换规则,FEB具有左、右子树,可以使用
中序直接前驱或者中序直接后继代替,因为平衡二叉排序树属于二叉排序树。
当采用中序直接前驱代替时,用DEC代替FEB,如图(c)所示。THANKSCON T EN T S
目录
考点一 查找的基本概念
考点二 顺序查找
考点三 折半查找 ★★★★
考点四 分块查找
考点五 二叉排序树 ★★★★★
考点六 平衡二叉树 ★★★★★
考点七 红黑树
考点八 索引查找 ★★★
考点九 散列查找 ★★★★★考点框架
红黑树的定义
红黑树的操作【红黑树的定义】考点七: 红黑树
1、红黑树的定义
前面我们已经学了AVL树,AVL树的查找、插入和删除在平均和最
坏情况下都是O(logn),但是AVL 树的左右子树高度差绝对值不超过1,
插入或者删除后重新调整平衡可能需要多达O(logn)次旋转,频繁地调
整平衡导致全树整体拓扑结构的变化。而红黑树在AVL 树“适度平衡”
的基础上,加了一些约束条件:红黑树的左右子树高度差不超过两倍,
本质上说,红黑树也是一种平衡二叉搜索树。考点七: 红黑树
红黑树是一棵二叉排序树,每个结点有一个表示颜色的标志,增加外
部结点(通常用nil表示),同时满足以下性质:
① 每个结点的颜色为红色或者黑色。
② 根结点的颜色为黑色。
③ 所有外部结点的颜色为黑色。
④ 如果一个结点是红色,则它的所有孩子结点为黑色。
⑤ 对于每个结点,从该结点出发的所有路径上包含相同个数的黑色结点。
路径特指从一个结点到其子孙结点中某个外部结点的路径。考点七: 红黑树
一棵红黑树 12
15
5
3 10 13 17
4 7 11 14
6 8考点七: 红黑树
红黑树是一种弱平衡二叉树,查找性能为O(log n)
2
第4条性质(如果一个结点是红色,则它的所有孩子结点为黑色) 任
何一条路径上不能有两个相邻的红色结点,这样最短的可能路径均由黑
色结点构成,最长的可能路径由交替的红色和黑色结点构成。
+
第5条性质(从每个结点出发的所有路径上包含相同个数的黑色结点)
所有最长的路径都有相同个数的黑色结点。
从根结点到叶子结点的最长路径的长度不大于最短路径长度的两倍。
含n个结点的红黑树的高度至多为2log (n+1),因此红黑树查找算法
2
的平均时间复杂度为O(log n)。
2【红黑树的操作】考点七: 红黑树
x y
左旋
y 右旋 x
a c
b c a b
实际上AVL树中的各种调整可以通过上述旋转操作实现:LL型调整就是对结点A
做右旋操作,RR型调整就是对结点A做左旋操作,LR型调整就是先对结点B做
左旋操作再对结点A做右旋操作,而RL型调整就是先对结点B做右旋操作再对结
点A做左旋操作。考点七: 红黑树
① 当前结点N的叔叔结点U是红色。
调整方式是采用改变结点颜色的操作:
将双亲结点P和叔叔结点U的颜色改为黑色,祖父结点G的颜色改为红色
(用来维护第5条性质)。
以祖父结点G为当前结点继续进行调整。
G
G
双亲 叔叔 双亲 叔叔
P U
P U
N
N
a b c
a b c考点七: 红黑树
② 当前结点N的叔叔结点U是黑色,并且结点N是右孩子。
调整方式:
左旋以双亲结点P为根的子树。
再以结点P为当前结点按情况③继续进行调整。
G
G
P U 左旋子树P N U
a N d e P
c d e
b c
a b考点七: 红黑树
③ 当前结点N的叔叔结点U是黑色,并且结点N是左孩子。
调整方式:
先右旋以祖父结点G为根的子树。
然后交换以前的双亲结点P和祖父结点G的颜色。
G P P
右旋子树G 改变颜色
P U
N G N G
N
c d e U U
a b c a b c
a b
d e d e考点七: 红黑树
上述插入过程的时间复杂度为O(log n),而且插入中的旋转操作不超过两次。
2
红黑树中删除结点的操作也是先按二叉排序树删除方法删除对应的结点,然
后进行判断和调整使其满足红黑树的性质,这里不再详述。同样删除过程的
时间复杂度为O(log n)。
2考点七: 红黑树
11 11
改变颜色
11 11
14 2 14
(a)插入11 (b)插入14 (c)插入2
G N
11 11 11
P U
改变颜色
2 14 2 14 改变颜色 2 14
N
7 7 7
(d)插入7考点七: 红黑树
11
11
P
P
2 14
2 14
N
1 7 15 N
1 7
(e)插入1 (f)插入15
11 11 11
G N
2 14 2 14 2 14
改变颜色
P
U P
1 7 15 1 7 15 1 7 15
N N
5 5 5 8
(g)插入5
(h)插入8考点七: 红黑树
插入关键字4
11 11 G 11 G
P P
U U
2 14 2 14 7 14
G 改变颜色 N 子树P左旋 N
1 7 15 1 7 15 2 8 15
P
U
5 8 5 8 1 5
N
4 4 4考点七: 红黑树
插入关键字4
P
7 7
G
11 11
2 2
子树G右旋
改变颜色
1 5 8 14 1 5 8 14
4 15 4 15THANKSCON T EN T S
目录
考点一 查找的基本概念
考点二 顺序查找
考点三 折半查找 ★★★★
考点四 分块查找
考点五 二叉排序树 ★★★★★
考点六 平衡二叉树 ★★★★★
考点七 红黑树
考点八 索引查找 ★★★
考点九 散列查找 ★★★★★考点框架考点框架
B-树的定义和性质
B-树的查找
B-树的插入
B-树的删除
B+树的定义和性质
B-树和B+的对比【B-树的定义和性质】考点八: 索引查找
1、索引查找的引入
平衡二叉排序树便于动态查找,因此用平衡二叉排序树来组织索引
表是一种可行的选择。当用于大型数据库时,所有数据及索引都存储在
外存,因此,涉及到内、外存之间频繁的数据交换,这种交换速度的快
慢成为制约动态查找的瓶颈。考点八: 索引查找
1、索引查找的引入
若以二叉树的结点作为内、外存之间数据交换单位,则查找给定关
键字时对磁盘平均进行㏒ n次访问是不能容忍的,因此,必须选择一种
2
能尽可能降低磁盘I/O次数的索引组织方式。树结点的大小尽可能地接近
页的大小。
R.Bayer和E.Mc Creight在1972年提出了一种多路平衡查找树,称
为B_树(其变型体是B+树) 。考点八: 索引查找
2、B树的定义
一棵3阶B树:
根结点
10
内
部
结
3 6 13 18
点
1 2 4 5 7 9 11 12 14 17 19 20 叶子结点层
外部结点层
一棵m阶B树或者是一棵空树,或者是满足要求的m叉树:
树中每个结点至多有m个孩子结点(即至多有m-1个关键字)
最多关键字个数Max = m-1考点八: 索引查找
2、B树的定义
一棵3阶B树:
根结点
10
内
部
结
3 6 13 18
点
1 2 4 5 7 9 11 12 14 17 19 20 叶子结点层
外部结点层
除根结点外,其他非叶子结点至少有m/2个孩子结点(即至少有
m/2-1=(m-1)/2个关键字);
最少关键字个数Min = m/2-1考点八: 索引查找
2、B树的定义
一棵3阶B树:
根结点
10
内
部
结
3 6 13 18
点
1 2 4 5 7 9 11 12 14 17 19 20 叶子结点层
外部结点层
若根结点不是叶子结点,则根结点至少有两个孩子结点;考点八: 索引查找
2、B树的定义
一棵3阶B树:
根结点
10
内
部
结
3 6 13 18
点
1 2 4 5 7 9 11 12 14 17 19 20 叶子结点层
外部结点层
每个结点的结构如下,结点中按关键字大小顺序排列:
n p k p k p … k p
0 1 1 2 2 n n考点八: 索引查找
2、B树的定义
每个结点的结构如下,结点中按关键字大小顺序排列:
n p k p k p … k p
0 1 1 2 2 n n
其中,n(m/2 −1≤n≤m−1)为关键码的个数,K(1≤i≤n)为关键码,且
i
K< K+1(1≤i≤n-1),A(0≤i≤n)为指向子树根结点的指针,且指针A所指
i i i i
子树中所有结点的关键码均小于K+1大于K。
i i考点八: 索引查找
2、B树的定义
一棵3阶B树:
根结点
10
内
部
结
3 6 13 18
点
1 2 4 5 7 9 11 12 14 17 19 20 叶子结点层
外部结点层
所有外部结点都在同一层上。B树是所有结点的平衡因子均等于0的多路查找树。
注意:在计算B树的高度时,有时计入最底层的外部结点考点八: 索引查找
2、B树的定义
B树:一棵m阶的B树或者为空树,或者为满足下列特性的m叉树:
(1)每个结点至多有m棵子树;
(2)所有结点都包含以下数据:
(n,A ,K ,A ,K ,…,K ,A )
0 1 1 2 n n
其中,n(m/2 −1≤n≤m −1)为关键码的个数,K (1≤i≤n)为关键码,且
i
K < K +1(1≤i≤n-1),A (0≤i≤n)为指向子树根结点的指针,且指针A 所指子
i i i i
树中所有结点的关键码均小于K +1大于K ;
i i
(3)根结点至少有两棵子树;
(4)除根结点之外的所有结点至少有m/2 棵子树;
(5)叶子结点都在同一层;【B-树的查找】考点八: 索引查找
在磁盘中进行
B 树的查找过程:
在内存中进行
(1)顺指针查找结点:按照指针到相应的子树中查找;
(2)在结点中查找关键码:若在结点内找到,则查找成功;
(3)重复上述两步,到达外部结点时,查找失败。
在磁盘上进行查找的次数,是决定 B
树查找效率的首要因素。考点八: 索引查找
将k与根结点中的key[i]进行比较:
若k=key[i],则查找成功;
若k<key[1],则沿着指针ptr[0]所指的子树继续查找;
若key[i]<k<key[i+1],则沿着指针ptr[i]所指的子树继续查找;
若k>key[n],则沿着指针ptr[n]所指的子树继续查找。
k= k
2
说明:当查找到某个叶结点时,若相应的
k k k
1 2 3
指针为空,落入一个外部结点,表示查找
k<k<k
k<k 1 2 k>k
1 3 失败。考点八: 索引查找
一棵3阶B树
根结点
10
内
部
3 6 13 18
结
点
1 2 4 5 7 9 1111 1122 14 17 19 20 叶子结点层
外部结点层
查找关键字11 查找成功考点八: 索引查找
一棵3阶B树
根结点
10
内
部
3 6 13 18
结
点
1 2 4 5 7 9 11 12 14 17 19 20 叶子结点层
外部结点层
查找关键字8 查找失败考点八: 索引查找
B-树的查找次数等价于树高,含有n个关键字,m阶B-树高的范围是:
log (n+1) <= h <= log ((n+1)/2)+1
m m/2
(1) 总关键字数目 n = 每个节点的关键字数 * 总的节点数,所以 n 最大可取:
1(1−𝑚ℎ)
n <= (m-1) * (1+ m + m^2 + m^3 + ... + mh-1)) = (m-1) *
𝑚−1
层 最多结点数 最多关键字数
第一层 1 m-1
𝑛 ≤ 𝑚ℎ − 1
第二层 m m*(m-1)
所以:h >= log (n+1)
第三层 m * m m * m * (m-1) m
…
这是h的最小值;每层结
…
点达到最大值
第h-1层 mh-2 mh-2*(m-1)
第h层 mh-1 mh-1*(m-1)考点八: 索引查找
(2)树中的除根之外的非叶节点最少有[m/2]棵子树,而根结点若不是
叶子结点,则至少有两棵子树。于是:
层 最少结点数 最少关键字数
第一层 1 1
第二层 2 2*(m/2 -1)
第三层 2*(m/2 ) 2*(m/2 ) *(m/2 -1)
…
…
第h-1层 2*(m/2)h-1 2*(m/2)h-1*(m/2 -1)
第h层 2*(m/2)h-2 2*(m/2)h-2*(m/2 -1)
n ≥ 1 + 2 (m/2) + (m/2)2 + ⋯+ ((m/2)h−2 ∗ (m/2 − 1)考点八: 索引查找
含有 n 个关键码的 m 阶 B 树,最坏情况下的深度是多少呢?
第一层至少有1个结点
m
2
根结点
第二层至少有2个结点
非终端结点至少有 棵子树
第三层至少有2 个结点
m
2
根结点至少有两棵子树
m
以此类推,第k+1层至少有2 ( )k-1个结点
2
若 m 阶 B 树有 n 个关键码,则第k+1层有n+1个结点(失败结点)
m
k−1
n +1 2( )
第k+1层为查找不成功的结点 2
考点八: 索引查找
含有 n 个关键码的 m 阶 B 树,最坏情况下的深度是多少呢?
n + 1 2 (
m
2
)
k − 1
因此,含有 n 个关键码的 m 阶 B 树的最大深度是
i
k
= 1
m
i − 1
= l o g
m
n + 1
k l o g
m / 2
(
n
l o
+
2
g
1
m
) +
/ 2
1
(
n +
2
1
) + 1考点八: 索引查找
B-树的查找次数等价于树高,含有n个关键字,m阶B-树高的范围是:
log (n+1) <= h <= log ((n+1)/2)+1
m m/2【B-树的插入】考点八: 索引查找
B树的生成也是从空树起,逐个插入关键字。插入时不是每插入一个关键字就
添加一个叶子结点,而是首先在最低层的某个叶子结点中添加一个关键字,然后
有可能“分裂”。
➢ 插入看上界
➢ 超过要分裂
➢ 根分高一层考点八: 索引查找
将关键字k插入到B树的过程分两步完成:
(1)查找该关键字的插入结点(注意B树的插入结点一定是叶子结点层的
结点)。
(2)插入关键字k。考点八: 索引查找
在某个叶子结点中插入关键字分两种情况
插入结点有空位置,即关键字个数n<m-1:直接把关键字k有序
插入到该结点的合适位置上。考点八: 索引查找
插入结点没有空位置,即原关键字个数n=m-1 分裂。
分裂过程:
k
双亲结点
i
k 分裂
i
插入k后的中间位
置关键字
如果没有双亲结点,新建一个双亲结点,树的高度增加一层。
如果有双亲结点,将k插入到双亲结点中。
i考点八: 索引查找
假定在 m 阶 B 树中插入关键码key,设n=m-1,插入过程如下:
(1)定位:确定关键码key应该插入哪个叶子结点并返回该结点的指针p
(2)若 p 中的关键码个数小于n,则直接插入关键码key
(3)若 p 中的关键码个数等于n,则执行“分裂——提升”
(4)如果提升到父结点的关键码个数等于n ,则继续执行“分裂——提升”考点八: 索引查找
关键字序列为:(1,2,6,7,11,4,8,13,10,5,17,9,16,
20,3,12,14,18,19,15)。
创建一棵5阶B树。
注意:最多的关键字个数Max = m-1 = 4
Max=4
关键字序列 1 2 6 7
11 21 21 62 6 7考点八: 索引查找
关键字序列为:(1,2,6,7,11,4,8,13,10,5,17,9,16,
20,3,12,14,18,19,15)。
创建一棵5阶B树。
注意:最多的关键字个数Max = m-1 = 4
Max=4
11 4 8 13
关键字序列
6
1 2 6 7 11
分裂
11 2 2 4 777 8 8 1 11111 13
关键字个数>4考点八: 索引查找
关键字序列为:(1,2,6,7,11,4,8,13,10,5,17,9,16,
20,3,12,14,18,19,15)。
创建一棵5阶B树。
注意:最多的关键字个数Max = m-1 = 4
10 5 17 9 16
Max=4
关键字序列
分裂
6 6 10
1 2 4 7 8 10 11 13 11 2 2 4 45 77 8 8 9 111111 11 331 31167 17
关键字个数>4考点八: 索引查找
关键字序列为:(1,2,6,7,11,4,8,13,10,5,17,9,16,
20,3,12,14,18,19,15)。创建一棵5阶B树。
注意:最多的关键字个数Max = m-1 = 4
关键字序列 20
6 10
1 2 4 5 7 8 9 11 13 16 17 20
分裂
关键字个数>4
6 10 16
1 2 4 5 7 8 9 11 13 17 20考点八: 索引查找
关键字序列为:(1,2,6,7,11,4,8,13,10,5,17,9,16,
20,3,12,14,18,19,15)。创建一棵5阶B树。
注意:最多的关键字个数Max = m-1 = 4
关键字序列 3
6 10 16
1 2 3 4 5 7 8 9 11 13 17 20
分裂
关键字个数>4
3 6 10 16
1 2 4 5 7 8 9 11 13 17 20考点八: 索引查找
关键字序列为:(1,2,6,7,11,4,8,13,10,5,17,9,16,
20,3,12,14,18,19,15)。创建一棵5阶B树。
注意:最多的关键字个数Max = m-1 = 4
关键字序列 12 14 18 19
3 6 10 16
1 2 4 5 7 8 9 1111 1122 1133 14 111777 1 12880 2 109 20考点八: 索引查找
关键字序列为:(1,2,6,7,11,4,8,13,10,5,17,9,16,
20,3,12,14,18,19,15)。创建一棵5阶B树。
注意:最多的关键字个数Max = m-1 = 4
15
关键字序列
3 6 10 16
1 2 4 5 7 8 9 11 12 13 14 15 17 18 19 20
关键字个数>4
分裂
3 6 10 13 16 关键字个数>4
1 2 4 5 7 8 9 11 12 14 15 17 18 19 20考点八: 索引查找
3 6 10 13 16 关键字个数>4
1 2 4 5 7 8 9 11 12 14 15 17 18 19 20
继续分裂
10
3 6 13 16
1 2 4 5 7 8 9 11 12 14 15 17 18 19 20
B树构建完毕考点八: 索引查找【B-树的删除】考点八: 索引查找
在B树上删除关键字k的过程分两步完成:
(1)查找关键字k所在的结点p。
(2)在结点p中删除关键字k。
在结点p中删除关键字k分两种情况:
结点p为叶子结点。
结点p为非叶子结点。
注意:一般结点的关键字最少个数Min=m/2-1考点八: 索引查找
假定在 m 阶 B 树中删除关键码key,删除过程如下:
(1)定位:确定关键码key在哪个结点并返回该结点的指针q。
假定key是结点 q 中的第 i个关键码K,有以下两种情况:
i
1.1 若结点 q是叶子结点,则删除key;
1.2 否则用 A所指左子树中的最大值 x或者右子树中的最小值替换K;删除 x;
i i
(2)判断是否下溢
2.1 如果叶子结点中关键码的个数大于 -1,则直接删除;
m
2
2.2 否则,删除操作涉及到兄弟结点
2.2.1 兄弟结点的关键码个数大于 ,则向兄弟结点借一个关键码,
并且借来的关键码“上移”到双亲结点,双亲结点相应关键码“下移”;
m
2
2.2.2 否则执行“合并”兄弟操作;删除空结点,并将双亲结点
中的相应关键码“下移”到合并结点中;【合并左兄弟或者右兄弟】考点八: 索引查找
给定5阶 B树,给出删除8,16,15,4等4个关键字的过程。
Min=2 8
删除:
10
3 6 13 16
1 2 4 5 77 8 99 11 12 14 15 17 18 19 20考点八: 索引查找
Min=2 删除: 16
10
3 6 1133 1167
1 2 4 5 7 9 11 12 14 15 17 18 19 20
右边子树找最小
关键字考点八: 索引查找
Min=2 15
删除:
10
3 6 13 17
1 2 4 5 7 9 11 12 14 15 18 19 20考点八: 索引查找
10
Min=2 删除: 4
3 6 13 18
1 2 4 5 7 9 11 12 14 17 19 20
合并
10
6 13 18
1 2 3 5 7 9 11 12 14 17 19 20考点八: 索引查找
10
合并
关键字个数<2 6 13 18
1 2 3 5 7 9 11 12 14 17 19 20
6 10 13 18
删除完毕
1 2 3 5 7 9 11 12 14 17 19 20考点八: 索引查找
思考题
在B树中每删除一个关键字,都要删除一个结点吗?
在B树中删除一个关键字,若引起合并,树高一定会降低一层吗?【B+树的定义和性质】考点八: 索引查找
B+树是B树的一种变形。一棵4阶的B+树示例:
31 52 根结点 索
引
部
15 22 31 47 52 分
sqt 叶子结
点层:
10 12 15 18 19 20 22 23 30 31 33 45 47 48 50 52
全部的
关键字
张
三
关键字指向的元素。考点八: 索引查找
31 52 根结点 索
引
部
15 22 31 47 52 分
sqt 叶子结
点层:
10 12 15 18 19 20 22 23 30 31 33 45 47 48 50 52
全部的
关键字
张
三
关键字指向的元素。 B+树的定义:一棵m阶B+树满足下列要求:
每个分支结点至多有m棵子树。这里m=4。考点八: 索引查找
31 52 根结点 索
引
部
15 22 31 47 52 分
sqt 叶子结
点层:
10 12 15 18 19 20 22 23 30 31 33 45 47 48 50 52
全部的
关键字
张
三
关键字指向的元素。
根结点或者没有子树,或者至少有两棵子树。考点八: 索引查找
31 52 根结点 索
引
部
15 22 31 47 52 分
sqt 叶子结
点层:
10 12 15 18 19 20 22 23 30 31 33 45 47 48 50 52
全部的
关键字
张
三
关键字指向的元素。
除根结点外,其他每个分支结点至少有m/2
棵子树,即至少有2棵子树。考点八: 索引查找
31 52 根结点 索
引
部
15 22 31 47 52 分
sqt 叶子结
点层:
10 12 15 18 19 20 22 23 30 31 33 45 47 48 50 52
全部的
关键字
张
三
关键字指向的元素。
有n棵子树的结点恰好有n个关键字。子树个数
与该结点的关键字个数相同。考点八: 索引查找
31 52 根结点 索
引
部
15 22 31 47 52 分
sqt 叶子结
点层:
10 12 15 18 19 20 22 23 30 31 33 45 47 48 50 52
全部的
关键字
张
三
关键字指向的元素。
所有叶子结点包含全部关键字及指向相应元素
的指针,而且叶子结点按关键字大小顺序链接。
并将所有叶子结点链接起来。考点八: 索引查找
31 52 根结点 索
引
部
15 22 31 47 52 分
sqt 叶子结
点层:
10 12 15 18 19 20 22 23 30 31 33 45 47 48 50 52
全部的
关键字
张
三
关键字指向的元素。 所有分支结点(可看成是索引的索引)中仅包含
它的各个子结点(即下级索引的索引块)中最大
关键字及指向子结点的指针。考点八: 索引查找
31 52 根结点 索
引
部
15 22 31 47 52 分
sqt 叶子结
点层:
10 12 15 18 19 20 22 23 30 31 33 45 47 48 50 52
全部的
关键字
张
三
关键字指向的元素。 所有分支结点(可看成是索引的索引)中仅包含
它的各个子结点(即下级索引的索引块)中最大
关键字及指向子结点的指针。考点八: 索引查找
root 通过该指针可以实现随机查找
B+树查找
31 52 根结点 索
引
部
通过该
指针可以 15 22 31 47 52 分
实现顺序
查找
sqt 叶子结
点层:
10 12 15 18 19 20 22 23 30 31 33 45 47 48 50 52
全部的
关键字
张
三
关键字指向的元素。考点八: 索引查找
root 通过该指针可以实现随机查找
B+树查找
31 52 根结点 索
引
部
通过该
指针可以 15 22 31 47 52 分
实现顺序
查找
sqt 叶子结
点层:
10 12 15 18 19 20 22 23 30 31 33 45 47 48 50 52
全部的
关键字
张
三
关键字指向的元素。 与B_树相比,对B+树可以从最小关键字起,按叶子
结点的链接顺序进行顺序查找。【B-树和B+的对比】考点八: 索引查找
B-(B树) B+树
子树个数 关键字个数 子树个数 关键字个数
根结点 2~m 1~(m-1) 2~m 2~m
中间结点 m/2 ~m m/2-1 ~m-1 m/2 ~m m/2 ~m
结点重复 否 是
查找 只有随机方式 随机方式和顺序方式
关键字 在B树中,各结点中包含的关键字是不 叶结点包含全部关键字,非叶结点中出
重复的 现过的关键字也会出现在叶结点中
存储信息 B树的结点中都包含了关键字对应的记 叶结点包含信息,所有非叶结点仅起索
录的存储地址 引作用,非叶结点中的每个索引项只含
有对应子树的最大关键字和指向该子树
的指针,不含有该关键字对应记录的存
储地址。
n个关键字 对应n+1个子树 对应n个子树THANKSCON T EN T S
目录
考点一: 查找的基本概念
考点二: 顺序查找
考点三: 折半查找 ★ ★ ★ ★
考点四: 分块查找
考点五: 二叉排序树 ★ ★ ★ ★ ★
考点六: 平衡二叉树 ★ ★ ★ ★ ★
考点七: 红黑树
考点八: 索引查找 ★ ★ ★
考点九: 散列查找 ★ ★ ★ ★ ★考点框架考点框架
散列的基本思想
几种常见的散列函数
处理冲突的方法——开放定址法
处理冲突的方法——拉链法
散列查找的性能考点九:散列查找
散列的基本思想考点九:散列查找考点九:散列查找
查找操作要完成什么任务?
待查值k 确定 k 在存储结构中的位置
前面学过哪些查找技术?这些查找技术有什么共性呢?
(1)顺序查找
0 1 2 3 4 5 6 7 8 9
10 15 24 6 12 35 40 98 55考点九:散列查找
查找操作要完成什么任务?
待查值k 确定 k 在存储结构中的位置
前面学过哪些查找技术?这些查找技术有什么共性呢?
(1)顺序查找 ==、!= 63
<、==、> 55 90
(2)折半查找
(3)二叉排序树查找
42 58 70
通过一系列的给定值与关键码的比较,
查找效率依赖于查找过程中进行的给定值与关键码的比较次数
O(log n)
2考点九:散列查找
能否不用比较,通过关键码能够直接确定存储位置?
在存储位置和关键码之间建立一个确定的对应关系
设关键码key在存储结构中的位置是addr,则有addr= H(key)。
比较式查找
查找技术
计算式查找考点九:散列查找
散列的基本思想:在记录的关键码和存储地址之间建立一个确定
的对应关系,通过计算得到待查记录的地址。
…
关
…
键
H
码 k H(k ) r
i i i
集
合
…
…考点九:散列查找
散列表:采用散列技术存储查找集合的连续存储空间。
散列函数:将关键码映射为散列表中适当存储位置的函数。
散列地址:由散列函数所得的存储地址。
…
散列函数
关
…
键
H
码 k H(k ) r
i i i 散列表
集
散列地址
合
…
…
数组
下标考点九:散列查找
如何解决冲突?
如何设计散列函数?
冲突:对于两个不同关键码k ≠k ,有H(k )=H(k )。
i j i j
同义词:k 和 k 相对于H 称做同义词。
i j
…
关
…
键
H
码 k H(k ) r
i i i
集
k
合
j …
…考点九:散列查找
散列是一种完整的存储结构吗?
散列只是通过记录的关键码定位该记录,没有完整地表达记录之
间的逻辑关系,所以,散列主要是面向查找的存储结构
…
关
…
键
H
码 k H(k ) r
i i i
集
合
…
…考点九:散列查找
散列是一种完整的存储结构吗?
散列技术最适合回答的问题是:
如果有的话,哪个记录的关键码等于待查值
…
关
…
键
H
码 k H(k ) r
i i i
集
合
…
…考点九:散列查找
设计一个散列表应包括:
① 散列表的空间范围,即确定散列函数的值域;
② 构造合适的散列函数,使得对于所有可能的元素(记录的关键字),
函数值均在散列表的地址空间范围内,且出现冲突的可能尽量小;
③ 处理冲突的方法。即当冲突出现时如何解决。
…
关
…
键
H
码 k H(k ) r
i i i
集
k
合
j …
…考点九:散列查找
几种常见的散列函数考点九:散列查找
如何设计散列函数?
(1)计算简单。散列函数不应该有很大的计算量,否则会降低查找效率。
(2)地址均匀。函数值要尽量均匀散布在地址空间,保证存储空间的
有效利用并减少冲突。
…
关
…
键
H
码 k H(k ) r
i i i
集
合
…
…考点九:散列查找
直接定址法
散列函数是关键码的线性函数,即:
H(key) = a key + b (a,b为常数)
关键码集合为{10, 30, 50, 70, 80, 90},选取的散列函数为H(key)=key/10,
散列表构造过程如下:
0 1 2 3 4 5 6 7 8 9
10 30 50 70 80 90
适用于:事先知道关键码,关键码集合不是很大且连续性较好考点九:散列查找
平方取中法
对关键码平方后,按散列表大小,取中间的若干位作为散列地址。
散列地址为 2 位,设计平方取中法的散列函数。
(1234)2=1522756
平方扩大了相近数之间的差别
(1235)2=1525225
适用于:事先不知道关键码的分布且关键码的位数不是很大考点九:散列查找
除留余数法
H(key)=key mod p
如何选取合适的 p,才能产生较少的同义词?
关键码 14 21 28 35 42 49 56
散列地址 14 0 7 14 0 7 14
小于等于表长(最好接近表长)的最大素数考点九:散列查找
除留余数法
H(key)=key mod p
散列表长为15,设计除留余数法的散列函数。
H(key)= key mod 13
散列技术名称的演变过程
Hash 哈希 杂凑 散列
适用于:最简单、最常用,不要求事先知道关键码的分布考点九:散列查找
假设哈希表长度m=13,采用除留余数法哈希函数建立如下关键字集合的哈希表
(16,74,60,43,54,90,46,31,29,88,77),共11个关键字。
• n=11,m=13,设计除留余数法的哈希函数为:
• h(k)=kmod p
• p应为小于等于m的素数,设p=13。
关键字:16 74 60 43 54 90 46 31 29 88 77
hhhhhhhhh(((((((((176459432640340619)))))))))=========3984217532
0 1 2 3 4 5 6 7 8 9 10 11 12
54 16 43 31 46 60 74 90
注意:存在哈希冲突。考点九:散列查找
处理冲突的方法——开放定址法考点九:散列查找
冲突:对于两个不同关键码k ≠k ,有H(k )=H(k )。
i j i j
同义词:k 和 k 相对于H 称做同义词。
i j
…
关
…
键
H
码 k H(k ) r
i i i
集
k
合
j …
…考点九:散列查找
开放定址法如何处理冲突?
对于给定的关键码key执行下述操作:
(1)计算散列地址:j= H(key)
(2)如果地址 j的存储单元没有存储记录,则存储key对应的记录;
(3)如果在地址 j 发生冲突,则寻找一个空的散列地址,存储key对应的记录;
闭散列表:用开放定址法处理冲突得到的散列表
如何寻找一个空的散列地址呢?
(1)线性探测法;(2)二次探测法;考点九:散列查找
线性探测法:从冲突位置的下一个位置起,依次寻找空的散列地址。
设散列表的长度为m,对于键值key,发生冲突时,寻找空散列地址的公式为:
H =(H(key)+d ) % m (d =1,2,…,m-1)
i i i考点九:散列查找
假设哈希表长度m=13,采用除留余数法哈希函数建立如下关键字集
合的哈希表:
(16,74,60,43,54,90,46,31,29,88,77)。
并采用线性探测法解决冲突。考点九:散列查找
关键字:16 74 60 43 54 90 46 31 29 88 77
h(29)=3 冲突
d =3,d =(3+1) % 13=4 仍冲突
0 1
d =(4+1) % 13=5 仍冲突
2
d =(5+1) % 13=6 OK
3
0 1 2 3 4 5 6 7 8 9 10 11 12
77 54 16 43 31 29 46 60 74 90
共探测4次考点九:散列查找
关键字:16 74 60 43 54 90 46 31 29 88 77
h(88)=10
0 1 2 3 4 5 6 7 8 9 10 11 12
77 54 16 43 31 29 46 60 74 88 90
共探测1次考点九:散列查找
关键字:16 74 60 43 54 90 46 31 29 88 77
h(77)=12
冲突
d =12,d =(12+1) % 13=0 OK
0 1
0 1 2 3 4 5 6 7 8 9 10 11 12
77 54 16 43 31 29 46 60 74 88 90
共探测2次
哈希表创建完毕考点九:散列查找
最终的哈希表
哈希表ha[0..12]
下标 0 1 2 3 4 5 6 7 8 9 10 11 12
k 77 54 16 43 31 29 46 60 74 88 90
探测次数 2 1 1 1 1 4 1 1 1 1 1
哈希表的构成:
• 哈希函数: 本例为h(k)=kmod 13
• 解决冲突方法:本例为线性探测法考点九:散列查找
• 查找关键字为29的记录:
• h(29)=29%13=3:16≠29;
• d =3,d =(3+1)=4:43≠29;
0 1
• d =(4+1)=5:31≠29;
2
• d =(5+1)=6:29=29。成功!
3
• 需要4次关键字比较
下标 0 1 2 3 4 5 6 7 8 9 10 11 12
k 77 54 16 43 31 29 46 60 74 88 90
探测次数 2 1 1 1 1 4 1 1 1 1 1
哈希表成功查找完毕考点九:散列查找
对于前面构建的哈希表:成功查找ASL 计算
成功
哈希表ha[0..12]
下标 0 1 2 3 4 5 6 7 8 9 10 11 12
k 77 54 16 43 31 29 46 60 74 88 90
探测次数 2 1 1 1 1 4 1 1 1 1 1
探测次数恰好等于查找到该记录所需要的关键字比较次数!
2+1+1+1+1+4+1+1+1+1+1
ASL成功= =1.364
11考点九:散列查找
查找关键字x=47的记录
h(47)=47%13=8:
60≠47
d =8,d =(8+1)=9: 74≠47
0 1
d =(9+1)=10: 88≠47
2
d =(10+1)=11: 此处为空,查找失败!
3
下标 0 1 2 3 4 5 6 7 8 9 10 11 12
k 77 54 16 43 31 29 46 60 74 88 90
探测次数 2 1 1 1 1 4 1 1 1 1 1
需要4次关键字比较
哈希表失败查找完毕考点九:散列查找
对于前面构建的哈希表:不成功查找ASL 计算
不成功
哈希表ha[0..12]
下标 0 1 2 3 4 5 6 7 8 9 10 11 12
k 77 54 16 43 31 29 46 60 74 88 90
探测次数 2 1 10 9 8 7 6 5 4 3 2 1 3
一个关键字一不个在关有键效字关不键在字有集效合关中键,字但集其合哈中希,函但数其值哈为希0函,数采值用线性探
测法找到空为位2,置采,用需线要性 2次探关测键法字找比到较空位置,需要10次关键字
比较
2+1+10+9+8+7+6+5+4+3+2+1+3
= 4.692
ASL =
不成功
13考点九:散列查找
线性探测法的特点
◆ 优点:只要散列表未满,总能找到一个不冲突的散列地址;
◆ 缺点:每个产生冲突的记录被散列到离冲突最近的空地址上,从
而又增加了更多的冲突机会(这种现象称为冲突的“聚集”)。考点九:散列查找
二次探测法:以冲突位置为中心,跳跃式寻找空的散列地址。
设散列表的长度为m,对于键值key,发生冲突时,寻找空散列地址的公式为:
H=(H(key)+d) % m (d= 12,-12,22,-22,… , q2,-q2(q≤m/2))
i i i
设关键码集合为 {47, 7, 29, 11, 16, 92, 22, 8, 3},散列表表长为11,
散列函数为H(key)=key mod 11,用二次探测法处理冲突,散列表的
构造过程如下:
0 1 2 3 4 5 6 7 8 9 10
11 22 3 47 92 16 7 29 8
22 3 3 29 8考点九:散列查找
相对于线性探测法,二次探测法能够在一定程度上减少堆积
设H(k ) = 6,H(k ) = 5,对于线性探测法:
i j
k 的探测序列:6, 7, 8, 9, …
i
重合之后再不分开
k 的探测序列:5, 6, 7, 8, …
j
设H(k ) = 6,H(k ) = 5,对于二次探测法:
i j
k 的探测序列:6, 7, 5, 10, 2, …
i
重合之后很快分开
k 的探测序列:5, 6, 4, 9, 1, …
j考点九:散列查找
处理冲突的方法——拉链法考点九:散列查找
拉链法如何处理冲突?
对于给定的关键码key执行下述操作:
(1)计算散列地址:j = H(key)
(2)将key对应的记录插入到同义词子表 j 中;
同义词子表:所有散列地址相同的记录构成的单链表。
开散列表:用拉链法处理冲突得到的散列表。
开散列表中存储同义词子表的头指针,开散列表不会出现堆积现象考点九:散列查找
地址 头结点
拉链法
…
是把所 h(k )=h(k )= … = i
x y
有的同
哈
义词用 i k k
希
x y
单链表 表
地 …
链接起
址
来的方
空
j k k
间 s t
法。
…
h(k )=h(k )= … = j
s t考点九:散列查找
假设哈希表长度m=13,采用除留余数法哈希函数建立如下关键字集合
的哈希表: (16,74,60,43,54,90,46,31,29,88,77)。
并构造采用拉链法解决冲突的哈希表。考点九:散列查找
0 ∧
采
1 ∧
用
拉 2 54 ∧
链
3 29 16 ∧
法
关键字集合: 构 4 43 ∧
造
(16,74,60,43,
5 31 ∧
的
54,90,46,31, 哈 6 ∧
希
29,88,77)
7 46 ∧
表
h
a 8 60 ∧
[
0
9 74 ∧
.
.
1
2 10 88 ∧
]
11 ∧
12 77 90 ∧考点九:散列查找
∧
0
∧
1
查找成功
54 ∧
2
3 29 16 ∧
4 43 ∧
• 查找关键字为90的记录:
5 31 ∧
• h(90)=90%13=12
∧
6
• p指向ha[12]的第1个结点,77≠90;
7 46 ∧
• p指向ha[12]的第2个结点,90=90。成功! 8 60 ∧
• 2次关键字比较 9 74 ∧
10 88 ∧
• 哈希表成功查找完毕
p
∧
11
12 77 90 ∧考点九:散列查找
0 ∧
成功找到第1层的结点,均需要1次关键字比较,
1 ∧
共9个结点
2 54 ∧
成功找到第2层的结点,均需要2次关键字
3 比较,共2个结点
29 16 ∧
4
43 ∧
5
31 ∧
6 ∧
7
46 ∧
8
60 ∧
9 1×9+2×2
74 ∧
ASL = =1.182
成功
10
88 ∧ 11
11 ∧
12
77 90 ∧考点九:散列查找
查找不成功 0 ∧
1 ∧
2 54 ∧
3 29 16 ∧
• 查找关键字为59的记录:
4
43 ∧
• h(59)=59%13=7
5
• p指向ha[7]的第1个结点,46≠59; 31 ∧
• p=NULL。失败! 6 ∧ p
• 1次关键字比较 7
46 ∧
• 哈希表不成功查找完毕 8
60 ∧
9
74 ∧
10
88 ∧
11 ∧
12
77 90 ∧考点九:散列查找
0 ∧
1 ∧
有1个结点的单链表,不成功查找需要1
2 54 ∧ 次关键字比较,共有7个这样的单链表
有2个结点的单链表,不成功查找需要2
3 29 16 ∧
次关键字比较,共有2个这样的单链表
4
43 ∧
5
31 ∧
6 ∧
7
46 ∧
1×7+2×2
8 ASL = =0.846
60 ∧ 不成功
13
9
74 ∧
α=n/m
10
88 ∧
11 ∧
12
77 90 ∧考点九:散列查找
用关键字序列{7,8,30,11,18,9,14}构造一个哈希表,哈希表的存储空
间是一个下标从0开始的一维数组,哈希函数为H(key)=(key×3) mod 7,处理
冲突采用线性探测法,要求装填(载)因子为0.7。
(1)画出所构造的哈希表。
(2)分别计算等概率情况下,查找成功和查找不成功的平均查找长度。考点九:散列查找
(1)这里n=7,α=0.7=n/m,则m=n/0.7=10。
H(7)=7×3 mod 7=0
H(8)=8×3 mod 7=3
H(30)=30×3 mod 7=6
{7,8,30,11,18,9,
H(11)=11×3 mod 7=5
14} ;哈希函数为
H(key)=(key×3) mod 7 H(18)=18×3 mod 7=5 冲突
d=(5+1) mod 10=6
1
仍冲突
d=(6+1) mod 10=7
2
H(9)=9×3 mod 7=6 冲突
d=(6+1) mod 10=7
1
仍冲突
d=(7+1) mod 10=8
2
H(14)=14×3 mod 7=0 冲突
d=(0+1) mod 10=1
1
下标 0 1 2 3 4 5 6 7 8 9
关键字 7 14 8 11 30 18 9
探测次数 1 2 1 1 1 3 3考点九:散列查找
下标 0 1 2 3 4 5 6 7 8 9
关键字 7 14 8 11 30 18 9
探测次数 1 2 1 1 1 3 3
(2)在等概率情况下:考点九:散列查找
下标 0 1 2 3 4 5 6 7 8 9
关键字 7 14 8 11 30 18 9
探测次数 1 2 1 1 1 3 3
不成功的探
3 2 1 2 1 5 4
测次数
(2)在等概率情况下:H(key)=(key×3) mod 7
任何关键字不属于{7,8,30,11,18,9,14}
的关键字x,H(x)在0~6之间考点九:散列查找
散列查找的性能考点九:散列查找
散列技术的查找性能取决于什么?
产生冲突后,仍然是给定值与关键码进行比较
影响冲突产生的因素有什么?
(1)散列函数是否均匀
(2)处理冲突的方法考点九:散列查找
散列技术的查找性能取决于什么?
产生冲突后,仍然是给定值与关键码进行比较
影响冲突产生的因素有什么?
(1)散列函数是否均匀
(2)处理冲突的方法
表中填入的记录数
(3)散列表的装填因子α =
散列表的长度考点九:散列查找
散列表的平均查找长度是装填因子 α 的函数,
而不是查找集合中记录个数 n 的函数——O(1)!考点九:散列查找
【政哥题型总结】考点九:散列查找
1.对于关键字集{30,15,21,40,25,26,36,37},若查找表的装填因子为0.8,采
用线性探测再散列方法解决冲突。
(1)设计哈希函数。
(2)画出哈希表。
(3)计算查找成功和查找失败时的平均查找长度。考点九:散列查找
1.对于关键字集{30,15,21,40,25,26,36,37},若查找表的装填因子为0.8,
采用线性探测再散列方法解决冲突。
(1)设计哈希函数。
解析 (1)因为表中元素有8个,且装填因子是0.8,哈希表长是10,按照除留余
数法的定义,哈希函数是H=key% 7。考点九:散列查找
1.对于关键字集{30,15,21,40,25,26,36,37},若查找表的装填因子为0.8,采
用线性探测再散列方法解决冲突。
(2)哈希函数是H=key% 7,且用线性探测再散列方法解决冲突,我们可以逐个
元素进行哈希运算。当发生冲突时,进行冲突解决。其计算过程如下。
30%7=2,此时2的位置没有元素,将30放入到2的位置,比较次数是1;
15%7=1,此时1的位置没有元素,将15放入到1的位置,比较次数是1;
21%7=0,此时0的位置没有元素,将21放入到0的位置,比较次数是1;
40%7=5,此时5的位置没有元素,将40放入到5的位置,比较次数是1;
25%7=4,此时4的位置没有元素,将25放入到4的位置,比较次数是1;
26%7=5,此时5的位置有元素,采用线性探测法,6的位置没有元素,将
26放入到6的位置,比较次数是2;
地址 0 1 2 3 4 5 6 7 8 9
元素 21 15 30 25 40 26
比较次数 1 1 1 1 1 2考点九:散列查找
1.对于关键字集{30,15,21,40,25,26,36,37},若查找表的装填因子为0.8,采
用线性探测再散列方法解决冲突。
、(2)哈希函数是H=key% 7,且用线性探测再散列方法解决冲突,我们可以逐
个元素进行哈希运算。当发生冲突时,进行冲突解决。其计算过程如下。
36%7=1,此时1的位置有元素,采用线性探测法,探测2的位置有元素,
继续探测3的位置没有元素,将36放入到3的位置,比较次数是3;
37%7=2,此时2的位置有元素,采用线性探测法,探测3、4、5、6的位
置均有元素,继续探测7的位置没有元素,将37放入到7的位置,比较次数是6。
最终的结果如下表所示。
地址 0 1 2 3 4 5 6 7 8 9
元素 21 15 30 36 25 40 26 37
比较次数 1 1 1 3 1 1 2 6考点九:散列查找
1.对于关键字集{30,15,21,40,25,26,36,37},若查找表的装填因子为0.8,
采用线性探测再散列方法解决冲突。
(3)计算查找成功和查找失败时的平均查找长度。
地址 0 1 2 3 4 5 6 7 8 9
元素 21 15 30 36 25 40 26 37
比较次数 1 1 1 3 1 1 2 6
请大家注意,对于线性探测法,不成功的标志是从某个位置出发,找到空位置。其探测过
程如下。当从0开始查找时,找到8的位置,需要查找9次;
当从1开始查找时,找到8的位置,需要查找8次;
当从2开始查找时,找到8的位置,需要查找7次;
当从3开始查找时,找到8的位置,需要查找6次;
当从4开始查找时,找到8的位置,需要查找5次;
当从5开始查找时,找到8的位置,需要查找4次;
当从6开始查找时,找到8的位置,需要查找3次。
失败的位置有7个。考点九:散列查找
2.设给定关键字输入序列为{100,90,120,60,78,36,42,31,15},用散列法散列
0~10的地址区间。要求:设计一合理的散列函数,冲突时用链表法解决。写
出散列算法,并构造出散列表,计算在等概率查找情况下查找成功时的平均查
找长度是多少?
解析 散列法散列0~10的地址区间,根据除留余数法,构造哈希函数H=key
% 11。当冲突时,用链表法解决,构造0 ~10的单链表,构造过程如下。
100 % 11=1,插入到地址1中(我们在考试中不用考虑头插或尾插,只需
要依次插入就可以);
90 % 11=2,插入到地址2中;120 % 11=10,插入到地址10中;
60 % 11=5,插入到地址5中;78 % 11=1,插入到地址1中;
36 % 11=3,插入到地址3中;42 % 11=9,插入到地址9中;
31 % 11=9,插入到地址9中;15 % 11=4,插入到地址4中。考点九:散列查找
2.设给定关键字输入序列为{100,90,120,60,78,36,42,31,15},用散列法散列
0~10的地址区间。要求:设计一合理的散列函数,冲突时用链表法解决。写出
散列算法,并构造出散列表,计算在等概率查找情况下查找成功时的平均查找
长度是多少?考点九:散列查找
3.设有一组关键字{9,1,14,55,20,84,27},采用哈希函数:H(key)=key mod
7,表长为10,用开放定址法的二次探测法解决冲突。要求:对该关键字序列
构造哈希表,并计算查找成功时的平均查找长度。
解析 哈希函数为H(key)-key mod 7,表长为10,用开放定址法的二次探测法解决冲突。
9 % 7=2,此时2的位置没有元素,将9放入到2的位置,比较次数是1;
1 % 7=1,此时1的位置没有元素,将1放入到1的位置,比较次数是1;
14 % 7=0,此时0的位置没有元素,将14放入到0的位置,比较次数是1;
55 % 7=6,此时6的位置没有元素,将55放入到6的位置,比较次数是1;
地址 0 1 2 3 4 5 6 7 8 9
元素 14 1 9 55
比较次数 1 1 1 1考点九:散列查找
3.设有一组关键字{9,1,14,55,20,84,27},采用哈希函数:H(key)=key
mod 7,表长为10,用开放定址法的二次探测法解决冲突。要求:对该关键字
序列构造哈希表,并计算查找成功时的平均查找长度。
解析 哈希函数为H(key)-key mod 7,表长为10,用开放定址法的二次探测
法解决冲突。
20 % 7=6,此时6的位置有元素,采用二次探测法,查找(6+1)的位置,
位置7中没有元素,将20放入到7的位置,比较次数是2;
84 % 7=0,此时0的位置有元素,采用二次探测法,探测(0+1)的位置,
位置1中有元素,继续探测(0-1)的位置,位置9中没有元素,将84放入到9的
位置,比较次数是3;
27 % 7=6,此时6的位置有元素,采用二次探测法,查找(6+1)的位置,
位置7中有元素,继续探测(6-1)的位置,位置5中没有元素,将27放入到5的
位置,比较次数是3。
地址 0 1 2 3 4 5 6 7 8 9
元素 14 1 9 27 55 20 84
比较次数 1 1 1 3 1 2 3考点九:散列查找
3.设有一组关键字{9,1,14,55,20,84,27},采用哈希函数:H(key)=key mod
7,表长为10,用开放定址法的二次探测法解决冲突。要求:对该关键字序列
构造哈希表,并计算查找成功时的平均查找长度。考点九:散列查找
4.设散列(Hash)表的地址范围为0~17,散列函数为H(key)=key mod 16,
key 为 关 键 字 , 用 线 性 探 测 法 处 理 冲 突 , 输 入 关 键 字 序 列
(10,24,32,17,31,30,46,47,40,63,49)构造散列表,试回答下列问题:
(1)画出散列表示意图。
(2)若查找关键字63,需要依次与哪些关键字比较?
(3)若查找关键字60,需要依次与哪些关键字比较?
(4)假定每个关键字的查找概率相等,求查找成功和不成功时的平均查找长度。考点九:散列查找
4.设散列(Hash)表的地址范围为0~17,散列函数为H(key)=key mod 16,
key 为 关 键 字 , 用 线 性 探 测 法 处 理 冲 突 , 输 入 关 键 字 序 列
(10,24,32,17,31,30,46,47,40,63,49)构造散列表,试回答下列问题:
(1)画出散列表示意图。
(2)若查找关键字63,需要依次与哪些关键字比较?
(3)若查找关键字60,需要依次与哪些关键字比较?
(4)假定每个关键字的查找概率相等,求查找成功和不成功时的平均查找长度。考点九:散列查找
4.设散列(Hash)表的地址范围为0~17,散列函数为H(key)=key mod 16,
key 为 关 键 字 , 用 线 性 探 测 法 处 理 冲 突 , 输 入 关 键 字 序 列
(10,24,32,17,31,30,46,47,40,63,49)构造散列表,试回答下列问题:
(1)画出散列表示意图。
解析 (1)因为散列函数为H(key)=key mod 16,根据关键字的序列,10 %
16=10;24%16=8;32%16=0;17%16=1;31% 16=15;30 % 16=14;
46%16=14,此时有冲突,根据线性探测法,比较30,比较31,比较空格,放
置到位置16;47%16=15,此时有冲突,根据线性探测法,比较31,比较46,
比较空格,放置到位置17;40 % 16=8,此时有冲突,比较24,比较空格,放
置到位置9;63%16=15,此时有冲突,比较31,比较46,比较47,比较32,
比较17,比较空格,放置到位置2;49%16=1,此时有冲突,比较17,比较
63,比较空格,放置到位置3。最终结果如下表所示。考点九:散列查找
4.设散列(Hash)表的地址范围为0~17,散列函数为H(key)=key mod 16,
key 为 关 键 字 , 用 线 性 探 测 法 处 理 冲 突 , 输 入 关 键 字 序 列
(10,24,32,17,31,30,46,47,40,63,49)构造散列表,试回答下列问题:
(2)若查找关键字63,需要依次与哪些关键字比较?
(3)若查找关键字60,需要依次与哪些关键字比较?
(2)若查找关键字63,首先计算散列地址,63%16=15,比较位置15的元素,并
线性探查,依次比较31,46,47,32,17,63,查找成功,比较6次。
(3)若查找关键字60,首先计算散列地址,60 % 16=12,此时12的位置是空的,
查找失败。考点九:散列查找
4.设散列(Hash)表的地址范围为0~17,散列函数为H(key)=key mod 16,
key 为 关 键 字 , 用 线 性 探 测 法 处 理 冲 突 , 输 入 关 键 字 序 列
(10,24,32,17,31,30,46,47,40,63,49)构造散列表,试回答下列问题:
(4)假定每个关键字的查找概率相等,求查找成功和不成功时的平均查找长度。
(4)假定每个关键字的查找概率相等,THANKS