ARTICLE · 1000746
知识库的召回质量,卡在文档解析这一步:我们把联犀的解析引擎开源了
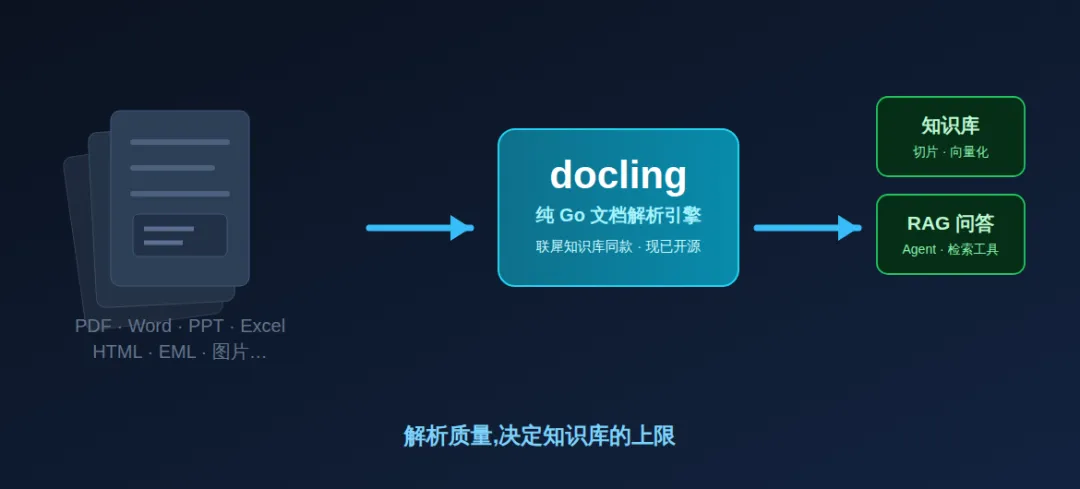
联犀开源 · 知识库解析引擎
知识库的召回质量,卡在文档解析这一步
联犀知识库把文档解析引擎做成了纯 Go 开源库 docling:12 种格式进、4 路输出,图表数据逐格精确还原,OCR 收敛为一个大模型接口。本文从动机讲到架构、实测效果与联犀的完整用法。
知识库同款引擎纯 Go 单二进制兼容 Docling 协议
做 AI 应用绕不开一件事:把文档变成大模型能吃的结构化数据。合同、标书、论文、报表、邮件……格式五花八门,而 LLM 只认 Markdown、JSON 和向量。这个"翻译层"看着不起眼,却直接决定了 RAG 的召回质量——解析时丢掉的表格和数字,检索和重排再怎么调都救不回来。
一、为什么联犀要自己写解析引擎
联犀是物联网 SaaS 平台,客户往知识库里灌的文档非常杂:设备说明书 PDF、验收文档 Word、汇报 PPT、点位表 Excel、告警通知邮件……最初我们调研了两条路,各有硬伤:
路线一,Python 模型管线(如 Docling):识别质量好,但每个部署环境都要拖一套 Python 服务加数 GB 布局/表格模型文件。联犀支持私有化交付,客户机房的环境里塞不下这些;批量导入十万份文档时,逐页过模型的排队时间也无法接受。
路线二,拼装开源库:PDF 一个库、Office 一个库、网页再一个库。输出格式五花八门,表格和图片的语义对不齐——同一个"表格",在 PDF 库里是坐标列表,在 Office 库里是 XML 结构,进了同一个知识库谁也对不上谁,维护成本失控。
于是我们给自己定了三条硬目标:纯 Go 单二进制,跟着联犀后端一起部署,不新增任何运行时依赖;输出统一为 Docling 官方协议,一套模型对接全部格式;解析不确定的内容交给大模型按页增强,但绝不编造结果。这三条催生了 docling。先看它吃什么、吐什么。
二、吃什么、吐什么:12 种输入,4 路输出
输入侧覆盖 12 种格式,一个入口按扩展名自动分发:
PDFWordPPTExcelCSV纯文本
▲ 蓝色:Office 与文档主战场——PDF 深度解析,Office 三件套含批注/修订/公式/图表
HTMLMarkdownAsciiDoc
▲ 绿色:网页与标记语言——标题平铺、富表格、行内格式与链接保留
EML 邮件图片 PNG/JPEG/BMP/WEBP
▲ 黄色:邮件与图片——RFC 头/multipart 择优/字符集解码;图片走 OCR 钩子
Docling JSON 回读
▲ 紫色:Docling 服务产出的 JSON 可直接回读,与 Python 生态互通
输出侧 4 路,全部由同一份结构化模型按需导出:
① Markdown — 文档就绪
标题层级、GFM 表格、代码块、公式 LaTeX、图表内嵌 SVG 预览,喂 LLM 或直接发布均可。
② HTML — 完整文档
与 Markdown 同构渲染,表格锚点、figure/caption 语义齐全,适合在线预览。
③ Docling JSON — 官方协议,无损
schema 1.10.0,与 Python Docling 互通可往返;页码、bbox、provenance 全保留。
④ content_list — RAG 检索列表
扁平化内容列表,带标题路径/页码/类型标签,知识库切片的直接输入。
知识库场景还内置三种分块器:层级分块(对齐官方 HierarchicalChunker,标题进上下文、列表组保持完整)、Hybrid 分块(token 感知切分+表头重复+同标题合并)和知识库分块(联犀在用:默认 900 字、表格每段 100 行并重复表头、过滤页眉页脚)。
格式覆盖只是入场券,解析效果才是核心——不看宣传看实测,下面全部用真实文档。
三、效果如何:真实文档,原文进什么出来
仓库的 examples 对照集为每种格式提供"样例源文件 ↔ 期望输出"的成对样本,以下全部展示真实世界文档的实际识别结果。
案例① Word · 微软官方测试文档(6 个原生图表)
真实 Office 生成的多系列柱状图/折线图文档(微软 Open XML SDK 官方测试资产,MIT 授权):
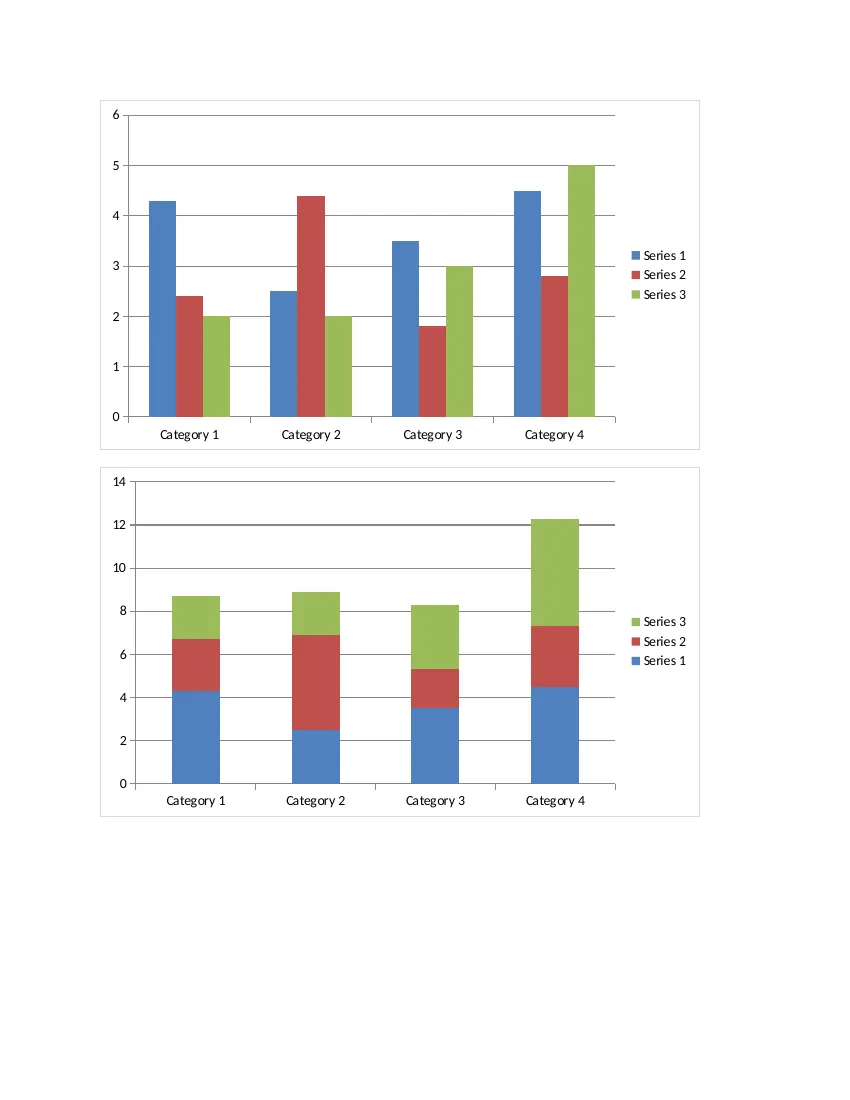
识别后的 Markdown(节选)——图表数据按系列精确还原为可检索表格,缺失单元格如实留空,并附 SVG 语义预览:
| 类别 | Series 1 | Series 2 | Series 3 | | --- | --- | --- | --- | | Category 1 | 4.3 | 2.4 | 2 | | Category 2 | 2.5 | 4.4 | | | Category 3 | 3.5 | 1.8 | 3 | | Category 4 | 4.5 | 2.8 | 5 |案例② PPT · 微软官方演示(3D 饼图)
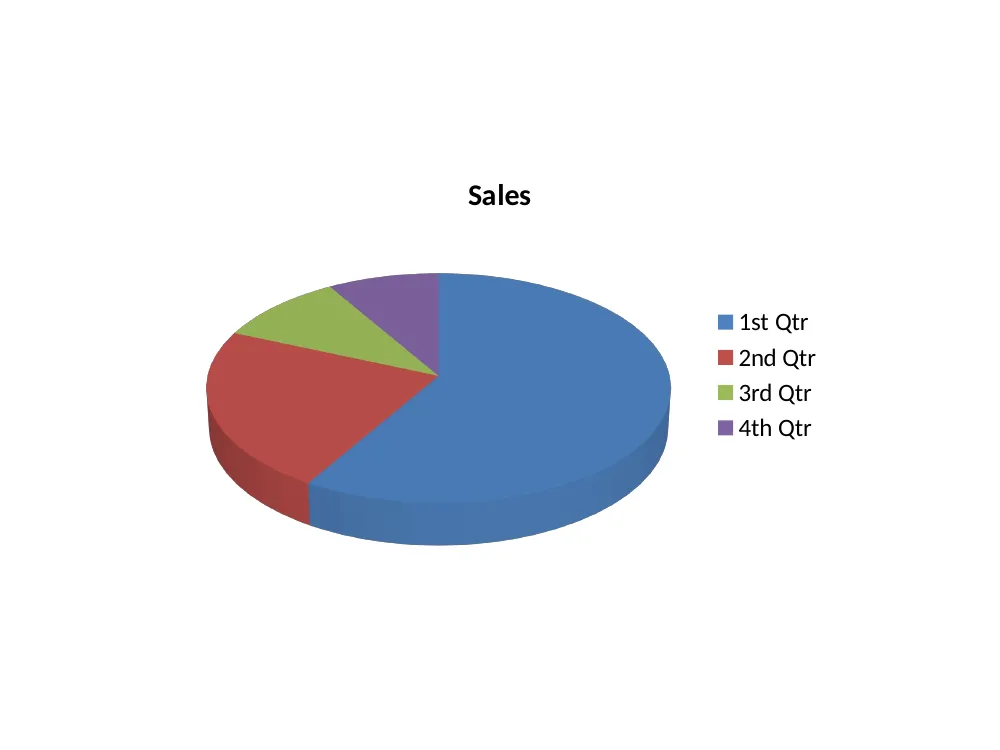
识别后的 Markdown(节选)——3D 饼图的季度数据完整还原:
| 类别 | Sales | | --- | --- | | 1st Qtr | 8.2 | | 2nd Qtr | 3.2 | | 3rd Qtr | 1.4 | | 4th Qtr | 1.2 |案例③ Excel · 微软官方工作簿(OLE 嵌入对象)
工作簿中的 OLE 嵌入对象按语义分类记录(目标路径、程序标识入 meta,载荷不执行)。
案例④ PDF · 真实学术论文(196 页论文 + 10 页双栏会议论文)
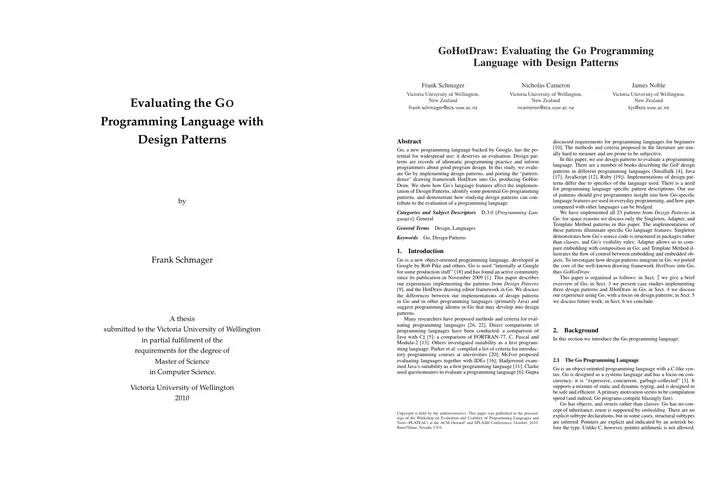
识别后的 Markdown(节选;两份论文 200+ 页纯 Go 解析约 30 秒):
## Evaluating the GO ## Programming Language with ## Design Patterns by ### Frank Schmager A thesis submitted to the Victoria University of Wellington in partial fulfilment of the requirements for the degree of Master of Science in Computer Science. ### Abstract GO is a new object-oriented programming language developed at Google by Rob Pike, Ken Thompson, and others. ...右侧的 10 页双栏会议论文展示双栏阅读顺序还原——左右栏内容不再交错串读。
案例⑤ TXT / CSV / EML · 真实文本类文档
《汤姆·索亚历险记》全书(380KB)、x86 指令集表(3700+ 行)、CPython 标准库的真实 MIME 退信邮件:
# Banned file: auto__mail.python.bat in mail from you From: MAILER DAEMON <> To: <webmaster@python.org> Date: Fri, 26 Nov 2004 19:41:44 -0800 (PST) BANNED FILENAME ALERT Your message to: xxxxxxx@dot.ca.gov, ... was blocked by our Spam Firewall. The email you sent with the following subject has NOT BEEN DELIVERED:邮件头、multipart 正文择优、收件人列表逐项还原;CSV 表与长文本按原样结构化。
案例⑥ 构造样例(rich-*)——复杂对象的确定性对照
对 SmartArt、OMML 公式、艺术字、组合图等复杂对象提供代码构造、可再生产的确定性对照:公式转 LaTeX({E}^{2}=mc)、SmartArt 流程转语义 SVG 且节点文字进入可检索 caption、组合图按系列类型分列渲染。
各格式真实样例总览(全部有授权来源,可放心复现):
以上每个案例 clone 下来跑一条命令即可逐字复现。这些效果的背后,是一条刻意求简的架构。
四、底层架构创新:五个专用组件,收敛为一个模型接口
传统解析管线的复杂度来自"专用组件堆叠":文字识别配 tesseract、版面配布局模型(LayoutLMv3)、表格配 TableFormer、公式配公式模型、阅读顺序再配一个模型——五套依赖、五份部署,每个环节的质量各自为政,升级要逐个换。
docling 把解析任务切成两类,分别交给最合适的执行者:确定性结构交给规则引擎——字体/CMap 恢复、表格网格、双栏切分、公式转换、图表数据回填、阅读顺序,这些有明确规则可循,不需要模型,精确且快。
识别类任务统一收敛给一个多模态大模型接口——OCR 逐字识别、版面视觉、图片表格与公式理解,全部走 OCRHook/VisualHook 两个钩子。依赖从"OCR 引擎 + 4 个模型文件"变成"0 个内置模型 + 1 个可选模型接口":换更强的大模型,整条识别链路一起升级,架构反而更简单:
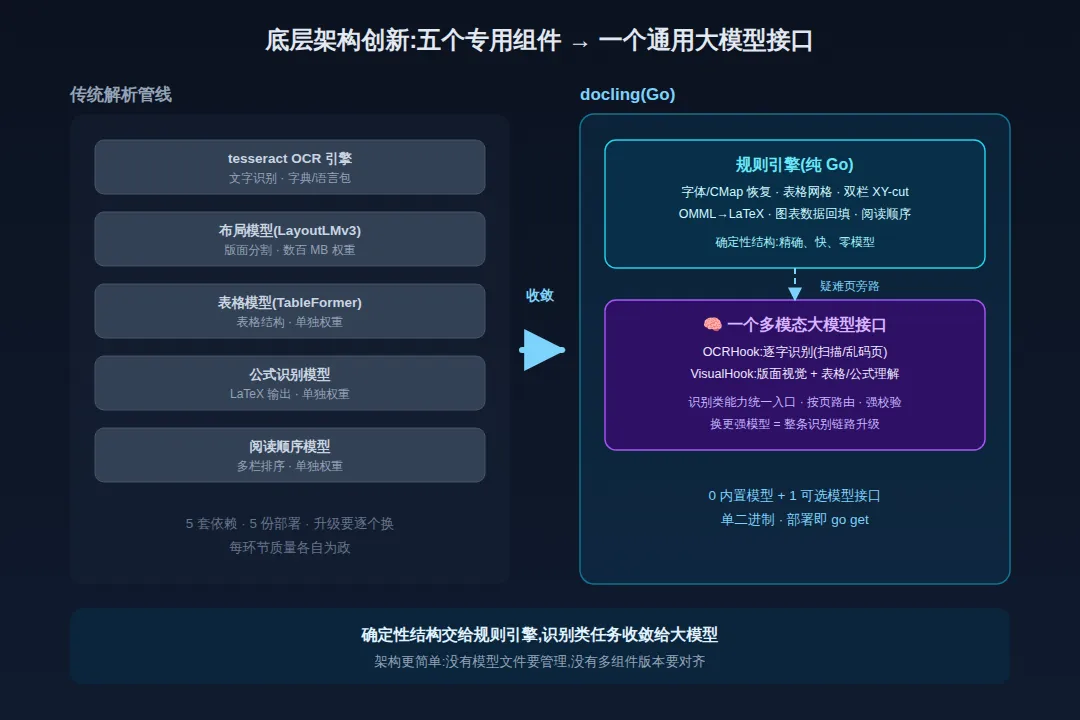
▲ 五个专用组件 → 一个通用大模型接口
路由不是拍脑袋:解析器对每一页计算质量信号——乱码率、表格候选、公式密度、栏位歧义,只有命中疑难信号的页(扫描件、图片表格、公式密集页)才真正调用模型:
doc, err := docling.ParsePDFWithOptions(data, docling.PDFOptions{ GarbageThreshold: 0.4, // 乱码率超 40% 触发 OCR OCRHook: myLLMOCR, // 逐字识别(接任意大模型) VisualHook: myVision, // 带 bbox 的结构化视觉 MaxVisualPages: 20, // 单文档页数预算 })模型返回的结果要过强校验——标签、置信度、表格拓扑、单元格几何、防拒答防复读,无效自动重试一次;有效结果与规则文本按几何去重合并,失败则保留纯 Go 结果。模型增强永远不破坏既有输出。架构简单的第一个红利,就是速度。
五、快多少:34~153 倍
同一台机器、同一批真实 PDF 的实测(Python Docling CPU 管线,同进程预热后计时,对它更公平的口径):
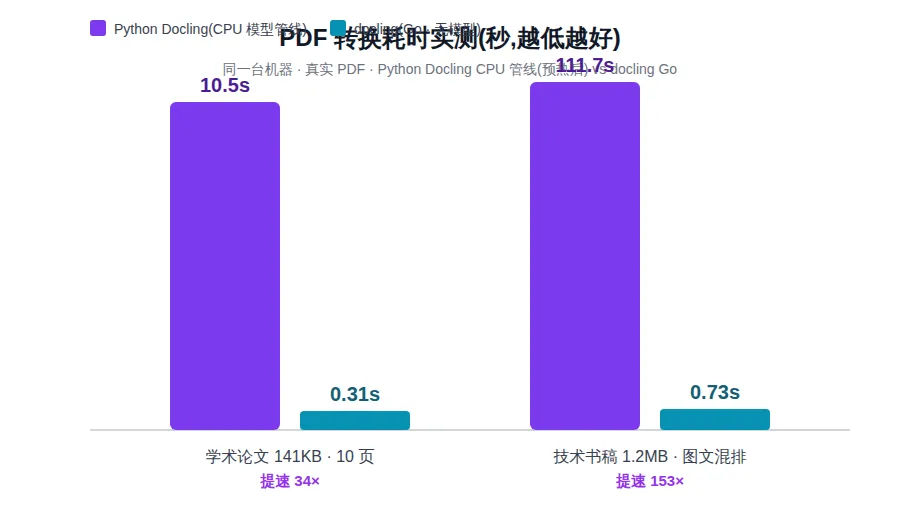
▲ 论文场景提速 34 倍,书稿场景提速 153 倍
196 页论文约 30 秒完成解析入库——对联犀的批量导入场景,这意味着不需要为解析单独准备算力池。说了这么多能力与原理,最后回到它真正的生产环境:联犀知识库是怎么用它的。
六、联犀知识库的完整链路
文档从上传到被 AI 用上,一共六步,docling 站在第二步:
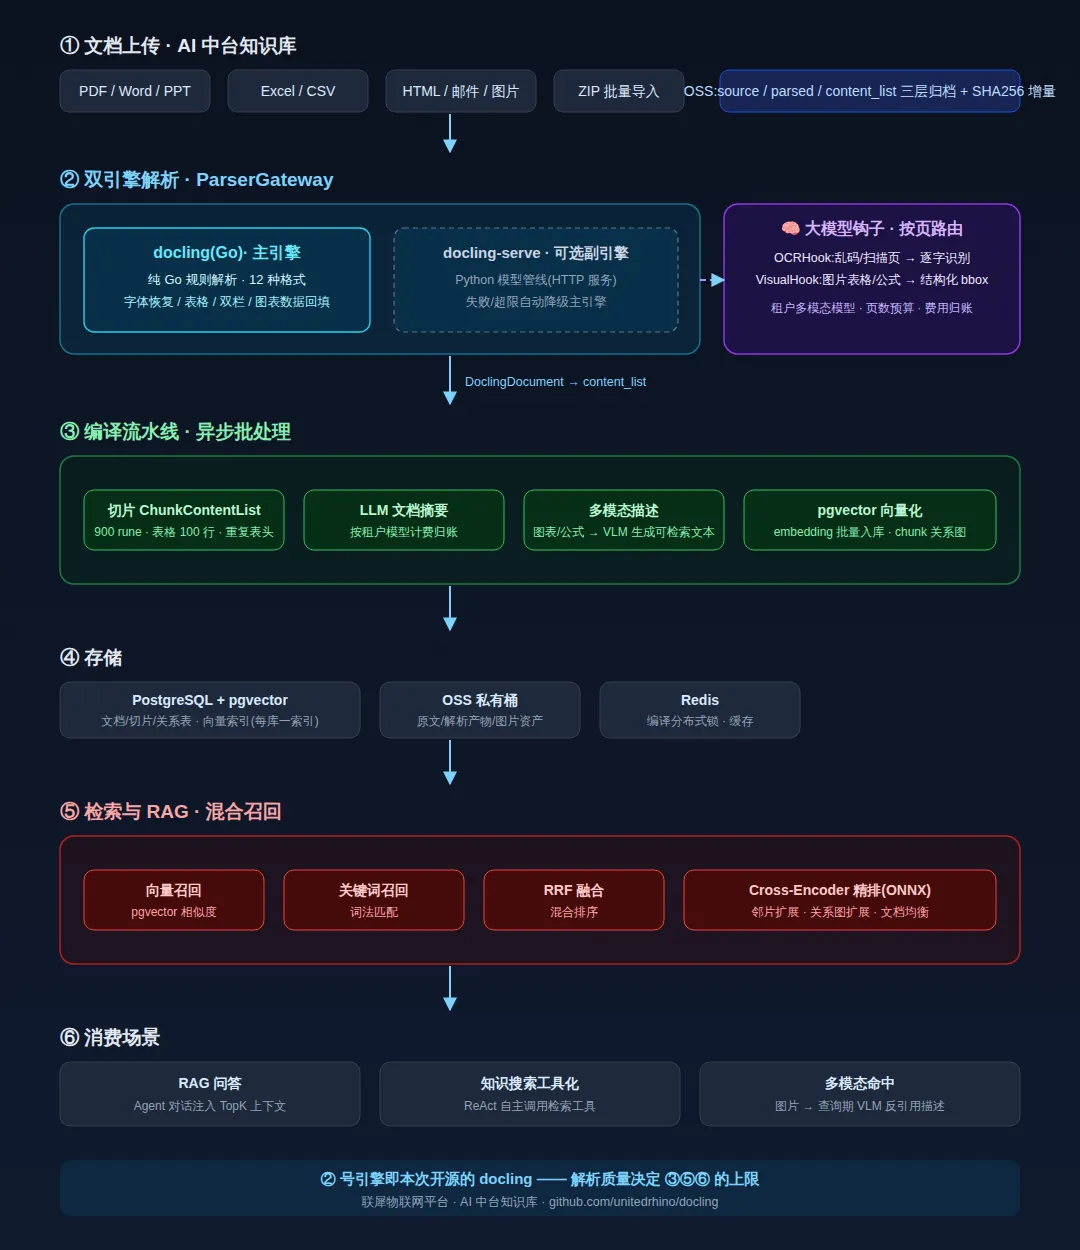
▲ 联犀知识库架构:docling 是第②层解析引擎,质量决定 ③⑤⑥ 的上限
① 上传归档:单文件或 ZIP 批量导入,原文、解析产物、内容列表三层落 OSS 私有桶,SHA256 哈希做增量——没变过的文档不重复解析,变了只重编增量部分。
② 双引擎解析:解析网关优先走 docling(纯 Go,12 种格式全量);对像素级版面要求高的场景可选挂 docling-serve Python 服务做副引擎,失败或超载自动降级,互为兜底。
③ 编译流水线:导入后的异步批处理——切片(知识库分块策略)、LLM 文档摘要、图片/表格/公式生成多模态描述、embedding 向量化入 pgvector、构建切片关系图(向量召回+LLM 判定关系类型)。
④ 存储:PostgreSQL + pgvector(每知识库一个向量索引)+ OSS(原文/产物/图片资产)+ Redis(编译分布式锁)。
⑤ 混合检索:向量召回 + 关键词召回 → RRF 融合 → Cross-Encoder 精排(ONNX),再沿切片关系图扩展上下文、保证文档多样性。
⑥ 消费:Agent 对话注入 RAG 上下文;或模型在推理中自主调用知识检索工具(ReAct);图片命中还能现场调视觉模型生成针对当前查询的描述。联犀侧对大模型钩子做了三层工程保护:结果强校验(防拒答/防复读/表格拓扑)、页数预算(单文档上限)、费用按租户归账。
七、和 Python 官方版的差距,如实说
不回避短板:扫描件 OCR 官方版开箱即用,docling 需配置钩子(配好后能力相当);像素级版面理解(复杂非矩形版面、极端旋转扫描)官方模型管线仍是上限;输入覆盖上音频 ASR、EPUB、XML 系列(XBRL/JATS/USPTO)还在路线图。所以联犀的答案是双引擎——默认纯 Go 跑量,高保真场景挂 Python 副引擎,互为兜底。README 里有完整的差距对照表,两者是互补,不是替代。
八、开源了,欢迎共建
这个引擎已经在联犀生产环境跑了多轮迭代,现在以 MIT 协议开源。如果你也在做知识库、RAG 或 Agent 的文档摄入,上手只要几行:
import docling "github.com/unitedrhino/docling" // 一行完成"解析 → Markdown" md, err := docling.ParseByExtToMarkdown("报告.pdf", data) // 或拿到结构化模型再消费 doc, _ := docling.ParseByExt("报告.docx", data) items := docling.ToContentList(doc, docling.SourceGolight) // 检索列表 chunks := docling.HierarchicalChunks(doc) // RAG 分块仓库自带真实文档对照集:微软官方测试文档、196 页论文、双栏会议论文、《汤姆·索亚历险记》全书、x86 指令集表、真实退信邮件——每格式一组"原文 ↔ 识别结果"成对样本,clone 下来跑一条命令即可逐字复现全部效果。
GitHub:github.com/unitedrhino/docling
你的知识库正在被哪种文档卡住——扫描件、表格还是公式?留言告诉我们,这决定下一个版本优先补什么。