ARTICLE · 1000985
Ragflow在解析文档过程中,报Embedding向量的batch不满足要求的问题的解决过程记录
Ragflow在解析文档过程中,报Embedding向量的batch不满足要求的问题的解决过程记录今天,在使用Ragflow知识库,在完成向量化的过程中,一直报错,提示embedding模型batch size不正常。 于是连接上去,看 embedding.log 里的具体报错,发现是连接的向量模型启动参数,限制了batch size 为512,而刚好在本次分片的时候,遇到一个514长的数据,就不能正常工作了。 先查看日志,确认是否还是 batch 限制: 找到原因:n_batch (2048) > n_ubatch (512)时 llama.cpp 强制把 batch 降回 512。问AI,AI说需要同时设置--ubatch 2048。修改脚本并重启。 修改脚本,发现--ubatch 参数不被这个版本支持。查一下这个 llama-server 版本的参数名。 发现参数名是--ubatch-size。修正脚本。 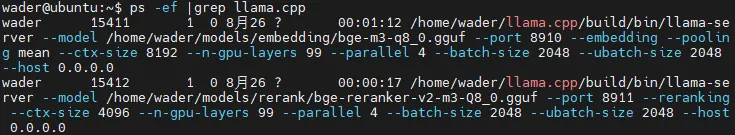
参数修正完成。启动并验证。 端口监听正常,日志还没刷出 listening(模型加载中)。等待并测试长文本(572 tokens)。 🎉核心修复验证通过:572-token 长文本 embedding 成功(之前 514 就被拒)。再验证 rerank 长文本,然后更新 RAGFlow 配置。 ✅ 213 服务验证通过:embedding 返回向量、rerank 返回分数。现在关键测试——用 514+ token 的长文本验证 batch-size 2048 生效(这是修复的核心)。
@ubuntu:~$ ps -ef |grep llama.cppwader 15411 1 0 8月26 ? 00:01:12 /home/wader/llama.cpp/build/bin/llama-server --model /home/wader/models/embedding/bge-m3-q8_0.gguf --port 8910 --embedding --pooling mean --ctx-size 8192 --n-gpu-layers 99 --parallel 4 --batch-size 2048 --ubatch-size 2048 --host 0.0.0.0wader 15412 1 0 8月26 ? 00:00:17 /home/wader/llama.cpp/build/bin/llama-server --model /home/wader/models/rerank/bge-reranker-v2-m3-Q8_0.gguf --port 8911 --reranking --ctx-size 4096 --n-gpu-layers 99 --parallel 4 --batch-size 2048 --ubatch-size 2048 --host 0.0.0.0