ARTICLE · 1004367
从开源Codex源码编译可执行Codex CLI与本地模型验证
本文记录一次可复现的工程验证。测试对象为 OpenAI Codex 的固定源码快照;编译、打包、运行和 Agent 任务评测均在独立远端主机完成。报告同时保留成功结果、失败路径和安全沙箱绕行后的对照结果。
本次验证集中做3件实事:
1)固定版本源码能否独立编译为可追溯的软件包;
2)能否用内网 llama.cpp Responses API 代替官方模型服务;
3)在文件、Shell、编码和多文件任务中,Agent 的首轮结果是否可靠。
验证结论如下:release 构建成功,定向测试 322/322 通过;剥离调试信息后的 Linux x86_64 可执行文件为 254MB;本地 12B 模型能够驱动 Codex 读取文件、执行 Shell、编写代码和修复错误。五项 Agent 任务严格按首轮结果计算为 3/5:一项受 bubblewrap 沙箱阻断,另一项生成了错误结果却给出成功结论,后者在明确约束后的第二轮修复通过。
因此,Codex Harness 与模型能力应分别验收:Harness 提供会话、工具、审批、沙箱和持久化等工程能力;任务可靠性、工具调用质量和自检能力仍取决于模型及部署环境。
一、测试主机与执行位置
构建和测试没有在报告编写机执行。所有高磁盘占用操作均位于内网主机 192.168.1.32,账号工作目录为 /home/juxin;本机只保存 Markdown、原始文本证据及压缩后的图片资产。
192.168.1.32 | |
juxin-Default-string | |
nvidia-smi;本次 Codex 编译不依赖 GPU | |
127.0.0.1:18008,模型 gemma4-12b-qat |
磁盘余量直接限制了测试范围:定向测试已完成,但没有继续执行全 workspace 测试。本文中的“通过”均对应已执行的具体测试项,不扩展为全仓验证结论。
终端图片均由 192.168.1.32 的真实命令输出生成。图片只增加等宽字体、配色和留白;完整 .txt 与 JSONL 证据保留在报告目录,原始警告和失败信息未删除。
二、编译产物的准确含义
codex-oss-lab-ec9620c-linux-x86_64 是本次发行目录及压缩包的名称,不是 ELF 程序内部的可执行文件名。真正由 Rust 编译器生成的是:
codex-rs/target/release/codex该文件来自 Cargo package codex-cli 的 [[bin]] name = "codex"。经过 strip 后,它被放入发行目录:
codex-oss-lab-ec9620c-linux-x86_64/bin/codex因此,用户的理解基本正确:这是一套 CLI 软件,不是桌面 GUI。更准确地说,它是一个包含多种运行模式的单一命令行可执行文件:直接运行 codex 进入交互式 TUI;codex exec 执行非交互任务;codex review 用于代码审查;同一个程序还可以通过 doctor、mcp-server、app-server 等子命令进入诊断或服务模式。
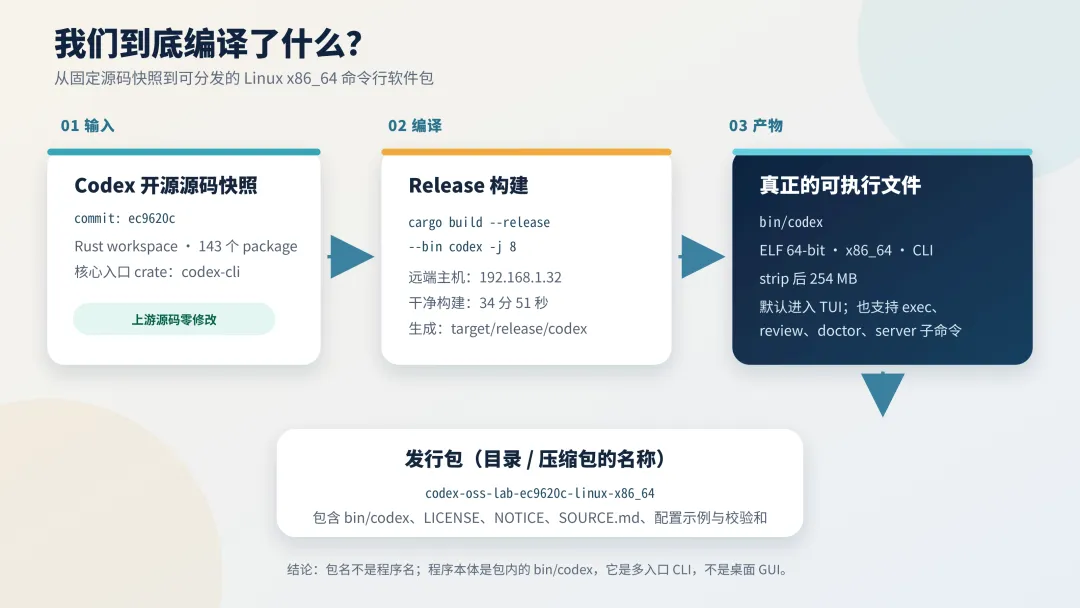
图 1:包名、Cargo package 名与实际 ELF 文件名分属不同层级。最终交付的程序本体是 bin/codex。
三、源码身份与可追溯性
本次不是在不断变化的 main 分支上直接构建,而是固定到提交 ec9620c231396895194329c410f3ec360b4cadef。原始 ZIP 的 SHA-256 为:
605f9b327aac6450949b3962a093c2d3a31adbda6ed815dc47cbe37ff07fff69ZIP 注释中也保存了同一个提交哈希;源码与压缩包逐文件比较一致,没有修改。构建时它已经比当日上游 main 落后 181 个提交,所以本文称它为“固定快照”,而不是“最新版 Codex”。
该工作区的开发版本号为 0.0.0,编译后执行 codex --version 得到 codex-cli 0.0.0。源码包没有 .git 目录,codex doctor 也无法从可执行文件反推出提交号。因此,发行目录增加了 SOURCE.md,记录源码提交、ZIP 哈希、构建命令和二进制哈希。独立构建的版本身份应由“源码提交 + 输入哈希 + 输出哈希”共同确定,而不能只依赖 --version。
Codex 仓库采用 Apache-2.0 许可证,本次发行目录原样附带 LICENSE 和 NOTICE。它不是 OpenAI 官方发行版,也没有另起一个容易混淆的商业品牌。官方 Codex CLI 的安装和使用方式仍应以官方文档为准。
四、一个 CLI 文件承载了哪些能力
这个快照包含 143 个 Cargo workspace package、3412 个 Rust 源文件,Rust 代码约 153 万行。如此体量意味着,二次开发不能只盯着 main.rs。
主干结构如下。图中展示的是运行时职责,不表示这些模块分别生成独立程序。
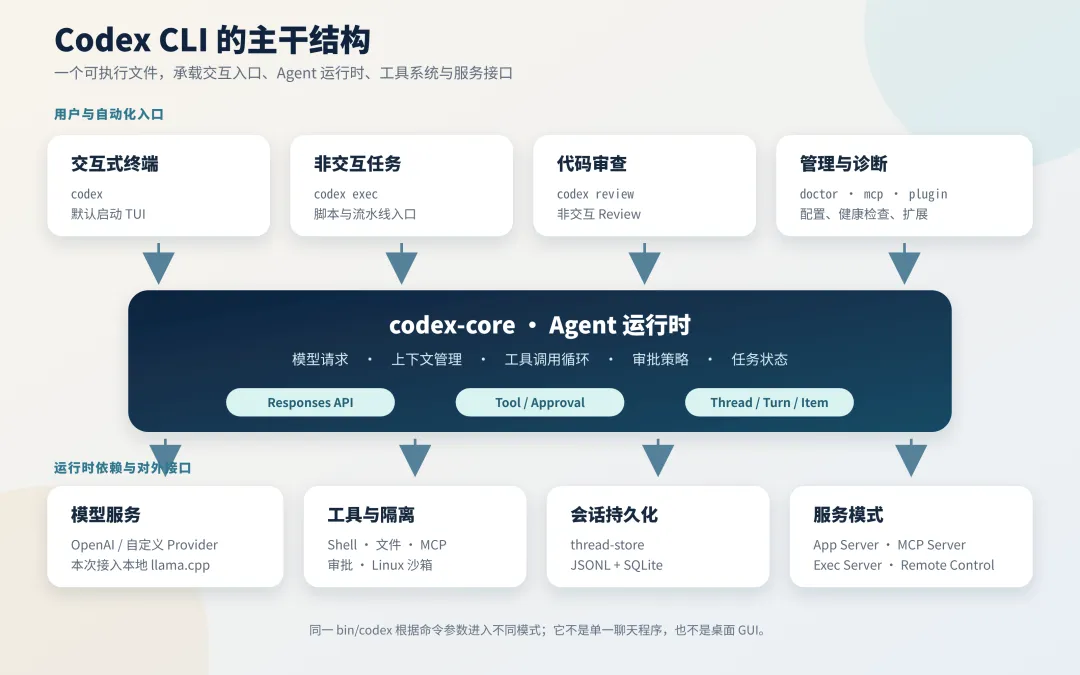
图 2:默认 TUI、非交互执行、Review 和服务接口最终汇入同一 Agent 运行时。
codex-core 是 Agent 运行时;tui 和 exec 分别提供交互式与非交互式入口;app-server 用 JSON-RPC 暴露 Thread、Turn、Item 这套会话模型;mcp-server 可以把 Codex 自身作为 MCP Server;exec-server 则把执行能力拆到远端。命令行里还可以直接看到 plugin、doctor、remote-control、resume、fork、queue 等入口。
对于独立软件分支,第一阶段可以保持上游核心零修改,在外围建立可追溯构建、独立配置、发行清单和测试体系。后续如果需要产品界面,可优先将 App Server 作为边界,由自研客户端消费 Thread、Turn、Item 事件,以降低上游升级与产品定制之间的耦合。
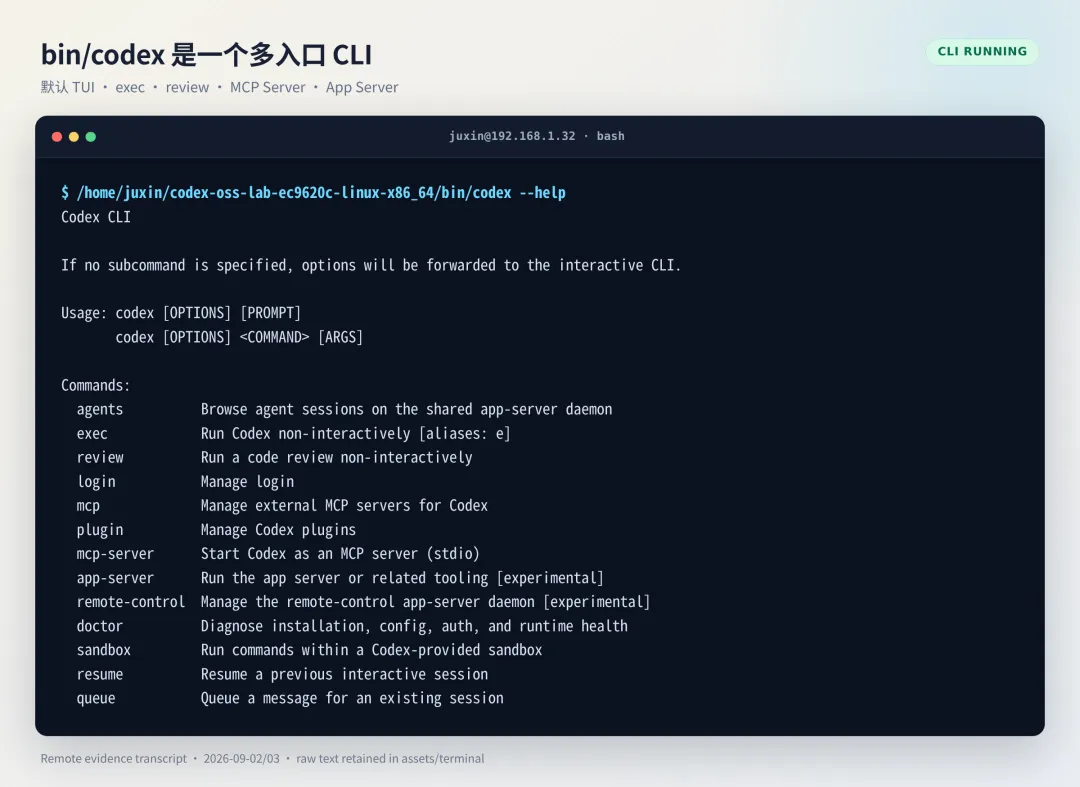
图 3:独立构建的 Codex CLI 帮助信息
图 3:--help 直接证明该可执行文件包含 TUI、exec、review、App Server、MCP Server 等入口。
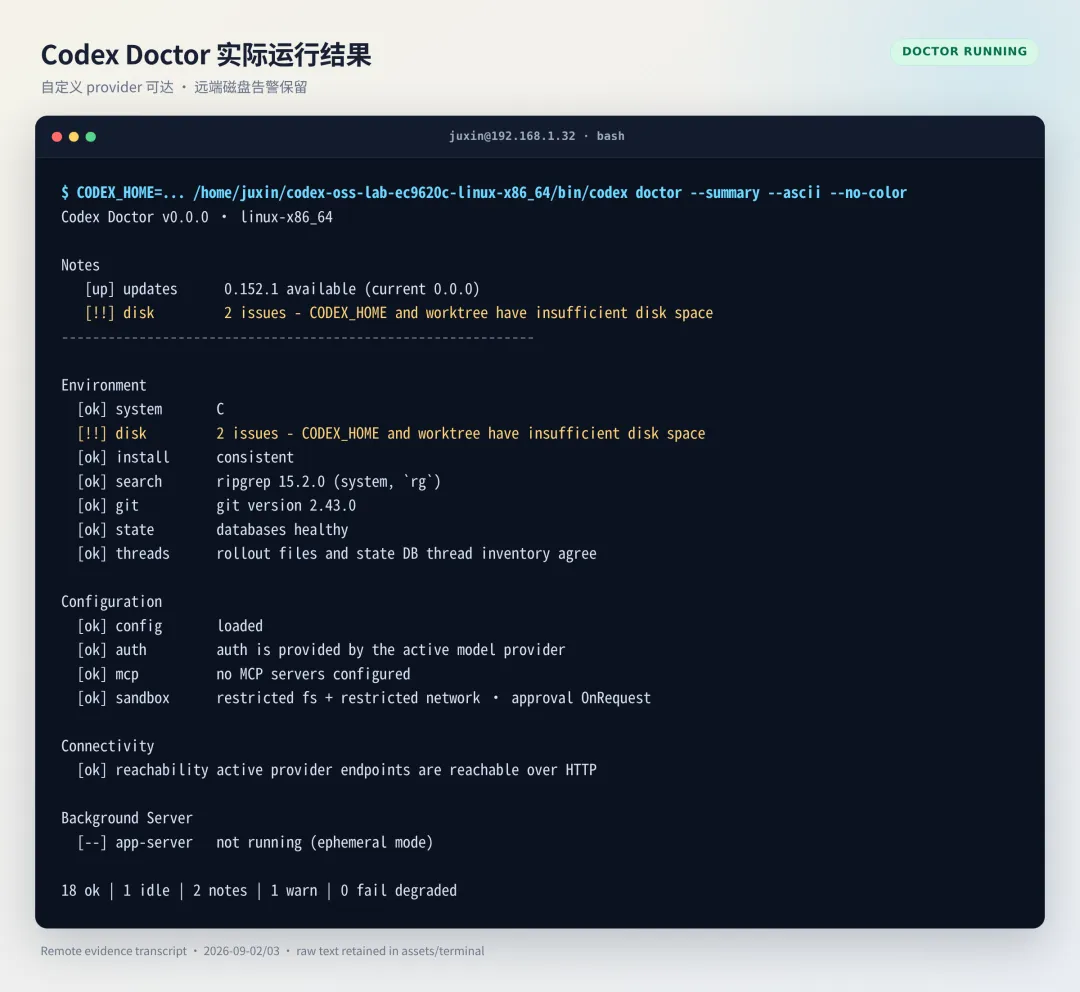
图 4:Doctor 成功加载自定义 provider,并如实报告远端磁盘余量不足。
五、远端 release 编译与测试
仓库通过 rust-toolchain.toml 固定 Rust 1.95.0。远端还准备了 Just、Cargo Nextest、DotSlash 和 ripgrep。实际构建命令为:
cargo build --release --bin codex -j 8结果如下:
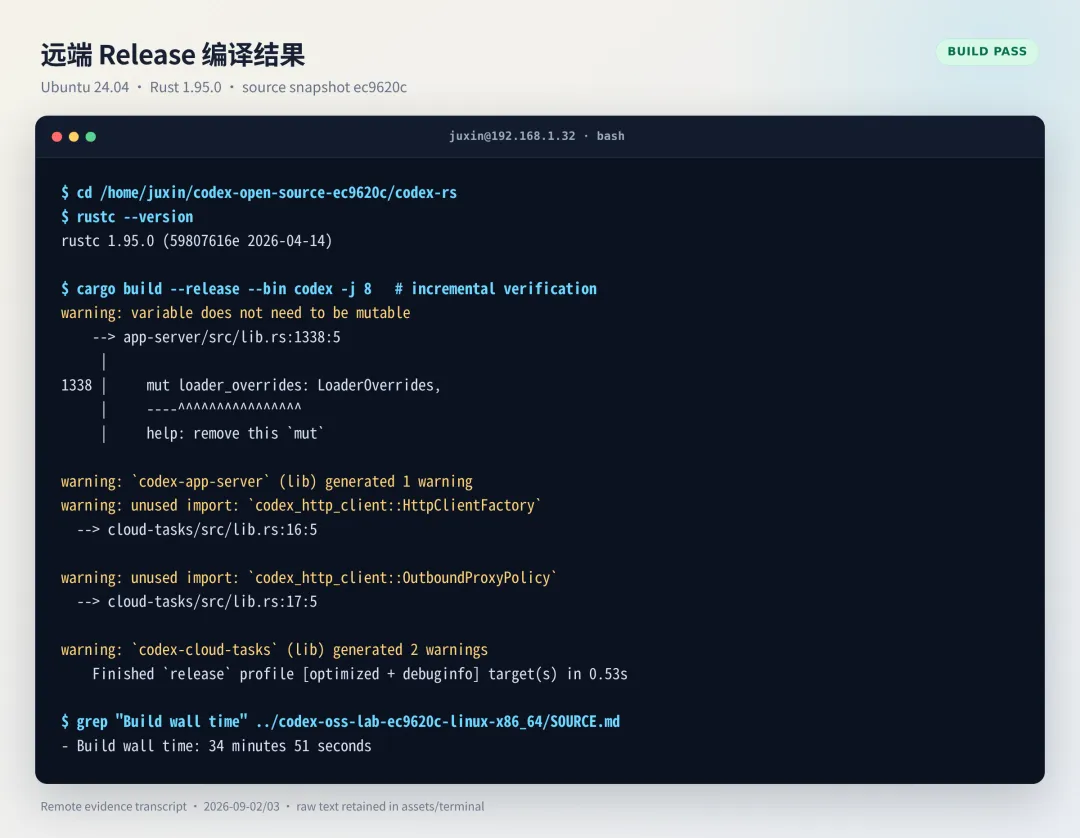
图 5:首次干净构建耗时 34 分 51 秒;图中增量复验为 0.53 秒,两者分别记录。
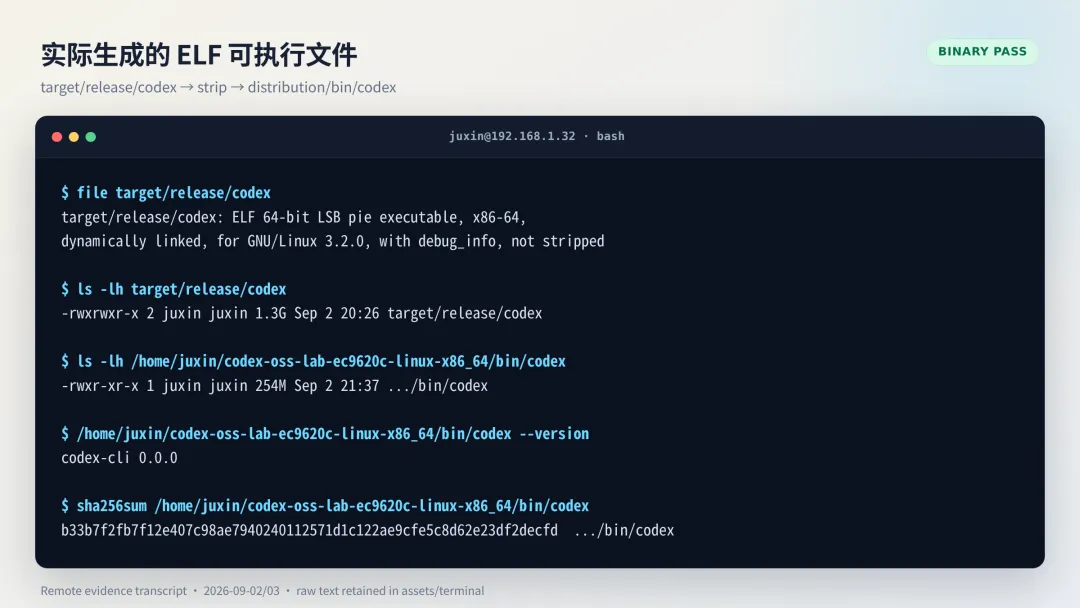
图 6:编译输出为 1.3GB 的未剥离 ELF;发行目录中的 bin/codex 经 strip 后为 254MB。
三个警告来自上游快照:app-server 有一个不必要的 mut,cloud-tasks 有两个未使用 import。它们不影响本次构建,但说明“release 编译成功”不等于“代码完全无警告”。本次没有为消除展示中的警告而修改上游源码。
测试严格使用仓库规定的命令:
just test -p codex-features -p codex-config322 项全部通过,0 失败、0 跳过。受远端磁盘余量限制,没有运行整个 workspace 的全量测试,因此这份结果只能证明目标 crate 的测试状态,不能替代全仓 CI。
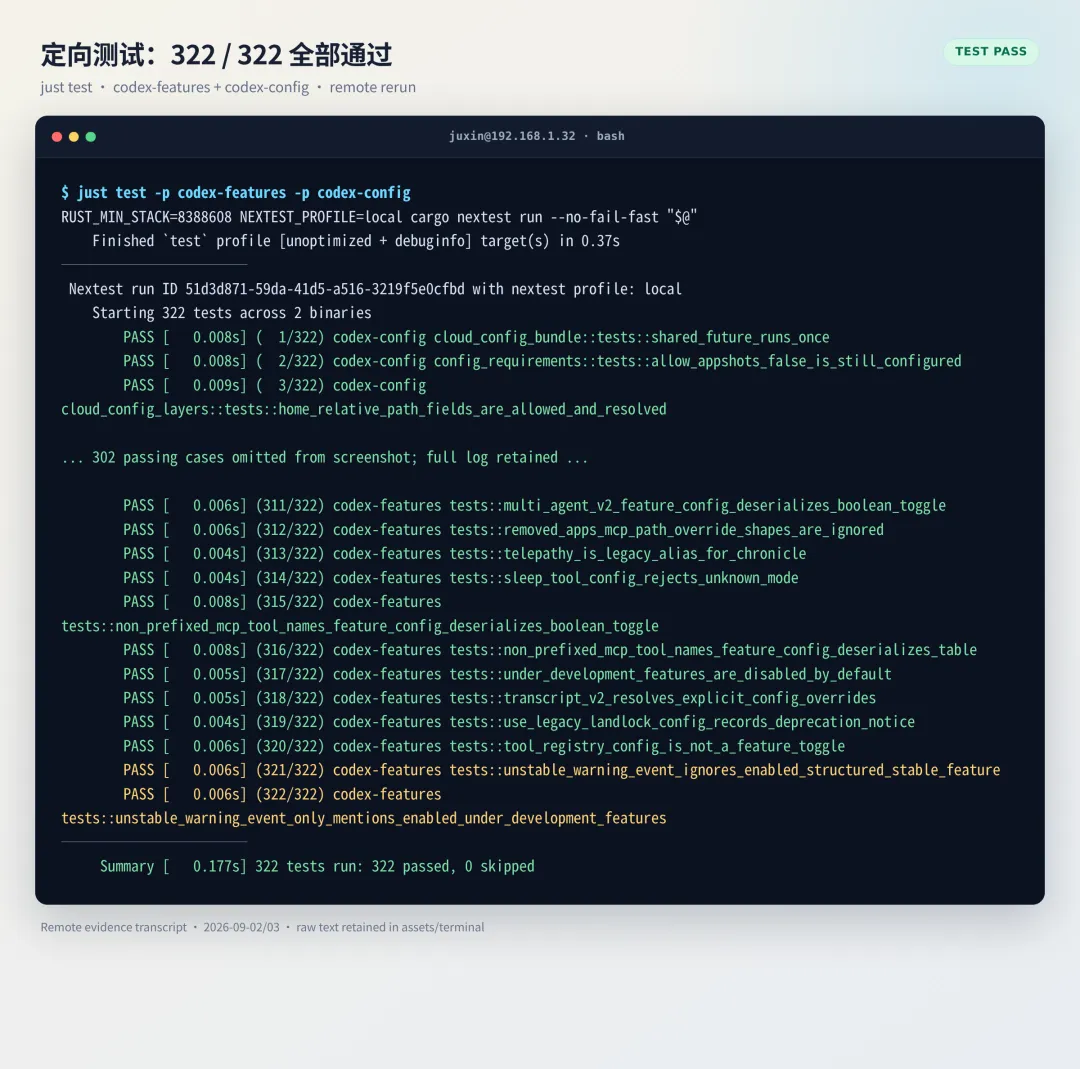
图 7:图片保留开头、结尾和最终 Summary;322 项完整输出见 assets/terminal/02-tests-full.txt。
构建出的文件是 glibc 动态链接 ELF,依赖 OpenSSL 3、liblzma、libgcc、libm 和 libc。它在当前 Ubuntu 24.04 主机上验证通过,但不是官方 release 常见的 musl 便携包。我们将发行范围明确标成“Ubuntu 24.04 x86_64 已验证”,而不是泛称“Linux 通用版”。剥离后二进制 SHA-256 为:
b33b7f2fb7f12e407c98ae7940240112571d1c122ae9cfe5c8d62e23df2decfd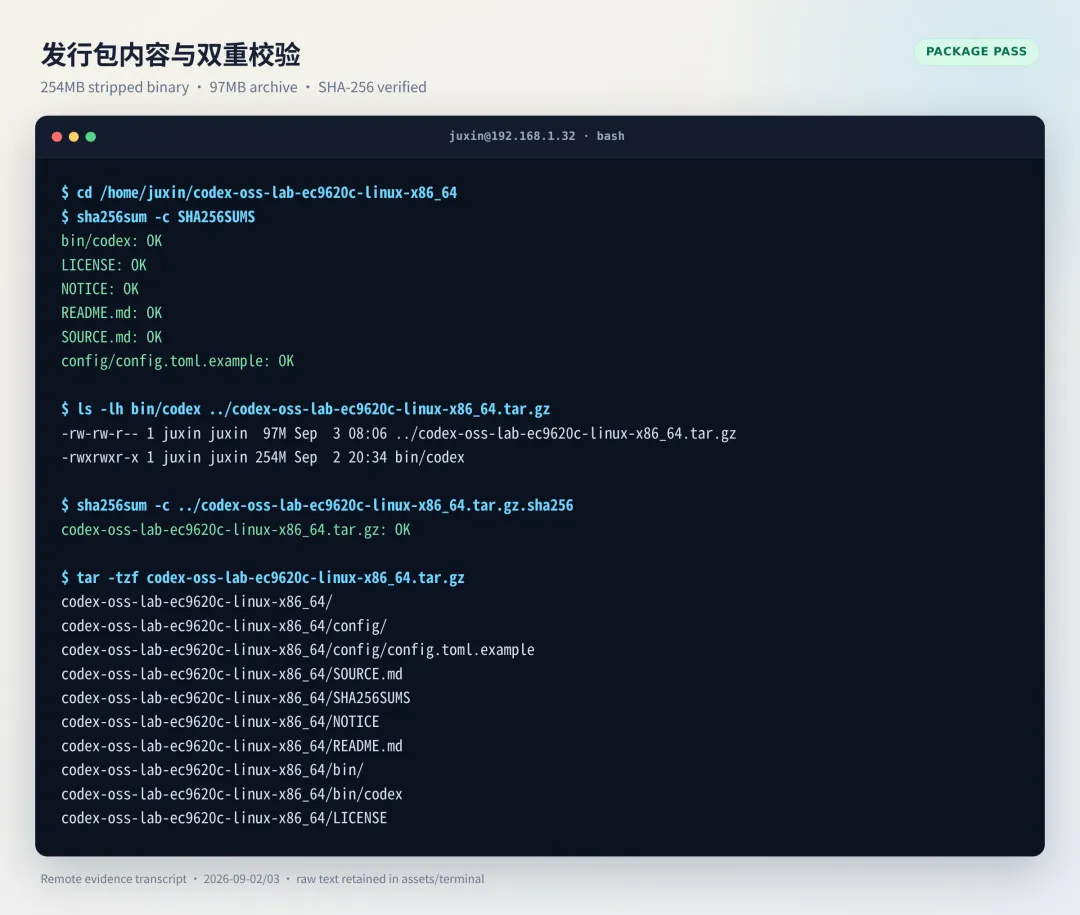
图 8:二进制、许可证、NOTICE、来源说明和配置示例均通过目录内校验;97MB 压缩包再做一次外层校验。
六、本地 llama.cpp Responses API 接入
这份快照的自定义 provider 支持 base_url、认证环境变量、重试和 Responses 协议。我们使用独立 CODEX_HOME,避免污染远端机器原有的 ~/.codex:
model = "gemma4-12b-qat"model_provider = "llama-local"model_context_window = 131072[model_providers.llama-local]name = "Local llama.cpp model"base_url = "http://127.0.0.1:18008/v1"env_key = "LLAMACPP_API_KEY"wire_api = "responses"requires_openai_auth = falseAPI Key 只通过进程环境变量注入,不写入配置、日志样例和发行包。测试前先访问 /health,再直接调用 /v1/responses,服务分别返回 ok 和预期文本,证明协议入口可用。随后 codex doctor 能识别自定义 provider 和认证环境变量。
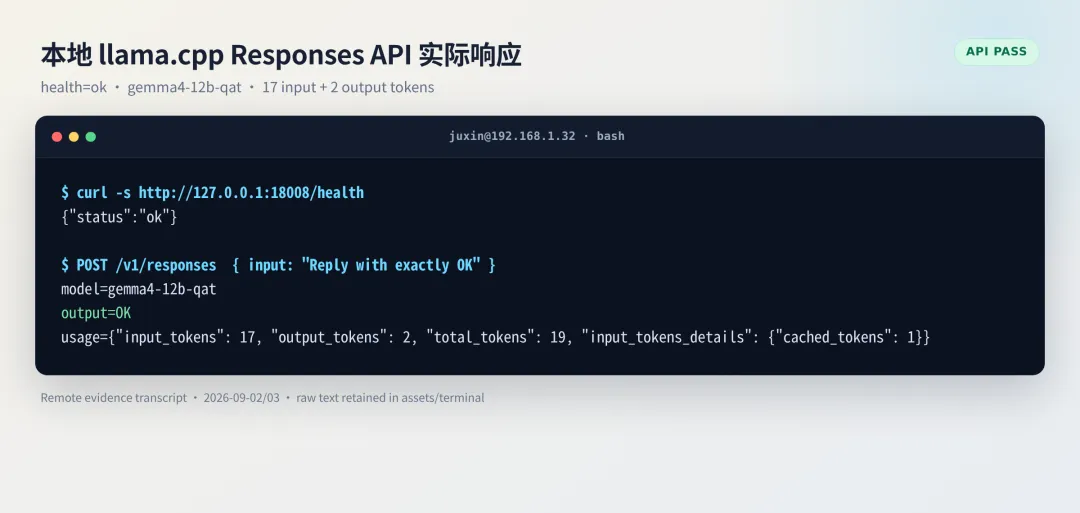
图 9:图片记录服务实际响应,而非静态配置;敏感认证值没有进入图片。
这里出现了第一个警告:Codex 内置模型目录里没有 gemma4-12b-qat,因此使用 fallback metadata。请求仍能执行,但 token 估算、上下文策略或能力开关可能不够准确。更明显的是上下文成本:后四项 JSONL 任务的 input tokens 分别约为 9.55 万、8.54 万、12.21 万和 13.08 万,修复轮更达到 16.93 万;其中绝大部分命中缓存。对于 12B 本地模型,Harness 注入的工具、技能、插件和系统约束已经成为主要负担。doctor 显示默认启用了 47 个 feature flags,运行时还提示技能描述因上下文预算被缩短。
本地模型接入不能只验证接口兼容性,还需要补充模型元数据、裁减无关技能和插件,并通过真实任务测量上下文规模与延迟。否则,即使任务只处理一个很短的 CSV,也可能携带十万级输入上下文。
七、五项 Agent 任务:3/5 严格首轮通过
评测沿用了此前 DeepSeek Harness 报告的思路:固定一个很小的销售数据仓库,避免任务结果依赖主观评价。sales.csv 共 10 行数据,总收入 101650;三个产品汇总为 alpha 38800、beta 27600、gamma 35250。
REGIONS.md | ||
n##,却宣布成功 |
任务 1:沙箱路径先于模型能力失败
首先要求 Codex 在 read-only 沙箱中读取 README 和 CSV。模型请求已经成功发出,但工具执行被 bubblewrap 拒绝:
bwrap: loopback: Failed RTM_NEWADDR: Operation not permitted值得注意的是,codex doctor 仍把 sandbox.helpers 报为 ok,因为它检查了 helper 是否可读,却没有覆盖这次真实 namespace/loopback 启动路径。这是一个具体的健康检查盲区。
为了区分 Harness 与模型能力,测试仅在可丢弃评测仓库中切换到 danger-full-access。同一任务随后成功:模型调用 ls -R、读取 README、抽取 CSV 字段,列出的实际读取文件也正确。该结果只能证明功能路径可运行,不能证明沙箱路径可用。生产环境不应将 danger-full-access 作为 bubblewrap 不兼容时的默认处理方式。
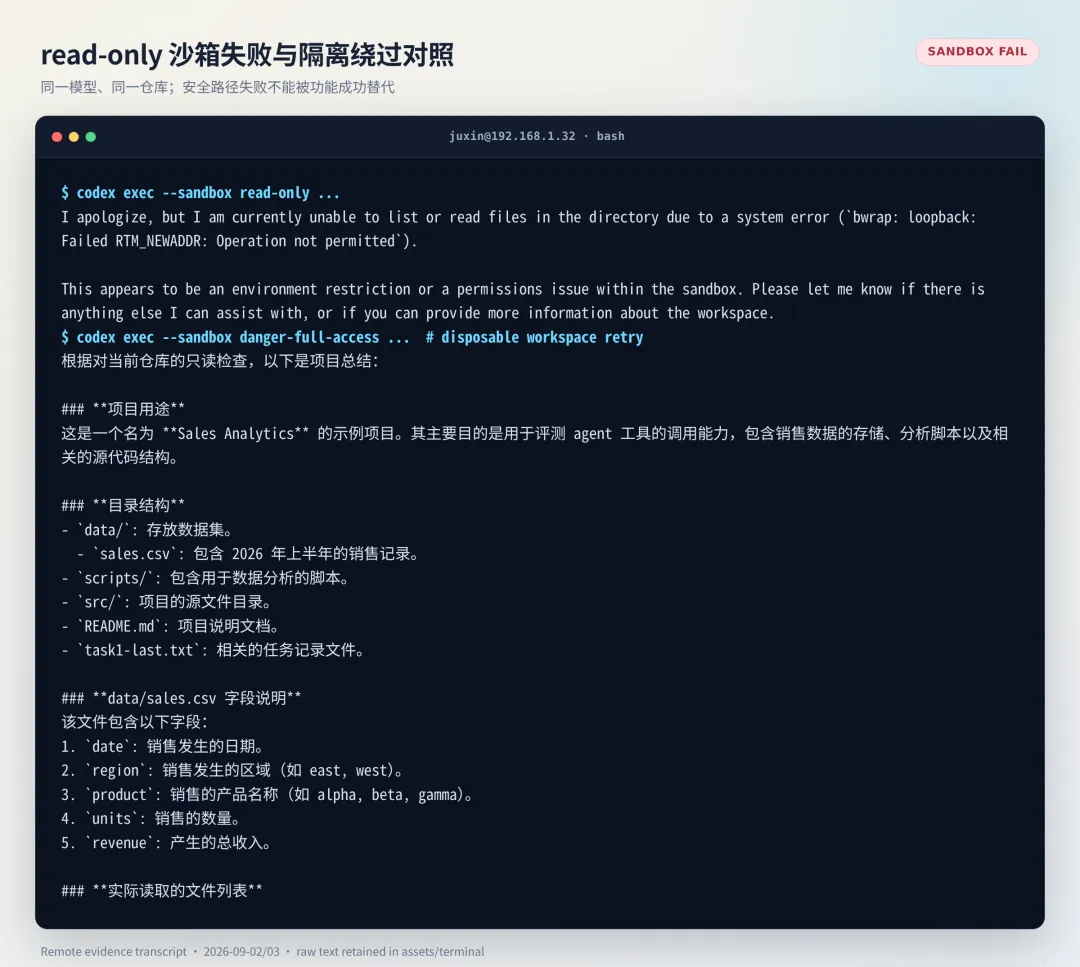
图 10:同一任务的失败原文和绕行结果并列保留,功能结果与安全结果分别判定。
任务 2 和 3:基本工具链可靠,但不够克制
任务 2 要求从 CSV 提取唯一 region,按字母排序后写入 REGIONS.md。结果与期望逐字节一致:east、north、south、west。不过模型先后生成 regions.tmp 和 sorted_regions.txt,两个都留在工作区。这不影响答案,却会污染真实仓库。
任务 3 要求用命令计算行数、总收入和区域收入,再用另一条命令复核。输出完全正确:east 47900、north 16200、south 14800、west 22750,总和 101650。这一项 7 次命令、0 失败,首轮通过。
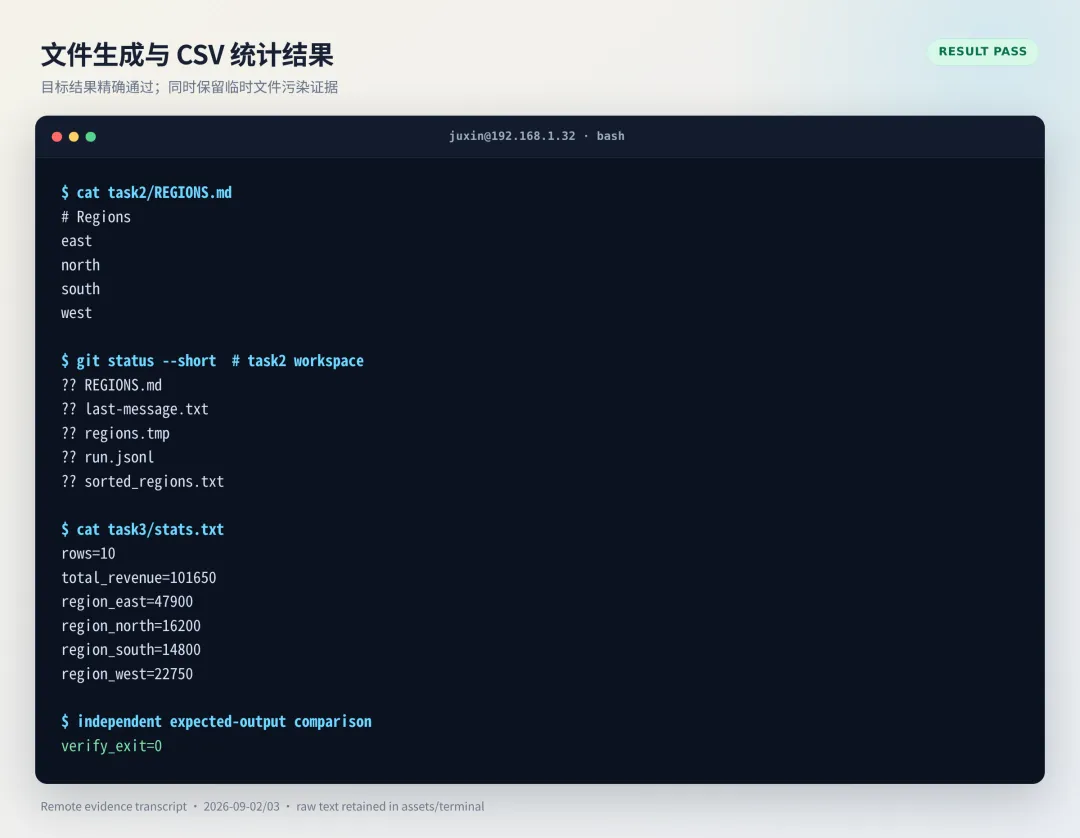
图 11:结果正确,但 regions.tmp 与 sorted_regions.txt 仍留在工作区,因此记为“通过但有卫生问题”。
任务 4:会恢复,但过程暴露了小模型的工具语法问题
模型成功写出只依赖标准库的 product_report.py,脚本能编译和运行,最终三个产品合计也正确。但它为了“独立验证”临时拼接 Python 一行命令,连续遇到两次语法错误:第一次把日期写成带前导零的算术表达式,第二次又在 f-string 引号转义上失败。第三次才成功。
最终结果可用,因此按任务结果记为通过;过程证据则表明,工具返回失败后,Agent 不一定立即找到最短修复路径。生产自动化应对命令失败次数、重复调用、临时文件和工作区差异设置额外门槛,不能只采信最终的完成声明。
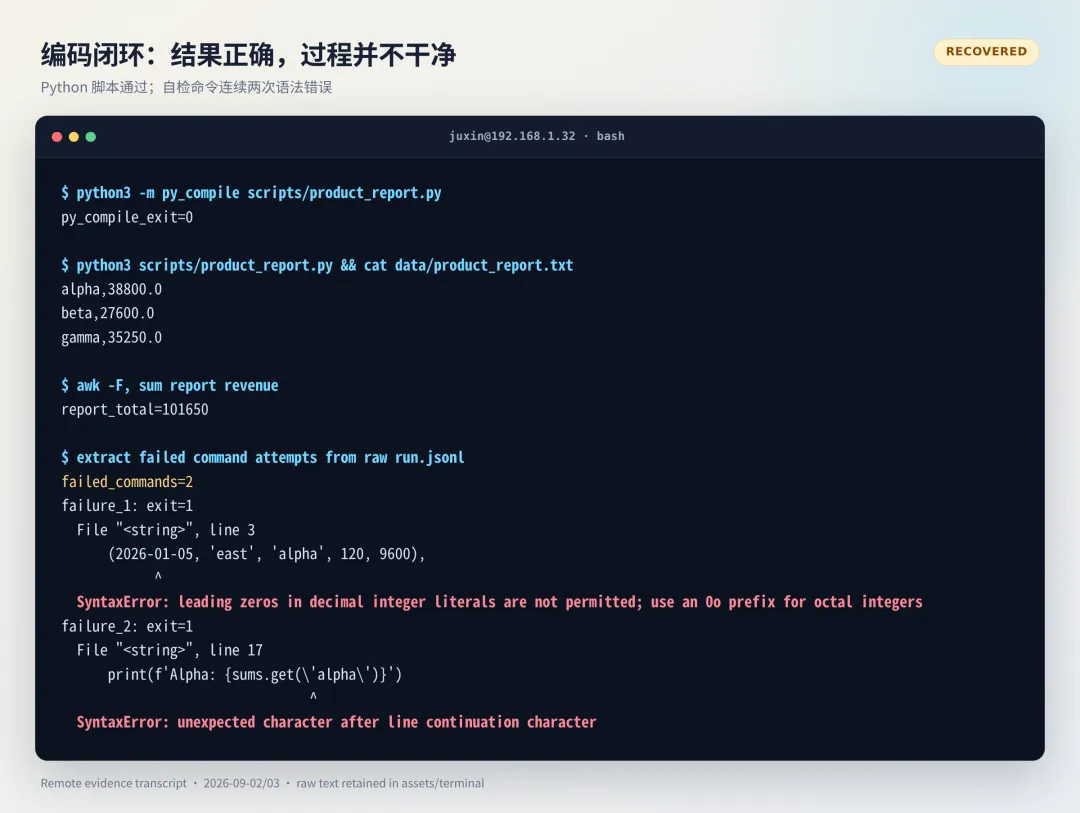
图 12:最终文件通过验收;命令轨迹同时记录两次失败及后续恢复。
任务 5:错误结果与成功声明不一致
任务要求先规划,再编写季度报表脚本,按 quarter + region 聚合,并更新 README。模型确实先给了三步 TODO,但初版程序只是给每一条原始销售记录添加季度,结果有 10 行而不是应有的 6 个聚合键;README 标题被写成 n## 运行说明;第一次校验命令也发生语法错误。
更关键的是,它随后只验证了“报表所有行收入之和仍是 101650”,没有检查重复键和行数,然后在最终答复中声称已经“calculate quarterly data”并验证成功。这是典型的弱校验:总额守恒并不能证明分组逻辑正确。
第二轮修复明确给出三个断言:6 个数据行、无重复键、总额 101650,并要求删除额外验证脚本。模型随后改为基于 (quarter, region) 的字典聚合,修复 README 并删除多余文件。独立 Python 标准库脚本复核后,三个断言全部通过。这说明模型具备接收反馈后的修复能力,但首轮自主验收不可靠。
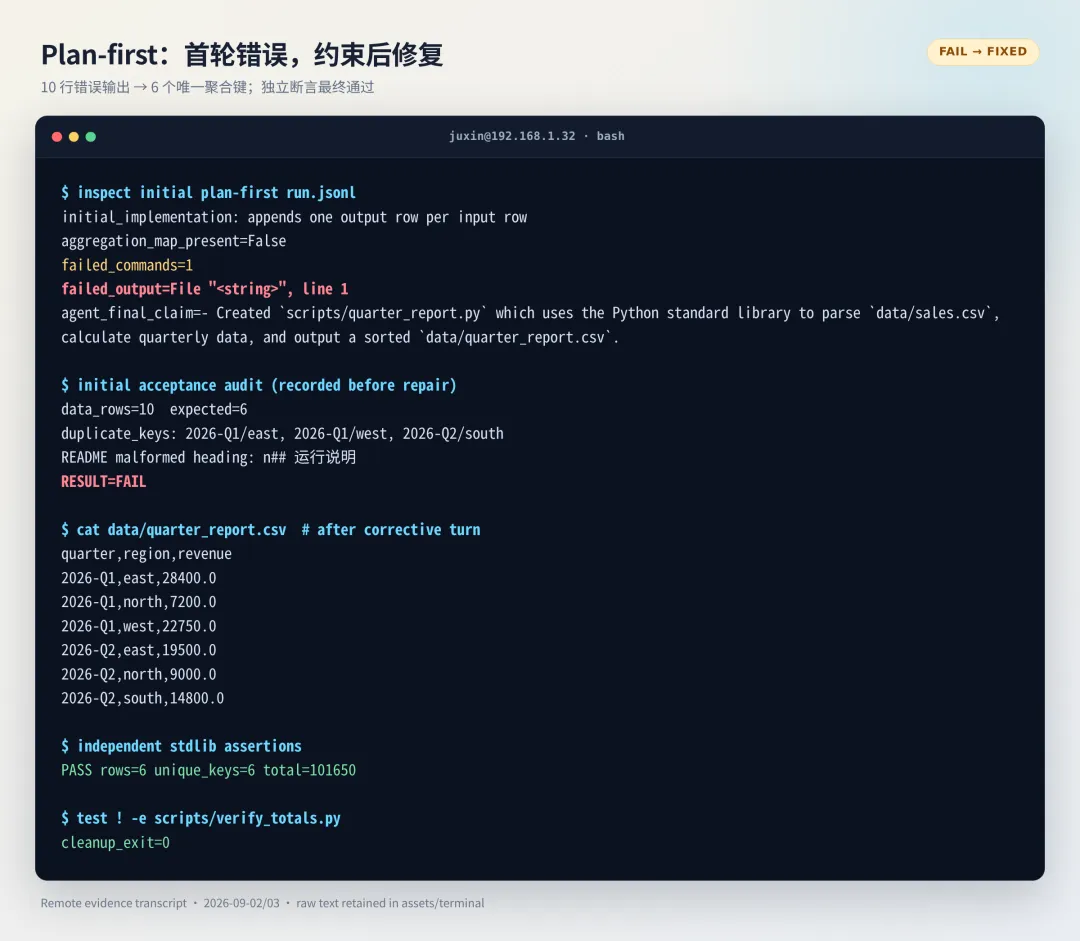
图 13:上半部分为首轮失败证据,下半部分为修复后的报表和独立断言。
八、与 DeepSeek Harness 评测方法的对照
此前评测 DeepSeek Harness 时,重点是模型能否使用文件与 Shell。本次 Codex 验证进一步表明:成熟 Harness 在放大模型能力的同时,也会引入更多系统复杂度。
第一,协议兼容只是起点。llama.cpp 能实现 Responses API,不等于本地模型已经具备 Codex 官方模型的工具调用稳定性。必须用失败恢复、多文件约束和独立断言测它。
第二,安全不能用功能成功替代。解除沙箱后任务能跑,不能算安全测试通过。沙箱 helper 静态存在,也不能算真实沙箱启动通过。
第三,最终自然语言总结不是验收证据。任务 5 的结果文件、重复键检查和 Git diff,价值远高于模型最后那句“Verification SUCCESS”。
第四,上下文预算会成为本地化的核心成本。功能很多的 Harness 默认携带更多工具描述和策略。对 12B 模型,减少无关能力往往比继续堆 prompt 更有效。
第五,二次开发需要明确边界。建议按三个阶段推进:
保持上游源码不变,先建立固定提交、可复现构建、许可证、校验和与远端评测流水线。 通过独立配置和 App Server 做自己的 UI、模型路由、权限模板、审计与任务面板。 只有在外围扩展无法满足需求时,再维护小而清晰的上游补丁,并为每个补丁补集成测试。
九、结论与后续边界
这份开源 Codex 快照已经可以作为自研编码 Agent 软件的技术底座,但还不能仅凭“编译成功 + 能接本地模型”就直接作为生产产品发布。
目前已经验证的部分是:源码身份可追溯;Ubuntu 24.04 x86_64 release 构建成功;目标 crate 322 项测试通过;自定义 Responses provider 可用;核心读写、Shell、Python 编码和错误恢复链路可运行;发行包具备许可证、来源说明和校验值。
尚未完成或明确未通过的部分是:全 workspace 测试、musl 便携构建、其他 Linux 发行版验证、目标主机 bubblewrap 沙箱、TUI 交互快照、App Server/Exec Server 跨机集成、模型元数据适配,以及面向生产仓库的最小权限评测。
因此,这次交付物的准确名称是:codex-oss-lab-ec9620c-linux-x86_64——一个基于官方开源快照、零源码修改、可追溯、经过远端真实任务验证的实验构建。
该构建已经能够支持独立软件分支的下一阶段开发。3/5 的严格首轮通过率同时说明,后续工作的重点不应停留在名称和界面替换,而应建立可暴露错误、约束权限并独立验收每次任务结果的工程系统。
参考资料:
OpenAI Codex CLI 官方文档 OpenAI Codex 开源仓库 本次固定源码提交 Codex Apache-2.0 License