ARTICLE · 1004513
腾讯版小龙虾「WorkBuddy Claw」体验63:OpenAI、Anthropic、 Grok(xAI)多家AI公司遭遇服务中断怎么看?
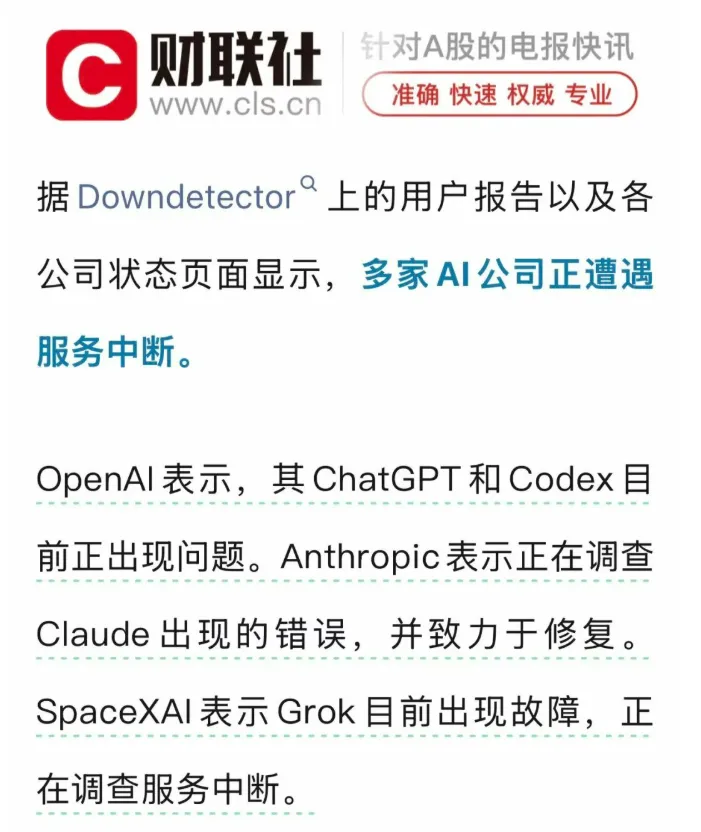
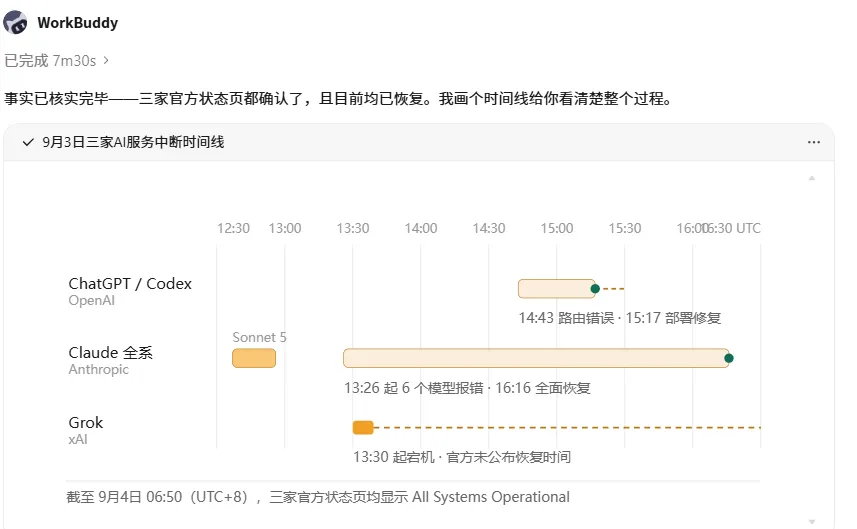
消息属实,但**"正遭遇"这个时态已经过期了**——我刚查了三家官方状态页,现在全部是 All Systems Operational,事件都标记 Resolved。
到底发生了什么(9月3日,UTC)
Claude 受影响的是 Mythos/Fable 5.1、Mythos/Fable 5、Opus 5、Opus 4.8、Opus 4.6 六个模型,15:25 收窄到只剩 Opus 4.8 和 Opus 5。OpenAI 那边 15 个 ChatGPT 组件 + 4 个 Codex 组件同时降级,登录、语音、搜索、深度研究、文件上传、图像生成全中招,Codex CLI 和 VS Code 插件也一起挂——Cursor 跟着遭殃,因为它下层同时依赖这三家。
几个需要澄清的点
"多家 AI 公司集体宕机"是真的,但"共同根因"没有被证实。 这是最容易以讹传讹的地方:
Cloudflare 发言人明确否认:"我们目前没有经历任何重大服务中断,任何与此不符的报道都是不正确的。" Ars Technica 查了 AWS、Google Cloud、Azure 状态页,均无对应的并发事件。 三家公司没有一家公开承认彼此有共同原因。OpenAI 说的是路由错误,Anthropic 说的是基础设施问题——这是两种不同的故障模式。
所以财联社那篇里"可能与 Cloudflare 有关"只是分析人士的猜测,被 Cloudflare 直接否掉了。
Gemini 的情况不要当真。 虽然有用户报告和 Downdetector 曲线上升,但 Google 从未公开承认,其 Cloud Service Health 历史里也没有 9 月 3 日的 Gemini 事件。CircleID 明确把它标为"不如另外三家确凿"。
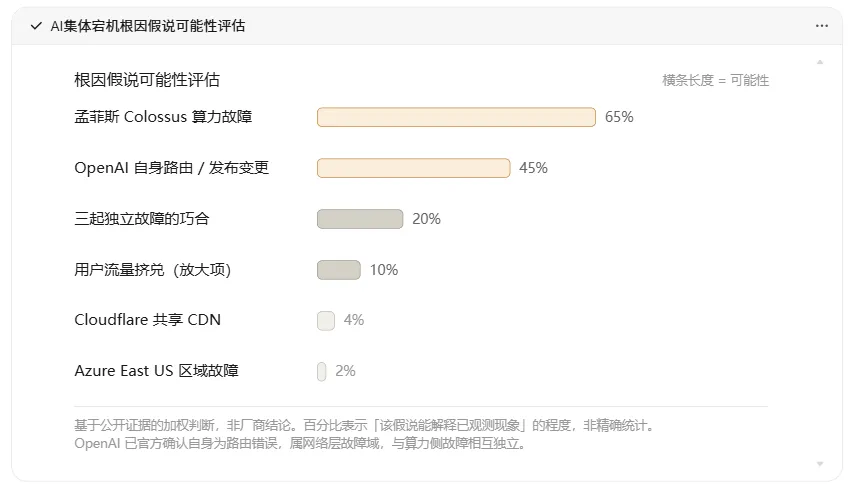
先说一个关键分野:网上把这当成"一个谜、一个根因",但从各方自己披露的措辞看,这更像是两个不同故障域的事件撞在了一起。
最直接的一条硬线索:SpaceX 自己认了
这是唯一有一手声明的说法,很多中文报道漏掉了:
SpaceX(xAI 母公司)周四下午公开声明,Grok 的故障源于"我们孟菲斯计算中心今早的一次 outage “,并且特意加了一句——” 我们也要向受影响的算力合作伙伴致歉"。
这句话的杀伤力在于背景:Anthropic 今年 5 月签下协议,包下了 xAI 位于孟菲斯附近的 Colossus 1 数据中心的全部产能(300MW、22 万+ 张 NVIDIA GPU),月付 12.5 亿美元,一直到 2029 年 5 月,总额约 400 亿美元。Google 也签了类似的租约,月付 9.2 亿美元。
所以"向算力合作伙伴道歉"几乎是在点名 Anthropic。
各路说法与我的判断
① 孟菲斯 Colossus 算力故障 —— 65%(解释 Claude + Grok)
支持证据不止一条,而是四条互相咬合:
Claude 13:26 UTC 起报错,Grok 13:30 UTC,只差 4 分钟 Claude 应用内提示原文是 "Due to unexpected capacity constraints, Claude is unable to respond" Grok 返回的是 "This model is overloaded right now" SpaceX 官方声明 + Anthropic 的 Colossus 租约
我的推断模型(非厂商结论):Colossus 是 Anthropic 的增量容量而非全部,所以更可能是「Colossus 故障 → Claude 可用容量受损 → 流量紧急回切 AWS/GCP → 回切过程中过载抖动 → 耗时 3 小时才恢复」,这也解释了为什么表现是"错误率升高"而不是彻底宕机。
② OpenAI 自身路由错误 —— 45%(仅解释 ChatGPT/Codex)
OpenAI 是官方确认的现象(routing error),但诱因没说。值得注意的是 GPT-6 Astra 在当天/近日正式上线了(目前仅对 Trusted Access / Daybreak 计划开放),大规模模型上线前的后端变更最容易引发路由和容量问题。这一层是纯推测,无实据。
③ 三起独立故障的巧合 —— 20%
故障模式确实不同,没有任何一家指认共同供应商,时间点也不是完全重合(13:26 / 13:30 / 14:43)。不能排除。
④ 用户流量挤兑 —— 10%(只能当放大项,不能当主因)
这一条网上流传很广,但时序是错的。多家中文报道说"ChatGPT 先挂 → 用户涌向 Claude/Grok → 挤垮后两家",可实际是 Claude 和 Grok 先挂,ChatGPT 晚了一个多小时。方向反了。反过来部分成立:Claude/Grok 挂了之后用户涌向 ChatGPT 和 Gemini,可能加剧了后续压力——这能部分解释为什么 Gemini 也有零星报错。
⑤ Cloudflare —— 4%(已基本证伪)
Cloudflare 官方否认得极其强硬:"我们目前没有经历任何重大服务中断……任何与此不符的报道都是不正确的。"当天其状态页只有香港 5xx、西雅图 522、R2 美西 503 这类区域性小事件。
⑥ Azure East US —— 2%(前提就是错的)
几篇文章(TechTimes、byteiota 等)说"三家都依赖 Azure",这个前提是错的:Claude 主力在 AWS 和 Google Cloud,Grok 跑在自建的 Colossus 集群,只有 OpenAI 大量用 Azure。而且 Azure 官方状态页无对应事件,第三方 StatusGator 在 UTC 15:13 检查记录为 operational。
另有两条基本可忽略:Cardano 联创 Hoskinson 猜"国家行为体攻击"(零证据);少数用户报告 ChatGPT 站点尝试下载无扩展名文件(疑似边缘配置错误,无任何厂商确认)。
我的结论
Claude 和 Grok 高度可能同源(孟菲斯算力故障),OpenAI 是独立的网络层事故,两者在同一个上午撞上了。 之所以大家都觉得"太巧了不可能是巧合",是因为这两件事确实不一定是巧合——真正的问题不是"同一时刻",而是Anthropic 把自己的相当一部分推理算力,外包给了竞争对手马斯克的一座数据中心。
这也解释了一个反直觉的现象:看起来三家互相竞争,但 Claude 和 Grok 的故障间隔只有 4 分钟,而 OpenAI 晚了 77 分钟——故障的时间距离,反映的是底层依赖的物理距离。
结论有点反直觉:损失是真实的,但几乎全部由用户承担,厂商自己几乎不痛。
先看可核实的基准
有个坑要提醒:Anthropic 的 ARR 用总额法(经 AWS/GCP/Azure 分销的收入全额计入,渠道分成记成本),OpenAI 用净额法。OpenAI 的 CRO 在内部备忘录里说 Anthropic 4 月那 300 亿"被夸大约 80 亿"。跨公司比 ARR 必须先对齐口径,否则会得出错误结论。
分层估算:不是平均数,是三个数量级
网上常见的算法是"用户数 × 宕机时长 × 时薪",这严重失真——用 Cursor 写代码的和偶尔问两句的,损失差两个数量级。我拆成三层:
| 用户侧合计 | 约 4 亿 | ||||
| 厂商自身直接收入损失 | 约 500 万 |
区间:保守 1 亿、激进 15 亿,不确定性几乎全在"重度用户到底有多少"这一个假设上。
两个历史锚点做校准:Cloudflare 2025 年 11 月宕机 3.5 小时,Forrester 保守估 2.5 亿美元(Shopify 自己只损失 400 万,但下游商家被放大到 1.7 亿);ChatGPT 2025 年 6 月 10 日全球宕机近半天,估约 4.5 亿。这次量级落在两者之间偏下——合理,因为 ChatGPT 只断了 34 分钟到 1 小时。
厂商为什么只损失 500 万
两个原因,都不难理解:
- 订阅收入不会退
。没人会因为 3 小时宕机去退 ChatGPT Plus,下个月照扣 20 美元。 - API 请求大部分会重试成功
。我按 85% 挽回率扣减。剩下的 15% × 中断时长 × 时均 API 收入,Anthropic 那边大概 78 万美元,OpenAI 约 12 万美元。
对 OpenAI 来说,500 万相当于 ARR 的 0.01%——财报上完全看不出来的数字。
这就是问题的核心:损失承担比是 80 : 1。 用户侧承担约 4 亿,厂商承担 500 万。这是标准的经济外部性——成本由用户付,所以厂商没有足够的经济激励去投资冗余。指望他们自觉提升韧性,指望不上。
真正的大头在账外,且不可量化
这几项可能比那 4 亿更值钱:
- 采购行为改变
。企业采购会开始问"你的机房在哪、用谁的 CDN、跟谁共用供应商"。这会永久改变未来合同的议价结构。 - Gemini 独自幸存 = 史上最有效的一次营销
。谷歌什么都没做,白捡一次全球压力测试通过的口碑。 - Anthropic 的 IPO 叙事
。6 月 1 日已提交 S-1,90 天 uptime claude.ai 99.4%、Claude Code 99.44%——这会成为路演必答题。更微妙的是,这次暴露了 Claude 的算力押在马斯克的数据中心上。 - SpaceX 的估值逻辑
。Oppenheimer 本周刚把目标价上调到 280 美元,核心逻辑就是"向 Anthropic、Alphabet 出售算力"。这次事故等于给这条逻辑做了一次负面演示。(有自媒体说 SPCX 当天"闪崩 8%",是假的——实际收涨 5.76%。)
五层影响
① 企业架构,0–6 个月,最确定
AI 容灾从"最佳实践"变成"必答题"。多模型 failover、熔断降级、缓存兜底会进入标准架构。而且治理框架已经动起来了——AI Governance Institute 把这次事件直接映射到了具体控制项:供应商集中度风险评估(PRC-009)、事件分类与响应(IRC-001/002)、系统准入(MGV-002)、供应商尽调(PRC-001)。以后采购会问"你的机房在哪、谁持有租约、跟谁共用"。
② 算力供应链,1–3 年
从"签得多"转向"签得散"。但上面说了,签得散解决不了单点半径问题——设施越大,故障半径越大。
③ 竞争格局,6 个月–2 年
自研芯片叙事走强。Gemini 这次幸存不是运气:Google 主体跑在自研 TPU 上,绕开了公有云中间层。同时小模型和本地部署会从"备胎"转正——昨天中文技术圈那句"我们本地部署的",杀伤力比任何广告都大。
顺便说,基础设施层自己也在动:Cloudflare 已经把 AI Gateway 和 Workers AI 统一成单一控制面,支持跨提供商动态路由——卖铲子的人开始把 failover 当一等公民了,这本身就是市场信号。
④ 监管,1–3 年,不确定性中低但天花板最高
EU DORA(数字运营韧性法案)有可能把头部 AI 供应商认定为"关键第三方",一旦认定就要接受监管测试。金融稳定委员会关于 Agentic AI 的建议已经把系统性依赖列为监管关注。真落地的话,披露成本和合规成本都会显著上升。
⑤ 行业结构,3 年+,最不确定但可能最深
这次查到的最耐人寻味的一条:英伟达在这笔交易里同时是三重身份——Lambda 的芯片供应商、德州数据中心的实际房东(它持有 Hut 8 的租约)、Lambda 的投资方。
WSJ 上周报道,英伟达因为员工担心监管审查,已经暂停了部分与 AI 云公司的收入分成安排;它披露的承诺规模是 360 亿美元。
这个结构你熟不熟悉?看起来是几家互相竞争的公司,底层暴露在同一批资产上。 2008 年说的是不同金融产品,今天说的是不同 AI 产品。
对你意味着什么
短期看,如果你是开发者,该做的是把熔断和降级配上——不是因为这次损失多大,而是因为这类事件从"罕见"变成"结构性必然"了。57% 的企业已经在生产环境跑 AI agent(不是试点),任务型 agent 今年预计出现在 40% 的企业应用里(2025 年还不到 5%)。依赖度还在涨,韧性没跟上。
中期看,如果你在选技术栈,"这个模型跑在谁的机房、谁的芯片上"会变成一个真实的选型维度,而不只是性能排行榜
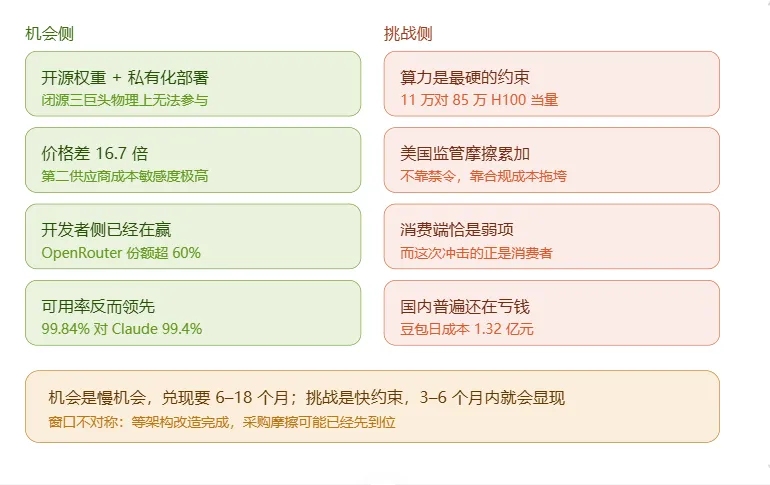
是机会,但机会的形状和大多数人想的不一样——而且兑现速度赶不上挑战的到来速度。
先说一个反直觉的发现:国产这次的可用率是真的更高
大家都默认"美国大厂更稳",但把双方官方状态页摆在一起,结论是反的:
| 99.92% | |
| 99.84% | |
| 99.4% |
不过要诚实两点:DeepSeek 90 天里有 27 条官方事故记录,只是每次都短(7–39 分钟);今年 3 月还有过一次持续 7 小时以上的大中断。它是"高频短断",不是"从不中断"。而且 9/3 那天是美东早晨 9:30 = 北京晚上 21:30,国产正处于夜间低负载——单次样本证明不了谁更稳,但 uptime 数据是实打实的。
最关键的判断:赢的是开发者,输的是消费者
这是整件事里最反直觉的一点。
开发者侧国产已经在赢:OpenRouter 上中国模型份额 6 月首次超过美国,7 月超 60%(Bloomberg);美国企业 token 调用里中国模型稳定占 30%+、峰值 46%;俄罗斯 Yandex 平台上 Qwen 占 21.2%、DeepSeek 13.5%,包揽二三位。
消费端在输:DeepSeek App 月活 5330 万,比 2025 年初掉了近 40%。Sensor Tower 数据显示中国 AI App 的月下载量跟 ChatGPT 完全不在一个量级。
问题来了——这次宕机挤出來的增量用户是谁? 是消费者和轻度用户,他们会临时去找个能用的替代品。而开发者早就用上国产模型了,他们不需要被"挤"过来。
红利恰好落在国产最弱的战场上。 这是我给出"机会有限"判断的核心依据。
真正的机会不在抢用户,在抢架构位置
这次事件之后,企业的标准答案从"多模型路由"升级成了"本地兜底"。而本地兜底只能用开源权重模型——Qwen、DeepSeek、GLM、Kimi 全开源,三家美国巨头全闭源。这条路他们物理上走不了。
配上价格差就更明显:MiniMax M2.5 / GLM-5 约 $0.3/百万 token,Claude Opus 4.6 是 $5,差 16.7 倍。企业要建"第二供应商 + 降级链路"时,第二家的成本敏感度极高。
但挑战更硬,而且来得更快
算力缺口是最要命的。中国约 11 万 H100 当量 vs 美国 85 万,只有七分之一;美国头部云今年 AI 投资 6000–7250 亿美元,是中国头部企业的 9 倍。从 CUDA 迁到国产芯片有"迁移税",时间和成本至少加 50%。
这里有个尴尬的悖论:如果这次事件推动全球企业增加冗余,那意味着全世界需要更多算力——而这恰恰是国产最缺的。机会来了接不住,是最难受的情况。
美国监管走的是"摩擦累加",不是禁令。 NDAA FY2026 已要求国防部和情报系统移除 DeepSeek;阿里 6 月进了五角大楼 1260H 清单;4 月起众议院两个委员会联合调查,已向 Cursor、Airbnb 发函;BIS 正在制定新规堵"第三国远程租算力"(直接点名 Moonshot 的 Kimi K3 在泰国训练)。TechTimes 的判断最到位:结局不是一纸禁令,而是采购摩擦 + 审计风险 + 合规成本叠加到经济性不再成立。
还有反向风险:路透 7 月报道北京也在考虑限制先进国产模型的海外访问。两头都可能被掐。
时间尺度不对称,这才是结论
机会兑现要 6–18 个月(企业改架构、过合规、建信任);挑战 3–6 个月就到(BIS 新规 9 月可能出、国会调查推进、算力成本持续涨)。
对国产厂商来说,最该做的是三件:把可用性当卖点打(这是罕见的真实领先窗口)、重押私有化部署(唯一一条闭源巨头无法竞争的路)、别在消费端硬拼。
更本质的一句话:这次事件最大的受益者可能不是某家中国公司,而是"开源 + 本地部署"这个模式本身——只不过它的主要载体恰好是中国公司。
如果要看之前的体验记录可以直接点下面的内容:
往期回顾:
体验1:WorkBuddy安装体验 腾讯版小龙虾「WorkBuddy Claw」学习和体验结果 体验10:”龙虾“越多越厉害? 腾讯版小龙虾「WorkBuddy Claw」体验10:“龙虾”越多越厉害?WorkBuddy给我泼冷水 体验15:hermes什么东西鬼? 腾讯版小龙虾「WorkBuddy Claw」体验15:hermes 什么东西鬼?比“龙虾”会更好? 22:微信小程序小白操作手册 腾讯版小龙虾「WorkBuddy Claw」体验22:搞定微信小程序,附小白操作手册 24:我的知识库+obsidian 腾讯版小龙虾「WorkBuddy Claw」体验24:WorkBuddy 设置的知识库和obsidian 知识库数据怎么共享 28:智能客服怎么实现?腾讯版小龙虾「WorkBuddy Claw」体验28:智能客服怎么实现的 34:Codex Code使用DeepSeek的4种方案 腾讯版小龙虾「WorkBuddy Claw」体验34:Codex没账号可以使用DeepSeek4 的4种方案 36:ClaudeCode的国内版本方案 腾讯版小龙虾「WorkBuddy Claw」体验36:搞定了Claude Code 国内账号版本(续) 37:“灵感”功能怎么用?腾讯版小龙虾「WorkBuddy Claw」体验37:“灵感”等新功能怎么用? 39:高考志愿要考虑的内容?腾讯版小龙虾「WorkBuddy Claw」体验39:高考填志愿需要考虑哪些内容? 40:Claude Fable 5上线72小时就全球下架? 腾讯版小龙虾「WorkBuddy Claw」体验40:Claude Fable 5上线 72 小时即被全球下架怎么看? 42:龙虾的“项目”功能怎么用?腾讯版小龙虾「WorkBuddy Claw」体验42:龙虾的“项目”功能怎么用? 44:怎么看Anthropic指控阿里”蒸馏攻击“? 腾讯版小龙虾「WorkBuddy Claw」体验45:美国Anthropic指控阿里"蒸馏攻击"怎么看? 48:长征十号乙运载火箭成功回收的意义48:长征十号乙运载火箭成功回收的真正意义 49:GPT-5.6把ChatGpt和Codex合并了怎么看? 腾讯版小龙虾「WorkBuddy Claw」体验49:GPT-5.6把ChatGPT和Codex合并了就无敌了? 50:Kimi-K3排名干到了第一怎么看?腾讯版小龙虾「WorkBuddy Claw」体验50:Kimi-K3 排名干到第一怎么看? 53:全球AI调用榜前5全是我们 腾讯版小龙虾「WorkBuddy Claw」体验53:全球AI调用榜单前5全是中国的怎么看? 55:腾讯版小龙虾「WorkBuddy Claw」体验55:WorkBuddy行业第一了,还奖励你免费用 56:腾讯版小龙虾「WorkBuddy Claw」体验56:参加2026微信开发大赛,获取免费开发资源 57:腾讯版小龙虾「WorkBuddy Claw」体验57:WorkBuddy App 1.2.0 值得一试 58:腾讯版小龙虾「WorkBuddy Claw」体验58:DeepSeek V4 Pro 正式版 + Harness 同日开源怎么看?怎么用? 59:腾讯版小龙虾「WorkBuddy Claw」体验59:怎么打造个人工作台? 60:腾讯版小龙虾「WorkBuddy Claw」体验60:9 天 3 大实验室集体开放 Agent 框架怎么看? 61:腾讯版小龙虾「WorkBuddy Claw」体验61:DeepSeek Harness实操记录:dsh 多 Agent 调度练习