ARTICLE · 1004514
官方译介 | 复杂文档提取新标杆:Databricks Document Intelligence 推出 Precision Mode
原文地址:
https://www.databricks.com/blog/databricks-document-intelligence-pushing-frontier-complex-document-extraction
原文发布日期:2026 年 8 月 18 日
原文作者:Jane Zhang, Arnav Singhvi, Ivan Zhou, Archika Dogra, Matthew Ding and Nihit Desai
翻译:洞见Databricks(上北智信运营)
在ai_extract中引入 Precision Mode:在现有方案力不从心的长文档和复杂模式上,实现前沿级别的准确率。
从跨页对账的长文档、数千行的发票明细,到需要推理计算的复杂字段模式——企业非结构化文档中沉睡的数据价值巨大。今天,Databricks Document Intelligence 正帮助数千家客户将这些数据投入生产,把数十亿页文档转化为驱动生产管道、智能体和应用程序的结构化数据。Panasonic、EY-Parthenon、Intercontinental Exchange(NYSE)等客户已将其用于最苛刻的工作流,每周处理数百万份文档。
在与客户合作的过程中,我们注意到现有大语言模型(LLM)或基于规则的文档提取方案在以下三类难题上力不从心:
1. 长文档:一份租约第 1 页的续租条款取决于第 80 页的某项条款,或第 150 页的段落重新定义了第 3 页的术语。现有方案无法正确解析这些跨页引用。
2. 大输出、深嵌套:一份包含数百个 SKU 的多页提单,或一张有数千行明细的发票。随着输出增长,现有方案会丢弃或截断字段。
3. 复杂模式与推理:需要综合三份财务报表的风险分类,或需要根据每项记录价格应用所列折扣来计算合同价值。现有方案无法跨文档一致地应用正确的逻辑。
📝 图1|Precision Mode 结合自定义文档提取模型与智能体框架,在长文档、大输出和推理密集型模式上提供可靠、准确的提取。(图片来源:Databricks 官方博客)
今天,我们激动地宣布在文档提取 API ai_extract 中推出 Precision Mode,为最复杂的企业文档和任务树立了准确率新标杆。
Precision Mode 将我们为文档提取自定义训练的模型与一个智能体框架(agentic harness)相结合,在长文档、大输出和推理密集型模式上提供可靠且准确的提取。在涵盖约 9000 份复杂文档的基准测试中,Precision Mode 达到了业界最优质量,在提取准确率上大幅超越最新的前沿模型。
"在 Intercontinental Exchange,我们每月处理数百万份复杂、高度可变动的金融文档。Document Intelligence 帮助我们将这些复杂性转化为结构化的市场情报,使我们能够更快地行动、为客户创造更大价值,并解锁能够加速分析和规模化决策的智能体工作流。"
——Anand Pradhan,Intercontinental Exchange(NYSE)抵押贷款数据业务 CTO 兼 AI 负责人
为了在最困难的提取任务上提升准确率,我们的研发团队从两个层面入手:定制模型本身,以及在模型周围构建高效的智能体框架。
我们的研究团队基于困难客户工作负载构建的基准,训练了用于文档提取的自定义高效模型。这些模型能够定位、推理并从复杂文档中提取结构化信息。我们没有依赖越来越大的通用模型,而是针对"准确的结构化提取"这一任务进行了专门优化。
即使是一个强大的模型,在面对数百页的跨页推理或一次性生成数千个字段时也会力不从心。受 Databricks MemEx启发,我们的团队构建了一个智能体框架,能够:
语义分解大型提取任务
并行执行更小的子任务
保留中间结果
最终对账合并为一个结构化输出
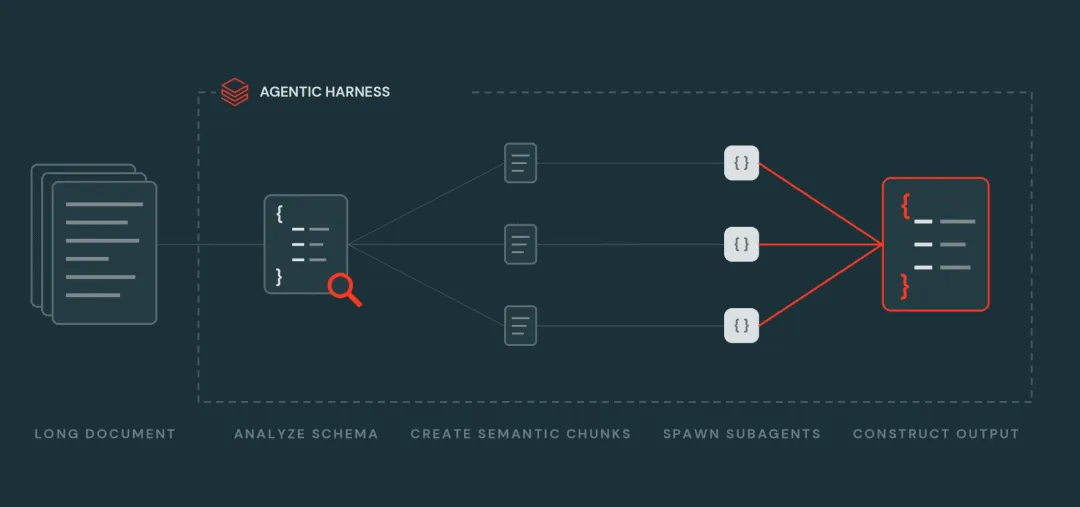
📝图2|使用智能体框架管理长文档提取:任务分解 → 并行子智能体提取 → 结果合并。(图片来源:Databricks 官方博客)
为了验证 Precision Mode,我们的评估基准围绕能将现有方案逼到极限的工作负载设计。
具体而言,我们在约 9000 份文档上评估了 Precision Mode,覆盖其旨在解决的三大提取挑战。评估集包含:
长达 2000 页的文档
包含数千行明细的发票
密集的多页表格和图表
包含超过 300 个深层嵌套字段的模式
需要跨文档交叉引用的推理密集型任务
文档来源包含两组基准:
10个内部数据集:灵感来自我们见过的最困难的客户工作负载,覆盖金融服务、制造、医疗健康等关键行业
5个公开基准:VAREX、RealDocBench、LongExtractBench、LEDGER,以及使用 Caselaw Access Project 数据集的长文档压力测试
这些数据集共同覆盖了 10-K 申报文件、提单、技术手册、金融文档、临床笔记、政府专利和资助申请等文档类型。
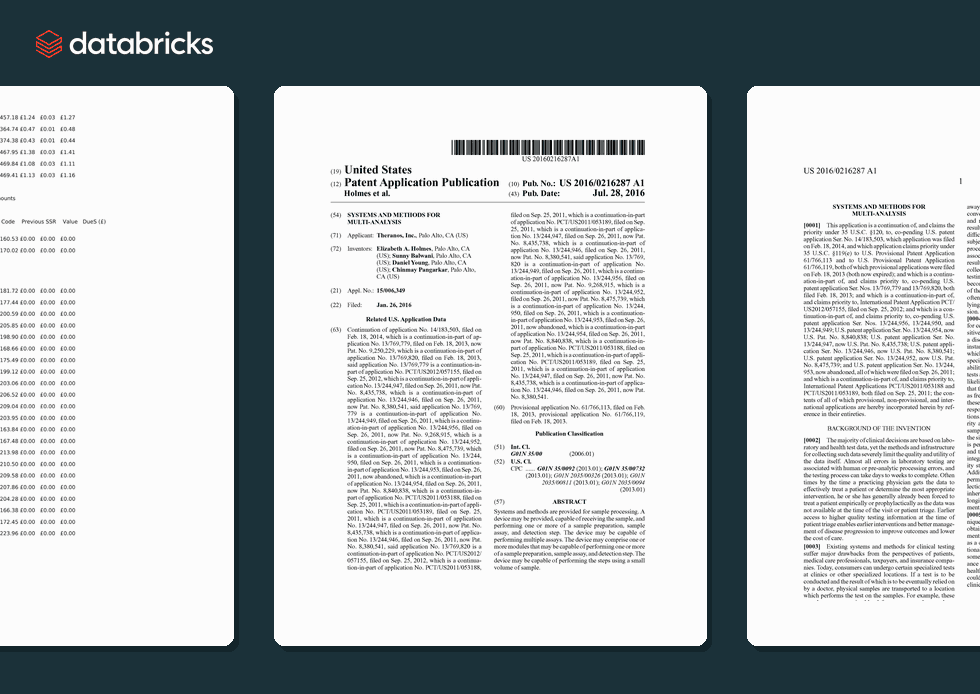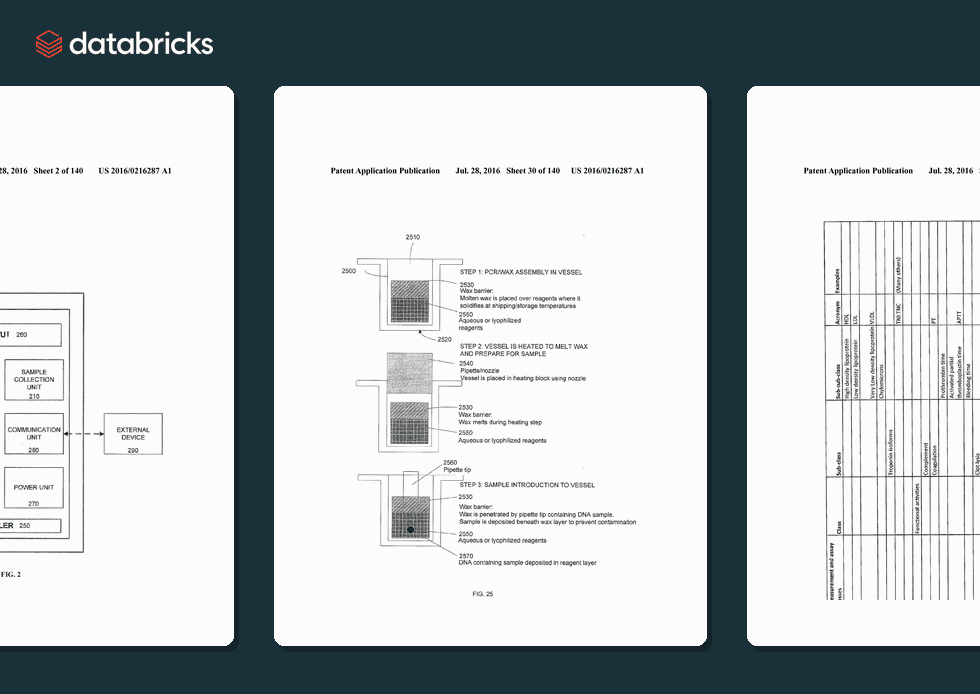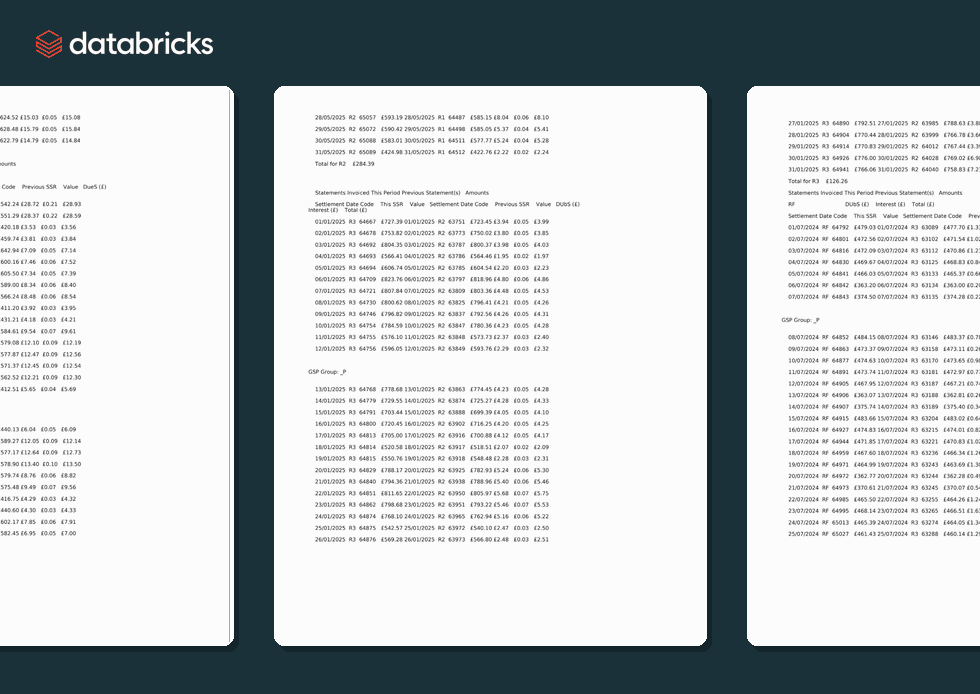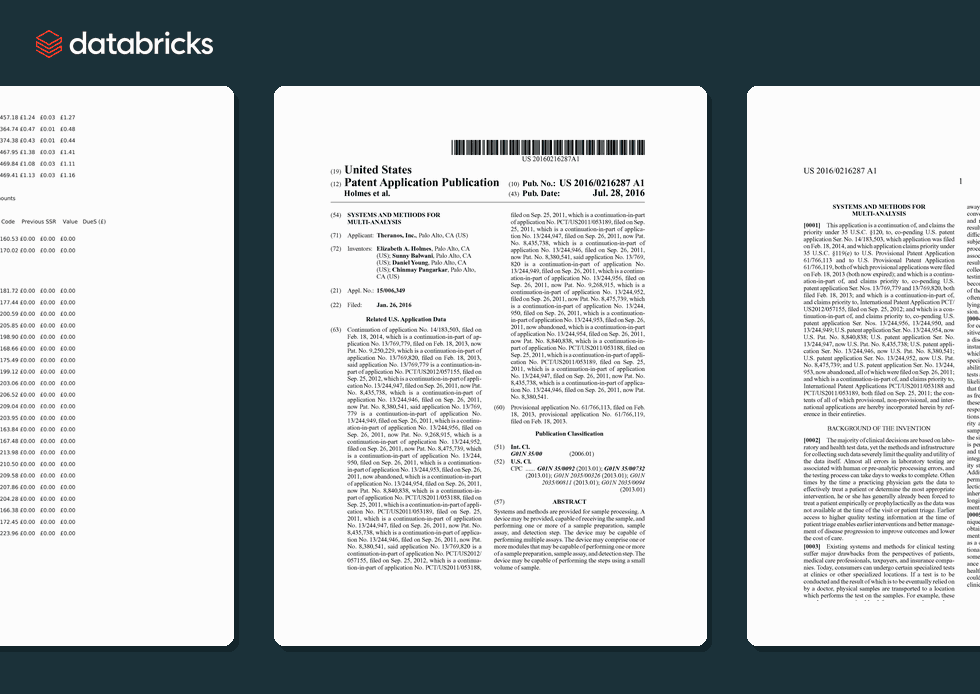
📝图3|内部基准中包含的复杂文档示例:密集表格、跨页引用、深层嵌套字段。(图片来源:Databricks 官方博客)
文档提取的一个自然起点是单次前沿模型调用:传入文档和模式,要求模型返回结构化输出。但在我们评估的密集复杂工作负载上,这种方法很快会崩溃——长文档可能超出模型上下文限制,导致结果不准确、不完整。
因此,我们针对一个更强、更现实的基线进行了基准测试:分块合并(chunk-and-merge)。我们将每份文档拆分为更小的块,独立提取,然后将结果合并为最终输出——这也是工程师在单次模型调用不够用时普遍采用的模式。
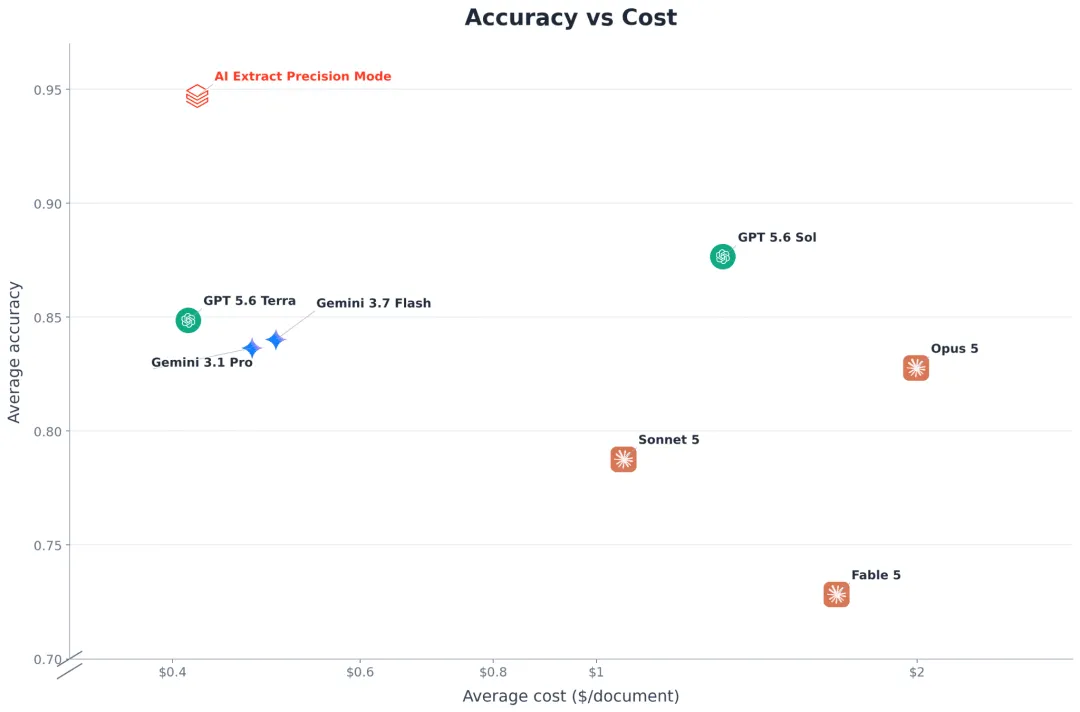
我们使用领先的 GPT、Claude 和 Gemini模型及其默认 API 设置测试了分块合并方法,然后将每个模型与 Precision Mode 在提取准确率上进行比较 ¹。
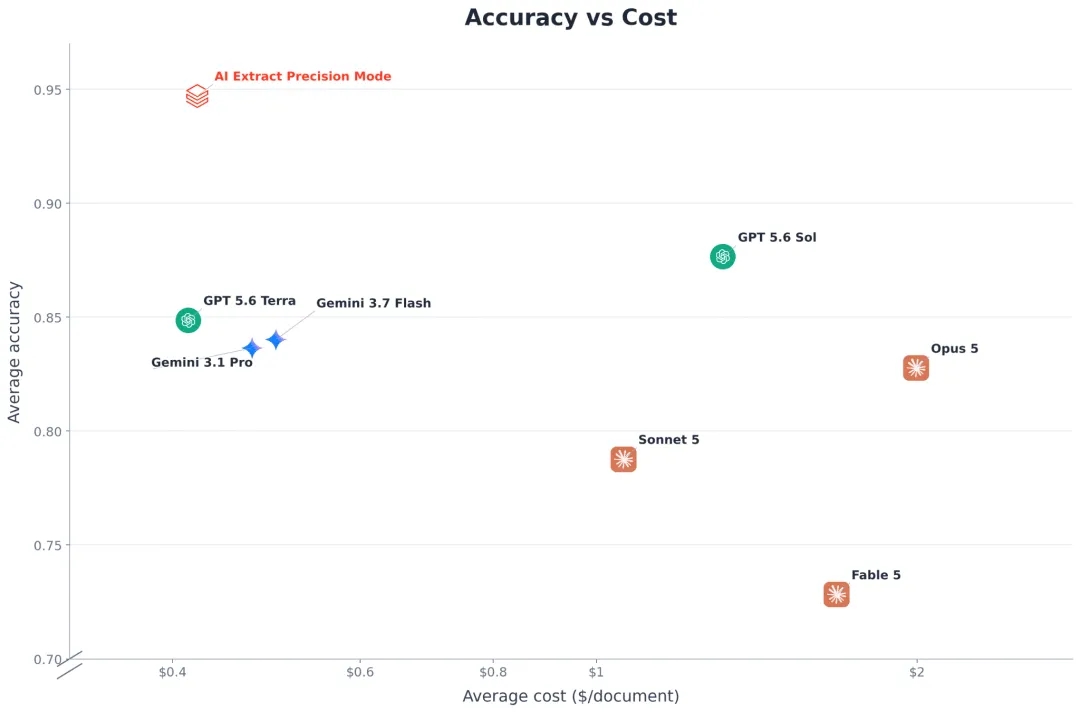
📝图4|跨基准测试中,Precision Mode 达到 94.7% 准确率,超越最强前沿模型分块合并基线 GPT-5.6 Sol 达 7 个百分点。(图片来源:Databricks 官方博客)
在所有基准测试中,Precision Mode 达到 94.7% 的准确率,超越最强的前沿模型分块合并基线 GPT-5.6 Sol达 7 个百分点。
特别是在困难的长文档工作负载上,我们观察到前沿模型遇到了大量操作故障模式,包括分块超时、输出截断,以及不符合请求模式的不完整最终合并。相比之下,Precision Mode 的智能体方法对这些故障模式具有鲁棒性,且我们自定义训练的提取模型保持了提取的高效和准确。
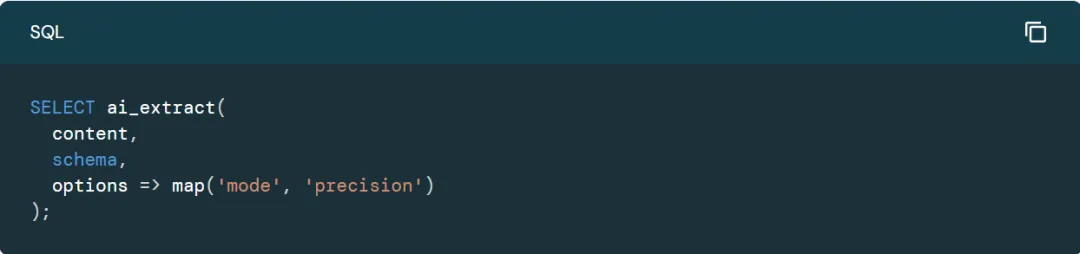
对于最复杂的文档提取任务,AI Extract Precision Mode 现已可用。在调用 ai_extract函数时将模式设为 precision,或在 Agents 页面的 Information Extraction UI 中打开 Precision Mode 开关:
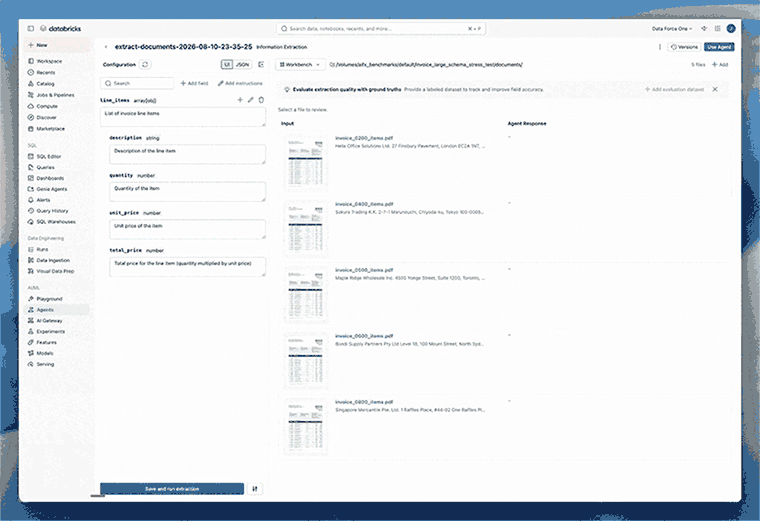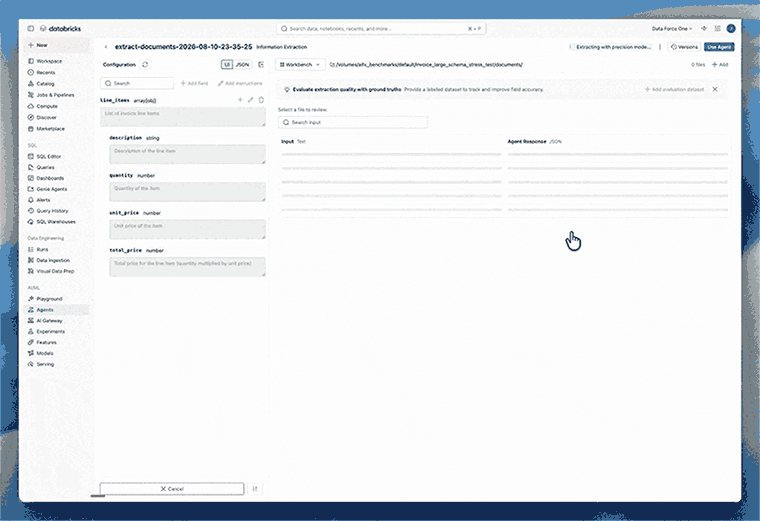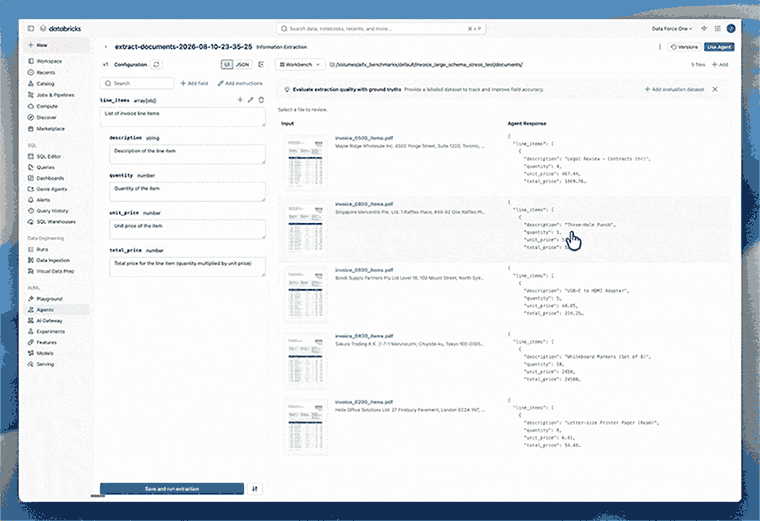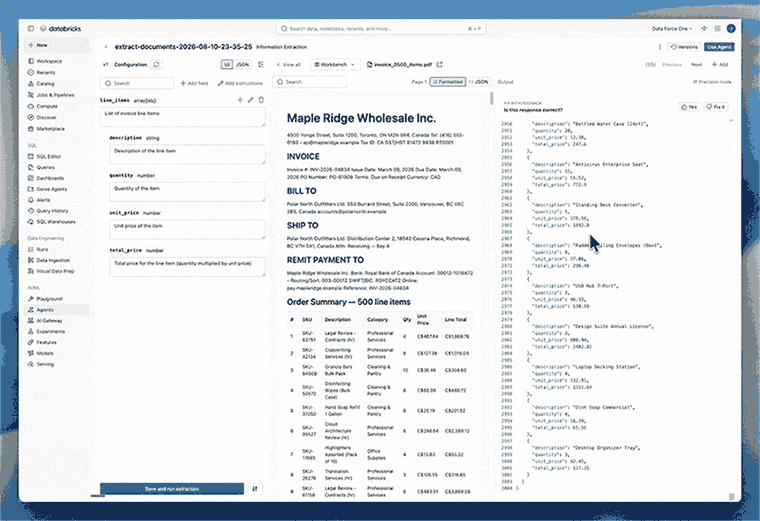
📝图5|AI Extract Precision Mode 操作演示。(图片来源:Databricks 官方博客)
¹ 我们将准确率定义为匹配真实标注对象的提取对象比例。评分因类型而异:
基本类型(布尔值、浮点数、整数、枚举):直接匹配
字符串:先尝试直接匹配,再模糊匹配,最后使用 LLM 评判器
数组:通过找到预测项与期望项之间的最接近配对来评分,然后对所有配对取平均
对象:按字段类型逐字段评分,然后对所有字段取平均
这篇发布于 2026 年 8 月 18 日的产品文,展示了 Databricks 在企业级 AI 应用落地上的最新进展。与 6 月的 Instructed-Retriever-1(检索加速)一脉相承,Precision Mode 同样采用了"自定义模型 + 智能体框架"的双层架构思路——这正是 Databricks Agent 战略的核心技术范式。
对于国内企业而言,合同审查、发票处理、财报分析等场景的文档提取需求极为旺盛。Precision Mode 的架构思路(语义分解 → 并行子任务 → 结果合并)对自建文档 AI 管道有很强的参考价值。
【本文由洞见Databricks 编辑呈现】
洞见Databricks 由上北智信运营,聚焦 Databricks / Lakehouse / Spark 在国内的落地实践与中文技术生态。
🤝 商务合作 / 技术交流
扫码添加企微客服,或见公众号菜单栏「联系我们」