ARTICLE · 1005898
源码的第一读者,是 AI
摘要:AI 写代码越来越强,工具却都在文本上编辑——文本给人读,不适合 AI。Vercel Zero 把程序变成语义图,AI 改图、编译器做守门员。落地还差多远?
让 AI 在一个陌生仓库里改一个方法,多数人会先遇到这类场面:它读了一堆文件,贴出一段 diff,一半是格式化噪音;你说"改第 47 行",等你在前面插两行注释,它反倒改错了地方。
问题不在模型笨,在编辑的载体。今天所有 AI 编程工具,无论界面多花哨,底层动作都是同一件事:在文本上做增删改。可文本是给人读的,行号会漂、格式会动、语义藏在字符间隙里——AI 每次下笔前,都得先猜"这句话落在哪个语义位置"。
2026 年 5 月,Vercel Labs 的 Chris Tate 发布了这门叫 Zero 的语言,8 月在 GitHub 开源,把这个问题连根拔起:程序根本不是文本,而是一张图。AI 不读源码,直接查图、改图,编译器在每次改动落盘前做校验。源码文本呢?降级成一张"给人看的投影"。
把"改第几行"换成"改哪个节点"
Zero 的核心假设一句话能说清:程序的本质是符号、调用、类型、依赖组成的语义图,文本只是这张图的一种序列化视图。
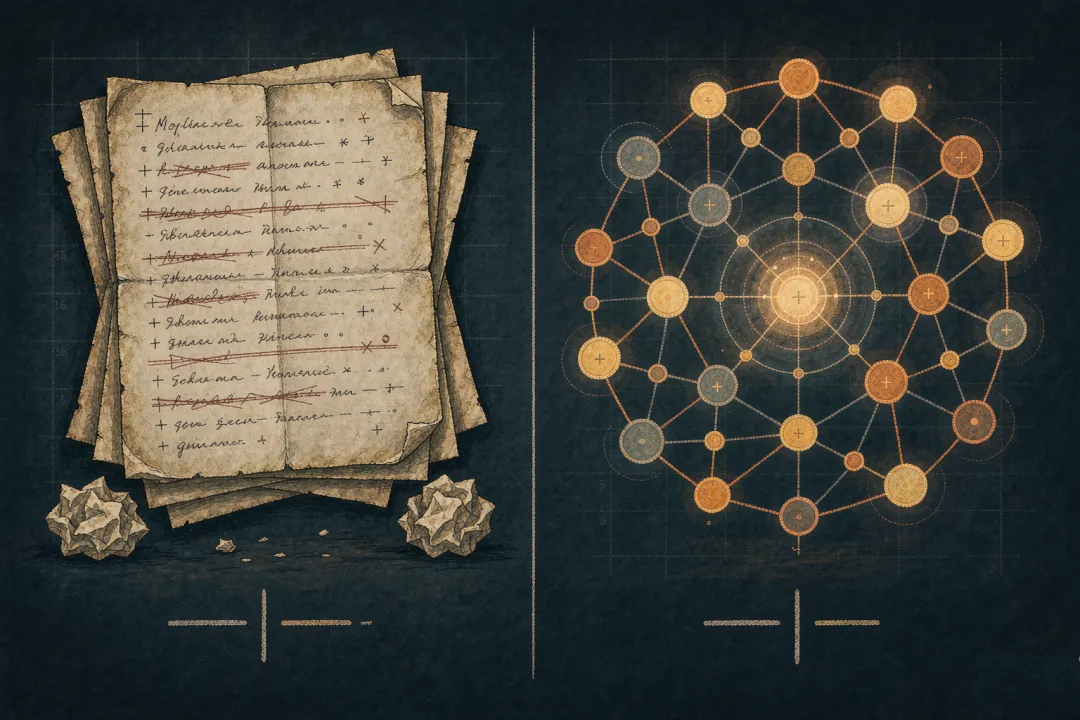
在这个模型里,AI 的工作方式变了。传统流程是"读文本 → 改文本 → 让编译器/解释器告诉你改得对不对",一个来回里藏着大量试错;Zero 把编译器挪进循环中间:Agent 用 query 读图、用 patch 改图,每次 patch 都带一个图哈希和字段期望值,编译器先校验——目标节点还是你读取时的状态吗?类型和形状对吗?
对不上,编辑直接失败,根本不落盘。这套设计的核心是给 AI 的编辑提供语义锚点——它瞄准的是"表达式 653eeb6e 的 value 字段"这种稳定标识,而不是"第 47 行第 3 个字符"这种会随任何一次插入而漂移的位置。
这套机制的实际收益目前还没量化——GitHub 上 5000 多星、版本号刚走到 v0.3.4,官方自己都标注"实验性、随时破坏性变更"。但方向是对的:改动有了确定性的校验,Agent 不再靠"生成文本后跑一遍看结果"来猜自己改没改对,迭代圈更短,静默出错更少。
编译器在环里,人在环外
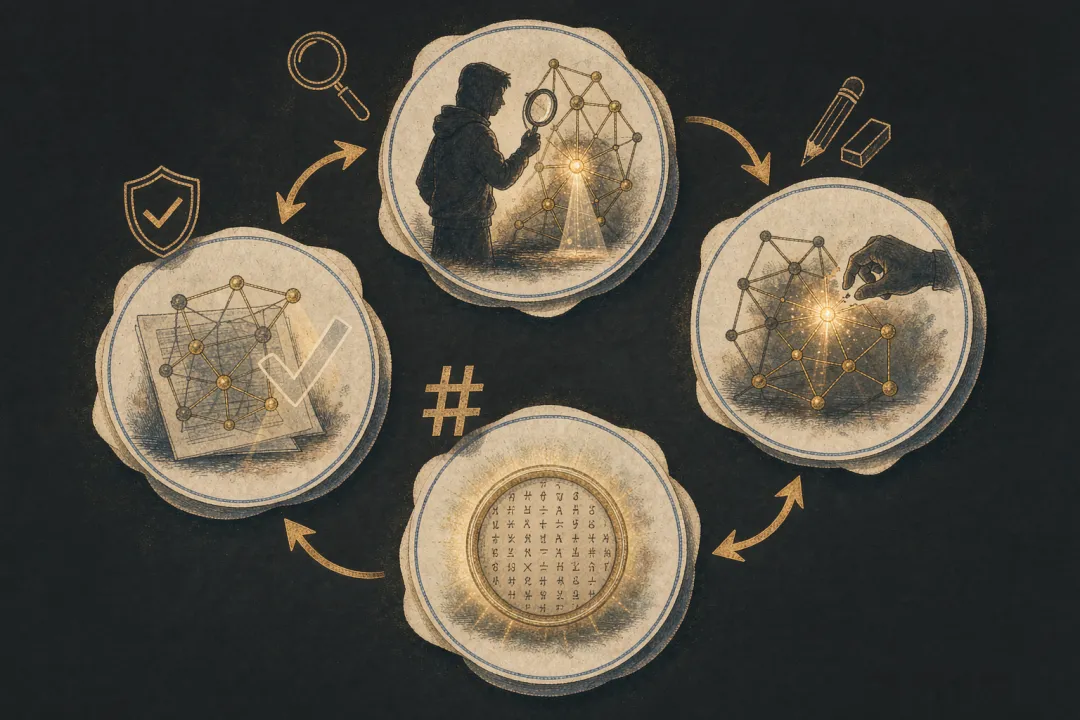
Zero 更激进的地方在于版本演进。到 v0.3.0,官方把"图优先"变成默认工作流:编译器输入直接是一个二进制图存储(zero.graph),.0 文本文件只是它的可读投影。这个决定是反复横跳后落下的——v0.1.4 用行语法、v0.2.0 把文本当原生载体、v0.3.0 又彻底拒绝文本输入,足以看出团队自己也还没想清楚终局。
人和 Agent 的角色就此分开:
- Agent:用
query读图、patch写图,全程不碰文本; - 人:用
export把图投影成.0文本查看,偶尔手动改,再import回去; 一个叫 zero fix --plan --json的命令,会把编译错误转成机器可读的修复计划——错误码(比如NAM003)带着类型化的修复建议(比如declare-missing-symbol),Agent 可以直接执行、修改或拒绝,而不是对着人类写的报错猜含义。
这套"给机器看的诊断"是 Zero 的另一层设计:传统编译器把报错写给人看,Zero 把所有诊断输出统一成结构化 JSON,每个子命令共享同一套 schema。对 Agent 来说,错误不再是需要二次解析的自然语言,而是可以直接消费的数据。
副作用也被做成显式约束:任何要触碰外界的函数,签名里必须带上一个 World 能力参数,编译器强制检查。一个函数能不能联网、能不能写文件,看签名就知道——这对让 Agent 放手写代码的安全边界,是实打实的帮助。
不是孤例:语言开始为 AI 重写
把 Zero 放进更大的背景里看更有意思。有个叫 agentlanguages.dev 的目录,专门收录"为 LLM 或 Agent 写代码而设计"的语言,到 2026 年 8 月底已经收了 41 个,分成三大阵营:
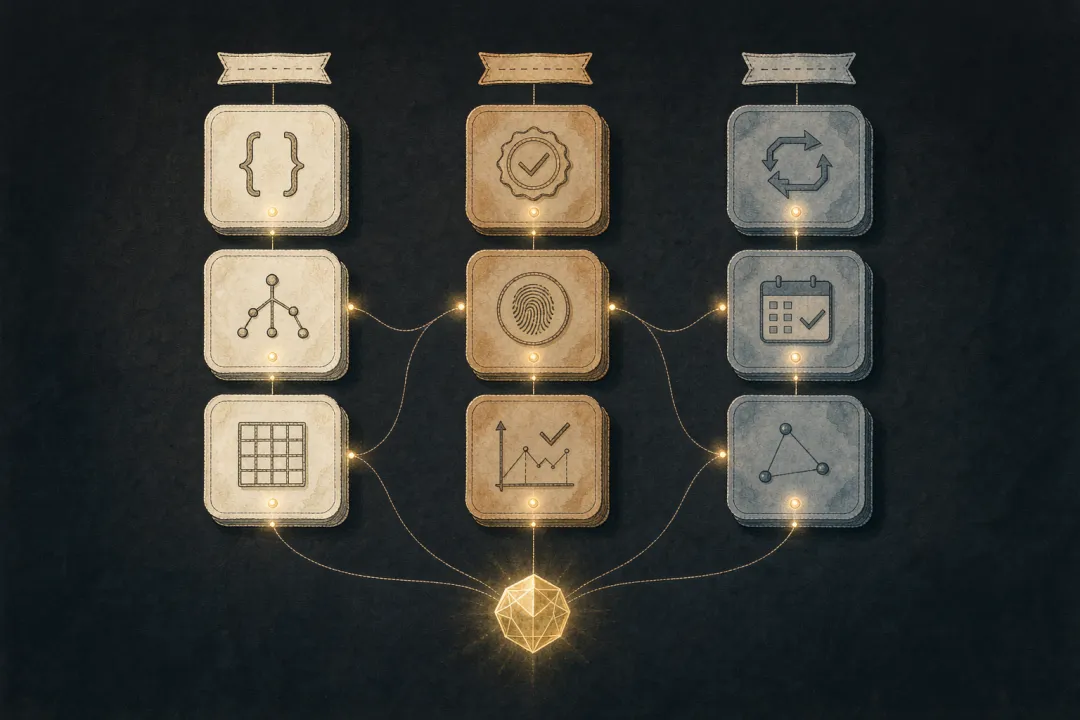
- 句法派
:认为问题出在表示层,语法太复杂、歧义太多,AI 容易写错。代表如 NERD(把所有运算符换成英文单词,赌 tokenizer 对单词更省 token)、Mog(整份语言规范压到 3200 token 内)、X07(程序直接就是 JSON AST,编辑操作是标准 JSON Patch)。 - 验证派
:认为模型不可能不犯错,关键是让编译器机械地抓住错误。代表如 Vera(每个函数强制带前置/后置契约,用 Z3 求解器验证)、NanoLang(每个函数强制配"影子测试块",核心有 193 条零公理 Coq 定理)。 - 编排派
:认为问题不在语言而在流程,要给 Agent 套上约束和审计。代表如 Fabro(用 Graphviz 图定义工作流、把每一步路由给不同模型)、Boruna(面向监管行业:每个副作用显式声明并做策略门控,执行过程生成哈希链证据包)。
Zero 属于"验证 + 句法"的激进混合——它不满足于让语法更简单,而是直接换掉载体。X07 和它思路最接近(程序就是规范 JSON AST,编辑操作是标准 JSON Patch),只是 Zero 做得更彻底、背后有 Vercel 的资源。
别急着下注
但冷静看,这门语言离"主流"还隔着几条鸿沟。Hacker News 上的讨论整体平淡,质疑集中在两点:Agent 为什么要学一门新语言,而不是用预训练里见过几百万次的 Python、TypeScript? 以及 语义图省 token、降错误率,至今没有量化证明。
第二个问题尤其关键。Agent 最擅长的语言,恰恰是语料里出现最多的语言。一门新语言再"为 AI 优化",也绕不开冷启动——模型没怎么见过它,写出来就生疏。
这不是无解的死局,国内有个现成的对照样本。粤港澳大湾区数字经济研究院的 MoonBit 自称 “AI-native 语言”,设计上刻意减少嵌套、强制顶层类型签名,让代码更适合模型线性生成;一篇被 IEEE TSE 接收的论文 拿 MoonBit 和 Gleam 这类"无资源语言"做测试,发现模型零样本写 MoonBit,在最难的 McEval-Hard 上通过率只有 1% 左右——但用官方代码和文档继续预训练、再做指令迁移后,Qwen2.5-Coder-32B 在 MoonBit 的 McEval-Hard 通过率能拉到 32.6%。
结论很朴素:新语言不是学不会,是需要主动"喂"给模型。Zero 官方仓库里也专门放了 skills/zero 和训练数据目录,说明它没指望模型天生会写——这是要自己动手养生态。
还有个现实约束:从 5 月发布到现在,Zero 的版本号刚走到 v0.3.4,官方在文档里反复强调"实验性、随时破坏性变更、请在隔离环境运行"。语言设计还在剧烈变动的东西,不适合任何生产项目。
我的判断
对大多数开发者,尤其是 Java 后端,现在不需要学 Zero,也不需要恐慌"源码要消失了"。真正值得留意的是它背后的信号:
程序的第一读者,正在从人变成 AI。 过去三十年,源码、报错、文档都在为人类读者优化;当写代码的主力变成 Agent,编译器输出的读者也随之改变。Zero 只是把这条路走到极端——结构化诊断、语义锚点、把编译校验前置到编辑动作里,这些理念会以更温和的方式渗透进现有工具链。
你可以把 Zero 当成一个观察窗口:它验证的从来不是"图比文本好",而是"当 Agent 成为代码的主要生产者,我们为它设计的开发环境,和为人设计的是两回事"。这个认知,比任何一门具体语言都活得久。
参考资料
Zero · Vercel Labs(GitHub) — “The Programming Language for Agents”,Apache 2.0;图即源码、checked patches、v0.3 图优先工作流等机制均见官方仓库与文档 Vercel Labs Ships Zero: a Graph-First Language(InfoQ) — Daniel Curtis,2026-08;Zero 发布背景、版本演进 v0.1.4→v0.3.0、结构化诊断与 HN 讨论摘录 agentlanguages.dev — 为 LLM/Agent 写代码而设计的编程语言目录,收录 41 个项目(截至 2026-08-31),三大阵营划分与各语言描述出处 No Resource, No Benchmarks, No Problem?(arXiv:2606.16827) — USI/塞维利亚大学团队,被 IEEE TSE 接收;MoonBit/Gleam 无资源语言代码生成评测与继续预训练、指令迁移结果
作者:唐悦玮 | 从后端出发,用 AI 拓展到全栈的工程师。