ARTICLE · 1006419
从逻辑翻译到意图理解:大模型重构软件工程开发范式
前沿
从逻辑翻译到意图理解:
大模型重构软件工程开发范式
|作者| 于吴桐 王子璇 瞿芳磊 周德宇
探讨智能软件工程技术路径,梳理演进脉络与代表性技术,展望“程序+模型”双核心驱动的软件新形态。
当代软件工程领域正经历一场前所未有的范式变革,从早期人工代码编写逐步迈向智能化意图理解阶段。系统复杂性呈指数级增长,使传统显式指令构建模式难以适配效率与创新的需求,生产力瓶颈亟待突破。软件工程历经1.0时代(显式指令确定性逻辑)至2.0时代(数据驱动逻辑优化)的演进,虽提升了交付效率,却难以应对当前的复杂挑战。在此背景下,大语言模型(large language model, LLM)凭借强大的代码生成与推理能力,催生了软件工程3.0时代。

软件工程的演进
软件开发的范式并非一成不变。为了理解当前的变革,首先需要建立一个清晰的历史坐标系。Andrej Karpathy[1]将软件的发展分为3个主要阶段,这不仅仅是版本的迭代,更是思维方式的跃迁。
软件工程1.0时代
软件工程1.0是我们最熟知的传统软件开发模式,也是当前数字世界的基石。在这个范式中,程序员扮演着逻辑翻译官的角色,他们将现实世界的复杂需求,拆解为计算机能够严格执行的显式指令。无论是Python、C++还是Java,这些编程语言本质上都是人类向机器下达的确定性命令。每一行代码,都代表了程序员在巨大的程序空间中精确定义的一个逻辑点。通过编写明确的条件判断、循环逻辑及模块化架构设计,程序员们成功构建了操作系统、数据库和Web服务器等基础设施。这种模式的优势在于其绝对的精确性和可控性,然而,它的局限性也同样明显:对于那些难以用显式规则描述的模糊问题,比如“识别一张图片中是否有一只猫”,软件工程1.0的编程范式显得力不从心,因为人类无法写出数百万行“if语句”来穷尽“猫”的所有视觉特征。
软件工程2.0时代
随着深度学习的兴起,软件开发进入了2.0时代。在这里,软件的形态发生了质的飞跃:代码不再局限于人类可读的源文件,而是变成了神经网络中数以亿计的抽象“权重”。程序员不再直接编写逻辑,而是通过提供海量的输入输出数据,定义一个神经网络架构作为骨架,然后利用反向传播和随机梯度下降等优化算法,让计算机自己在巨大的搜索空间中寻找出最优的程序。这种由数据训练得来的软件工程2.0,在图像识别、语音合成等感知类任务上表现出了超越人类的能力。虽然由于内部计算过程是难以透视的黑盒,它牺牲了部分可解释性,但解决了软件工程1.0无法处理的非结构化难题。
软件工程3.0时代
如今,我们正站在软件工程3.0的门槛上,这是一个由大语言模型驱动的全新范式。在软件工程3.0中,大语言模型充当了通用的认知引擎或操作系统,而自然语言提示词(prompt)则成为新的源代码。开发者只需通过自然语言描述意图和约束条件,例如“帮我写一个贪吃蛇游戏”或“总结这篇文档”,大语言模型就能凭借强大的代码生成能力和逻辑推理能力,自动理解需求并输出最终的执行逻辑,既可以生成一段Python代码,也可以直接输出答案。这种范式大大降低了编程的门槛,实现了从“指令驱动”到“意图驱动”的跨越。然而,这也引入了更多的不确定性,模型可能会产生幻觉,这要求新一代的软件工程师掌握如何验证、引导和约束这个强大的智能引擎,而不仅仅是编写代码的本领。
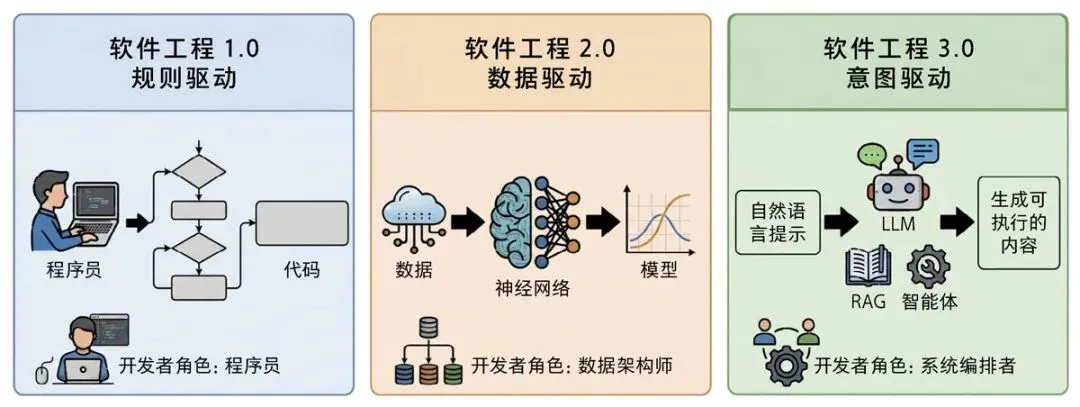
软件工程的三阶段演进

软件工程2.0的关键技术
软件工程2.0的实现依赖于机器学习库生态与数据工程技术的突破。单纯的统计学习算法虽然具备了处理感知任务的能力,但缺乏工业级的工程规范。模型训练(model training)、数据管线(data pipelines)与机器学习运维(MLOps)体系,从不同方面支持软件迭代,成为机器学习从学术研究迈向工程实践的关键技术[2]。
模型训练
在软件工程 2.0 范式中,最深刻的转变在于对程序本质的重定义。安德烈·卡帕斯(Andrej Karpathy) 指出,代码的形式已从程序员手动编写的显式指令转变为神经网络中的抽象权重与参数。在这种模式下,传统的源代码编写被模型训练所取代,开发者不再通过编写“if-else ”来穷尽业务规则,而是定义神经网络架构作为骨架,利用反向传播等优化算法让计算机在巨大的搜索空间中自动寻找最优的函数近似。为了提升开发效率,TensorFlow、PyTorch 等主流机器学习库成为行业标配。这些库提供了预设的算法组件,使开发者能够快速构建出具备语音识别、图像分析等感知能力的系统。
数据管线
数据是软件工程2.0的核心支撑,其质量直接决定了软件的行为边界。数据管线旨在构建一套自动化的数据生命周期管理体系,涵盖数据的收集、清洗、标注与特征工程等关键环节。在软件工程2.0场景下,由于逻辑是从数据中习得的,数据处理不再是开发前的一次性预处理,而是需要像工业生产线一样不断迭代升级,确保持续的基础支撑。为应对数据依赖带来的系统脆弱性,现代数据管线引入了严格的版本控制机制,通过DVC、Pachyderm等工具建立可追溯、可复用的数据管线,成为降低技术债务累积、确保模型能够基于准确事实进行训练的关键基座。
机器学习运维
当模型与管线准备就绪,如何确保其在动态环境下的稳定运行与持续演进,成为软件工程2.0的最后一道关卡。机器学习运维体系借鉴了软件工程1.0的DevOps思想,但其核心增加了对数据和模型的版本化追踪。由于软件工程2.0系统在源码、模型和数据3个轴向上同时变化,其测试与部署的复杂性远超传统软件。在工程实践中,由于机器学习库版本发布极其频繁,软件系统常面临二进制不兼容和性能退化的风险。机器学习运维体系通过构建集成的持续集成(CI)与持续部署(CD)环境,并引入用于覆盖率提升的测试技术,实现了对模型在沙箱环境中的实时监控与自动重训。这种将模型视为动态代谢工件的运维模式,带领软件生产从单次发布走向持续进化。

软件工程3.0的研究进展
从概念到落地,软件工程3.0的实现依赖于一系列大模型关键技术的突破。单纯的预训练模型(pre-trained models)虽然具备了通用的知识,但缺乏特定领域的专业能力。微调(fine-tuning)、检索增强生成(retrieval, augmentation, generation, RAG)与智能体(agent)框架,从不同维度为模型注入专业能力,成为大语言模型走出通用对话舒适区、迈向工程实践深水区的关键技术。目前,针对“如何内化领域专有规范”、“如何精准获取代码上下文”以及“如何自主规划复杂任务”三大核心问题,业界构建了一套立体化的基础设施,以支撑软件工程3.0的落地。
微调
在大模型发展的早期阶段,开发者通常依赖指令微调来教会模型“说程序员的语言”。然而,传统微调本质上是一种统计学上的简单模仿,模型通过海量代码学会语法风格,却往往难以深入理解代码背后的执行逻辑。这一局限性在企业私有框架或高安全规范场景下尤其突出,生成的代码常常仅形似,执行中会出现各种错误。
为降低定制成本,低秩适应(LoRA[3])及其变体成为行业标配,使得企业能够在消费级显卡上高效训练私有代码模型,实现“千企千模”的个性化部署。在此基础上,WizardCoder[4]通过算法自动生成复杂度渐进的编程问题对模型进行专项训练,显著提升了其处理复杂逻辑与边界情况的能力。
更深刻的范式转变,在于从模仿学习转向与环境交互的强化学习。代码具有独特优势:它运行在客观、确定的数字执行环境(编译器与测试套件)中,其正确性可被严格检验。最新研究正利用这一点,将代码执行结果直接转化为优化模型的信号。例如,μCode[5]将代码生成形式化为强化学习问题,将代码生成的过程视作单步可恢复的决策过程,验证器根据测试结果给出单步奖励信号,该奖励信号直接用于优化生成策略,形成一个完整的“生成-执行-奖励-优化”闭环。同时,RLCoder[6]等工作展示了强化学习如何优化仓库级代码补全中的检索策略,使模型学会主动判断何时、从何处获取最有效的上下文信息。
这一转变标志着大模型正从语法和模式的模仿者,演变为能通过与环境交互来自主学习与改进的协作者。 模型不再仅仅学习“代码看起来什么样”,而是通过试错,内化“什么样的代码能成功运行并满足约束”的因果逻辑。这种基于客观验证的强化学习,是解决代码生成中幻觉问题、推动大模型从“编程助手”迈向“可靠自主协作者”的关键路径。
检索增强生成
在软件工程领域,检索增强生成已从通用文档问答工具,演进为深度理解项目上下文、提升开发效率的智能基座。其基础范式是通过构建代码仓库的语义索引,为补全、定位等任务提供精准上下文。例如在仓库级代码补全场景中,RAG呈现出从迭代检索到语义增强的清晰演进路径。
RepoCoder[7]率先系统化解决该问题,其框架不依赖静态分析,而是通过迭代检索与生成协同机制突破单轮检索局限:语言模型生成的初步代码会作为新查询,从仓库中检索出更相关的上下文,经多轮迭代,最终合成与项目模式高度一致的代码。然而,纯文本向量检索难以捕捉程序内在的精确逻辑依赖(如数据流向等)。因此,图-向量混合检索架构成为前沿方向,有研究通过对整个代码库进行静态分析,构建抽象语法树(AST)并执行扩展数据流分析(DFG),生成表征完整数据依赖的“仓库特定上下文图”。在代码补全时,系统可据此图精准检索出与当前光标位置有实际数据流交互的代码片段作为上下文,确保生成代码不仅在语义上相关,更在工程逻辑上自洽。这标志着RAG从基于“文本相似”迈向基于“语义相似”的检索。
与此同时,RAG范式被成功迁移并革新了软件安全测试领域。针对API模糊测试中测试代码生成质量低的难题,有研究通过构建由代码元数据、API文档和真实调用关系组成的结构化知识库,并基于该知识库进行检索增强,使大模型在生成测试代码时能精准检索并融入当前API约束、常见用法与错误模式。这种领域知识增强的生成方式,结合闭环质量净化机制,使生成的测试代码在分支覆盖率上显著超越基于大语言模型的旧方法和人工代码,并高效挖掘出大量真实漏洞。通过RAG注入精准结构化工程知识,可将大模型的通用能力转化为解决特定复杂工程问题的专业能力。
智能体框架
当底层模型与知识库就绪,如何让它们像一支训练有素、配合默契的工程团队般协同工作,成为智能软件工程的“最后一公里”。软件生产模式正从“线性工作流”转向“动态自适应编排”。早期多智能体框架如ChatDev[8]等,虽引入角色扮演,但多遵循预设、硬编码的执行脚本,难以应对现实开发中复杂多变的真实需求。
当前研究致力于构建具备反思与调试能力的自主智能体。这一研究方向的核心突破在于赋予智能体“运行状态感知”与“自我修正” 能力。当智能体生成的代码测试失败时,它不再仅基于错误信息进行文本层面的猜测式修改,而是能够观察程序在沙箱中包括变量状态、控制流路径和异常堆栈在内的实际执行过程。这使智能体能像人类工程师一样进行根因分析,实现“生成→测试→诊断→修复”的强闭环。
更具前瞻性的探索在于构建多智能体动态协作生态系统。以 MetaGPT[9]框架为例,系统可根据任务的复杂性与专业性需求,动态召集由“架构师”“程序员”“测试者”等虚拟角色组成的临时团队。这些角色智能体之间会进行任务分解、方案辩论与代码评审,模拟真实软件开发现场。这种 “按需组队、专业协作” 模式,不仅是高效的协作工具,更在尝试复现与优化人类团队解决问题的集体智慧。
通过深层次的运行感知、自我反思与多角色协作,智能体框架正将软件工程从“人驱动工具”推向“人定义意图,智能体团队自主实现”的新阶段。 其演进方向并非取代人类工程师,而是形成能够理解复杂目标、规划执行路径并可靠交付成果的超级数字化劳动力,从而将人类从繁琐的实现细节中解放出来,使其更专注于高层次的架构创新与问题定义。

未来发展
软件工程3.0的浪潮正在将这一领域推向全新的未知疆域。未来几年,我们将见证更深层次的变革,同时也面临着前所未有的挑战[10]。
角色转型
在传统的开发模式中,程序员的职责是将人类意图翻译成机器可理解的显式指令。但在软件工程3.0的背景下,开发者将完成从“逐行编码者”到“智能系统编排者”的关键转变。未来开发者的核心竞争力不再是掌握多少种编程语言的语法,而是如何设计精确的提示词、如何验证AI生成的复杂构件以及如何协调多个自主智能体共同解决大规模工程问题的能力。
信任重构
过去半个世纪,软件工程的重心是“规模化编程”,即如何构建超大规模的代码库。而随着AI自动生成代码的普及,重心将转向“可信编程”。AI生成的代码不再被视为黑盒,而是携带足够的关键证据(如形式化规格说明或自动生成的验证报告),以证明其逻辑合规性与功能可靠性。建立一套科学、可落地的信任机制,让开发者能够放心地将AI生成代码集成到商用软件系统中,将成为支撑软件工程3.0稳步推进的核心基石。
系统演进
未来的软件将不再是发布后即固化的静态工件,而是具备自我感知与演进能力的自适应系统。借助大模型的推理与自主规划能力,软件能够在生产环境中通过自主测试实时发现缺陷,并依托智能体自动生成补丁,完成在线修复。这种具备自主代谢与更新功能的软件形态,将极大地缩短软件从故障到恢复的周期,实现真正意义上的持续演化。
协作范式
在进行人机协同时,人机关系将从主从式的工具调用,演变为平等对称的伙伴协作。未来的软件团队将是人类与AI代理深度交织的混合型组织,两者基于共享的心理模型开展高效的对话式开发。AI代理不仅能被动响应指令,还能主动预测开发者的需求、识别架构中的隐性风险,甚至在结对编程中提供更高维度的逻辑审查,实现认知层面的互补与共生。
工程责任
在全力推进智能化转型的同时,软件工程3.0也将面临前所未有的资源约束挑战,“可持续性”将从过去的边缘指标跃升为软件的核心非功能性需求。这就要求未来的智能软件工程必须在技术效能与环境影响之间找到精准平衡:一方面需要研发能效更高的小型化、轻量化模型,降低模型训练与推理过程中的能源消耗;另一方面需优化检索增强生成技术的知识检索密度,减少不必要的算力浪费,确保智能化带来的产业红利,不会以高昂的能源消耗和沉重的生态足迹为代价,实现软件工程的绿色化、可持续发展。
总体而言,软件工程3.0的未来演进,是技术形态、角色定位、协作模式与责任认知的全方位变革,唯有主动适应这些趋势、攻克转型中的核心难题,才能真正把握智能化时代软件工程的发展机遇。
于吴桐,博士研究生;王子璇,硕士研究生;瞿芳磊,硕士研究生;周德宇,教授:东南大学计算机科学与工程学院,南京 211189。d.zhou@seu.edu.cn
Yu Wutong, Doctoral Candidate; Wang Zixuan, Master Degree Candidate; Qu Fanglei, Master Degree Candidate; Zhou Deyu, Professor: School of Computer Science and Engineering, Southeast University, Nanjing 211189.
[1]Andrej Karpathy. Software is changing (again). https://www.youtube.com/watch?v=LCEmiRjPEtQ.
[2]Malinda Dilhara, Ameya Ketkar, Danny Dig. Understanding software-2.0: A study of machine learning library usage and evolution. ACM Transactions on Software Engineering and Methodology, 2021, 30(4): 1-42.
[3]Hu E J, Shen Y, Wallis P, et al. LoRA: Low-rank adaptation of large language models. The Tenth International Conference on Learning Representations, 2022.
[4]Luo Z, Xu C, Zhao P, et al. WizardCoder: Empowering code large language models with evol-instruct. The Twelfth International Conference on Learning Representations, 2024.
[5]An Y, Jiang C M, Xu S, et al. μCode: Multi-turn code generation through single-step rewards. The Forty-second International Conference on Machine Learning, 2025.
[6]Lu S, Huang Y, Wu H, et al. RLCoder: Reinforcement learning for repository-level code completion. Proceedings of the 47th International Conference on Software Engineering, 2025.
[7]Zhang F, Chen B, Zhang Y, et al. RepoCoder: Repository-level code completion through iterative retrieval and generation. Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, 2023: 2471-2483.
[8]Qian C, Cong X, Yang C, et al. ChatDev: Communicative agents for software development. Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics, 2024: 15174–15186.
[9]Hong S, Zhuge M C, Chen J, et al. MetaGPT: Meta programming for a multi-agent collaborative framework. The Twelfth International Conference on Learning Representations, 2024.
[10]Mauro Pezzè, Silvia Abrahão, Birgit Penzenstadler, et al. A 2030 roadmap for software engineering. ACM Transactions on Software Engineering and Methodology, 2025, 34(5): 55.
关键词:软件工程3.0 大语言模型 意图驱动开发■


《科学》编辑部收件地址:
上海市闵行区号景路159弄世纪出版园A座1006室
邮编:201101