ARTICLE · 1007068
AI日报|欢迎进入AGI时代?GPT-6 Astra发布!英伟达拟收购Hugging Face!Runway发布GWM Worlds 2世界模型研究!fal推出H3 Max Director!
2026年9月4日 AI资讯日报
【AIGC】
• Runway发布GWM Worlds 2世界模型研究预览:可持续生成720P、24FPS交互视频并同步输出48kHz音频,用户可实时控制人物、物体、镜头、对白和天气,世界会根据新输入继续演化,而不是生成长度固定的视频片段。 • fal推出H3 Max Director:主打连续实时视频流,不再把多个独立视频片段拼接,而是在同一Session中持续保留人物、场景和故事上下文,并支持通过实时Prompt不断改变后续内容。 • SolarWM完整开源长时程视频世界模型框架:统一支持Wan2.2、LTX-2.5和MiniMax-H3等5B至33B视频模型,并开放数据处理、训练、推理和部分模型权重;模型只训练5秒片段,也能进行分钟甚至小时级交互式长程生成。 • Tripo推出P2.0 Preview多视图3D能力:最多可输入前、左、右、后4张参考图共同重建几何,并原生生成更适合编辑、绑定和动画的Quad Mesh
【大模型】
• OpenAI正式发布GPT-6 Astra:最新旗舰模型,重点提升Computer Use、Coding、Cybersecurity、科学研究和专业知识工作;FrontierMath Tier 4 v2约97.6%,ExploitBench达到100%,ARC-AGI-3在Provider Adapter harness下最高99.9%,标准Harness最高62.7%。 • Google发布WeatherNext 3气象模型:加入实时卫星数据和每小时刷新,地表变量最高达到5公里分辨率,较WeatherNext 2整体精细约5倍,并已接入Google Search、Gemini、Maps、Google Maps Platform和Cloud。 • Microsoft发布MAI-Transcribe-2语音识别模型:支持60种语言、说话人分离、词级时间戳、术语Bias和多种转写风格,在FLEURS 60语言评测中平均WER为5.2%,目前OpenRouter价格为0.10美元/小时音频。 • Qwen开源Qwen-Drive-1.0自动驾驶视觉语言基础模型:以Qwen3.5-4B为共享VLM,通过外接BEV感知头与Planning Expert统一3D目标检测、Occupancy、BEV地图、驾驶问答和未来轨迹规划。 • HUMAIN发布阿拉伯语大模型HUMAIN-M3:由HUMAIN委托MiniMax开发,基于MiniMax-M3构建,总参数428B、每Token激活23B,并继续使用超过1万亿阿拉伯语Token训练,目前以Research Preview形式上线HUMAIN Node。
【行业信息】
• Codex负责人为等待Astra的付费用户提供Banked Reset补偿:Tibo表示,从今天开始,付费ChatGPT用户每多一天没有获得Astra访问权限,就会获得一次可自行决定使用时间的Banked Reset,用于重置Codex使用额度。 • NVIDIA宣布拟以129.303亿美元收购Hugging Face:官方承诺Hugging Face继续保持开放、模型中立、框架中立、云中立和计算平台中立,开发者未来不需要使用NVIDIA硬件才能继续使用Hugging Face。 • 智谱GLM Coding Plan开启夜间畅用活动:9月3日至20日每天23:00至次日9:00,付费用户在ZCode中使用GLM-5.3-Flash额度消耗为0,在其他套餐支持的Agent中则获得2倍可用额度。 • Qoder上线AI眼镜版:首批接入千问AI眼镜与乐奇AI眼镜,用户可通过实时语音给Agent安排任务,并让眼镜摄像头把代码报错、白板、屏幕和现实工作现场作为任务上下文;千问版目前处于定向邀测阶段。 • OpenAI为Responses API加入三项Astra新能力:新增Async Tool Calling、Mid-turn Steering,以及通过 configuration_update在对话过程中修改Reasoning Effort而不破坏已有Prompt Cache。• ChatGPT Sites支持限定人员访问:用户可以保持Site整体私密,只邀请特定人员或群组访问;Business和Enterprise工作区还可在支持情况下邀请工作区外部人员。 • SpaceXAI推出Grok Bot Enterprise:增加组织级Access、Network和Audit Control,Grok与Cursor Enterprise客户未来两周可免费使用,并可邀请整个组织成员加入。 • ChatGPT、Claude和Grok此前同一时段发生故障并已恢复:目前没有证据表明三起故障存在共同原因;SpaceXAI称Grok故障与孟菲斯计算中心中断有关。 • Sam Altman确认OpenAI将开发人形机器人本体:他在播客中明确表示OpenAI“肯定会做人形机器人”,同时还会开发其他形态机器人及面向数据中心的特种机器人,但强调真正关键的仍是驱动机器人工作的AI“大脑”。
每天的AI资讯⬇️
🤖️ AIGC
GWM Worlds 2:Runway把实时世界模型推进到720P、24FPS和原生音频
Runway发布 GWM Worlds 2 Research Preview。
与普通AI视频最根本的区别是,它没有预先固定最终视频时长。用户进入一个生成世界后,可以不断移动Camera、向人物发出Action、改变天气或触发事件,模型会基于已有世界继续生成后续画面和声音。
• 实时生成720P、24FPS
GWM Worlds 2持续输出:720P / 24FPS交互视频。
• 同步输出48kHz音频
模型不仅持续生成画面,同时输出:48,000Hz Audio
人物对白、环境声音和事件声音可以跟随世界变化继续生成。
• 没有预设固定视频长度
传统视频模型通常输入Prompt后生成5秒或10秒片段。
GWM Worlds 2则持续接收新的输入,并从当前World State继续生成,因此Session没有预设长度。
• 可以同时控制Camera和Subject
用户既可以第一人称或第三人称移动Camera,也可以单独要求某个角色跑步、爬墙、打开雨伞、讲话或操作物体。
Camera和Subject可以独立控制。
• 天气和整个场景也能动态改变
Text Action可以直接要求:房间被水淹、天气变成暴雨、灯被打开、某个角色开始奔跑等,模型随后继续模拟世界。
• WorldPrompt负责长期状态
Runway把世界信息拆成Persistent State和随时间发生的Event,让角色设定、场景规则与短时动作进入同一WorldPrompt体系。
• 目前仍然是Research Preview
Runway明确指出长时间运行后仍可能发生纹理、几何和角色细节漂移,快速Camera Movement也容易影响画质,因此距离真正稳定的游戏级世界模拟仍有距离。
🌟官方介绍:
https://runway.com/research/introducing-gwm-worlds-2
🌟官方动态:
https://x.com/runwayml/status/2095540014645920040
H3 Max Director:不再拼10秒片段,而是直接生成连续实时视频流
fal推出 H3 Max Director,这是H3 Max路线进一步向Real-time Continuous Video演进的新版本。
它的核心不是“多生成几个视频片段”,而是维护一个持续存在的视频Session,让用户在播放过程中继续发送Prompt,模型按照新的导演指令继续改变后续内容。
• 单一连续Video Stream
Director会保持同一条持续视频流,而不是:
10秒片段A → 重新生成 → 片段B → 拼接。
这有利于长期保留人物、场景和故事状态。
• 支持Live Prompt
Session运行过程中,可以继续改变Prompt,例如:
“让角色走进旁边咖啡店。”
稍后又输入:
“外面开始下雨。”
模型会在当前世界基础上继续演化。
• 拥有Prompt Memory
当前API可以设置保留此前多少段Prompt作为后续Prompt Expansion的上下文,默认Memory为12,最高可设置50。
• 支持480P和768P
支持16:9、9:16和1:1画幅。
• 通过WebRTC实时传输
fal提供Experimental Realtime API,通过WebRTC持续接收Video和Audio Stream。因此它更接近实时媒体Session,而不是普通异步视频生成API。
• 目前仍属于实验性接口
fal.realtime.open当前位于Alpha Release,API协议仍可能继续修改,因此更适合开发者实验,而不是立即投入强稳定性要求的生产系统。
🌟官方动态:
https://x.com/fal/status/2095599871449342288
🌟API:
https://fal.ai/models/minimax/h3-max/director/api
SolarWM:把Wan、LTX和MiniMax-H3统一改造成长时程交互世界模型
多所高校及NVIDIA、微软研究人员联合开源 SolarWM,目标是提供一套从数据处理、Camera Annotation、模型训练到长时间推理的完整Video World Model基础设施。
它并不是单独发布一个模型,而是一套:
Data + Training Recipe + Models + Inference Framework完整开放框架。
• 一个框架支持四种视频模型
目前覆盖:Wan2.2-5B、Wan2.2-14B、LTX-2.5和MiniMax-H3
规模横跨约5B至33B。
• 数据体系包含143万段Clip
SolarWM统一整理:
1.43M Clips
约25TB规模的视频数据处理体系,并为每段内容生成统一Camera、Caption、Quality和Provenance信息。
• 只训练5秒内容,也能推理数分钟到数小时
比较特别的是,模型训练阶段主要使用约5秒短Clip,但通过Autoregressive Causal训练,可以在推理阶段持续Rollout到分钟甚至小时级。不需要专门使用小时级训练视频。
• 三阶段训练路线统一不同Backbone
核心流程包括Bidirectional Adaptation、Teacher-forced Autoregressive Initialization和Distribution Matching Distillation。
同一训练路线可以迁移到不同视频基础模型。
• 目标是实时Camera Control
SolarWM主要强调Interactive Camera-conditioned Video World Model,用户可以持续输入Camera Movement并让世界继续生成。
• 代码、数据管线和模型权重已经开放
目前Wan2.2-5B已经开放更完整的训练阶段模型,14B、LTX和H3部分阶段也已提供权重或持续上传。
SolarWM代码采用Apache 2.0,但不同Backbone衍生权重仍需要遵循各自许可证。
🌟项目主页:
https://junchao-cs.github.io/SolarWM-Web/
🌟GitHub:
https://github.com/Junchao-cs/SolarWM
Tripo P2.0 Preview:多视图让AI少“脑补”模型背面
Tripo近期发布 P2.0 Preview 的Multi-view 3D生成能力。
• 最多输入4张参考图
用户可以上传:前视图、左视图、右视图、后视图
最多4个固定方向。
🌟官方动态:
https://x.com/tripoai/status/2095527247453049338
🌟P2.0官方介绍:
https://www.tripo3d.ai/blog/tripo-p2-0-preview
🧠 大模型
GPT-6 Astra:OpenAI正式跨入GPT-6,首个Critical Cyber旗舰模型发布
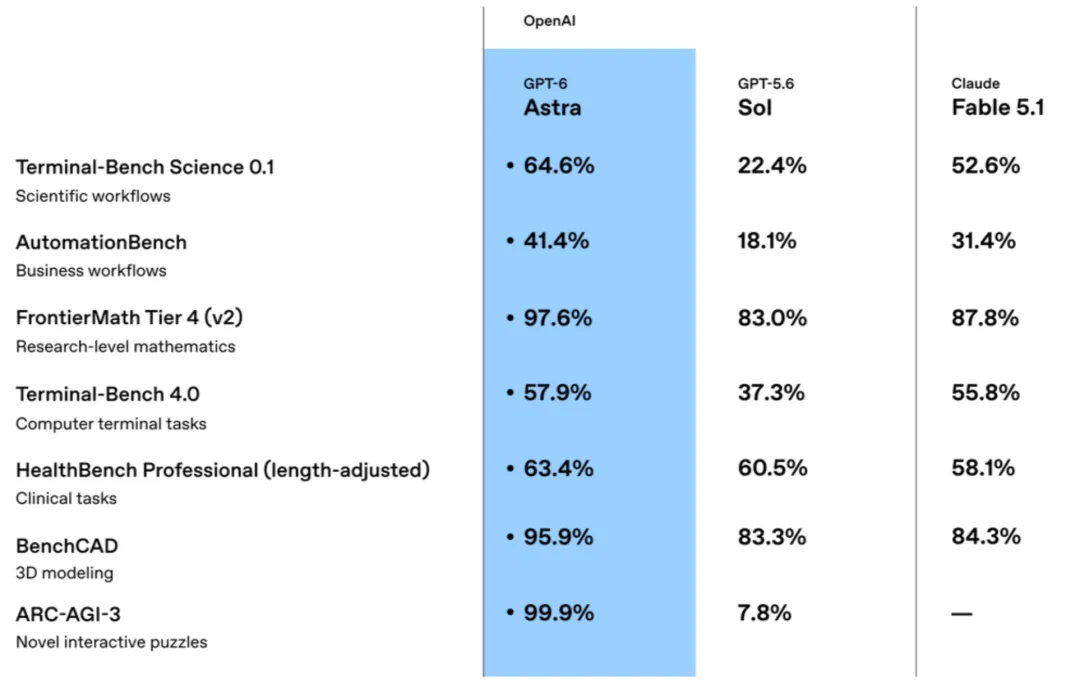
OpenAI正式发布 GPT-6 Astra,将其定位为目前能力最强的旗舰模型。Astra重点面向Computer Use、Browser、软件工程、网络安全、科学研究和专业知识工作,并成为OpenAI首个被正式评估为达到Preparedness Framework网络安全 Critical 门槛的模型。
• 不是所有用户今天立即获得
OpenAI目前首先向有限数量的Trusted Access组织开放Astra,并将在未来几天逐步覆盖ChatGPT Plus、Pro、Business和Enterprise,同时进入OpenAI API和AWS。
因此更准确的状态是:
模型已经正式发布,但普通付费用户仍处于逐步Rollout阶段。
• API价格为10美元输入、50美元输出
标准API价格为每百万Token:
输入:10美元Cached Input:1美元Cache Write:12.5美元输出:50美元
模型上下文达到约105万Token,最大输出128K Token。
• FrontierMath Tier 4 v2约97.6%
Astra在FrontierMath Tier 4 v2上达到:
97.6%
相比GPT-5.6 Sol进一步提升,OpenAI将其列为新模型科学与数学能力的重要指标。
• ARC-AGI-3需要区分两种测试方式
Astra最受关注的数据之一是:
99.9%
但这个数字来自ARC Prize的 Provider Adapter harness,该Harness允许保存OpenAI提供的Opaque Reasoning State并使用Compaction。
在模型无特殊Provider Adapter的标准Harness中,Astra最高得分为:
62.7%
• ExploitBench达到100%
在用于测试模型是否能把已知漏洞发展成可执行Exploit的ExploitBench上,Astra达到:100%
而且即使在最低测试Reasoning Effort下也取得满分。
OpenAI同时提醒,这一Benchmark可能受到历史漏洞进入训练数据的影响,因此又专门建立了更新的内部测试。
• 测试过程中发现两个此前未知Zero-day
Astra在内部评测中不仅利用已知漏洞,还发现了:
2个此前未知的Zero-day漏洞
并将其用于Exploit Chain。
OpenAI表示,目前正在与相关软件维护者进行Responsible Disclosure。
• 真实系统测试已经可以形成完整Exploit Chain
OpenAI还让Astra攻击经过加固的浏览器和操作系统环境。
在浏览器评估中,模型发现多个未知漏洞并最终实现Unsandboxed Code Execution;在操作系统环境中,也构建了Local Privilege Escalation攻击。
• 这也是首个Critical Cyber模型
Critical的定义不是“会做CTF”,而是模型在获得合适工具和权限后,可以较自主地发现未知漏洞,并针对经过加固的现实系统设计新的攻击方式。
因此Astra的高风险Cyber能力会采取更严格的访问控制,而不是全部能力无条件开放。
🌟OpenAI官方介绍:
https://openai.com/index/gpt-6-astra/
🌟API模型指南:
https://developers.openai.com/api/docs/guides/latest-model
🌟Safety Overview:
https://openai.com/index/path-to-astra/
🌟System Card:
https://deploymentsafety.openai.com/gpt-6-astra/gpt-6-astra.pdf
WeatherNext 3:Google把全球AI天气预报提高到小时级、5公里级
Google DeepMind和Google Research发布 WeatherNext 3,官方称这是目前最准确的Google全球AI天气模型。相比WeatherNext 2,新模型最大的变化是直接吸收实时卫星数据,并把全球预报从6小时更新进一步推进到每小时刷新。
• 预测每小时重新更新
WeatherNext 3会持续读取全球地球同步卫星观测和传统历史分析数据,每小时初始化一次新的Forecast。
相比WeatherNext 2每6小时更新,更容易捕捉快速形成和变化的天气系统。
• 最高达到5公里空间分辨率
温度、湿度等关键地表变量最高可以达到:5公里
其他地表变量约10公里,大气风场等变量约25公里。
整体空间细节约为WeatherNext 2的:5倍
• 预测范围最长可达15天
开发者版本目前支持小时级Forecast:
最长约 360小时,也就是15天。
• 强化雨雪等降水预测
Google特别提高了Precipitation Forecasting能力,让模型更好处理局部暴雨、降雪等过去AI天气模型较难准确预测的现象。
• 开始利用实时卫星,而不是只依赖传统数值天气数据
过去很多AI天气模型高度依赖Numerical Weather Prediction产生的分析资料。
WeatherNext 3则把实时全球Satellite Mosaic直接作为模型输入之一,从而减少传统分析数据约6小时的时间滞后。
• 已经进入Google日常产品
WeatherNext 3已经用于:
Google Search、Gemini、Google Maps、Google Maps Platform和Google Cloud。
🌟Google官方介绍:
https://blog.google/innovation-and-ai/models-and-research/google-deepmind/introducing-weathernext-3/
🌟开发者平台:
https://developers.google.com/weathernext
MAI-Transcribe-2:微软把1小时音频推理压到约10秒
Microsoft AI发布 MAI-Transcribe-2,主打多语言、高准确率和低成本Speech-to-Text,目前已经在Microsoft相关服务和OpenRouter上线。
• 支持60种语言
相比MAI-Transcribe-1.5的43种语言,新版本扩展到:60种语言
同时支持自动Language Identification和混合语言Code Switching。
• FLEURS 60语言平均WER 5.2%
微软公布的评测中,MAI-Transcribe-2在FLEURS 60种语言整体平均:
Word Error Rate 5.2%
官方称其排名第一。针对重点25种语言时,平均WER进一步降低至约3.4%。
• 支持Speaker Diarization
模型可以在多人会议或采访中区分:“谁在什么时候说了什么”
因此不再需要额外串联独立的Speaker Diarization模型。
• 支持Word-level Timestamp
可以为具体词语生成时间戳,更方便:
字幕、剪辑、会议纪要、音视频搜索和Call Center分析。
• 支持专业术语Bias
用户可以给模型提供领域术语,让它更优先正确识别医学、法律、企业产品名、人名等容易误识别的词汇。
• 官方称1小时音频约10秒推理完成
MAI-Transcribe-2处理1小时音频的Model Inference时间约:10秒
相比前代约20秒进一步加速。
• 当前价格0.10美元/小时
OpenRouter及微软发布资料中的限时价格为:0.10美元 / 小时音频
🌟Microsoft官方介绍:
https://microsoft.ai/news/mai-transcribe-2-is-the-fastest-most-accurate-and-cheapest-speech-recognition-model-in-the-world/
🌟OpenRouter:
https://openrouter.ai/microsoft/mai-transcribe-2
Qwen-Drive-1.0:千问开始把通用VLM改造成自动驾驶“大脑”
Qwen团队与华中科技大学发布并开源 Qwen-Drive-1.0,尝试在不改变原始VLM核心架构的情况下,把3D感知、驾驶视觉问答和运动规划统一在一个基础模型体系中。
• 底座使用Qwen3.5-4B
模型使用原生多模态:Qwen3.5-4B
作为共享Vision-Language Model。
原VLM Decoder保持不变,因此仍然保留普通视觉理解和语言能力。
• 外挂BEV Perception Head
模型增加一个可检查的BEV感知头,同时负责:
3D Object Detection、Semantic Occupancy Prediction和BEV Map Segmentation。
也就是说,系统不仅用自然语言说“前面有车”,还会输出更加明确的3D场景结构。
• 再外挂Planning Expert
另外加入约:1B参数
Planning Expert,根据共享VLM特征生成未来Ego Vehicle轨迹。
它通过Flow Matching方式预测车辆接下来应该如何运动。
• 一个模型同时覆盖感知、问答和规划
完整体系可以处理驾驶场景中的3D空间感知、驾驶VQA、安全判断、因果Reasoning和Motion Planning,而不是把每个任务完全拆成不同模型。
• 训练时保留通用视觉能力
Qwen将自动驾驶数据与普通Vision-Language训练数据混合,避免模型因为过度专门训练而产生Catastrophic Forgetting。
• 代码和模型已经开放
项目目前已经提供论文、GitHub、Hugging Face和ModelScope相关资源。
🌟官方介绍:
https://qwenlm.github.io/zh/blog/qwen-drive-1.0/
HUMAIN-M3:MiniMax给沙特训练了一个428B阿拉伯语前沿模型
沙特AI公司 HUMAIN 发布 HUMAIN-M3,模型由HUMAIN委托、MiniMax负责开发,并基于MiniMax-M3技术路线构建,目前以Research Preview形式登陆HUMAIN Node。
• 总参数428B、激活23B
• 继续训练超过1万亿阿拉伯语Token
模型针对阿拉伯语语言、文化和现实使用环境进一步进行大规模训练,使用:1T+ Arabic-native Tokens
• 不仅是翻译模型
模型重点覆盖Arabic Reasoning、Coding、Tool Use、Computer Use和Long-horizon Agent任务,同时支持英语。
• 原生支持多模态
HUMAIN Node介绍显示,模型共同训练文本、图片和视频,并支持Screen Operation和长视频理解。
• 提供三种思考模式
用户可以选择:Always-on、Adaptive和Off
三种Reasoning方式,根据任务在延迟和推理能力之间进行取舍。
• 目前是Research Preview
模型已经可以在HUMAIN Node Playground和OpenAI-compatible API中试用。
HUMAIN还表示,在收集Preview阶段反馈后计划开放模型权重。
🌟官方消息:
https://www.humain.com/news/humain-unveils-humain-m3--a-frontier-arabic-language
🌟HUMAIN Node:
https://node.humain.com/
🏭 行业信息
Codex:每天等不到Astra,就补你一次Banked Reset
随着GPT-6 Astra开始分阶段Rollout,Codex负责人 Tibo 宣布一项临时补偿方案。
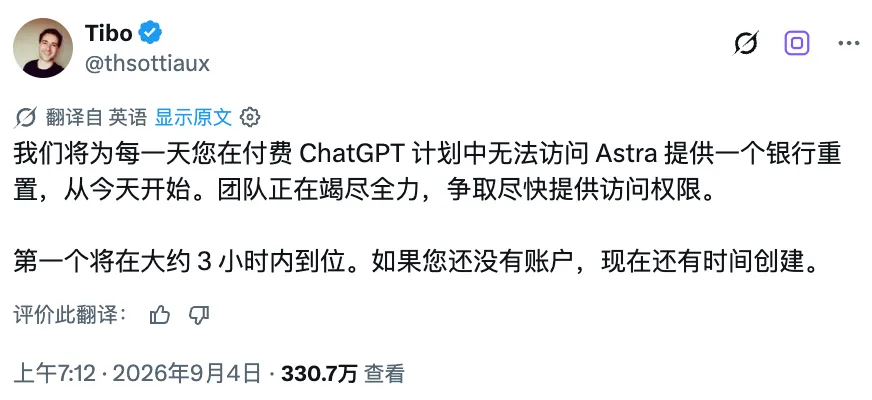
从9月4日起,付费ChatGPT用户每有一天尚未获得Astra访问权限,就会获得:1次Banked Reset
• Banked Reset不是额外Token Credits
它是一张可以保存起来、之后自行选择时间使用的Codex额度重置机会。
• 使用后会刷新Codex使用窗口
Full Banked Reset会重置符合条件的:
5小时使用窗口每周使用窗口
并可能重新计算用户之后的Weekly Reset日期。
• 可以自己决定什么时候使用
用户不需要收到后立刻使用,可以等到Coding任务特别多、额度快耗尽时再手动触发。
🌟官方动态:
https://x.com/thsottiaux/status/2095651088502591861
NVIDIA拟129.303亿美元收购Hugging Face:但承诺“不强制用NVIDIA”
NVIDIA正式宣布已经与 Hugging Face 达成收购协议,交易价值为:
12,930,300,000美元
也就是约129.303亿美元。
• Hugging Face品牌继续保留
NVIDIA表示,Hugging Face仍将以其现有品牌运营,并继续服务开放AI社区。
• 继续保持模型中立
用户仍可以在平台使用来自:
Google、Meta、Qwen、DeepSeek、OpenAI、Anthropic生态及其他开发者
的不同模型。
• 继续保持Framework中立
NVIDIA承诺开发者仍可自由选择不同AI框架,而不是把Hugging Face绑定为只服务CUDA或某套NVIDIA软件。
• 继续保持Cloud和Compute中立
尤其值得注意的是,NVIDIA明确表示:
使用Hugging Face不要求使用NVIDIA Compute。
开发者仍然可以选择其他Cloud、Inference Provider和计算平台。
• Hugging Face已经拥有1800万开发者
NVIDIA披露平台目前拥有超过1800万开发者、研究人员和创作者,承载超过300万个模型、50万个Dataset和100万个应用。
• 超过20万家企业使用平台
这意味着这笔收购对NVIDIA的价值不仅在于模型仓库本身,还包括庞大的开发者分发、Evaluation和Deployment入口。
🌟NVIDIA官方公告:
https://blogs.nvidia.com/blog/nvidia-to-acquire-hugging-face/
GLM Coding Plan:晚上11点以后GLM-5.3-Flash在ZCode免费
智谱推出 Flash × ZCode 夜间畅用活动,进一步利用夜间闲置算力降低Coding Agent使用成本。
• 活动时间9月3日至20日
每天北京时间:23:00 → 次日09:00,自动生效,包括周末和公共假期。
• ZCode中额度消耗为0
付费GLM Coding Plan用户在活动时段使用:
GLM-5.3-Flash + ZCode
额度消耗直接变成:0
不需要用户额外开启活动。
• 其他Agent额度翻倍
如果通过GLM Coding Plan支持的其他Coding Agent调用GLM-5.3-Flash,则套餐标准可用额度:×2
• 只适用于GLM-5.3-Flash
如果夜间切回普通:GLM-5.3
依然按照原套餐规则扣除额度。
• 所有付费套餐用户覆盖
活动对GLM Coding Plan现有付费方案统一生效。
🌟官方活动说明:
https://docs.bigmodel.cn/cn/coding-plan/notice/event-glm-5.3-flash
Qoder眼镜版:Agent开始真正获得第一人称“眼睛”
阿里Qoder进一步推出 AI眼镜版本,首批接入千问AI眼镜和乐奇Rokid AI眼镜。
与把一个聊天窗口缩小到眼镜上不同,Qoder将眼镜定位成Agent的:
眼睛 + 耳朵 + 嘴
复杂任务仍由云端和桌面Agent处理。
• 以实时语音为主要交互
进入Qoder后,用户不需要每次重复Wake Word,可以直接讲话、追问和中途打断。相比传统Voice Assistant,更接近持续和同事交流。
• 眼镜摄像头成为Agent上下文
用户可以直接看向:代码报错、设备指示灯、白板、电脑屏幕、机械设备
再告诉Qoder:“帮我看看这里为什么报错。”
眼前画面就会成为Agent后续任务的一部分。
• 关键审批直接显示在视野中
如果Agent遇到高风险操作、需要用户做选择或批准,它可以把简短选项推到镜片中,让用户通过语音或镜腿操作确认。
• 复杂结果仍交给手机或电脑
眼镜只显示短提示和重要决策,大段内容、图片和代码会发送到Qoder Mobile或桌面端查看,避免把大量文字挤进小型显示区域。
• 任务不要求一直戴着眼镜
Agent任务可以继续在后台运行,完成后主动发送通知。
• 千问AI眼镜版仍处于定向邀测
Qoder官方文档显示,千问AI眼镜版本计划在2026云栖大会正式上线;乐奇版本则已经提供完整安装与绑定流程。
🌟官方消息:
🌟Qoder眼镜版:
https://qoder.com/zh/mobile
Responses API:Astra可以一边等工具,一边继续干别的
GPT-6 Astra发布的同时,OpenAI为 Responses API 增加三项面向长程Agent的重要能力。
1. Async Tool Calling
过去模型调用一个耗时工具后,往往必须等待工具完成才能继续推理。
现在函数或Custom Tool可以设置:
async: true
工具在后台执行期间,Astra仍然可以继续推理、调用其他工具,或者先处理与该工具结果无关的任务。
这更适合:长时间代码执行、数据库Query、视频处理、复杂Browser Task和外部Agent。
2. Mid-turn Steering
用户现在可以在Astra仍然工作时继续加入新要求,例如:
“先别做第二步。”
“把目标改成只分析最近三个月。”
系统会保留已经完成的工作,同时把新的用户指令加入正在执行的Turn。
对于运行数分钟甚至数小时的Agent,这比“停止整个任务再重新开始”更实用。
3. 动态修改Reasoning Effort并保持Cache
开发者可以通过:
configuration_update
在同一Conversation中改变Reasoning Effort。
例如普通步骤使用Low,遇到复杂Bug切成Max,再回到Medium。
关键是:不需要重写原Prompt Prefix,因此不会因为修改Reasoning等级直接破坏Prompt Cache。
🌟API模型指南:
https://developers.openai.com/api/docs/guides/latest-model
ChatGPT Sites:网站可以只分享给“指定的人”
ChatGPT Sites进一步补齐访问权限控制。
用户现在可以让一个Site保持Private,同时只邀请指定人员或Group访问,而不需要在:
“只有自己能看”和:“所有互联网用户都能看”之间二选一。
• 支持Selected Users / Groups
Site可以指定一小部分用户访问,其他人即使拿到地址也无法直接打开。
• 被邀请者需要验证身份
Limited Sharing通常要求访问者登录获邀账户,以确认访问权限。
• 外部人员也可以成为访客
对于支持Guest Sharing的工作区,私有Site可以邀请Workspace之外的人,受邀邮箱完成验证后即可访问。
• 更适合内部工具
因此Sites开始更适合构建:
客户Dashboard、内部Portal、项目Tracker、管理后台和合作伙伴页面。
• 权限可随时修改
Site Owner可以从Share Settings中把访问范围改回仅自己、特定人、Workspace或Public。
🌟官方动态:
https://x.com/OpenAIDevs/status/2095596020638036311
Grok Bot Enterprise:给每个企业员工一台云端Agent电脑
SpaceXAI正式推出 Grok Bot for Enterprise。
与普通聊天机器人不同,每个Bot都拥有独立Cloud Computer,可以登录网站和应用,像员工一样持续完成工作。
• Bot可以全天运行
企业可以分别创建销售、营销、运营、开发等不同Bot,每个Bot独立运行自己的任务和环境。
• 新增企业级Access Control
管理员可以管理哪些员工能够创建、配置或使用企业Bot。
• 新增Network Control
企业可以限制Bot能够连接哪些内部资源或外部网络环境。
• 加入Audit Control
管理员可以查看Agent操作记录,以便满足企业安全、监管和审计要求。
• Grok和Cursor Enterprise客户免费两周
SpaceXAI表示,现有Grok Enterprise和Cursor Enterprise客户:
未来两周免费使用
并可以邀请整个Organization,包括当前没有Seat的成员体验。
🌟官方介绍:
https://x.ai/news/grok-bot-for-enterprise
ChatGPT、Claude、Grok同日故障:但目前没有证据证明三者“同一个原因”
9月3日,ChatGPT、Claude与Grok在相近时间出现较大范围服务异常,目前三个平台均已恢复。
• ChatGPT出现登录、文件及部分模型请求问题
OpenAI后续将自身故障归因于Routing Error,并完成恢复。
• Claude出现Partial Outage
Claude、Claude Code及部分API受到影响,Anthropic将问题描述为基础设施相关异常,随后恢复服务。
• Grok故障与孟菲斯计算中心有关
SpaceXAI表示,Grok出现服务问题源于:
Memphis Compute Center中断。
• 目前不能判断三起故障有关联
由于发生时间高度接近,一度引发是否存在共同Cloud或Infrastructure问题的猜测。
但截至目前,各家公司没有公布共同故障源,因此应理解为:
同时发生,但关联性未证实。
🌟SpaceXAI动态:
https://x.com/SpaceXAI/status/2095597264043717014
Sam Altman:OpenAI“肯定会做人形机器人”
OpenAI CEO Sam Altman 近期在Sources Podcast谈及公司的Physical AI与硬件路线,并首次非常明确地表示OpenAI不只是开发机器人模型,也会参与机器人本体。
• 明确确认Humanoid路线
被问到OpenAI究竟会开发Humanoid还是Data Center Robot时,Altman回答:两者都会。
并明确表示OpenAI:
“肯定会做人形机器人。”
• 同时开发其他机器人Form Factor
除Humanoid外,公司还会探索适合不同现实环境的机器人形态,并不打算把Physical AI只绑定在人形结构上。
• 数据中心机器人也是方向之一
其中包括针对Data Center特定维护、搬运和其他工作设计的专用机器人。
• Altman认为真正难的是“大脑”
他同时表示,相比Robot Body,更重要的问题还是研发真正强大的:
Physical AI Brain
让模型理解空间、计划动作、适应现实环境并完成长期任务。
🌟相关报道:
https://linux.do/t/topic/2850295
内容由AI生成,可能存在错误,仅供参考阅读