ARTICLE · 1007070
文档版面解析:从 PDF 与扫描件到带结构的多模态元素
文档版面解析:从 PDF 与扫描件到带结构的多模态元素
你接手过一个需求:把公司近三年的行业研究报告灌进知识库。这些报告是投行风格的 PDF,双栏排版,每页夹着两三张图表,还有跨页的数据大表。你信心满满地跑了一版解析,抽样一看傻眼了——正文句子东一句西一句像是被打乱重拼,一张本该有 12 个月数据的表格只剩上半页 7 个月,页脚的"本报告仅供内部参考"混进了表格第一行,图表则连影子都没有。
这不是解析器坏了,是它做的事和你以为它做的事根本不是一回事。大多数 PDF 解析器默认干的是"把页面上的字符按某种顺序倒出来",而你需要的是"把这一页拆成结构清晰、归属明确、顺序正确的元素"。这两件事在纯文字单栏文档上恰好等价,所以很多人没意识到区别;一旦文档有了栏、有了表、有了图,两者就彻底分道扬镳。
文档版面解析是多模态理解层的第一步,也是决定整条链路信息保真度的地基。上一步(原始文档)到这一步的转换质量,直接决定了后面 VLM 抽取、编码、检索能拿到什么样的原料。这篇文章要把这一步拆透:解析到底要产出什么、版面分析和阅读顺序怎么做、OCR 和表格结构识别的边界在哪、主流工具链怎么选,以及最关键的——怎么判断你的解析结果到底对不对。
先纠正一个普遍的认知误区:很多人把"文档解析"等同于"PDF 转文本",觉得这是个已经被解决的、调个库就行的问题。这个误解害人不浅。PDF 转文本在纯文字文档上确实解决了,但那只覆盖了企业文档里最简单的一小部分。真实场景里,解析要处理的是版面、表格、图表、扫描件、多语言、公式的混合体,每一样都是独立的技术难题。把解析当成"调库"来对待的团队,往往在原型阶段跑得很顺(因为测试用的都是简单文档),一到生产接入真实文档就全面崩溃。解析层的复杂度,是多模态知识系统里最容易被低估的部分。
还有一个更隐蔽的陷阱:就算是有文本层的电子版 PDF,也不代表能直接拿文本用。PDF 的文本层本质是"一堆带坐标的字符片段",它们在文件里的存储顺序由生成 PDF 的软件决定,未必等于人的阅读顺序。双栏排版的电子 PDF,字符片段可能是先存完整页左半、再存右半,也可能左右交替存——直接按存储顺序读出来,同样会得到错乱的正文。所以"有文本层"只帮你省掉了 OCR 这一步,阅读顺序恢复、版面结构判断这些活一样都少不了。很多人误以为"电子 PDF = 干净文本",结果在双栏电子研报上栽了跟头,就是没意识到这一层。判断有没有文本层,和判断解析对不对,是两个独立的问题。
解析要产出的不是文本,而是带结构的元素集合
先把目标定清楚,否则后面所有技术选择都没有靶子。一个合格的版面解析,输出不应该是一坨字符串,而应该是一组结构化元素,每个元素至少携带四类信息。
有了这个目标,就能反推解析要干四件事:检测元素(找出页面上有哪些块,每块是什么类型)、恢复阅读顺序(这些块该按什么顺序读)、抽取内容(文本块出文字、扫描块出 OCR、表格出行列结构)、以及给图表留出裁剪好的图像交给下游。把这四件事画成一条流水线:
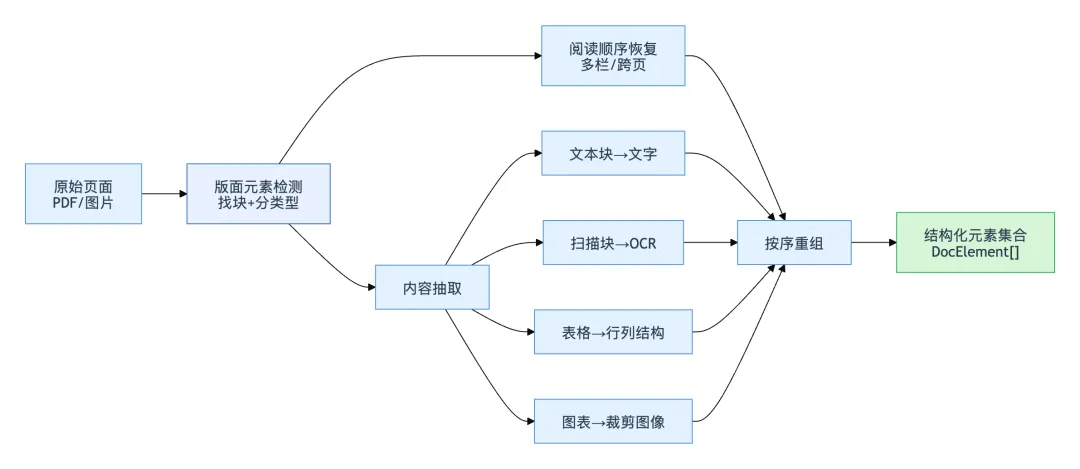
这条流水线里,元素检测是龙头——它错了,后面全错。如果检测把一张表当成普通文本块,那这张表就会被当文本抽取,行列关系立刻丢失;如果它漏掉了页眉页脚,那"仅供内部参考"就会混进正文。所以解析质量的第一决定因素不是 OCR 有多准,而是版面检测有多准。这个认知很重要,因为很多团队把精力全砸在 OCR 引擎上,却用一个粗糙的检测,结果地基歪了。
这里要特别强调四类属性里最容易被扔掉的一个——坐标 bbox。很多解析管线在抽完文字后就把坐标丢了,觉得"反正要的是文字内容"。这是个会在下游反噬的短视决定。坐标至少在三个环节不可或缺:阅读顺序判断要靠它算元素的空间关系,跨页拼接要靠它判断表格贴不贴页边,而到了检索的最后一公里——给用户展示答案出处时,要靠它在原文档上画出"答案来自这个框"的高亮引用。第六篇讲证据编排、第七篇讲可视化引用,用的都是这一步保留下来的坐标。解析阶段丢坐标,等于提前判了下游"可溯源"能力的死刑,而这个能力在企业场景里往往是刚需。所以一个务实的原则是:解析产出的每个元素都带着它的页码和 bbox 一路传下去,哪怕当前用不上,也别在源头丢弃。
元素类型体系也需要提前统一。不同解析工具吐出的类别名五花八门——有的叫 text,有的叫 paragraph,有的把标题细分成 title/section-header/subtitle。如果直接拿工具原始类别往下游传,一旦换个工具,下游所有判断类型的逻辑都得跟着改。合理做法是在解析层出口定义一套自己的标准类型枚举(比如统一成前面约定的 text/table/chart/figure/formula/header_footer),各家工具的原始类别在解析层内部就映射到这套标准枚举。这样下游只认标准类型,换解析工具时改动被限制在映射表里,不会扩散。这是一个小设计,但在解析工具频繁试错、经常换来换去的项目里,能省掉大量返工。
# 各解析工具的原始类别 → 统一标准类型枚举# 换工具时只改这张表,下游判断逻辑一律基于标准类型,不受影响CATEGORY_MAP = {# DocLayout-YOLO 风格"text": "text", "title": "text", "figure": "figure","table": "table", "isolate_formula": "formula",# unstructured 风格"NarrativeText": "text", "Header": "header_footer","Footer": "header_footer", "Image": "figure", "Table": "table",}defto_std_type(raw_category: str) -> str:# 映射不到就归为 text 并记日志,避免未知类别静默丢失 std = CATEGORY_MAP.get(raw_category)if std isNone: log.warning("未映射的解析类别: %s,暂按 text 处理", raw_category)return"text"return std这段映射看着琐碎,但它是解析层和下游之间的"防火墙"。有了它,"换个更准的表格模型"这种优化就能局部完成,不会因为新模型换了一套类别命名而波及整条链路。工程系统里,把易变的东西(第三方工具的接口习惯)挡在一个薄适配层后面,是控制改动半径的通用手法,解析层这里只是它的一个具体应用。
版面元素检测:把页面切成有类型的块
版面检测的本质是一个视觉目标检测任务:输入一张页面图,输出若干带类别的框。这几年主流做法分两条技术路线,各有取舍。
第一条是纯视觉检测模型,代表是 DocLayout-YOLO、PP-DocLayout 这类基于目标检测框架(YOLO/DINO)在文档版面数据集上训练的模型。它们把页面当图片,直接预测文本、标题、表格、图、公式等类别的边界框。优点是快、对扫描件和电子档一视同仁(都当图处理)、不依赖 PDF 内部结构。缺点是纯看视觉,对语义边界不敏感,偶尔会把两个紧挨的段落合成一块。
第二条是多模态版面模型,代表是 LayoutLMv3、LayoutXLM 这类同时吃文本、位置和图像三种输入的预训练模型。它们不仅看长什么样,还看字面内容和坐标关系,对"这块到底是标题还是加粗正文"这类需要语义判断的分类更准。代价是必须先有文本层(或先 OCR),推理更重更慢。
# 用视觉版面检测模型给一页图做元素检测(以 DocLayout 风格接口示意)from doclayout import LayoutDetectordetector = LayoutDetector(model="doclayout-yolo")elements = detector.detect("page_14.png")for e in elements:# 每个元素:类别 + 置信度 + 边界框print(e.category, round(e.score, 2), e.bbox)# 输出示例:# title 0.97 (72, 60, 520, 92)# text 0.95 (72, 100, 300, 480) ← 左栏正文# text 0.94 (320, 100, 548, 480) ← 右栏正文# table 0.93 (72, 500, 548, 700)# figure 0.91 (72, 720, 548, 900) ← 柱状图,交给下游 VLM拿到这些框之后有个关键判断要做:哪些类别走文本抽取,哪些必须交给专门处理。text、title 走文本;table 必须走表格结构识别(下一节讲);figure 不走文本,裁剪成图像交给第 3 篇的 VLM;header/footer 通常直接丢弃或单独存,不能混进正文。这个分流决策,就是理解层"按元素类型分模态处理"的起点。
选哪条路线,取决于你的文档特征。用一张表把选择依据摆清楚:
两条路线并非互斥,实践中还有一种"视觉检测打底 + 语义修正"的混合用法:先用快的视觉检测拿到大部分元素框,再对少数拿不准的分类(比如某块到底是二级标题还是加粗正文)用文本语义做二次判断。这样既保住了速度,又在关键的语义分类上借了多模态模型的准。工程上这种"快模型兜底 + 慢模型精修"的组合非常常见,本质是把有限的重计算花在真正需要的地方,和成本路由是同一套思路。
这里要提醒一个常见误判:不要因为"多模态模型更先进"就无脑选它。它慢、重、依赖文本层,对一个全是规整电子档的知识库是过度投入。检测这一步的工程原则和前面讲过的路由一致——能力匹配需求,不是越重越好。
版面检测真正难的不是常规版面,而是几类容易翻车的边界情况,值得单独拎出来说,因为它们决定了你的检测模型够不够用。第一类是紧邻元素粘连:两个段落间距很小,或表格紧贴正文,检测容易把它们框成一块,导致表格被当文本处理。第二类是嵌套元素:图里套着小表、表格单元格里有小图,检测框会互相重叠,需要处理框的包含关系。第三类是跨栏大元素:一个横跨两栏的大标题或大图,在多栏页面里会打断 XY-cut 的分栏假设。第四类是旋转和倾斜:扫描件常有轻微旋转,纯视觉检测对角度敏感,需要先做方向矫正。
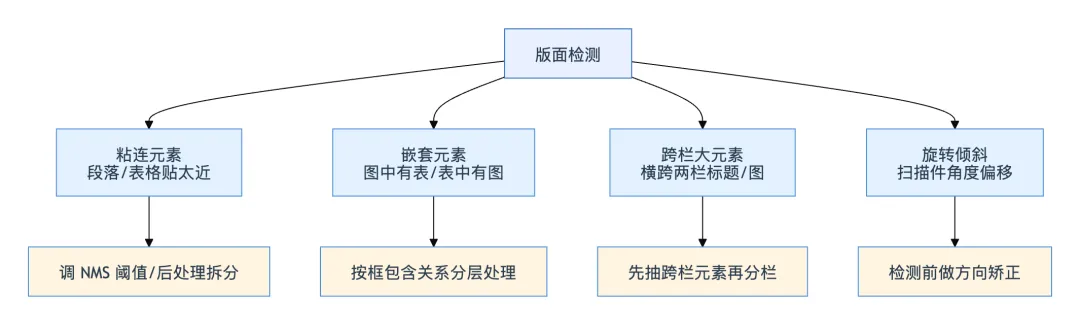
这四类边界情况的共性是:它们都不会在"规整测试文档"上暴露,只在真实业务文档里出现。所以评估检测模型时,一定要用你自己的真实文档抽样,而不是拿模型自带的 benchmark 数字当准绳。benchmark 上 95% 的准确率,到了你满是嵌套表和跨栏图的研报上,可能掉到 70%。这个差距,是很多团队上线后才痛苦地发现的。
阅读顺序恢复:多栏与跨页是两个硬骨头
检测出块之后,得决定它们的阅读顺序。单栏文档很简单,按 y 坐标从上到下即可。真正的难题是多栏排版和跨页表格。
多栏的经典解法是 XY-cut 递归切分算法:先找页面里的水平或垂直大空白(栏间距、段间距),沿空白把页面递归切成子块,直到不能再切,再按"先左后右、先上后下"的规则给子块排序。它的好处是无需训练、可解释、对规整多栏很稳。局限是遇到不规则版面(跨栏的大标题、浮动图框)会切错。
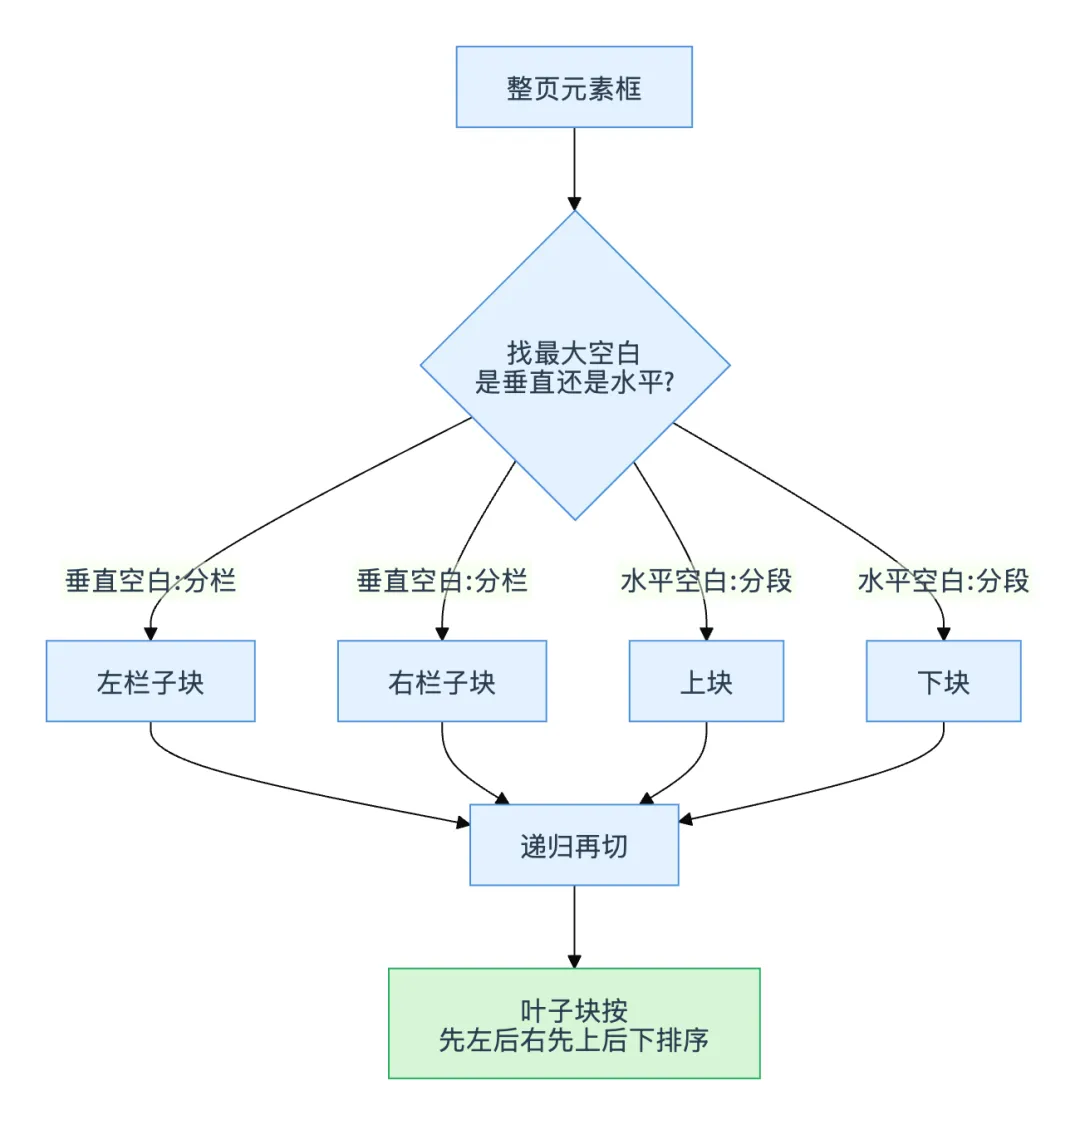
下面是 XY-cut 核心思路的简化实现,帮助理解它在干什么:
defxy_cut(boxes, axis=0):"""递归 XY-cut:axis=0 找垂直分割(分栏),axis=1 找水平分割(分段)"""iflen(boxes) <= 1:return boxes# 在当前轴上按投影找最大空白间隙 boxes.sort(key=lambda b: b.bbox[axis]) gaps = []for i inrange(len(boxes) - 1): gap = boxes[i+1].bbox[axis] - boxes[i].bbox[axis+2] # 后一块起点 - 前一块终点 gaps.append((gap, i)) max_gap, split_i = max(gaps, default=(0, -1))# 空白足够大才切,否则换个轴再试if max_gap < MIN_GAP:return xy_cut(boxes, axis=1-axis) if axis == 0else boxes left = xy_cut(boxes[:split_i+1], axis=1-axis) # 切开后换轴递归 right = xy_cut(boxes[split_i+1:], axis=1-axis)return left + right # 先左/上,后右/下# ── AI 视角 ──# "把所有文本块按 y 坐标排个序不就行了,为什么要这么复杂?"# ── 实际含义 ──# 按 y 排序会把左栏第一行和右栏第一行判成"同一行先后",# 于是左栏右栏交错输出,句子被拦腰缝合。# XY-cut 先识别出"这里有两栏",保证读完整个左栏再读右栏。跨页表格是另一个硬骨头,XY-cut 解决不了它——因为问题跨越了页边界,单页算法看不到全貌。它需要专门的页间拼接逻辑,本文后面单列一节展开。这里先记住一点:阅读顺序恢复不只是"页内元素排序",还包含"跨页元素的合并",两者都属于把离散元素重组成连贯文档这件事。
阅读顺序错了的危害是隐蔽的:抽出来的文字每个字都对,连起来却语义崩坏。它不会报错,只会让下游检索到一堆语法不通的句子。所以阅读顺序是解析质量评估里必须单独测的一项,不能只看"有没有抽到文字"。
XY-cut 也不是万能的,它有明确的失效场景,了解这些场景才能知道什么时候要换更强的方法。它的核心假设是"版面能被水平或垂直的大空白干净地递归切开"。当版面不满足这个假设时它就会出错:杂志式的自由排版(图文环绕、不规则栏宽)、表格和正文交错的复杂版面、以及栏间距和段间距接近导致切分点判断错误的情况。对这些复杂版面,业界的替代方案是用学习式的阅读顺序模型——把元素框和它们的特征喂给一个序列预测模型(如 LayoutReader),直接预测阅读顺序。它比 XY-cut 更能处理不规则版面,代价是需要训练数据、推理更慢、且在规整版面上未必比 XY-cut 更准。所以实践中常是"规整版面用 XY-cut,检测到复杂版面再降级到学习式模型",又是一次能力匹配需求的分层决策。
OCR 与表格结构识别:字符之外的两道关
对扫描件和图片型 PDF,文本块里没有文字层,得靠 OCR 把像素转成字符。现代 OCR(PaddleOCR、Tesseract、各家云 OCR)在印刷体上已经相当成熟,真正的难点在三个边界场景:公式、手写、多语言混排。
公式是重灾区。普通 OCR 会把 ∑ 读成"E"、把上下标拍平成同一行,一个积分公式出来变成一串没法读的符号。要正确处理公式,得用专门的公式识别模型(如 pix2tex/LaTeX-OCR)把它转成 LaTeX。手写体识别率明显低于印刷体,且强依赖训练数据覆盖。多语言混排(中英日夹杂)要求 OCR 引擎支持多脚本,否则非主语言部分会乱码。
这三类边界场景的处理策略不一样,值得分开说。公式的最佳实践是"检测阶段就把公式块单独标出来,走专用模型,绝不混进普通 OCR"——因为普通 OCR 对公式不是识别率低,而是从原理上就没法表达上下标和数学符号结构,再强的通用 OCR 也救不了。手写则是另一种困境:识别率天花板受限于训练数据,通用模型对潦草手写基本无能为力,工程上更现实的做法是接受它识别不准,把手写块标记为低置信并保留原图,让下游能回看原件,而不是假装读对了。多语言混排的关键是选对引擎——很多 OCR 默认只加载主语言模型,中文文档里夹的几个英文缩写会被强行按中文形状硬猜,结果全错。正确做法是显式开启多语言模式,或按检测出的语种分块调用对应模型。
这三种边界场景背后是同一个原则:解析层要诚实地区分"我能读准的"和"我读不准的",而不是对所有输入都输出一个看起来正常的结果。一份混了公式和手写批注的技术文档,理想的解析产出应该是:印刷正文高置信抽取、公式转成 LaTeX、手写批注标记低置信并附原图,三类内容各按各的可信度进入下游。把它们一视同仁地拍平成纯文本,才是最糟糕的选择——因为下游再也无法区分哪些字能信、哪些字是瞎猜的。
这里有个容易被忽视的工程细节:OCR 的置信度不能只看不用。很多团队拿到 OCR 结果直接全盘采信,把 0.6 置信度的疑似错字和 0.99 置信度的确定字一视同仁地送进索引。正确的做法是把置信度作为一等公民贯穿下去——低置信度的文本块要么标记为"待验证",要么触发二次处理(换更强的 OCR、或交 VLM 重读)。在合同、财务这类容错率极低的场景,一个被静默采信的 OCR 错字(把"不得转让"读成"不得转计")可能带来严重后果。置信度是解析层最重要的自我怀疑机制,丢掉它等于让系统盲目自信。
from paddleocr import PaddleOCRocr = PaddleOCR(use_angle_cls=True, lang="ch") # 支持中英,自动方向分类result = ocr.ocr("scanned_contract.png")for line in result: box, (text, conf) = line[0], line[1]# 关键:保留置信度,低置信度的 OCR 结果要标记为待验证if conf < 0.85: text = f"[低置信:{text}]"# 不能静默采信,可能是错字print(box, text, round(conf, 2))# 边界:公式/手写块置信度普遍偏低,应路由到专用模型而非硬 OCR表格结构识别比 OCR 更复杂,因为它不只要读字,还要还原二维结构:有几行几列、哪些是表头、有没有合并单元格、每个单元格里的值属于哪行哪列。这是一个专门的研究方向,代表模型有 TableFormer、PP-StructureV2 的表格识别模块、以及一些把表格转成 HTML 的端到端模型。它们的输出通常是 HTML 表格或带行列索引的结构化数据。
from paddleocr import PPStructuretable_engine = PPStructure(layout=False, table=True)res = table_engine("financial_table.png")for region in res:if region["type"] == "table": html = region["res"]["html"] # 表格被还原成 HTML,保留行列/合并# HTML 可再解析成结构化 dict,喂给下游做字段级检索print(html[:200])# ── AI 视角 ──# "OCR 已经把表格里的字都读出来了,直接当文本用就行"# ── 实际含义 ──# OCR 只给出"每个文字在哪个坐标",不给行列归属。# "35%"这个 OCR 结果,不知道它属于哪一行哪一列。# 表格结构识别才建立起"第2行第3列=35%"的二维映射,# 这是后面能精确回答"华东Q3毛利率"的前提。这两道关的共同特点是:它们都有明确的能力边界,且边界内外的处理策略完全不同。印刷体 OCR、规整表格在能力边界内,可以自动化;公式、手写、密集嵌套表格在边界外,要么上专用模型,要么标记低置信度交人工或交 VLM 兜底。识别出"这个元素超出了当前工具的能力边界",本身就是解析质量的一部分——静默地输出一个错误结果,比明确标记"这里我拿不准"危害大得多。
表格结构识别里最难啃的是合并单元格和多级表头。财务报表尤其喜欢用合并单元格——一个"2023 年"横跨 Q1 到 Q4 四列,下面再分季度。人眼一看就懂的层级,模型要正确还原成"这个值同时属于 2023 年这个大类和 Q3 这个小类"并不容易。多级表头(行表头 + 列表头交叉定位)也是同理。处理这类表格,输出格式的选择很关键:简单的二维数组表达不了合并和层级,所以主流做法是输出 HTML(用 rowspan/colspan 表达合并)或带层级路径的结构化格式。下面把表格从图像到可检索结构的完整转换画出来:

这条链路里,结构识别(第二步)和格内 OCR(第三步)是解耦的——先搞清楚有几行几列、谁合并了谁,再往每个确定的格子里填字。这个顺序不能反:如果先 OCR 再猜结构,就退化成了前面批评过的"有字符没结构"的老问题。先结构后内容,是表格识别区别于普通 OCR 的本质。
跨页表拼接:单页解析对了,整张表却是断的
表格识别做对了单页,还有一个专门的坑:一张表跨了两页甚至三页。财报的明细表、合同的条款表经常几十行排下来,翻到下一页继续。逐页解析时,每页都能被正确识别成一张"完整"的表——但它们其实是同一张表的上下两半。如果不做拼接,下游看到的是两张残表:上半张少了合计行,下半张没有表头。用户问"全年各季度合计是多少",命中的可能只是缺了合计行的上半张,答案自然不完整。
拼接的难点在于判断"这两页的表到底是不是同一张"。不能只看"都是表格"就拼——一页底部一张表、下一页顶部另一张不相干的表,硬拼就错得更离谱。可靠的判断要综合几个信号:下半张表是否在页面顶部(紧贴页眉之下)、上半张是否在页面底部、两张表的列数和列宽是否一致、下半张表的第一行是不是重复的表头。这几个信号里,列结构一致性是最强的证据。
deftry_merge_cross_page(table_a, table_b, page_h):"""判断相邻两页的表是否为同一张跨页表,是则拼接"""# 1. 位置信号:A 贴着页底,B 贴着页顶 a_at_bottom = table_a.bbox[3] > page_h * 0.85 b_at_top = table_b.bbox[1] < page_h * 0.15ifnot (a_at_bottom and b_at_top):returnNone# 位置不对,大概率不是同一张# 2. 列结构信号:列数一致 + 各列 x 边界对齐(最强证据)ifnot columns_aligned(table_a, table_b, tol=8):returnNone# 列对不上,是两张不同的表# 3. 重复表头处理:B 首行若与 A 表头相同,视为重印表头,拼接时丢弃 rows_b = table_b.rowsif is_same_header(table_b.rows[0], table_a.header): rows_b = table_b.rows[1:] # 去掉重印的表头,避免表头混进数据 merged = Table(header=table_a.header, rows=table_a.rows + rows_b) merged.bbox_pages = [(table_a.page, table_a.bbox), (table_b.page, table_b.bbox)] # 保留两页来源,供引用回溯return merged这里有两个容易忽略的细节。一是重印表头:很多跨页表会在续页重复一遍表头方便阅读,拼接时必须识别并丢弃,否则表头会变成一行数据混进结果。二是来源回溯:拼出来的表跨了两页,将来要在答案里标注"证据出自第 3-4 页",所以拼接后要保留两页各自的坐标,不能拼完就把来源信息丢了。这条信息在第六篇讲证据编排时会直接用到。
跨页拼接还和前面的增量解析有个耦合点:一张跨页表只要有一页变了,整张表都得重拼重入库,不能只更新变化的那一页。这也是前面增量处理表格里"跨页表变更要整表重跑"那条边界的由来。把它单列出来,是因为它是解析层里少数几个"局部改动会引发非局部重算"的地方,做增量设计时必须特意处理。
工具链对比:没有全能选手,只有场景匹配
市面上的解析工具各有侧重,没有一个能通吃所有场景。把主流选手放在一张表里对比,能帮你按场景组合使用。
选型不是"选一个最好的",而是"按元素类型和文档类型组合"。一个常见的成熟组合是:用 PyMuPDF 快速判断有没有文本层并抽电子档文本,用版面检测模型定位元素,对扫描块调 OCR,对表格块调 PP-Structure,对图表块裁剪交 VLM。把它们串成一条按需调度的管线:
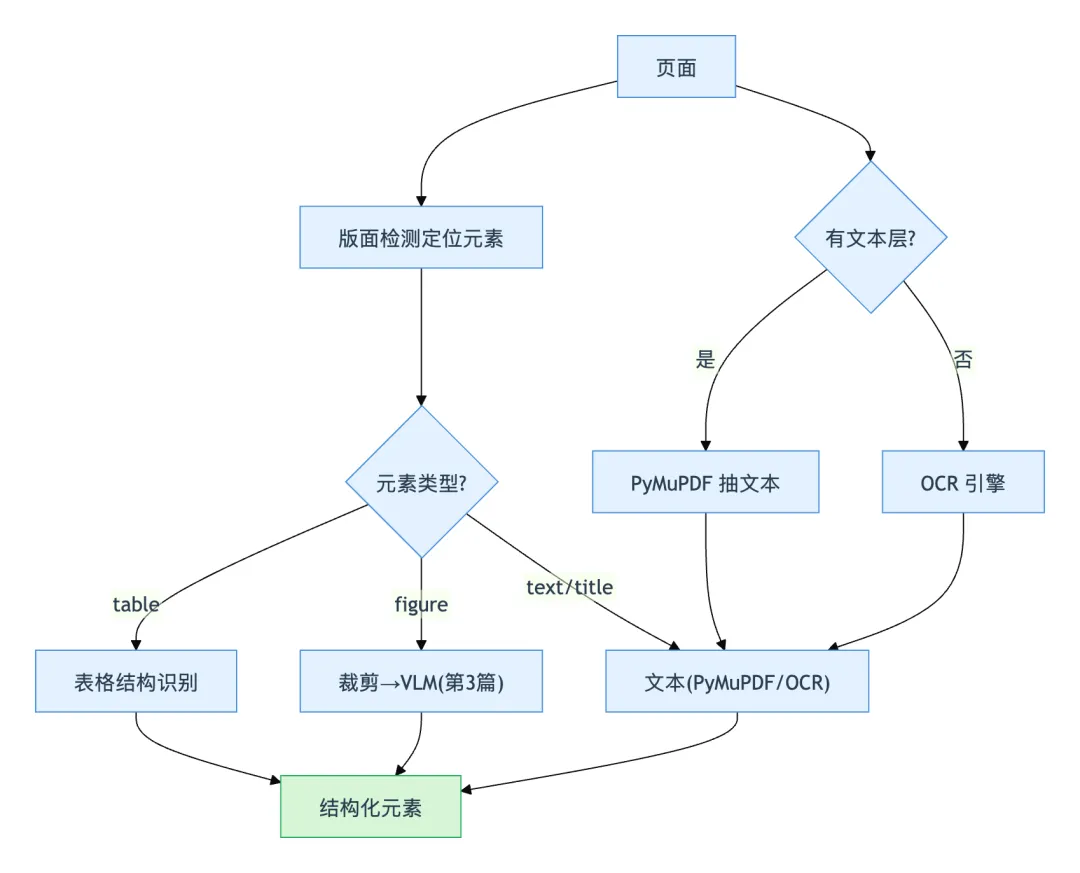
为什么不用一个端到端大模型把这些全包了?因为端到端方案(比如直接让 VLM 输出整页 Markdown)虽然接口简单,但可控性差、成本高、出错时难定位是哪一步错的。分模块管线的每一步可单独评估、单独替换、单独优化——表格识别不准就换表格模型,不用动 OCR。这种可维护性在生产系统里比"接口简洁"重要得多。当然,端到端方案在快速原型阶段有价值,两者不是对立,是不同阶段的选择。
还有一个绕不开的选型维度是自建还是用云服务。云文档智能服务(各大厂都有)综合精度高、免运维、开箱即用,对没有算法团队的项目很有吸引力。但它有两个硬约束:一是成本,按页计费在大批量场景下会很可观;二是数据合规,文档要传到外部,对含敏感信息的合同、财务、内部资料往往过不了安全审查。所以这个选择常常不是技术问题而是合规问题——数据能不能出内网,直接决定了能不能用云服务。能出网、量不大、又缺算法人手,云服务是省心之选;数据敏感或量极大,就得咬牙自建。现实里很多企业走的是混合路线:非敏感的公开资料走云服务快速见效,敏感文档走自建管线,用前面那套标准类型枚举把两条路的产出对齐到同一套下游。这样既照顾了合规红线,又不用为所有文档都承担自建的重量。
解析绕不开的三对矛盾
工具选好了,还要理解解析这件事本质上要在三对矛盾里做权衡。这些矛盾没有标准答案,取决于你的场景,但想清楚它们能帮你避免在错误的方向上死磕。
第一对是粒度与完整性的矛盾。切得太粗,一个大块里混了标题、正文、脚注,语义不纯;切得太细,一句话被拆成好几个元素,上下文断裂。表格尤其典型——把整张表当一个元素,检索时能保住行列结构但块太大;把每行当一个元素,检索粒度细但丢了表头上下文。实践中的折中是"表格整体作为一个元素保结构,同时为每行生成带表头的可检索文本",鱼和熊掌各取一部分。
第二对是速度与精度的矛盾。版面检测、OCR、表格识别、公式识别,每加一道都更准,但也更慢更贵。一份纯文字电子档,用 PyMuPDF 毫秒级抽完就够;非要走全套版面检测+VLM,精度没提升多少,延迟涨了几十倍。这对矛盾的解法还是前面提过的路由思想——按页/按元素类型决定走多重的管线。
第三对是通用与领域的矛盾。通用解析模型开箱即用,但对特定领域(医疗化验单、工程图纸、特定格式的财报)的怪异版面往往力不从心。领域微调能大幅提升精度,但要标注数据、要训练、要维护。什么时候值得微调?判断标准是:如果某一类文档占知识库比例大、且通用模型在它上面错误率高,那微调的投入产出比就高;如果是零散的长尾格式,用通用模型 + 低置信标记兜底更划算。
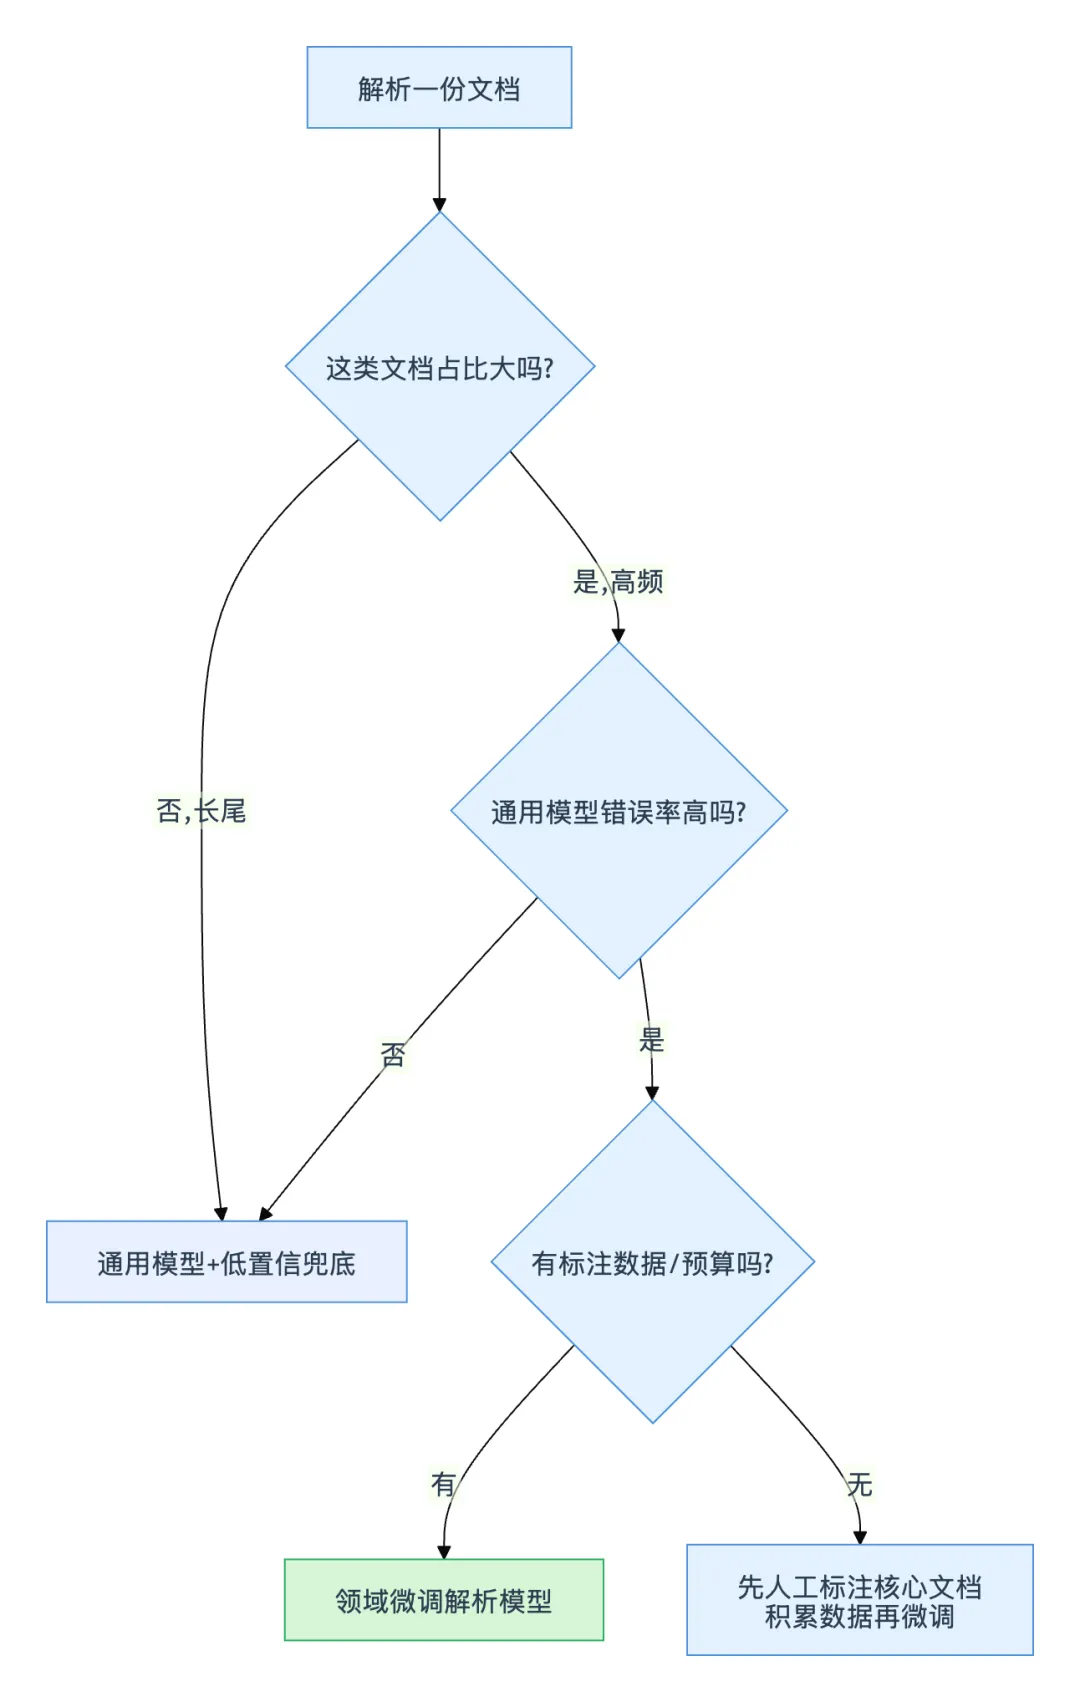
这三对矛盾贯穿解析层的每个决策。理解它们的意义在于:当你的解析效果不理想时,能判断出到底是该换更重的模型(精度问题)、还是该做路由(速度成本问题)、还是该微调(领域适配问题),而不是一股脑全上,把简单问题复杂化。
输出规范化:把异构解析结果统一成下游能消费的格式
解析管线里每个组件的原生输出格式五花八门——版面检测给的是框和类别,OCR 给的是文字加坐标,表格识别给的是 HTML。如果直接把这些异构结果丢给下游,表示层和检索层就得分别适配每种格式,耦合会失控。所以解析层的最后一步是规范化:把所有元素统一成前面约定的 DocElement 结构,或统一成结构化 Markdown。
选哪种统一格式,取决于下游怎么用。如果下游主要是喂给 LLM 做理解和生成,结构化 Markdown 是个好选择——它保留了标题层级、表格(用 Markdown 表格或 HTML)、图片引用,且 LLM 天然擅长读 Markdown。如果下游要做字段级检索(按行列查表格值),那 DocElement 加结构化字段更合适,因为 Markdown 表格没法做精确的单元格定位。
defnormalize_to_elements(raw_results, doc_id, page):"""把版面检测/OCR/表格识别的异构输出统一成 DocElement""" elements = []for r in raw_results: elem = DocElement( elem_type=r.category, # 统一类型词表 doc_id=doc_id, page=page, bbox=r.bbox, # 统一坐标系(左上原点) text=r.text if r.category in ("text", "title") elseNone, structured=parse_html_table(r.html) if r.category == "table"elseNone, image_ref=crop_and_save(r.bbox) if r.category in ("figure", "chart") elseNone, ) elem.reading_order = r.order # 阅读顺序序号 elem.confidence = r.confidence # 贯穿下去的置信度 elements.append(elem)return elements# ── AI 视角 ──# "各组件都有输出了,直接拼起来给下游不就行了?"# ── 实际含义 ──# 不规范化的话,下游要处理 N 种坐标系、N 种类型命名、N 种内容格式。# 规范化把'解析层的复杂性'挡在这一层内部,给下游一个干净稳定的契约,# 这样换任何一个解析组件,下游代码一行都不用改。规范化这一步看着不起眼,却是解析层能不能被独立维护的关键。它把内部的脏活累活封装起来,对外只暴露一个稳定的元素契约。前面提到的四层架构之所以能各层独立演进,靠的就是这种层间契约。解析层再怎么折腾工具组合,只要最终吐出的 DocElement 格式不变,表示层就感知不到变化。这是好的分层设计的标志——变化被限制在层内,不外溢。
规范化时还要统一坐标系。不同工具的坐标原点、y 轴方向可能不同(有的左上原点 y 向下,有的左下原点 y 向上),PDF 的坐标单位和渲染成图片后的像素坐标也要对齐。这个看似琐碎的细节,如果不统一,后面做可视化引用(在原图上画框标注证据)时就会出现框画歪了的问题。坐标系统一是规范化里最容易被忽略、又最容易在后期埋雷的一点。
规模化解析的性能与增量处理
前面讲的是"一页解析对不对",落到生产还有一个绕不开的问题:几十万上百万页怎么高效跑完,以及文档更新后怎么只重跑变化的部分。
性能瓶颈通常在版面检测和 OCR/表格识别这几个 GPU 密集环节。优化的核心思路是批处理和分级并行:把同类任务攒批送进 GPU(批量做版面检测比一页一页跑吞吐高得多),把 CPU 密集的文本抽取和 GPU 密集的视觉任务分到不同的 worker 池,避免互相抢资源。第一篇讲的路由在这里又派上用场——80% 的简单页走廉价 CPU 路径,只有 20% 的复杂页占用宝贵的 GPU,整体吞吐能提升好几倍。
defbatch_parse(pages, gpu_batch=16):"""分级并行:简单页走CPU快路径,复杂页攒批走GPU""" simple, complex_ = [], []for p in pages: (simple if p.route == "text_enhance"else complex_).append(p)# 简单页:CPU 并行,毫秒级 results = cpu_pool.map(fast_text_parse, simple)# 复杂页:攒够一批再送 GPU,提高显卡利用率for i inrange(0, len(complex_), gpu_batch): batch = complex_[i:i+gpu_batch] results += gpu_layout_detect(batch) # 批量推理,吞吐远高于逐页return results增量处理则解决"文档变了怎么办"。一份手册改了两页,没必要把整本重新解析。做法是给每个文档存一个内容指纹(页级哈希),入库时对比哈希,只对变化的页重跑解析。配合前面提过的理解版本号,还能在升级解析组件时精准定位"哪些文档需要用新版本重跑"。没有增量机制,一个大知识库每次微调都要全量重跑,成本和时间都撑不住。增量解析不是锦上添花,是规模化的必需品。
这些手段单独看都不复杂,但缺了它们,解析层在小规模验证时没问题,一到真实体量就会成为整个系统的吞吐瓶颈和成本黑洞。规模化能力要在架构设计时就留出位置,事后补代价很大。
解析质量评估与失败模式:怎么知道解析对不对
解析最危险的地方在于它的错误是静默的——不抛异常、有输出、看起来正常。所以必须主动评估,不能等下游查询失败了才倒查。评估要分三个层次,对应三类失败模式。
第一层是元素检测评估:抽样页面,人工核对检测出的元素数量、类型、边界是否正确。核心指标是各类别的检测准召率,尤其关注表格和图的漏检——它们一旦漏检,信息直接归零。
第二层是阅读顺序评估:把重组后的正文和人工判定的正确顺序对比。这一层专治多栏错序,指标可以用序列的编辑距离或逆序对数量。
第三层是内容抽取评估:OCR 字准率、表格单元格的行列对齐准确率、公式识别正确率。表格这里要特别测"字对了但位置错了"的情况——OCR 出的字全对,但塞进了错误的单元格。
defeval_parsing(parsed_elements, gold_elements):"""三层解析质量评估,返回可定位问题层次的指标""" metrics = {}# 1. 检测层:按类型算 F1,单独看 table/figure 漏检 metrics["detect_f1"] = element_f1(parsed_elements, gold_elements) metrics["table_miss"] = count_missed(parsed_elements, gold_elements, "table") metrics["figure_miss"] = count_missed(parsed_elements, gold_elements, "figure")# 2. 顺序层:重组正文与 gold 顺序的逆序对(越小越好) metrics["order_inversions"] = inversion_count( reading_order(parsed_elements), reading_order(gold_elements))# 3. 内容层:表格单元格行列对齐准确率(只字对不算,位置也要对) metrics["table_cell_acc"] = table_cell_alignment_acc(parsed_elements, gold_elements)return metrics# 用法:每次换解析组件后跑一遍,任一指标退化立即定位到具体层把常见失败模式和它们的根因、检测方法列成排查表,落地时可以直接照着查:
评估这件事的价值不只在发现问题,更在于建立回归防线。解析组件会不断迭代——今天换个更好的表格模型,明天升级 OCR 版本。没有评估集,你根本不知道升级是让某类文档变好了还是变坏了。一个哪怕只有几百页人工标注的解析 gold set,也能在每次改动后跑一遍,第一时间挡住"改好了 A 却弄坏了 B"的退化。这笔前期投入,在解析组件频繁迭代的系统里回报极高。
构建这个 gold set 有个实操要点:不要随机抽样,要按文档类型分层抽样。如果你的知识库里 80% 是规整电子档、20% 是复杂研报,随机抽 100 页会抽到 80 页简单的、20 页复杂的,而简单页解析器本来就不会错,测了也白测。正确做法是让每类文档在 gold set 里有足够样本,尤其是那些已知容易出错的类型(扫描件、多栏、含公式、跨页表),要重点覆盖。评估集的价值在于暴露问题,所以它应该有意地偏向难例,而不是复现真实分布。
还有一个评估维度容易被漏掉——端到端的信息保真度,也就是之前讨论过的核心指标。前面三层评估(检测、顺序、内容)测的是"每个环节做得对不对",但用户最终关心的是"文档里的信息有多少能被查到"。可以构造一批"信息点问题":从源文档里人工挑出若干关键事实(这个数据、那个结论),然后测解析后的结果里这些事实还在不在、结构对不对。这个指标最接近业务价值,也最能说服上下游"解析层到底值不值得投入"。
definfo_fidelity(parsed_doc, gold_facts):"""端到端信息保真度:源文档关键事实在解析结果中的可检索比例""" hit = 0for fact in gold_facts: # 人工标注的关键事实点# 事实是否能在解析结果中被完整、结构正确地找到if fact_present_and_structured(parsed_doc, fact): hit += 1return hit / len(gold_facts) # 例如 0.85 表示 15% 的关键信息在解析阶段就丢了# 这个指标直接对应业务价值,是向团队证明解析层投入产出比的最有力证据一个健康的解析层,信息保真度应该稳定在高位(比如 0.9 以上),并且每次组件升级后这个指标只升不降。如果它上不去,说明有系统性的信息在解析阶段丢失,得回到检测、顺序、内容三层里定位到底哪层拖了后腿。这就是三层评估和端到端评估配合使用的方式——端到端指标告诉你"有没有问题",分层指标告诉你"问题在哪"。
回到开头那份双栏研报:解析做对之后,左右栏按 XY-cut 正确分栏、逐栏读通,跨页大表被拼接算法合成完整一张并剔除了重印表头,页脚"仅供内部参考"被检测分类识别为 footer 丢弃,图表被裁剪出来等待后续的 VLM 理解。同一份文档,从"打乱重拼的字符垃圾"变成了一组类型清晰、顺序正确、结构完整的元素——这就是理解层第一步该交出的成果,也是后面所有环节能正常工作的前提。
把整篇的判断收一下:解析层的价值不在于用了多先进的模型,而在于它对自己能力边界的诚实——知道哪些文档能高质量处理、哪些只能标低置信、哪些必须交专用模型或人工。一个能力一般但边界清晰的解析层,比一个能力很强却对所有输入都"自信输出"的解析层可靠得多,因为前者的错误是可见、可拦截的,后者的错误是静默、会扩散的。这也解释了为什么这篇花大量篇幅讲评估和失败模式,而不只是讲怎么调用工具——在解析这件事上,知道自己什么时候会错,比追求极致准确率更有工程价值。
落地清单:解析层上线前必须验证的五件事
解析层不是搭完就完,上线前对着下面五件事逐条验证,能挡掉大部分后续会爆的坑:
第一,跑一遍元素检测评估,确认 table 和 figure 的漏检率足够低——这两类漏检等于信息直接消失,是所有失败里最不可接受的。第二,用真实的多栏文档测阅读顺序,人工读几页重组正文看通不通顺,别只看抽没抽到字。第三,找几份跨页长表专门测拼接,核对拼接后的行数和源文档一致。第四,对含公式、手写、多语言的文档,确认这些超边界元素被正确标记为低置信或路由到了专用模型,而不是被静默硬抽。第五,把解析组件的版本记进每个元素,确保将来升级模型时能只重跑受影响的文档。
这五条验证有个共同点:它们都不是在测"平均情况",而是在测"最坏情况"。平均情况下(规整电子档),几乎任何解析器都能跑得不错,测了没意义;真正决定系统上线后稳不稳的,是那些少数难例——扫描件、跨栏、跨页表、公式手写。所以验证时要刻意去找这些难例,而不是拿一堆简单文档刷一个好看的通过率。把难例挡在上线前,比上线后被用户用真实文档打脸要划算得多。说到底,解析层是整条多模态链路里离原始数据最近的一环,它丢掉的信息,后面无论多强的模型都补不回来——所以它值得在上线前被最严格地对待。
这五件事都通过了,理解层的地基才算打牢。顺着这条链路往下,真正的难题才刚开始:那些被裁剪出来、还只是像素的图表和复杂表格,怎么用 VLM 真正"读懂"成可检索、可推理的语义——把"看到了图"变成"知道图里说了什么",是理解层要迈的下一步,也是决定整个多模态系统能不能答准图表问题的关键一跃。