ARTICLE · 1007859
文档驱动开发-信息智能萃取-本地知识库:内容存得住、找得到、带得走
一、项目需求
需求可以用三个动词概括。一是存得住:处理过的内容自动入库,不需要我手动整理归档——“整理”这件事一旦靠自觉,就等于不做。二是找得到:过了一个月,我只记得只言片语,也要能把它翻出来。三是带得走:内容是我的,必须能导出去发给同事、贴进笔记软件,不能被工具绑架。
目前实现的痛点功能:
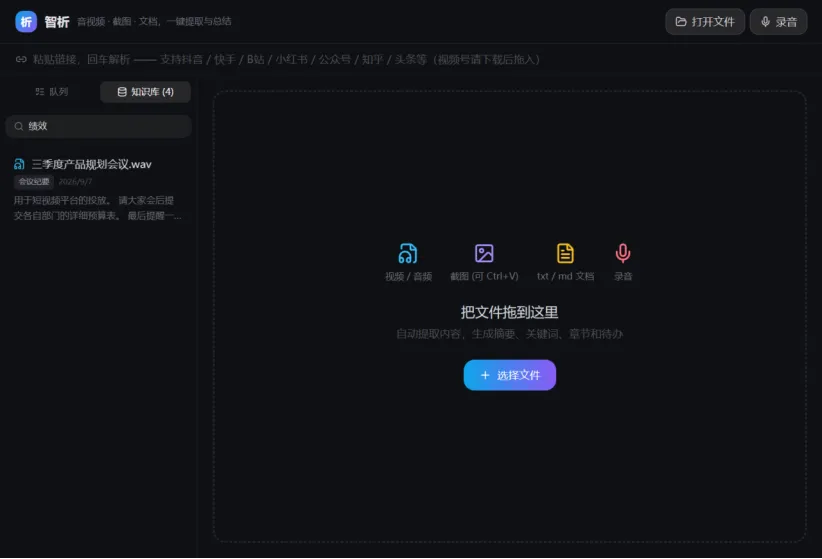
• 输入:在“全文检索”框里输入一个词,比如“绩效”。
• 输出:只有包含这个词的条目留下来,并且直接显示命中位置前后的原文片段——不用点进去,光看片段就知道是不是自己要找的那条。
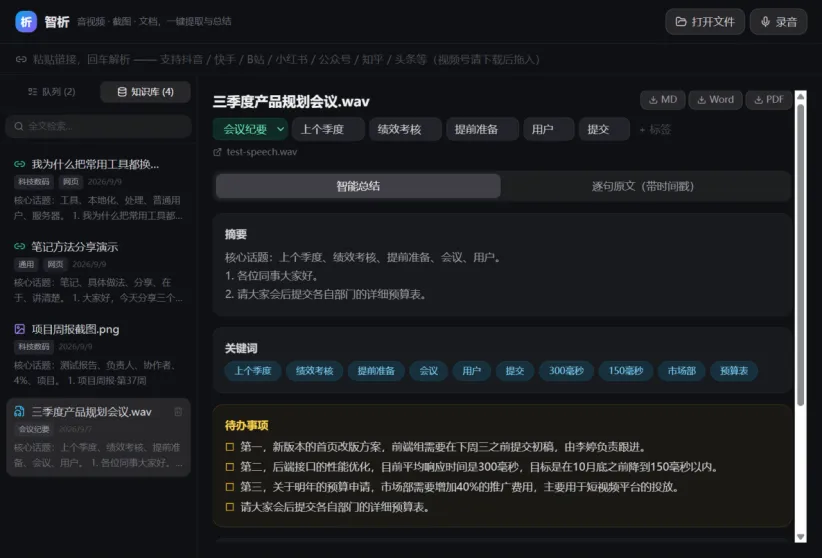
演示 2 · 一条会议纪要,一键变成 Word 发出去
• 输入:点开知识库里的会议纪要条目,右上角选导出格式。
三、藏在功能背后的思维链(重点)
知识库这个模块,同样有三个决策值得讲讲。
决策一:中文搜索,难在“没有空格”
英文按空格切词就能建索引,中文“绩效考核”四个字连着,切错了搜“绩效”就找不到“绩效考核”。解法是一种叫 trigram 的经典技术:不管词义,把文本按“每三个字一组”滑动切开建索引,搜索时同样切分,一匹配就命中。不聪明,但稳定可靠;本地索引,断网也能搜。
思维沉淀:经典方案不是过时的方案,而是被时间验证过的方案。
决策二:自动分类,我故意没用“AI 分类”
我反着来,用了一张明明白白的规则表:命中“会议、绩效、汇报”多就归会议纪要,命中“教程、例题”多就归课程学习。为什么故意“笨”一点?可解释——分错了你知道为什么;可修正——界面上点一下就改过来;零成本——不用为分类再背一个模型。
思维沉淀:简单可解释的规则,好过玄乎但不可控的“智能”。工具的第一要务是让人信得过。
决策三:连数据库也要“分家”
知识库的数据库模块和界面框架存在底层版本冲突,硬塞在一起要么编译不过、要么莫名闪退——和第 1 篇 AI 引擎的问题如出一辙。解法也是同一个:数据库搬出去单过,界面通过消息和它通信。现在界面、识别、数据库三户独立,互不干扰。
思维沉淀:好架构不是设计出来的复杂,而是拆出来的简单。两个东西天生合不来,最省事的做法是保持距离。
四、下一步:还要做什么
1. 同主题自动聚类:比如所有跟“产品规划”相关的笔记自动串成一条线,让知识库越用越结构化。
2. 知识库一键备份:整个库打包成一个文件,换电脑、重装系统都能原样恢复。
3. 批量导出:按分类、按时间段批量导出,比如“把这个月的会议纪要全部导成 Word”。