ARTICLE · 1009159
世界模型是什么?一文读懂 AI 从"数字助手"进化为"现实伙伴"的技术路线
过去三年,我们习惯了和 AI 聊天。
它能写代码、改文案、做总结,像个随叫随到的数字助手——但它始终待在屏幕里,不知道杯子掉在地上会碎,也不知道门后是什么。
2024 年之后,整个行业的注意力开始悄悄转向另一个词:
世界模型(World Model)
黄仁勋说它是"AI 的下一个前沿",Yann LeCun 把它当成通往 AGI 的必经之路,李飞飞的 World Labs 直接拿它创业融资 10 亿美元。
但"世界模型"这四个字,被讲得玄之又玄。
它到底是什么?和现在的大语言模型差在哪?技术路线有几条?
这篇文章,我们一次讲清。
一、先给一句话定义
世界模型 = 让 AI 在"脑子里"建立一个可推演的现实模拟器。它不仅能描述世界"是什么",还能预测"如果这样做,接下来会发生什么"。
拆开看,一个合格的世界模型要干三件事:
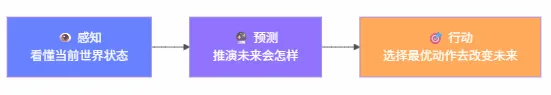
用一句人话来对比:
大语言模型:读过互联网上所有的书,能跟你聊任何话题,但没在现实里活过一天。 世界模型:可能话没那么多,但知道重力、知道遮挡、知道因果关系,还能提前"预演"后果。
二、为什么 LLM 走不到终点?
先别急着否定大模型。它已经很强了,但有几个结构性天花板:
| 输入模态 | ||
| 世界表示 | ||
| 核心任务 | ||
| 物理常识 | ||
| 因果推理 | ||
| 能否行动 |
一句话总结痛点:
LLM 学的是人类对世界的描述,而不是世界本身。
它能写出一篇关于"苹果落地"的优美散文,却不知道苹果松手后会以 9.8 m/s² 加速下落; 它能生成一段"机器人倒咖啡"的文案,却无法让机器人真的把咖啡倒进杯子。
而人类婴儿,在学会说话之前,就已经掌握了物理直觉——这就是世界模型要补的那一课。
三、四条技术路线,一次看懂
目前全球做世界模型的团队,从技术理念上大致可以分成四派。
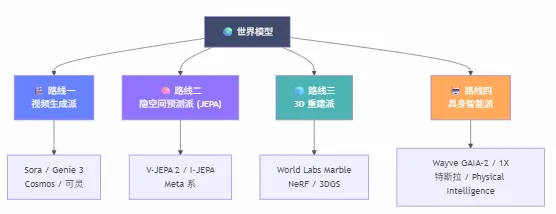
🎬 路线一:视频生成派——"把世界画出来"
代表: OpenAI Sora / Sora 2、DeepMind Genie 3、NVIDIA Cosmos、国内的视频生成模型
核心思路: 既然视频是现实世界最直接的记录,那就用视频预测来逼近世界模拟。
只要模型能生成"物理上合理、时序上连贯"的视频,就说明它内在学到了一套世界规律。
优点:
感官效果最直观,一眼就能"看见"世界模型 可交互性在快速提升(Genie 系列已支持实时交互 + 长时一致性) 数据来源广泛,互联网视频即可
短板:
容易"看起来对,推演全错"——视觉逼真 ≠ 物理正确 像素级预测算力开销巨大 缺少显式的 3D 结构和动作空间
💡 一句话评价:这是目前最出圈的一派,但也是最容易被质疑"是不是只是在做高级视频"的一派。
🧠 路线二:隐空间预测派——"Yann LeCun 的执念"
代表: Meta 的 JEPA 系列(I-JEPA → V-JEPA → V-JEPA 2),LeCun 2022 年那篇 A Path Towards Autonomous Machine Intelligence
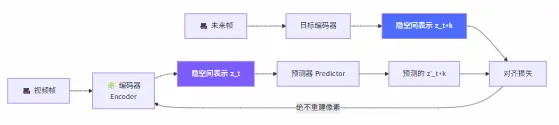
核心思路: 在像素层面预测太蠢了。世界有无数细节(每片树叶怎么动),但真正有用的只是抽象后的状态表示。
所以 JEPA 主张:
不要预测像素,预测"语义表征"。
在**隐空间(latent space)**里做预测,只保留"物体在哪、往哪动、什么关系"这些高层信息,把无关细节全部丢掉。
优点:
算力效率远高于像素生成 学到的是抽象世界结构,泛化能力更强 V-JEPA 2 已能零样本驱动机器人做规划
短板:
不能直接输出图像,不好"炫技",也难商业展示 隐空间表示可解释性偏弱 工程生态远不如视频生成热闹
💡 一句话评价:最被学术界认可的一派,也是最"不性感"的一派。
🧊 路线三:3D 重建派——"先把世界建出来"
代表: 李飞飞的 World Labs(Marble)、NeRF、3D Gaussian Splatting(3DGS)
核心思路: 不走视频,也不走抽象隐空间,而是直接生成可编辑、可漫游的三维世界。
输入一张图或一段文字,输出一个持久的、几何一致的 3D 场景,你可以像玩游戏一样在里面自由走动。
优点:
空间一致性天然成立(因为是显式 3D 结构) 可导出到游戏引擎、影视制作、VR/AR 管线 天然可编辑——挪动一个沙发不需要重训模型
短板:
动态世界(会动的物体、流体、人)仍是难点 大规模场景重建成本高 物理规律仍需额外建模
💡 一句话评价:最快能落地赚钱的一派——游戏、影视、空间设计已经在用。
🤖 路线四:具身智能派——"让 AI 有身体"
代表: Wayve GAIA-2、特斯拉的神经世界模拟器、1X 的世界模型、Physical Intelligence、各类机器人公司
核心思路: 世界模型不是拿来"看"的,是拿来开车的、抓东西的、走路的。
这一派的评价标准极其硬核:能不能在真实世界里把事办成。
优点:
目标明确,闭环可验证(成功了就是成功了) 与自动驾驶、机器人产业直接绑定,商业价值清晰 需要的是动作条件世界模型(action-conditioned),最接近"智能体"本质
短板:
真实数据采集成本极高 安全要求苛刻,迭代周期长 Sim-to-Real(仿真到现实)鸿沟依然存在
💡 一句话评价:最接近 AGI 想象的一派,也是最烧钱、最慢的一派。
📊 四条路线横向对比
| 高 | ||||
| 强 | ||||
| 极高 | ||||
| 强 | 强 | |||
| 快(内容/工业) | ||||
注意:这四条路线不是互斥的。越来越多团队在做融合——用 3D 表示做骨架,用视频生成做渲染,用 JEPA 思想做预测,最后接到机器人上执行。
四、世界模型是怎么训出来的?
抛开各家差异,一条通用技术链路大致长这样:
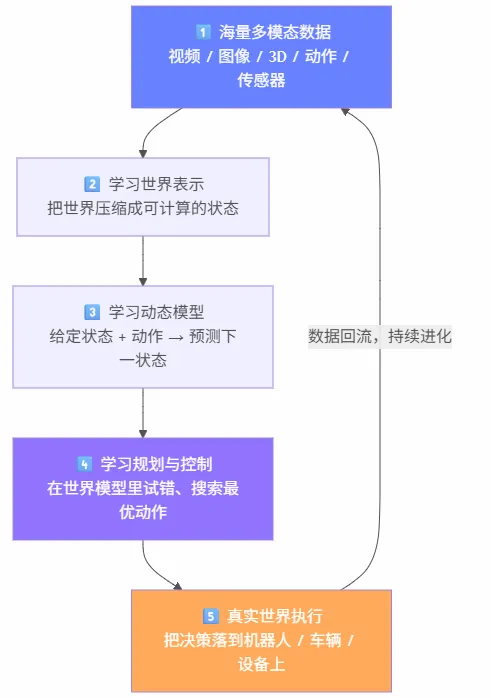
关键点在于第 3 步和第 4 步:
第 3 步是世界模型的"心脏"——它必须支持反事实推演:"如果我左转,会发生什么?" 第 4 步是世界模型的"价值兑现"——智能体可以在模型内部先试错几百次,再到现实里执行一次。这就是所谓 "想象中训练,现实中行动"。
这也是世界模型相比 LLM 最本质的差异:
LLM 的训练和推理是分离的; 世界模型天然是为了决策闭环而生的。
五、怎么判断一个"世界模型"是不是真货?
现在几乎每家公司都自称在做世界模型。下面这 6 条 是比较好用的"照妖镜":
| 空间一致性 | ||
| 长时一致性 | ||
| 物理规律 | ||
| 因果推理 | ||
| 动作可控性 | ||
| 持久记忆 |
Generative 与 Predictive 的区别也值得记住:
只会"生成好看的画面" → 更像生成模型 能"接受动作输入并推演后果" → 才算世界模型
很多所谓的世界模型,其实卡在"生成"这层,还够不到"模拟"。
六、它到底能用来干什么?
别只盯着"通用人工智能",世界模型的近期落地场景已经很具体:
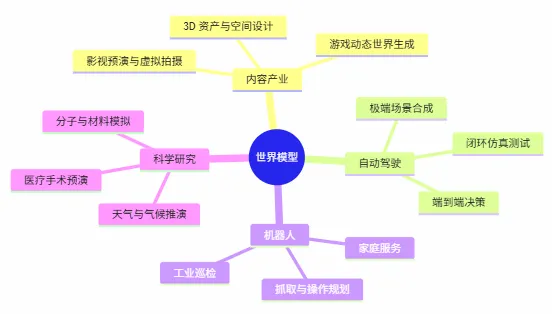
几条最实在的价值:
给自动驾驶造"无限公里数"——不用真跑几亿公里,在模型里合成罕见危险场景 给机器人降本——先在模型里练,再上真机,减少硬件损耗 给内容创作提速——一句话生成可漫游的 3D 世界,影视和游戏管线被重写 给科学计算加速——用神经模拟器替代部分昂贵数值仿真
七、冷思考:它现在还不是"万能钥匙"
泼几盆冷水,避免被营销带偏:
❄️ 物理正确性仍不可靠:视频模型能生成"看起来对"的物理,但推演误差会迅速累积 💸 算力黑洞:视频级世界模型的训练与推理成本,远超同规模语言模型 📉 长时一致性仍是硬伤:几分钟以上的稳定交互,目前只有极少数系统能做到 🧪 评测标准不统一:没有公认 benchmark,"谁更强"很难公断 ⚠️ 安全与滥用:能推演现实,就意味着能生成以假乱真的"现实",深度伪造风险升级
一句话:
世界模型正处在 "GPT-2 时刻" ——方向已经对了,但距离真正可用,还有一代到两代的距离。
八、时间线:我们是怎么走到这里的
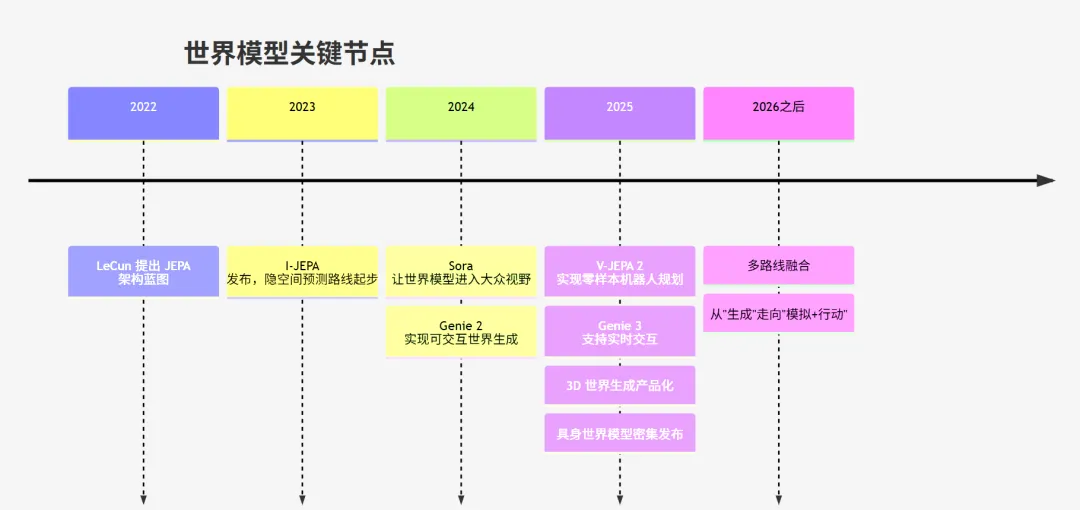
主线非常清晰:从**"预测下一个词"** → "预测下一个画面" → "预测下一个状态 + 行动"。
九、普通人该怎么看这件事?
如果你不是研究者,也不是创业者,这篇给你的结论其实只有三条:
1. 别把世界模型当"更炫的视频生成器"它的真正价值在于决策,而不在画面。谁能把它接到真实业务闭环上,谁才吃到红利。
2. 关注"数据 + 场景",而不是"参数"世界模型的门槛不在模型结构,而在高质量的交互数据(尤其是动作数据)。数据从哪来,是这轮竞争的核心。
3. 未来 3 年最值得盯的三个方向
🧊 3D / 空间内容工具链(离钱最近) 🚗 自动驾驶与机器人仿真(产业需求最刚) 🧠 JEPA 式高效表示学习(学术价值最高)
十、写在最后
回到标题那句话——
AI 正在从"数字助手"进化为"现实伙伴"。
大语言模型让 AI 学会了说话; 世界模型要让 AI 学会生活在世界里。
前者是理解人类写下的世界, 后者是理解世界本身。
这条路的终点,可能才真正称得上"通用人工智能"。
而现在,我们大概才刚刚走到它的序章。
如果这篇帮你搞懂了世界模型,点个「在看」或转发给还在问"世界模型是不是又一个概念炒作"的朋友。🌍
📎 信息来源说明
为避免误导读者,这里统一做几点说明:
关于公司与产品举例:文中提到的 Sora、Genie、Cosmos、JEPA、V-JEPA 2、GAIA-2、World Labs 等,均为各技术路线的代表性公开项目,仅用于说明路线差异,不代表任何投资或选型建议 关于技术能力描述:相关能力(如"零样本机器人规划""实时交互""长时一致性")来自各团队公开发布的信息与论文摘要,具体效果请以官方最新技术报告为准 关于时间线与节点:年份为大致阶段划分,用于帮助理解脉络,非精确发布日期 关于"GPT-2 时刻"等判断:属于个人观点,不构成行业定论 AI 领域进展极快,本文内容具有时效性,若你发现事实性错误,欢迎在评论区指出,我会更新
下一篇我会拆解四条技术路线各自的代表论文与技术细节,想看哪条路线的深挖,评论区告诉我~