ARTICLE · 1011641
孙显斌丨谈人文研究中人脑与电脑的合作
谈人文研究中
人脑与电脑的合作

作者:孙显斌
摘要:
电脑的引入给人文研究带来了新的面貌,但在人文研究中,人脑与电脑合作的相关问题,比如在合作的基础、法则以及分工等方面,还需要我们深入探讨。
关键词:人文研究;电子化
近些年来,电脑给人文研究带来的冲击一如它曾经给整个社会造成的冲击那样,迅速而猛烈,仿佛山洪汹涌,当你刚刚感觉到它的来临时,它已经把你团团包围。置身其中,又作为一个本科学计算机专业的学生,我对这个问题也就萌发了兴趣,并且一直在关注和思考。
对于还不了解电脑的人们,首先面临的困惑是电脑会不会取代人脑?我想可以不武断地说,现阶段电脑在某些方面固然强大,但是离开人脑的指挥,这一切就无从谈起。我最早听说用电脑辅助人文研究并不是很晚,大约在20世纪80年代末,我在文摘上看到一篇文章,说海外某位学者用电脑分别分析了《红楼梦》前八十回和后四十回的用词习惯、句法结构等方面,分析的结果是百分之八十相符,所以他认为《红楼梦》前八十回和后四十回的作者都是曹雪芹。但那时候,接触电脑的人还很少,个人电脑的功能也不够强大。在国内,电脑深入到人文研究领域,大概是近十年的事了。随着一大批研究资料的电子化,以及一些数据库的诞生,相应的文学、语言学等方面的研究成果也不断涌现,携此利器的新锐学者来势汹汹,一时间让那些未触电的学者有些感觉招架不住。但是几年下来,虽然人文研究的革新依然在不断孕育发展,可也没有发生翻天覆地的变化,一如洪水到后,只不过淹了个半身,暂无性命之忧,善于游泳的固然如鱼得水,旱鸭子们也照样行动自如。与不了解电脑的人对它的好奇和敬畏相反,计算机领域的工作者对它的能力则抱持着审慎的态度,即电脑在人脑的巧妙指挥下的确会具有强大的能力,但前提是人脑的巧妙指挥。这是因为现阶段电脑智能的实现只是对人脑的一些简单模仿,远远谈不上自学习和自组织,同时人类现今对于自己大脑的知识也还很有限。许多影迷可能都知道美国大导演斯皮尔伯格的一部科幻电影,名字叫做《A.I.》,也就是人工智能。被誉为“人工智能之父”的阿伦·图灵曾提出一种称作“图灵测试”的方法。此原则说:被测试的有一个人,另一个是声称自己有人类智能的机器。测试时,测试人与被测试人是分开的,测试人只有通过一些装置(如键盘)向被测试人问一些问题,这些问题随便是什么问题都可以。问过一些问题后,如果测试人能够正确地分别谁是人谁是机器,那机器就没有通过图灵测试;如果测试人没有分出谁是机器谁是人,那这个机器就是有人类智能的。当时图灵还预言,当计算机的内存达到1G,人工智能就可以实现。遗憾的是我们现在连笔记本电脑的内存都达到了1G,可人工智能还离我们很远。我举以上的例子是为了说明:人工智能远比我们想象的复杂,电脑的智能在相当长一段时间内都无法和人脑相比。因此在与人脑的合作中,电脑暂时也只能作为工具来发挥它的作用。
因此,在人文研究中相当长的时间内人脑也不会面临电脑的直接挑战,而学者必须面临的是作为工具的电脑的挑战,更准确地说,就是如何更好地利用电脑弥补人脑的不足,推动人文研究取得进展。以下我将从三个方面谈谈我对人脑与电脑合作的想法:即合作的基础、合作的法则以及合作的分工。
合作的基础:材料电子化
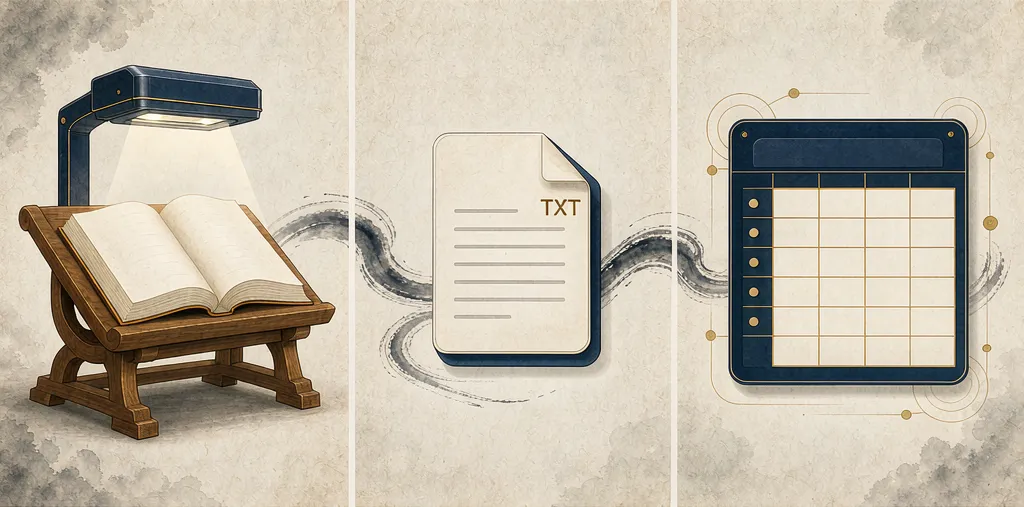
电脑给我们带来的第一个变化,就是材料的电子化,其实这也是人脑与电脑合作的基础。电子化有三个层次,分别是图像化、文本化、数据库化。材料在电子化后优势主要有以下三个方面:资源共享、查询方便、统计分析。其中资源共享是材料电子化后的共同优势。
图像化是指将学术材料制作成电子图像格式,这是最基本最简单的电子化,它不具有查询统计的功能,但是图像化有自己的优势,就是可以保持材料原貌,同时保证了材料的准确性。
第二种方式是文本化,这种方式具有查询统计的优势,但是需要录入和认真校对。因为有了文字自动识别技术,使这一方式实现起来简单了许多,与图像化相反,它具有准确性的风险,并且忽略了非文本信息,如字迹、版式等。因此与图像结合使用,则可以互补。另外,文本格式提供的查询功能虽然灵活方便,但因为这种查询一般都是依靠文本编辑软件(比如Word)实现的,所以在统计分析方面的功能很简单。谈到文本化,还需要谈一个问题,就是汉字的电子化问题,这包括两个方面,一方面是编码标准及字库,另一方面是输入法。输入法问题最早得到较好的解决,在同等条件下汉语的输入速度已经不让拼音文字。当然输入法的问题,给我们的校对和校勘提出了新的问题,输入法的错误与传统的刻本错误、铅印排字错误相比具有不同的特点,并且和使用的输入法密切相关。字库能表示的汉字数量及编码标准化都是重要的问题,但近来都因为国际标准化组织(ISO)的Unicode方案得到飞跃性的进步。它针对中国大陆、台湾、香港和日本、韩国使用的汉字进行了统一编码,同时大大扩充了其收字范围。我们知道1990年版《汉语大字典》收录汉字54678个,1994年版的《中华字海》收录了汉字87019个,最近通过专家鉴定的北京国安咨询设备公司的汉字字库收入有出处的汉字91251个。台湾《异体字字典》收字106152个,其中正字29866个,异体字76286个。而Unicode方案现在收汉字大约七万多,应该说完全可以满足文本化的需要。其实常用的现代汉字,不会超过新华字典所收的1万个左右,古籍也是一样,《辞源》收录的1万字左右也大致可以包括。而数量巨大的字库一般只是增加了大量的异体字,有的只是字形的不同而已。现在海峰五笔可以输入Unicode方案七万多汉字,对于不会五笔的人来说可以使用手写输入法逍遥笔,它可以输入方正超大字符集的六万多汉字。至于用于学术研究的古字体,比如甲骨文、金文、小篆等,也有相应的字库文件出现,只是还不够全面,使用面也不广。
第三种方式是数据库化。数据库化是在文本化的基础上将资料做成数据库,数据库是由一条条的项目构成的,我们拿《全唐诗》的数据库为例,每一首诗可以作为一个项目,其中包括的信息字段除了诗的文本外,还可以包括这首诗的作者、体裁、题材、时代等等,有了这些相关信息,我们就可以通过数据库进行方便快捷的统计分析,比如统计这样一个题目——“中唐时期写爱情的七言律诗”。我们可以看到数据库中文本条目外相关信息越丰富准确,我们能进行的统计分析就越方便。所以说文本化只是将材料作平面延展,而数据库化则将材料立体化、关系化。除了拥有文本化的优势外,它的统计和分析功能更强大,这正是我们最需要的。
基于以上分析,我们现在应该推进珍贵资料的图像化,以扩大它们的学术共享范围。另一方面就是建立更多针对性强、功能强大的资料数据库。
合作的法制:理论与规范的缺失
虽然电脑被引入人文研究已经有不短的一段时间了,但是我们至今还没有建立起相应研究的理论和规范。学者们主要是按照自己的理论预设,进行统计和分析,成为自成一家的“新方法”。我们使用新方法的同时是不是还需要相应的新规则呢?这就是我说的合作法则的问题。
我们知道统计分析需要统计学的理论基础,尤其在统计的范围是抽样的时候,对样本的选取很重要,所得的结论也要有保留。即使对于《全唐诗》这种样本的统计,我们知道所谓的“全”是指流传下来的,它不等于曾经存在的“全”。所以即使是全部样本,也要进行样本的分析。虽然统计学的基础对于人文学者来说相当不容易,并且在统计学理论的检验下,我们现行的方法也未必有多大漏洞,但是我们在作统计分析前,应该先思考和确认一下统计分析的适用范围和合理性等问题。
统计学基础缺乏的同时,其他的理论基础也一样薄弱。比如我们做文学的研究,往往要分析作家的风格,那么风格如何从文本表现,它和词语的运用、句式的变化,以及音韵的关系是什么样的。是不是用“风、花、雪、月”最多,就是浪漫;是不是用“金戈铁马”最多,就是豪放。实际上,风格如何从文本表现,是复杂的,并且不单单是一个客观的问题,有很多主观的因素,但主观因素也无外乎是在文本的基础上加上读者的前理解。风格是如何在作者、文本、读者之间作用形成的,只有弄清了这些基本问题,我们才能更准确的分析文本的风格,至少是风格的文本因素。我们现今的大多数研究还是集中在新数据库基础上的浅层分析,所以这类研究的新意往往只是体现在数据库的新上而已。我们说学术研究的进步无外乎新问题、新材料、新方法,就此而言现阶段的这方面研究大多是在新材料方面。如果我们想把文本统计分析的研究做得深入,就必须逐步着手相关的理论建设。
我们应该先建立起一个规范,就是指出什么样的研究方式过于简单,指出这些研究方式的缺陷和不足,指出这样的浅层次研究意义不大,同时也就提出了我们应该关注的理论问题。
合作的分工:人机各司其职
再有一个方面就是要清醒认识人脑和电脑的能力和优势,什么工作电脑来做,什么工作人脑来做。我想现阶段电脑的优势在于它的检索与统计,以及自动处理能力,并且可以保证速度和准确,这方面是人难以企及的。比如在一本书中找到一个词出现过多少次,都在哪个位置,对于电脑来说是非常轻松的。再比如,我们编了一万条的条目,要为它们编一个索引,这种工作常被我们称为“体力活”,但是电脑就是擅长这种“体力活”,并且干得又快又好,任劳任怨。遇到这种工作,我们在材料电子化的基础上,交给电脑就好了。那么电脑不擅长做什么,也就是相比之下我们人脑擅长做什么,也就是在合作中人脑必须去做的。我想主要是主观的东西:判断、理解和考证。对于一些简单或者有规律的判断,可以由人脑制定一个算法,告诉电脑如此这般去做,那么它也能很好的完成任务。比如分析诗词格律,我们只要先建立起一个汉字的音韵库,也就是每个汉字的声韵调,就好比我们要去查的韵书,那么就可以让电脑去分析诗词的格律了。当然也不是就这么简单,因为存在汉字多音的情况,而在具体诗词中,具体的字到底取那一个声韵调是和它在诗词中的意义相关的。我们可以进一步细化这个算法,来分析多音字的具体情况,也可以干脆把这个较复杂的问题留给人脑来做。也就是在初步分析之后,电脑提示你所有多音字的地方,让人脑给出准确判断,问题也就解决了,电脑虽然没有为我们解决所有问题,但是我们的工作量却小多了。
要想让电脑理解或者考证,其算法必将非常复杂,我们现阶段也无法开发出这种算法。但是这些都不是问题,因为我们还有人脑在。比如上文说到的标注诗歌的题材,它包括诗歌的意象和主题,只有每首诗标注了题材,我们才可以利用电脑按照题材来分类统计分析。这个标注工作电脑是无法独立完成的,这是一个理解工作,但是可以由人脑帮助完成,电脑记录下来。再举一个考证的例子,假如我们来为一本书编一部人名索引,我们不只是做简单的记录,当碰到字、号、别称时,就要做一番联系和考证工作,这也是只有人脑才能完成的。在这个例子中,甚至连人名也要你来判断,电脑无法从一个句子中准确识别哪个是人名。这样说来,似乎在这个例子中电脑没有用武之地了,我们不要忘了它的自动处理功能,只要我们在电子文本上标出人名,并给出准确的人名字头,电脑就会为你自动生成全部索引。
我们说人脑与电脑的合作,对于人文学者而言,还有一个桥梁,那就是软件的开发者。人脑与电脑的合作也就体现在人文学者和编程人员的合作上,应该怎么做人文学者最清楚,电脑能做什么编程人员最清楚。但是我们不能否认两者之间多少还是存在专业隔阂,如果互相了解一些对方领域的基本知识,那么合作就会轻松许多。程序开发的过程首先是需求分析,能否做好需求分析对于一个软件的开发成功和顺利与否至关重要,所以编程人员要认真做需求分析,在需求分析阶段人文学者也要多提要求,多做设想,力求使所有问题在程序开发前都清楚地被关注。现在很多数据库都是编程人员开发的,需求分析做得不够,导致开发耗费巨大的数据库功能却很有限,这样很浪费。比如现在大家常用的一个网上数据库——《文渊阁四库全书(网络版)》,我们知道这里面的资料是非常丰富的,几乎包含了乾隆以前我国所有的重要典籍,但是它只提供一个功能,就是文本全文检索或者单书检索。对于这么丰富的语料库,我们首先想到的是它能不能实现时代检索,比如我想知道一个词语在唐代典籍出现的情况,现在要想解决这个问题有两种方法,一个是进行全文检索,然后在里面挑唐代的典籍;再就是一部部唐代典籍检索,两种都够费劲的。其实数据库实现这个功能并不复杂,只要给数据库中的每本书标明时代,电脑就可以自动实现这个功能。新出的《中国古籍基本库》就增加了时代检索的功能,但是同时制造了一个更笨的不方便,它只能单个时代查询,其实只要让使用者规定起止时代就可以了。出现这些问题的主要原因是开发者并不是使用者,也没有很好的了解使用者的需求。
原文发表于《云梦学刊》,引用请参考原文:
孙显斌.谈人文研究中人脑与电脑的合作[J].云梦学刊,2008,(3):28-30.