ARTICLE · 1012447
FPGA SmartNIC 卸载网络协议:如何设计Linux Kernel Bypass 和用户态实现方案
协议已经在 FPGA 中处理完了,但数据最终交给谁?
如果 FPGA 完成 UDP/IP 解析后,通过普通 Linux ethX 网卡路径把数据交给主机,那么数据仍然可能经历:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 FPGA NIC │ │ DMA ▼Linux NIC Driver │ ▼NAPI / skb │ ▼Linux IP Stack │ ▼UDP │ ▼Socket │ ▼Application 这时候 FPGA 虽然已经承担了大量协议处理工作,但 CPU 仍然需要参与:
网卡中断/NAPI; skb 管理; IP 层处理; UDP 层处理; socket 缓冲区管理; 数据拷贝或者引用传递; 用户态/内核态切换。
于是出现一个非常典型的问题:
FPGA 卸载了协议计算,却没有真正卸载数据路径。
真正有价值的 SmartNIC UOE/TOE 架构应该进一步变成:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 ┌─────────────────────┐ │ User Process │ │ │ │ send / recv / poll │ └──────────┬──────────┘ │ User-space Fast Path │ ┌────────────▼────────────┐ │ Shared Queues │ │ SQ / RQ / CQ / Buffer │ └────────────┬────────────┘ │ PCIe / DMA │┌──────────────────────────────▼─────────────────────────┐│ FPGA SmartNIC ││ ││ PCIe DMA → UDP/IP Offload → Ethernet MAC → PHY ││ │└─────────────────────────────────────────────────────────┘ Linux 内核不再位于每一个数据包的必经路径上。
这才是 真正意义上的 Host CPU offload。
本文重点讨论的,就是这个“最后一公里”。
读完之后,可以得到一个完整的实现框架:
为什么协议卸载之后还必须绕过 Linux 网络栈; 用户态直接访问 FPGA SmartNIC 到底需要解决哪些问题; DPDK 为什么性能高,以及为什么它并不天然适合嵌入式; - libibverbs 为什么值得借鉴;
如何把 Verbs 的设计思想用于 UOE/TOE; 一个面向 FPGA SmartNIC 的嵌入式用户态数据面应该如何设计。
2. UOE 的价值,不只是减少协议计算
先看传统 UDP 数据路径。
假设 FPGA 收到一个 Ethernet Frame:
1 2 3 4 5 6 7 Ethernet ↓IPv4 ↓UDP ↓Application 如果完全由 Linux 处理,CPU 需要参与协议解析、状态维护以及数据传递。
FPGA UOE 可以把其中的大部分工作搬到 FPGA:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 FPGA │Ethernet ──► Ethernet Parser │ ▼ IPv4 Parser │ ▼ UDP Parser │ ▼ RX Queue / DMA │ ▼ Host Memory 此时 FPGA 已经完成:
Ethernet 解析; IPv4 解析; UDP checksum; UDP port 匹配; packet filtering; DMA; queue dispatch。
但如果 Host 仍然通过:
1 recvfrom(sockfd, ...) 接收数据,那么数据仍然需要进入 Linux socket 子系统。
因此整个架构实际上变成:
1 2 3 4 5 6 7 8 9 10 11 FPGA │ UDP/IP already offloaded │ ▼ Linux Network Stack │ "再次处理" │ ▼ Application 这就出现了一个非常重要的工程原则:
协议卸载和数据路径卸载必须同时考虑。
否则 FPGA 只解决了其中一半的问题。
3. Linux Kernel Bypass 到底绕过了什么
这里需要把“绕过内核”说准确。
真正需要绕过的,并不是 Linux 内核所有功能,而是:
高频数据面。
控制面仍然应该由 Linux 负责。
因此比较合理的架构应该是:
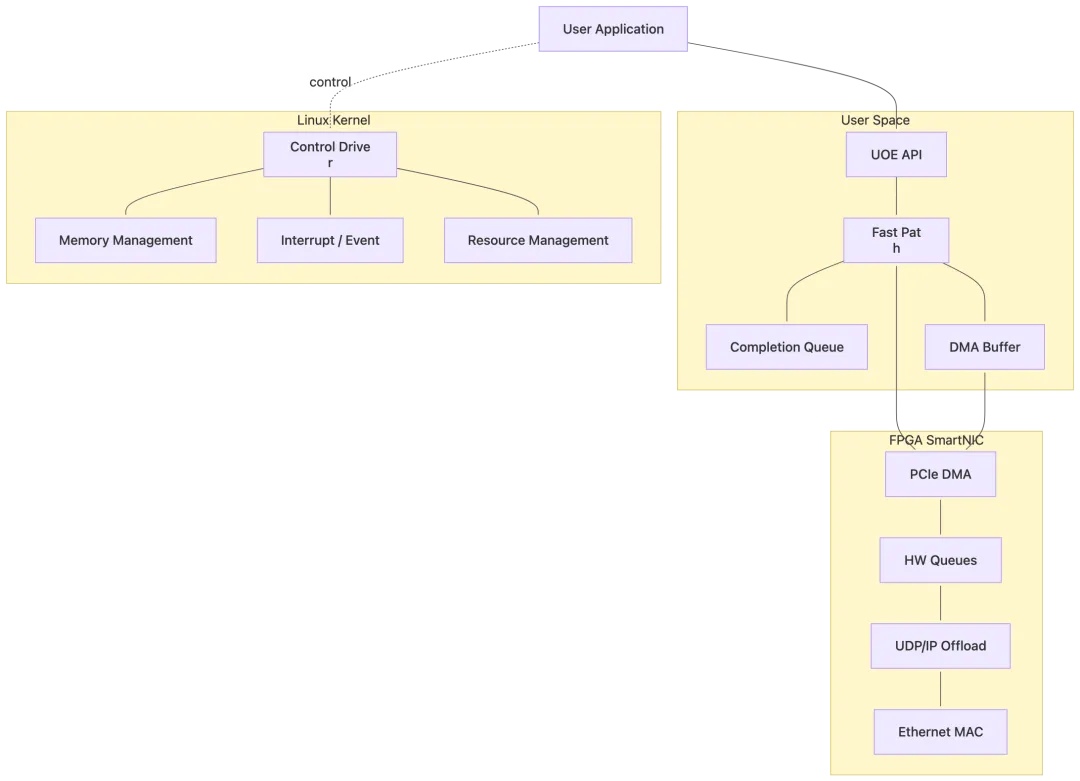
核心思想非常简单:
控制路径
可以进入内核:
1 2 3 4 5 6 7 8 open()ioctl()mmap()madvise()resource allocationqueue creationDMA mappinginterrupt setup 数据路径
尽可能停留在用户态:
1 2 3 4 5 submitpollconsumerecycledoorbell Linux 官方 RDMA 用户态机制实际上就是这种思想:资源管理通过 /dev/infiniband/uverbsN 等接口进入内核,而快速数据路径可以通过 mmap 后的硬件资源直接在用户态完成。
这也是 libibverbs 最值得 UOE/TOE 借鉴的地方。
4. 真正困难的不是 UDP,而是 DMA 内存
如果设计一个最简单的 UOE:
1 2 3 4 5 6 7 8 Application │ │ buffer ▼DMA Engine │ ▼FPGA 第一个马上出现的问题就是:
FPGA DMA 到底写哪块 Host 内存?
用户程序里的:
1 char buffer[4096]; 并不能直接等价于 FPGA 可以使用的物理地址。
现代 Linux 使用虚拟地址:
1 2 3 4 5 6 7 8 9 10 11 12 13 Application VA │ ▼ MMU │ ▼Physical Page │ ▼IOMMU / DMA Address │ ▼PCIe FPGA 因此一个真正的 UOE SDK 至少需要解决:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 Memory Registration │ ▼Virtual Address │ ▼Pinned Pages │ ▼DMA Mapping │ ▼IOMMU / Physical Address │ ▼FPGA DMA 这就是为什么简单写一个:
1 mmap("/dev/uoe", ...) 远远不够。
5. DMA Buffer 最终应该变成什么样
比较合理的设计不是每次:
1 send(buffer, length) 都临时进行 DMA 映射。
而应该建立长期存在的 Buffer Pool:
1 2 3 4 5 6 7 8 9 Host Memory┌─────────────────────────────────────────────┐│ Buffer 0 │ Buffer 1 │ Buffer 2 │ ... │ N │└────┬────────┬────────┬────────┬─────────────┘ │ │ │ ▼ ▼ ▼ DMA DMA DMA Addr Addr Addr 同时 FPGA 只保存:
1 2 3 4 DMA addresslengthflagsbuffer_id 例如:
1 2 3 4 5 struct uoe_buf { uint64_t dma_addr; uint32_t len; uint32_t buf_id;}; 这样 FPGA 不需要理解 Linux 虚拟地址。
6. Queue 才是整个系统的核心接口
DMA Buffer 解决“数据放哪里”。
Queue 解决的是:
谁告诉 FPGA 有数据?谁告诉 Host 数据已经完成?
因此最基本的 UOE 用户态接口实际上应该围绕四种对象建立:
1 2 3 4 SQ Submit QueueRQ Receive QueueCQ Completion QueueBUF Buffer Pool 可以设计成:
1 2 3 4 5 6 7 8 9 10 11 12 13 Application │ ┌─────────┴─────────┐ ▼ ▼ TX SQ RX RQ │ │ └─────────┬─────────┘ │ FPGA DMA │ ┌─────────┴─────────┐ ▼ ▼ TX CQ RX CQ 这已经非常接近 RDMA Verbs 的设计思想。
7. Doorbell:用户态如何告诉 FPGA
假设用户程序把一个 TX descriptor 写到了:
1 TX SQ FPGA 并不知道这个 descriptor 已经准备好。
传统做法可以:
1 2 3 4 5 6 7 write() ↓Kernel ↓Driver ↓FPGA Register 但这又重新引入系统调用。
更高性能的方法是:
1 2 3 4 5 6 7 8 9 10 11 12 User │ │ write descriptor ▼SQ │ │ MMIO ▼Doorbell Register │ ▼FPGA 即:
1 2 sq[tail] = desc;mmio_write(DOORBELL, tail); 这里的 mmio_write() 本身并不意味着进入 Linux 内核。
PCIe BAR 可以被 mmap 到用户态后,用户程序直接执行 MMIO。
这正是 Verbs fast path 的关键思想之一。Linux 文档明确指出,RDMA 快速路径可以通过 mmap 后的硬件寄存器直接访问,避免系统调用和内核上下文切换。
8. Completion Queue:为什么不应该每个包一个中断
如果 FPGA 每收到一个 UDP packet:
1 2 3 4 5 6 7 Packet ↓Interrupt ↓CPU ↓Application 10GbE 下很快就会产生大量中断。
25GbE、100GbE 更明显。
因此高性能数据面通常不会:
1 1 packet = 1 interrupt 而是:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 FPGA │ ├── CQE ├── CQE ├── CQE ├── CQE └── CQE │ ▼ interrupt │ ▼Application │ ▼poll CQ 更进一步,可以采用:
1 Adaptive Notification 即:
1 2 3 4 5 6 7 低流量 ↓Interrupt / event高流量 ↓Polling 这正是 DPDK 为什么采用 Poll Mode Driver 的原因之一。DPDK PMD 直接访问 RX/TX descriptor,并通过轮询避免高频中断开销。
9. DPDK 为什么性能高
DPDK 的核心不是“用了很多优化”。
最重要的是它改变了数据路径:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 传统 LinuxNIC │ ▼Kernel Driver │ ▼NAPI │ ▼skb │ ▼Network Stack │ ▼Socket │ ▼User DPDK:
1 2 3 4 5 6 7 8 9 10 11 12 13 NIC │ ▼DMA │ ▼Hugepage / DMA Memory │ ▼RX Descriptor │ ▼User Application 并且:
1 2 3 4 5 No skbNo socketNo normal network stackNo per-packet syscallNo per-packet interrupt DPDK 官方 PMD 架构就是让用户态直接轮询 RX/TX descriptor。
这也是它在服务器高吞吐场景非常强的根本原因。
10. 但 DPDK 的代价同样非常明确
问题不是:
DPDK 性能不好。
恰恰相反,DPDK 的问题是:
它为了获得高性能,主动把 CPU 变成了数据面设备的一部分。
典型结构:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 CPU Core 0 │ └── RX PollCPU Core 1 │ └── RX PollCPU Core 2 │ └── ApplicationCPU Core 3 │ └── TX Poll 只要数据面运行:
1 2 3 4 5 6 while (1) { nb_rx = rte_eth_rx_burst(...); if (nb_rx) process();} CPU 就会持续工作。
即使当前:
1 Network Traffic = 0 CPU 仍然需要不断检查 RX ring。
因此 DPDK 特别适合:
1 2 3 4 5 6 7 8 9 服务器+高吞吐+持续流量+大量 CPU Core+高功耗可以接受 而嵌入式系统经常恰好相反:
1 2 3 4 5 CPU Core 少功耗敏感流量具有突发性Linux 仍然承担大量控制任务不希望独占 CPU 因此:
嵌入式 UOE 并不一定需要复制 DPDK。
11. DPDK 与 Verbs 的真正区别
可以把两者抽象成:
这里最重要的不是 API 名字,而是设计思想。
DPDK 的核心抽象:
1 2 3 4 5 6 PortQueuembufRX burstTX burstPolling Verbs 的核心抽象:
1 2 3 4 5 6 7 ContextPDMRCQQPWRWC 如果我们开发 FPGA UOE,完全可以创造第三种:
1 2 3 4 5 6 7 8 9 UOE Context │ ├── Memory Region │ ├── Queue Pair │ ├── Completion Queue │ └── Event Channel 12. libibverbs 最值得复用的不是代码,而是 Provider 架构
这是整个方案中最有价值的一点。
libibverbs 本身并不直接知道某个 FPGA 的硬件细节。
它提供:
1 2 3 4 5 6 7 8 9 10 11 12 13 Application │ ▼ libibverbs │ ▼ Provider │ ▼ Hardware Driver │ ▼ Device 例如:
1 2 3 4 5 6 libibverbs │ ├── mlx5 provider ├── rxe provider ├── hns provider └── ... 公共层定义接口。
Provider 负责:
1 2 3 4 5 6 hardware-specificdescriptordoorbellCQEDMAregister Linux 官方文档也明确将 libibverbs 定义为设备无关的用户态 verbs API,而具体硬件需要对应的 kernel/userspace driver。
因此对于 FPGA SmartNIC:
最值得复用的是 Provider Model。
而不是把 RDMA 协议本身硬塞进 UOE。
13. 可以构建一个“UOE Provider”
一个非常自然的架构是:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 Application │ UOE SDK / API │ ┌──────▼──────┐ │ libuoe.so │ │ │ │ Generic API │ └──────┬──────┘ │ Provider │ ┌──────────┴──────────┐ │ │ FPGA-UOE FPGA-TOE Provider Provider │ │ └──────────┬──────────┘ │ /dev/uoe0 │ Kernel Driver │ PCIe / DMA / IRQ │ FPGA 应用程序看到的是统一 API:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 uoe_open();uoe_alloc_pd();uoe_reg_mr();uoe_create_cq();uoe_create_qp();uoe_post_send();uoe_post_recv();uoe_poll_cq(); 而 FPGA 具体实现:
1 2 3 4 5 6 7 Queue LayoutDescriptor FormatDMA EngineDoorbellInterruptCQERegister Map 全部隐藏在 Provider 后面。
14. UOE API 甚至可以比 Verbs 更简单
没有必要把 RDMA 的所有语义全部搬过来。
UDP 本身没有:
1 2 3 4 5 6 7 QP State MachineRDMA ReadRDMA WriteAtomicReliable ConnectionPSNRetry 因此 UOE 可以大幅简化。
例如:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 struct uoe_send_wr { void *buf; uint32_t len; uint32_t dst_ip; uint16_t dst_port; uint32_t flags;};struct uoe_recv_wr { void *buf; uint32_t len; uint32_t flags;};struct uoe_wc { uint64_t wr_id; uint32_t byte_len; uint32_t src_ip; uint16_t src_port; uint32_t status;}; 应用程序:
1 2 3 4 5 uoe_post_recv(qp, &wr);uoe_poll_cq(cq, &wc);uoe_post_send(qp, &wr);uoe_poll_cq(cq); 这已经足够形成一个完整的 FPGA UDP Offload 数据面。
15. 真正适合嵌入式的关键:Event + Poll 两种模式并存
如果完全复制 DPDK:
1 100% polling 嵌入式系统会比较痛苦。
更合理的方案是:
1 2 3 4 5 6 7 8 9 UOE │ ┌────────┴────────┐ │ │ Poll Mode Event Mode │ │ 高吞吐/低延迟 低流量/低功耗 │ │ CPU IRQ 例如:
高速模式
1 2 3 4 5 6 while (running) { n = uoe_poll_cq(cq, wc, 32); if (n) process(wc, n);} 低功耗模式
1 2 3 4 5 6 7 uoe_arm_cq(cq);poll();wait_event();uoe_poll_cq(cq, wc, 32); 这样:
1 2 3 4 5 6 7 8 9 高流量→ Poll低流量→ Interrupt/Event突发流量→ Event 唤醒→ 短时间 Poll 这其实比单纯复制 DPDK 更适合嵌入式 SmartNIC。
16. 中断到底应该放在哪里
推荐结构:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 FPGA │ │ CQE ▼ Completion Queue │ Interrupt │ ▼ Linux Driver │ eventfd │ ▼ User Process 注意:
中断不是数据通路。
它只负责:
告诉用户程序“可能有数据了”。
真正的数据仍然通过:
1 2 3 DMA Buffer+CQ 完成。
这就把:
1 Interrupt 从:
1 每个 packet 都参与 变成:
1 低频 notification 17. 这样才能解决嵌入式 CPU 的核心矛盾
假设一个嵌入式 SoC:
1 4 CPU cores 如果使用纯 DPDK:
1 2 3 4 Core 0 → RX pollingCore 1 → RX pollingCore 2 → TX pollingCore 3 → Application 系统基本没有多少 CPU 余量。
而 UOE Event + DMA 模型可以变成:
1 2 3 4 5 6 7 8 9 10 11 Core 0 └── LinuxCore 1 └── ApplicationCore 2 └── ApplicationCore 3 └── idle FPGA 负责:
1 2 3 4 5 6 7 EthernetIPv4UDPChecksumFilteringQueueDMA CPU 只负责:
1 Business Logic 这才是嵌入式 FPGA SmartNIC 真正有意义的地方。
18. 一个可落地的完整软件栈
最终可以形成:
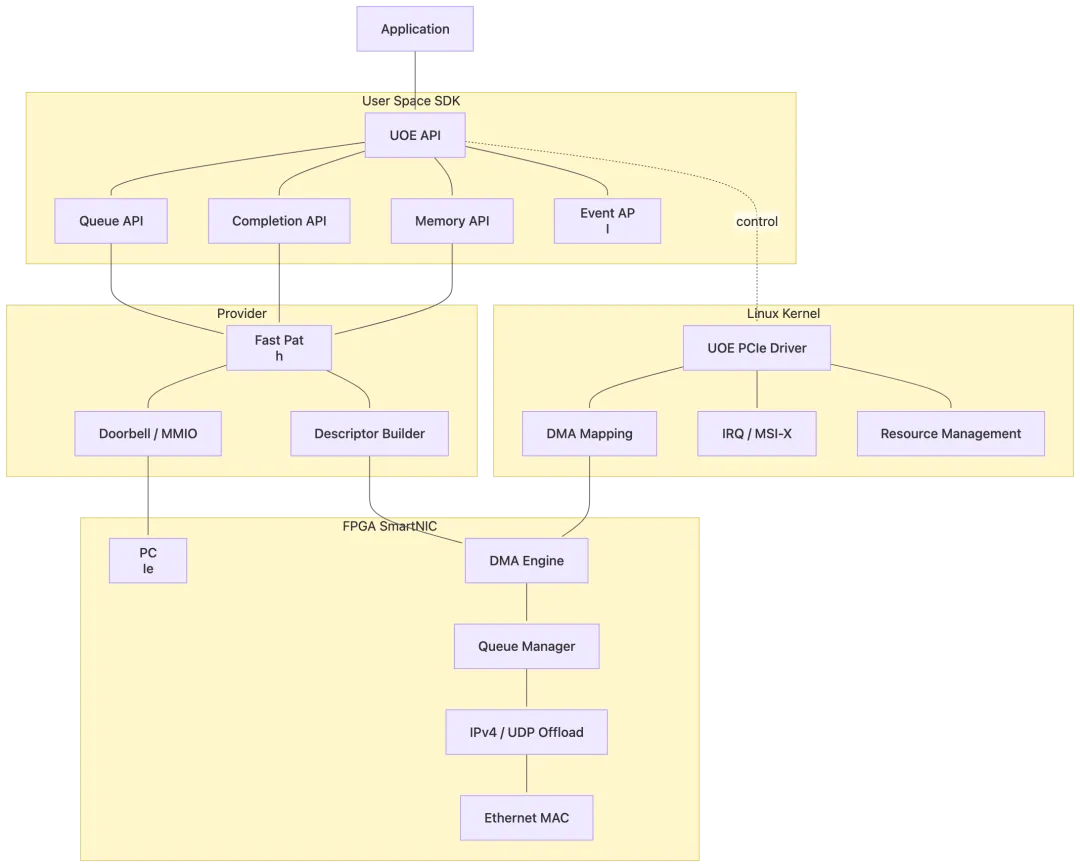
这个架构的最大特点是:
Linux 驱动只负责建立这条高速通道,而不是承担每个 UDP packet 的处理。
19. 三种方案放在一起看
从工程实现角度,可以把当前方案分成三类。
这里的“CPU占用、延迟”不是固定硬件指标,而是典型架构趋势;最终数据必须结合 FPGA、PCIe、CPU、包长和队列模型实测。
AF_XDP 本身已经提供了用户态 UMEM、zero-copy 等机制,因此也值得研究;但它仍然依赖 Linux XDP/socket 基础设施,不等于一个完全独立的 SmartNIC userspace driver。
因此,如果目标是自己掌控 FPGA SmartNIC 的完整产品栈,更值得研究的是:
1 2 3 4 5 libibverbs architecture +DPDK fast-path principles +自定义 FPGA DMA / Queue 而不是简单选择 DPDK 或 Verbs 二者之一。
20. 最小可行产品其实没有想象中复杂
第一版完全没必要做:
1 2 3 4 5 6 7 8 TCPRDMATLSDPDKHugepageNUMARSS多队列调度 可以直接从:
1 2 3 4 5 6 7 1 FPGA1 PCIe Queue1 RX Queue1 TX Queue1 CQ1 DMA Buffer Pool1 MSI-X 开始。
最小数据路径:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 RX:Ethernet ↓UDP/IP FPGA ↓RX DMA ↓Host Buffer ↓RX CQ ↓Event / Poll ↓Application TX:
1 2 3 4 5 6 7 8 9 10 11 12 13 Application ↓TX Buffer ↓TX SQ ↓Doorbell ↓FPGA DMA ↓UDP/IP ↓Ethernet 这已经能够验证最关键的事情:
协议卸载之后,CPU 是否真的退出了数据面。
21. 再进一步,UOE 可以演化成通用 SmartNIC API
当第一版 UOE 成功之后,可以继续扩展:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 libsmartnic │ ┌───────────────┼───────────────┐ │ │ │ UOE TOE RoCE │ │ │ UDP/IP TCP/IP RDMA │ │ │ └───────────────┼───────────────┘ │ Common DMA Layer │ ┌─────────┴─────────┐ │ │ Queue Manager Memory │ │ └─────────┬─────────┘ │ FPGA PCIe 此时真正可复用的就不再只是一个 UDP IP。
而是一套:
1 2 3 4 5 6 7 8 9 10 11 12 13 PCIe DMA+Memory Registration+Queue+CQ+Doorbell+Event+User-space API 这才是个人 FPGA SmartNIC 项目真正值得长期积累的部分。
协议本身可以变化:
1 2 3 4 5 6 UDPTCPRoCEGigE VisionTSNCustom Protocol 但下面这一层:
1 2 3 4 5 DMAQueueMemoryCompletionEvent 高度复用。
22. 最终的技术路线应该这样理解
因此,FPGA SmartNIC 的完整卸载实际上不是:
1 2 3 UDP ↓FPGA 而是:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 ┌─────────────────────────────┐ │ Application │ └──────────────┬──────────────┘ │ User API │ ┌──────────────▼──────────────┐ │ User-space Fast Path │ │ │ │ Queue / CQ / Buffer / MMIO │ └──────────────┬──────────────┘ │ PCIe DMA / Doorbell │ ┌──────────────▼──────────────┐ │ FPGA SmartNIC │ │ │ │ DMA → UOE → MAC │ └─────────────────────────────┘ Linux Kernel │ ┌───────────┼────────────┐ │ │ │ DMA IRQ Resource Mapping Management 只负责控制面 这个架构中:
FPGA 卸载的是协议。
DMA 卸载的是数据搬运。
Queue 卸载的是数据协调。
User-space Fast Path 卸载的是 Linux 网络栈。
四者组合起来,才构成完整的 SmartNIC Offload。
23. 结论:嵌入式 SmartNIC 不应该简单复制 DPDK
DPDK 已经证明了一件非常重要的事情:
高性能网络数据面可以完全脱离 Linux 网络协议栈,由用户态直接管理 NIC Queue、DMA Buffer 和 Descriptor。
但 DPDK 的典型设计是用大量 CPU polling 换取极低的软件开销。其 PMD 模型明确采用轮询 RX/TX descriptor,并强调 per-core queue、batch 和减少异步通知。
对于服务器,这是合理的。
对于资源受限的嵌入式系统,则可以换一种思路:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 DPDK ↓学习 User-space NIC Fast Pathlibibverbs ↓学习 Kernel Control Plane+User Fast Path+Memory Registration+CQ+Event+Provider ArchitectureFPGA ↓自己实现DMA+Queue+UOE+Doorbell+CQ 最终形成:
Verbs-like API + DPDK-like fast path + FPGA-specific DMA/Queue。
这条路线的意义不在于“再造一个 DPDK”。
而在于建立一套适合 FPGA SmartNIC、尤其适合嵌入式平台的用户态网络卸载框架。
对于 UOE、TOE、RoCE、GigE Vision,甚至未来的 TSN 数据面,真正值得长期积累的也不是某一个协议 IP,而是这一套底层能力:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 SmartNIC Software Stack Application / SDK │ Protocol API │ ┌────────────┴────────────┐ │ │ UOE API RDMA API │ │ └────────────┬────────────┘ │ Common Fast Path │ ┌─────────────┼─────────────┐ │ │ │ DMA Queue CQ/Event │ │ │ └─────────────┼─────────────┘ │ PCIe Driver │ FPGA HW 真正可产品化的 SmartNIC,不只是 FPGA 里的协议栈,而是 FPGA + DMA + Queue + Linux Driver + User-space SDK 的完整闭环。
这也是 UOE 从一个“FPGA 网络协议 IP”走向一个真正可用 SmartNIC 平台时,必须跨过的一道门槛。