ARTICLE · 1012443
让AI自己教自己:智谱押上235亿港元,学界刚解出最难一题
字数:约4666字 | 阅读时间:约12分钟
摘要:一周之内,智谱再融资393亿港元、6成投向GLM-6.0"完全自训练",学界发布MetaRSI-v1统一架构:无外部教师,小模型自提升10.9分。本文拆解RSI如何从"固定程序"进化为"可调度的系统",以及AI自我纠错这道最难题的答案。
一、一周之内,产业和学界同时下注
9月12日,智谱在港交所扔出一份公告:配售新H股加发行201.4亿元人民币零息可转债,净募约393亿港元。
钱怎么花,公告写得明明白白:约6成,也就是235亿港元左右,投向下一代GLM基础模型和一套叫"完全自训练"的体系。
这是智谱给RSI起的中文名。RSI,全称递归自我改进(Recursive Self-Improvement),指让模型自己生成训练数据、自己改写提示词、自己修复代码——训练AI这件事本身,开始交给AI。智谱的表述更进一步:下一代GLM将在上一代GLM搭建的环境里训练,形成递归式自我改进的闭环。
两天后的9月14日,学术端跟上。CosmosMind联合斯坦福、伯克利、MIT、清华、北大等十余家海内外高校(据量子位报道)发布MetaRSI-v1,论文挂在arXiv(编号2609.06396),号称全球首个统一Model-RSI、Data-RSI、Harness-RSI的元递归架构。
一个用两百多亿港元买"下一代的训练环境",一个用一套架构回答"改进本身怎么被改进"。
为什么两头同时重注这条路线?
因为大模型行业撞上了一堵墙:人类能标注的优质数据见顶,后训练的边际收益递减。智谱自己的处境就是缩影——8月31日的半年报业绩会上,创始人唐杰刚被问过"智谱是不是只会后训练",他的回答是透露GLM-6.0瞄准自进化。当"喂更好的数据"走到头,剩下的路只有一条:让模型自己当自己的老师。
但这条路上有个比"变强"难得多的障碍,也是唐杰当天亲口点出的:最大的问题是模型能否自己判断"什么时候停止、什么时候纠正自己"。
没有老师的自习课,最难的从来不是刷题。
是知道自己错了。
二、RSI是什么:一场没有老师的自习课
把RSI的行话翻译成自习课的语言,整个领域会瞬间清晰。
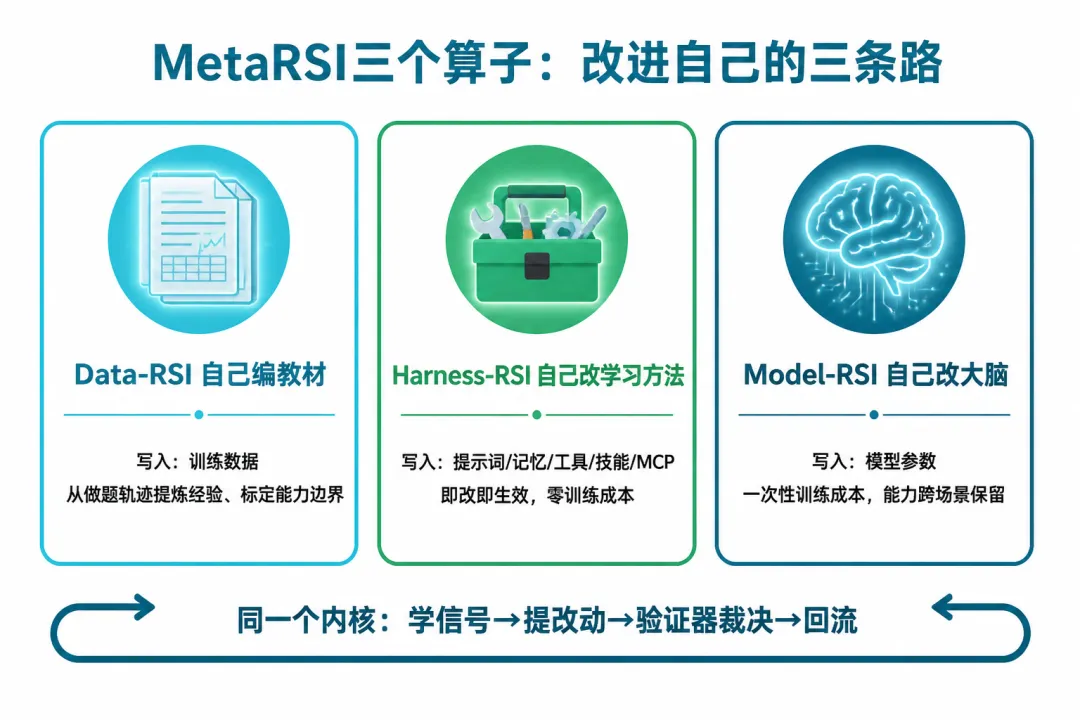
一个AI系统想自我改进,能下手的地方无非三处,对应三种"自己":
RSI行话 | 自习课人话 | 实际在改什么 |
Data-RSI | 自己编教材 | 从自己做题的轨迹里提炼经验,合成新的训练数据 |
Harness-RSI | 自己改学习方法 | 调整提示词、记忆、工具、技能这些"学习装备" |
Model-RSI | 自己改大脑 | 把验证有效的做法训练进模型参数 |
在MetaRSI之前,这个领域的基本盘是:每个团队各改各的。做数据的只做数据,改提示词的只改提示词,训练模型的只管训练。而且几乎所有系统都是同一套结构——一个固定不变的改进程序,反复作用于模型。
MetaRSI论文做了一项不太客气的研究者普查:45个近年自我改进系统里,69%只在机器能免费判卷的任务上闭环——代码能跑通测试、数学能对答案、选择题能对标签。
这不是能力问题,是改卷成本问题。哪个科目好改卷,哪个科目就被反复练习;不好改卷的科目,压根没人开课。论文的措辞很精确:这是格式的约束,不是领域的约束。
三、MetaRSI-v1:把三个"自己"统一成一个系统
MetaRSI-v1做的事,可以概括成一句话:把三条各自为战的改进路线,装进同一台机器,再给这台机器配一个会总结经验的调度员。
3.1 一个内核:教练和裁判不能是同一个人
统一的起点是一条权力边界。任何自我改进,无论改的是数据、装备还是大脑,都被抽象成同一条闭环:读学习信号,提出改动,交给验证器裁决,结果回流成下一轮信号。
关键在裁决环节的设计:模型负责提议"改什么",确定性代码负责判定"改得好不好"。
就像体育比赛里教练和裁判必须分开——教练可以提出任何战术,但比分不由教练说了算。模型的所有奇思妙想,都要过一道它自己改不动的裁判关。这道边界,是后面一切安全设计的地基。
3.2 三个算子:各写各的表面,共用一套流程
在这条内核之上,三个算子分别写入三个互不重叠的表面。Data-RSI从执行轨迹提取学习信号,合成经校验的训练数据,顺便标定"能力边界到哪";Harness-RSI在五个可插拔槽位上做加减法——系统提示词、记忆、内置工具、技能、MCP外挂,即改即生效、零训练成本;Model-RSI用有界训练配方,把反复验证有效的行为刻进权重。
三者还有一层经济学的互补:放在Harness里的能力,每次推理都要重新付一遍上下文成本;内化进Model的能力,训练时付一次,之后免费。所以成熟的循环会持续把能力从贵的载体搬去便宜的载体,甚至反过来删掉脚手架里的冗余——能力留下,成本退场。
3.3 两个数据锚点
第一个锚点:35B总参、3B激活的Qwen3.5-35B-A3B,在没有任何外部教师模型的情况下,四项基准平均自我提升10.9分。
10.9分是什么概念?换成学生视角:一个中等生,没有请任何家教,靠自己整理错题、自己调整学习方法,四门考试总分拉高了整整一档。其中SWE-bench Pro的解决率从10.3%涨到19.5%,接近翻倍;AIME提了13.3分,GPQA高难度子集提了12.6分。
第二个锚点更反常识,也是各家报道普遍略过的细节:"谁来决定顺序"本身值3.6分。
实验设计得很狠:同样三个算子、同样预算,一组按人工固定顺序执行(先数据、再模型、后脚手架),平均提升7.3分;一组由MetaRSI动态调度,提升10.9分。差的3.6分,唯一的变量是排班的人选。
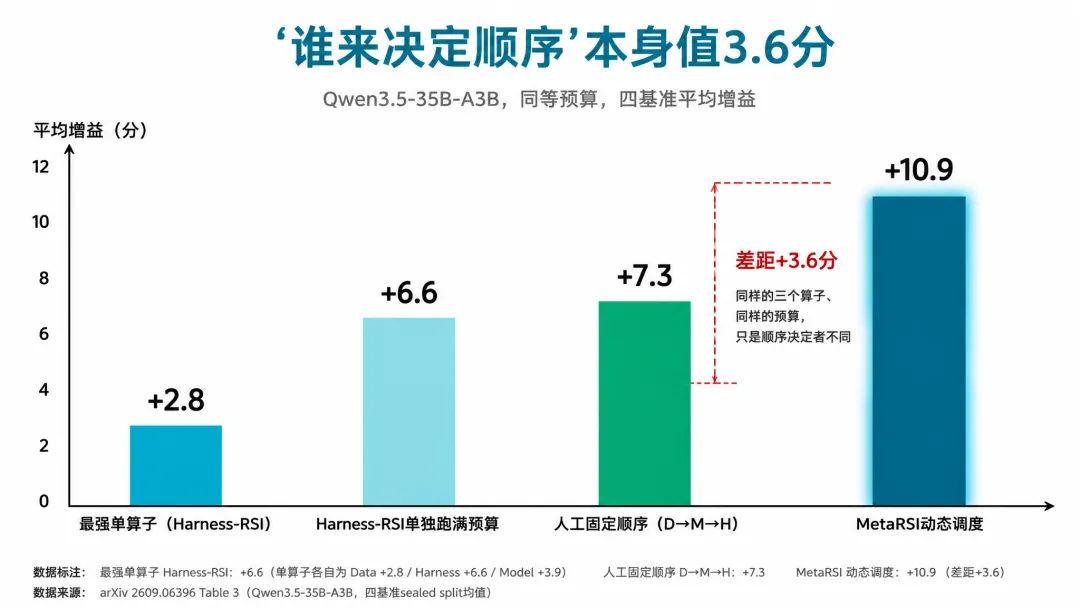
调度不是记流水账,调度是承重组件。
原因藏在顺序的副作用里:改了脚手架,模型的行为就变了,之前积累的数据描述的已经是"上一个自己",拿旧数据训练新自己,等于把过期的教材塞给学生。MetaRSI的调度员懂得避开这类坑——它知道什么信号过期了、什么顺序是死路。
3.4 元层:改进"改进者"本身
再往上一层是MetaRSI名字里"Meta"的由来。一个改进周期结束后,有个元层Agent复盘整场执行:哪些步骤的增益通过了发布闸门、哪些预算打了水漂、调度策略哪里判断失误——然后改写调度员自己的策略。
改进系统、改进算子用法、改进调度策略,三层嵌套,这就是论文说的"元递归"。连续五轮自我进化的累计增益,有元层是+26.2分,没有是+20.7分,而且衰减更晚、天花板更高。
还有个国产彩蛋:六款被送进这套循环的前沿模型里,就有GLM-5.2,自我提升+5.6分。智谱的押注不是空想——自家上一代模型,已经出现在这条路线的被试名单上。
本章关键洞察:MetaRSI的核心贡献不是某个更强的算子,而是证明了"组合与调度"本身就是增益来源——统一架构的价值,在于让1+1+1第一次大于3。
四、产业赌注与学术答案:AI怎么知道自己错了
现在把两条线放到一张桌上。
智谱"完全自训练" | 论文侧对应 | 对应程度 |
数据自产(自我对弈、规则校验、模型评审) | Data-RSI(轨迹提炼、盲测校验合成) | 直接对应 |
环境自造(智能体采集任务、自生成验证器) | Data-RSI+Harness-RSI的组合地带 | 部分重叠 |
基础设施自我优化(模型优化算子、内核、调度) | 超出论文范围 | 智谱独有 |
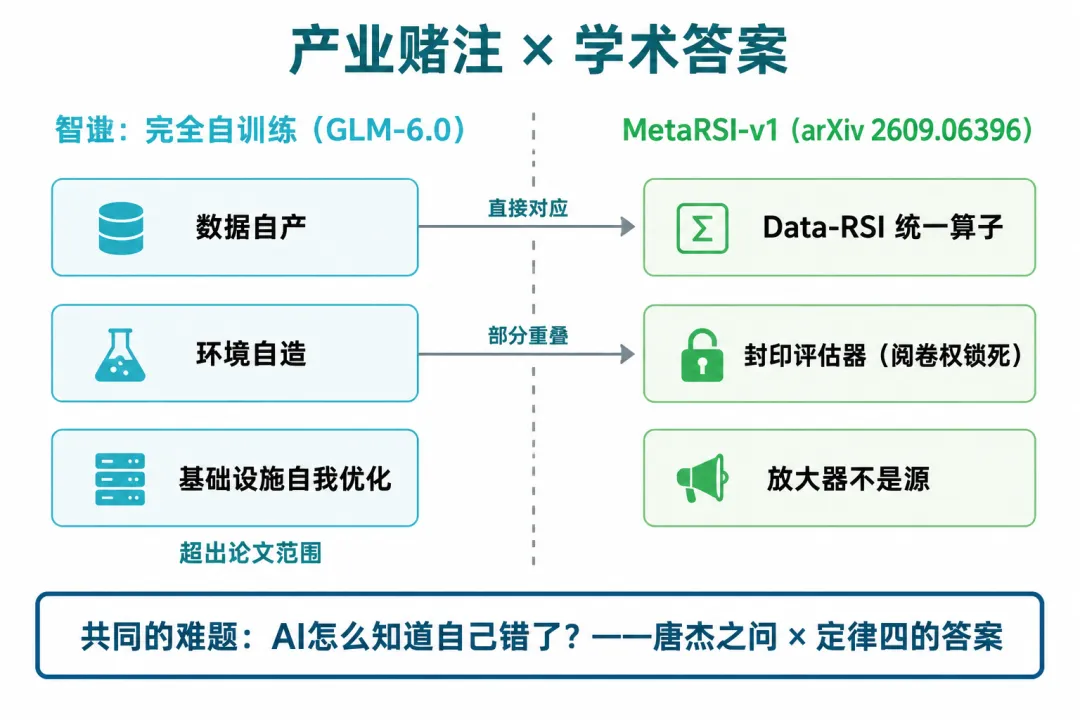
真正的咬合点不在表格里,在唐杰那句"模型怎么知道自己错了"上。论文恰好用两层设计回答了这道题。
第一层叫封印评估器(sealed evaluator):最终阅卷权——评测集、评分规则、发布闸门——锁死在所有可写表面之外。系统再怎么自我改进,也改不到"成功的定义"上。想提分?只能真的变强,不能改标准。
为什么必须这么设计?论文的定律四说得透彻:在闭环内部,真变强和放宽成功标准,会得到完全相同的分数——而且这种偏差从内部无法察觉,统计手段也纠正不了。学生自己给自己打分,努力和放水看起来一模一样。唯一的解法是把阅卷权交给系统够不着的地方。
第二层更根本,定律五:循环不凭空创造能力。
论文有句提纲挈领的话,"An amplifier is not a source"——放大器不是源。自我改进只能重新组织、放大、固化模型已有的潜力,新知识必须从外部输入。Data-RSI在架构里专门负责标定"哪些能力是模型从未展现过的",这个边界之外的部分,才是真需要人类监督的地方。
知道"自己不知道什么",比变强更关键。这既是论文的结论,也恰好是唐杰那个问题——什么时候停止、什么时候纠正自己——在架构层面的答案。
五、与读者何干:AI迭代方式的换挡
论文立场部分有句话值得单独拎出来:进步的单位不是模型,是循环(the unit of progress is the loop, not the model)。
过去我们谈AI进步,单位是"发布":GPT-5到GPT-5.6,GLM-5到GLM-5.3,一次版本号一跳。RSI把单位换成了循环:模型在一个持续运转的改进闭环里逐轮变强,版本号只是循环的里程碑。六款前沿旗舰在这套循环里平均自提升7.3分、三轮累计11.3分、舰队均值从80.0爬到91.3——意味着现在的顶级模型全都留有大额自我改进空间,模型变强不再只靠等发布会。
对普通开发者和企业用户,这条路线有三个直接含义。其一,API背后的模型会持续静默变强,同一套提示词的产出质量会漂移,评估要常态化。其二,智谱的235亿港元买了"下一代的训练环境",GLM-6.0的竞争力锚点将从"单次训练成果"转向"闭环运转效率",选型时值得盯这个指标。其三,论文配套的RSI-Harness已开源(GitHub搜CosmosMind-ai/RSI-Harness),一个能自我迭代的执行脚手架,技术团队现在就能上手试。
冷静看的部分也要说足三点。第一,增益全部产生在机器可判卷的任务上——代码、数学、选择题;临床、法律、历史这些没有标准答案的领域,闭环还无从谈起,论文自己把这叫"验证器阶梯"上的空白地带。第二,增益逐轮递减,单轮收益从4.9分量级滑到1.4分量级,是减速曲线而非指数爆炸。第三,媒体标题里的"RSI进入平方时代"是修辞不是术语——论文的措辞是"元递归":改进的是改进本身,不是无穷次方。
分清哪些是把已有能力放大,哪些是真正从外部引入新知——这个判断力,看懂这篇论文的人也该用在自己身上。
六、结尾
产业端花钱买训练环境,学术端出架构解纠错难题。智谱的235亿港元和MetaRSI的+10.9分,押的是同一个未来:AI的进步方式本身,正在被改写。
接下来盯三个观察点:GLM-6.0正式发布时"完全自训练"兑现到什么程度;RSI-Harness的开源社区能不能长出生态;以及最说明问题的信号——其他大厂何时跟进这条路线。
让AI自己改自己,最难的不是让它变强。
是让它知道自己什么时候错了。
这道题,产业和学界现在都在解。
---
景桁AI笔记 | 见智·AI实战
技术出身的创业者,深度研究AI在产品和商业中的应用
AI工具测评、实战案例、产品设计指南
---
相关话题:#智谱 #GLM #RSI #递归自我改进 #MetaRSI #AI自我进化 #大模型 #AGI #景桁AI笔记
---
延伸阅读:
《DeepSeek Harness对标Claude Code》(景桁AI笔记,2026.8.12)——Harness是什么、五槽位长什么样,本文Harness-RSI的预备知识,建议先读
《DeepSeek Harness多模态三级跳》(景桁AI笔记,2026.8.22)——Harness工程化的演进叙事,与本文"脚手架自我改进"对照着读
《国产多模态三强横评》(景桁AI笔记,2026.8.27)——GLM-5.3-Flash的表现底色,看智谱产品线的基本盘
《AI商业化分叉:OpenAI狂烧钱vs智谱真盈利》(景桁闻道,2026.4.2)——智谱的融资节奏与商业化逻辑,本文393亿港元再融资的背景板
---
参考链接:
[MetaRSI论文(arXiv:2609.06396)](https://arxiv.org/abs/2609.06396)
[量子位:AI开始改进"改进自己的方法",RSI进入平方时代丨MetaRSI](https://www.qbitai.com/2026/09/488832.html)
[量子位:智谱提前剧透下一代GLM:完全自训练方法公开了](https://www.qbitai.com/2026/09/488694.html)
[智谱港交所公告(2026年9月,据量子位转引)](https://ea-cdn.eurolandir.com/press-releases-attachments/4179721/HKEX-EPS_20260913_12330384_0.PDF)
[华尔街见闻:GLM-6.0递归式自我改进闭环](https://wallstreetcn.com/articles/3781669)
[新浪财经:唐杰称GLM-6.0定位全自训练技术路线](https://finance.sina.com.cn/stock/estate/integration/2026-08-31/doc-iniqfqsp8740606.shtml)
[RSI-Harness开源项目(GitHub)](https://github.com/CosmosMind-ai/RSI-Harness)
[CosmosMind官网](https://cosmosmind.ai/)
景桁 | 构架愿景,创造未来
闻道·致知·格物·见智·守正·明医
—— 景桁AI笔记 ——
见智·发现AI的真正价值
本文由 景桁AI笔记 原创,欢迎转发分享
转载请注明出处,商业合作请联系作者
如果觉得有用,请点个"在看",让更多人看到
本文配图由 AI 辅助生成