ARTICLE · 1014193
高中数学—9.1随机抽样(必修二)
总体与个体、全面调查(普查)
教学过程
(一)情境导入
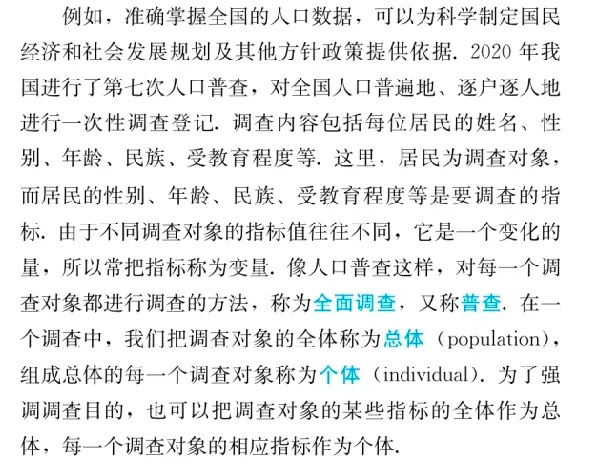
展示人口普查现实情境:国家制定经济社会发展政策,需要准确的人口数据。
引出第七次全国人口普查,从生活实例进入统计概念学习。
(二)新知讲授
1、结合课本材料,分析第七次人口普查案例:
调查对象是居民;性别、年龄、民族、受教育程度这些是调查的指标,指标取值会变化,也叫变量。
2、讲解全面调查(普查):
对每一个调查对象都进行调查的调查方法,又叫普查。
3、讲解总体、个体:
调查对象的全体叫作总体;组成总体的每一个调查对象叫作个体。
4、补充说明:也可以把调查对象某些指标的全体作为总体,每一个调查对象对应的指标作为个体。
5、结合人口普查举例辨析,厘清调查对象、指标、变量、总体、个体之间关系。
(三)概念辨析
1、设置简单辨析:人口普查当中,总体是全体居民;每一位居民是个体;性别、年龄是调查指标也就是变量。
2、强调概念易混点:不要把指标和调查对象混淆。
(四)课堂小结
引导学生梳理本节课概念:普查、总体、个体、调查对象、变量(指标),学生发言总结,教师补充完善。
(五)布置作业
整理课本当中各个统计概念;
举一个生活当中普查的实例,写出对应的总体和个体。
试讲
我今天试讲的题目是《总体与个体、全面调查》,下面开始我的试讲。
上课,同学们好,请坐。
同学们,大家想一想,我们国家要制定国民经济、社会发展的相关政策,需要哪些参考依据呢?
没错,像人口数量这样的数据就十分重要。准确掌握全国人口的数据,可以帮助我们科学制定各类方针政策。在二零二零年,我国开展了第七次全国人口普查,今天我们就借助人口普查这个实例,来学习统计当中的一组重要概念。
大家请看大屏幕上的材料。
这次人口普查,是对全国人口普遍地、逐户逐人地进行一次性调查登记。
那大家思考,这次调查当中,我们的调查对象是谁呢?第一排同学你来。
回答很好,请坐,调查对象就是居民。
那我们调查居民的哪些内容?
对,居民的姓名、性别、年龄、民族、受教育程度等等。这里的性别、年龄、民族、受教育程度,这些就是我们要调查的指标。
大家观察,不同居民,年龄不一样,性别不一样,受教育程度也不一样,指标的值是会发生变化的,所以我们也常常把指标称为变量。
那什么叫做全面调查呢?
大家看,人口普查,我们对每一个调查对象都进行调查,像这样,对每一个调查对象都进行调查的方法,就叫做全面调查,也叫作普查。
接下来我们学习两个核心名词,总体与个体。
大家阅读课本找一找,什么是总体,什么是个体?靠窗这位同学,你来说。
很不错,请坐。
在一次调查当中,我们把调查对象的全体称为总体,组成总体的每一个调查对象,称为个体。
放到人口普查的例子,全体居民就是总体,每一位居民就是个体。
这里有一个大家容易忽略的点,课本还做了补充说明。
为了强调调查目的,我们也可以把调查对象的某些指标的全体作为总体,把每一个调查对象相应的指标作为个体。
举个例子,如果我们研究全国居民的年龄,那么全体居民的年龄构成总体,每一位居民的年龄就是个体。
大家要区分清楚,调查对象和调查的指标,二者不能混淆。
老师再来考考大家。在第七次人口普查当中,如果我们研究民族这个变量,总体是什么?
对,全体居民的民族;个体就是每一位居民的民族。大家一定要灵活理解总体和个体。
好了,新知识学完了,哪位同学帮我们梳理今天学习的概念?最后一排这位同学,请你来说。
总结的很不错,请坐。
这节课我们通过第七次人口普查,认识了调查对象、指标也就是变量;学习了全面调查也叫普查,就是对每一个调查对象都调查;还学习总体是调查对象的全体,个体是每一个调查对象;同时总体也可以是某些指标的全体。统计概念一定要结合实例去理解。
课后作业:把今天学习的概念整理到笔记本;自己举出一个生活当中普查的例子,写出对应的总体与个体。
本节课到此结束,下课。
板书设计
总体与个体、全面调查
实例:第七次人口普查(2020 年)
调查对象:居民
调查指标(变量):性别、年龄、民族、受教育程度
全面调查(普查)
对每一个调查对象都进行调查。
总体与个体
①总体:调查对象的全体
②个体:组成总体的每一个调查对象
补充:
也可将【指标的全体】作为总体,每一个调查对象的对应指标作为个体。
举例:人口普查
总体:全体居民
个体:每一位居民
区分:调查对象 ≠ 调查指标(变量)
抽样调查
教学过程
(一)复习导入
1、全面调查也就是普查,以人口普查为例,指出普查耗费大量财力物力,不能经常开展。
2、抛出问题:想要及时了解人口变动情况,又不能年年做普查,该怎么办?
(二)新知讲授
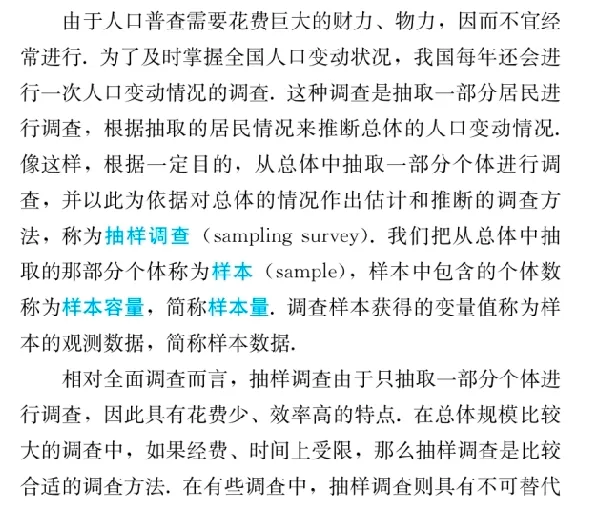
1、以我国每年人口变动情况调查为例讲解抽样调查概念:从总体当中抽取一部分个体开展调查,依据这部分结果去估计推断总体情况,这种方式叫做抽样调查。
2、接着讲解样本、样本容量、样本数据:抽取出来的那一部分个体叫样本;样本当中包含的个体数量叫样本容量,简称样本量;样本调查得到的变量值叫样本观测数据,简称样本数据。
3、对比全面调查,总结抽样调查优点:花费少、效率高;适合总体规模大、时间经费有限的场景。
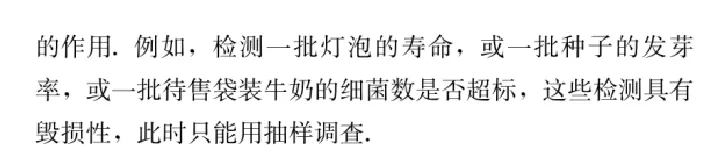
4、讲解特殊场景:当检测具备毁损性,不能全部检测,只能抽样调查。
5、结合课本例子:检测灯泡寿命、种子发芽率、袋装牛奶细菌数,说明为什么不能普查。
(三)概念辨析
强调易错点:样本容量是数目,没有单位。
对比全面调查与抽样调查的适用条件。
(四)课堂小结
引导学生梳理抽样调查相关概念,对比普查与抽样调查,学生发言总结,教师补充。
(五)布置作业
整理本节课概念;
举出两个生活中适合抽样调查的实例,说明理由。
试讲
我今天试讲的题目是《抽样调查》,下面开始我的试讲。
上课,同学们好,请坐。
上节课我们学习了全面调查,也就是普查,就像第七次全国人口普查,可以把所有调查对象全部调查一遍。
大家想一想,人口普查要耗费巨大的财力物力,能不能年年开展普查呢?
这位靠窗同学,你来说。
说得非常好,请坐。
普查成本太高,不适合经常进行。可是国家又需要及时掌握全国人口的变动状况,那我们有什么别的办法吗?
这就是今天我们要学习的抽样调查。
大家看课本,我国每年都会开展人口变动情况调查,它不会调查全部居民,而是抽取一部分居民做调查,再用这一部分居民的情况,去推断全国总体人口变动情况。
那什么叫做抽样调查呢?请大家齐读课本定义。
根据一定目的,从总体中抽取一部分个体进行调查,并以此为依据,对总体的情况作出估计和推断,这样的调查方法就叫做抽样调查。
这里又出现了一组新名词。从总体抽取出来的那一部分个体,我们称之为样本。
样本里面包含的个体数目,叫做样本容量,也简称样本量。
大家要注意,样本容量只是数字,是个数,是不带单位的。
我们调查样本得到的变量值,叫做样本的观测数据,简称样本数据。
我来考考大家,人口变动调查当中,被抽取到的这一部分居民是什么?
第一排同学你来。
很好,请坐,被抽取的一部分居民就是样本;抽取了多少位居民,这个数字就是样本容量。
那对比我们之前学习的全面调查,抽样调查有什么样的优点呢?大家思考一下。
来,中间这位同学。
回答很不错,请坐。
因为抽样调查只抽取一部分个体,所以它花费少、效率高。
当总体规模很大,经费、时间有限的时候,抽样调查就非常合适。
还有一类场景,抽样调查有着不可替代的作用。
大家想一想,如果我们要检测一批灯泡的使用寿命,把每一个灯泡全部用到烧坏才测寿命,这批灯泡是不是就全部报废了?
像这种检测会破坏产品,我们叫做毁损性检测。
课本还举了例子,检测一批种子的发芽率,检测袋装牛奶细菌数是否超标,这些都具备毁损性。
如果做全面调查,全部产品都会被破坏,那就失去意义,这种时候,就只能使用抽样调查。
那我们简单梳理:经费充足、总体不大、不具备破坏性,可以选全面调查;总体庞大、经费时间有限,或者检测带有毁损性,就要选用抽样调查。
好了,新知识学完了,哪位同学帮我们总结今天学习的内容?最后一排这位同学,请你来说。
总结得很完整,请坐。
今天我们学习了抽样调查,从总体抽取部分个体,用样本推断总体;认识了样本、样本容量、样本数据;知道抽样调查花费少效率高;尤其记住,具有毁损性的检测,只能用抽样调查,同时我们也对比了抽样调查和全面调查的适用场景。
课后作业:整理本节课的概念;举出两个生活中适合抽样调查的例子,并说明理由。
本节课到此结束,下课。
板书设计
抽样调查
1、抽样调查:
从总体抽取一部分个体调查,以此估计、推断总体。
2、相关概念
样本:从总体抽取的一部分个体
样本容量(样本量):样本中个体的数目(只有数字,无单位)
样本数据:样本得到的观测数据
3、抽样调查特点
花费少、效率高;适合总体规模大,时间经费有限
4、只能抽样调查:毁损性检测
例:灯泡寿命、种子发芽率、牛奶细菌数
对比
全面调查(普查):调查全部个体,成本高
抽样调查:调查部分个体,推断总体
简单随机抽样
教学过程
(一)复习导入
1、抽样调查的概念:从总体抽取部分个体作为样本,用样本推断总体。
2、引出问题:怎样抽样才公平?
(二)新知讲授
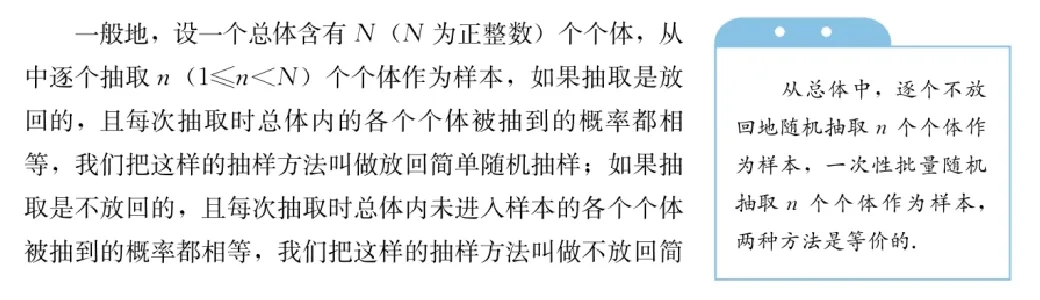
1、给出总体有 N 个个体,抽取 n 个个体做样本的大前提。
2、讲解放回简单随机抽样:逐个抽取,抽取之后放回,每次抽取,总体里每一个个体被抽到概率相等。
3、讲解不放回简单随机抽样:逐个抽取,抽取之后不放回,每次抽取,还没进入样本的各个个体被抽到概率相等。
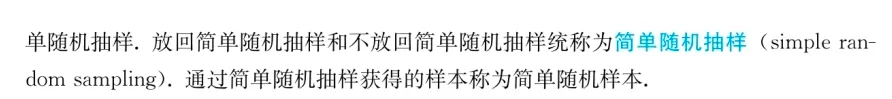
4、点明二者统称简单随机抽样,得到的样本叫简单随机样本。
5、辨析关键点:不放回抽样当中,逐个不放回抽取 n 个个体,和一次性批量抽取 n 个个体,两种方式是等价的。
(三)概念辨析
1、对比放回与不放回抽样的区别:一个抽取后放回,个体可以被重复抽到;一个抽取后不放回,个体不会重复入样。
2、强调核心条件:抽样过程当中个体被抽到的概率相等,保证抽样公平。
(四)课堂小结
梳理放回、不放回简单随机抽样,简单随机抽样、简单随机样本,还有两种抽取方式等价这个知识点。
(五)布置作业
1、整理本节课概念;
2、思考生活当中哪些场景适合放回简单随机抽样,哪些适合不放回简单随机抽样。
试讲
我今天试讲的题目是《简单随机抽样》,下面开始我的试讲。
上课,同学们好,请坐。
上节课我们学习了抽样调查,我们从总体当中抽取一部分个体作为样本,依靠样本的数据推断总体情况。
那大家思考,我们要想让样本能够很好代表总体,抽样的时候最重要要保证什么呢?靠窗这位同学,你来说。
说得很好,请坐,抽样一定要保证公平,每一个个体被抽到的机会要一样。
那怎样做到公平抽样,这就是今天我们学习的简单随机抽样。
大家请看大屏幕。
一般地,假设一个总体含有 N 个个体,N 是正整数,我们要从中抽取 n 个个体作为样本,这里 n 大于等于一,并且 n 小于 N。
这里有两种抽样方式。
第一种,放回简单随机抽样。它是逐个抽取 n 个个体,抽取之后是放回去的,并且每一次抽取的时候,总体内部的每一个个体,被抽到的概率全部相等。抽取完一个个体,把它放回总体,之后继续抽,这个个体还有机会再次被抽中,这就是放回简单随机抽样。
那什么是不放回简单随机抽样呢?第一排同学你来读一读对应的定义。
很好,请坐。
抽取的时候不放回,每一次抽取,总体里面还没有进入样本的各个个体,被抽到的概率相等。抽走一个,这个个体就不再放回总体,不会重复被抽到,这就是不放回简单随机抽样。
大家注意,放回简单随机抽样和不放回简单随机抽样,这两类,我们统称为简单随机抽样。通过简单随机抽样得到的样本,叫做简单随机样本。
这里课本还给我们补充了一个重要知识点。对于不放回抽样,从总体当中,逐个不放回地随机抽取 n 个个体作为样本,和一次性批量随机抽取 n 个个体作为样本,这两种方法是等价的。
也就是说,不管我们一个一个拿出来,还是一次性拿出来,最终得到的样本效果是一样的。
那我们来对比一下两种抽样。
放回抽样,个体有可能被重复抽取;不放回抽样,每个个体最多只能出现一次。
但是它们有一个共同点,就是抽样的时候,个体被抽到的概率相等,保证抽样公平,这也是简单随机抽样的核心。
老师考考大家,如果总体有十个人,我们抽取两个人做样本,采用不放回简单随机抽样,一次性取出两个人,和先后逐个取出两个人,效果一样吗?
没错,是等价的。
好了,新知识学习完毕,哪位同学来梳理本节课学到的内容?最后一排这位同学,请你来说。
总结的很不错,请坐。
今天我们学习了放回简单随机抽样和不放回简单随机抽样,知道二者合起来叫简单随机抽样,对应的样本是简单随机样本;抓住核心就是抽样过程个体被抽到概率相等;同时记住,不放回抽样中逐个抽取与一次性批量抽取是等价的。
课后作业,整理本节课全部概念;想一想,生活当中哪些场景适合放回简单随机抽样,哪些适合不放回简单随机抽样。
本节课到此结束,下课。
板书设计
简单随机抽样
前提:总体 N 个个体,抽取 n 个样本,1≤ n<N
1、放回简单随机抽样
逐个抽取,抽取后放回;每次抽取,总体各个个体被抽到概率相等。
2、不放回简单随机抽样
逐个抽取,抽取后不放回;未入样的个体被抽到概率相等。
统称:简单随机抽样
得到样本:简单随机样本
补充:
不放回抽样:
逐个不放回抽取 n 个个体 ⇔ 一次性批量抽取 n 个个体,二者等价
核心:个体被抽到的概率相等,保证抽样公平
区分:放回可重复抽到个体;不放回不重复抽取个体
简单随机抽样的方法
教学过程
(一)复习导入
1、简单随机抽样概念。
2、出示家具厂调查高一 712 名学生平均身高的实际问题。
3、提出问题:我们该如何具体实施简单随机抽样抽取样本?
(二)新知讲授(以 712 名学生为例)
1、抽签法
步骤:编号→制作号签→充分搅拌→不放回逐个抽取号签得到样本。
优缺点:简单易行;总体个体数目大时操作麻烦,适合总体个体数不多的情况。
提问:为什么要编号,用学号可以吗?引导学生明白编号目的统一格式方便抽取。
2. 随机数法
步骤:编号,生成一到七百一十二之间整数随机数,抽中对应编号;出现重复随机数就要剔除重复编号,继续生成,凑够样本数量。
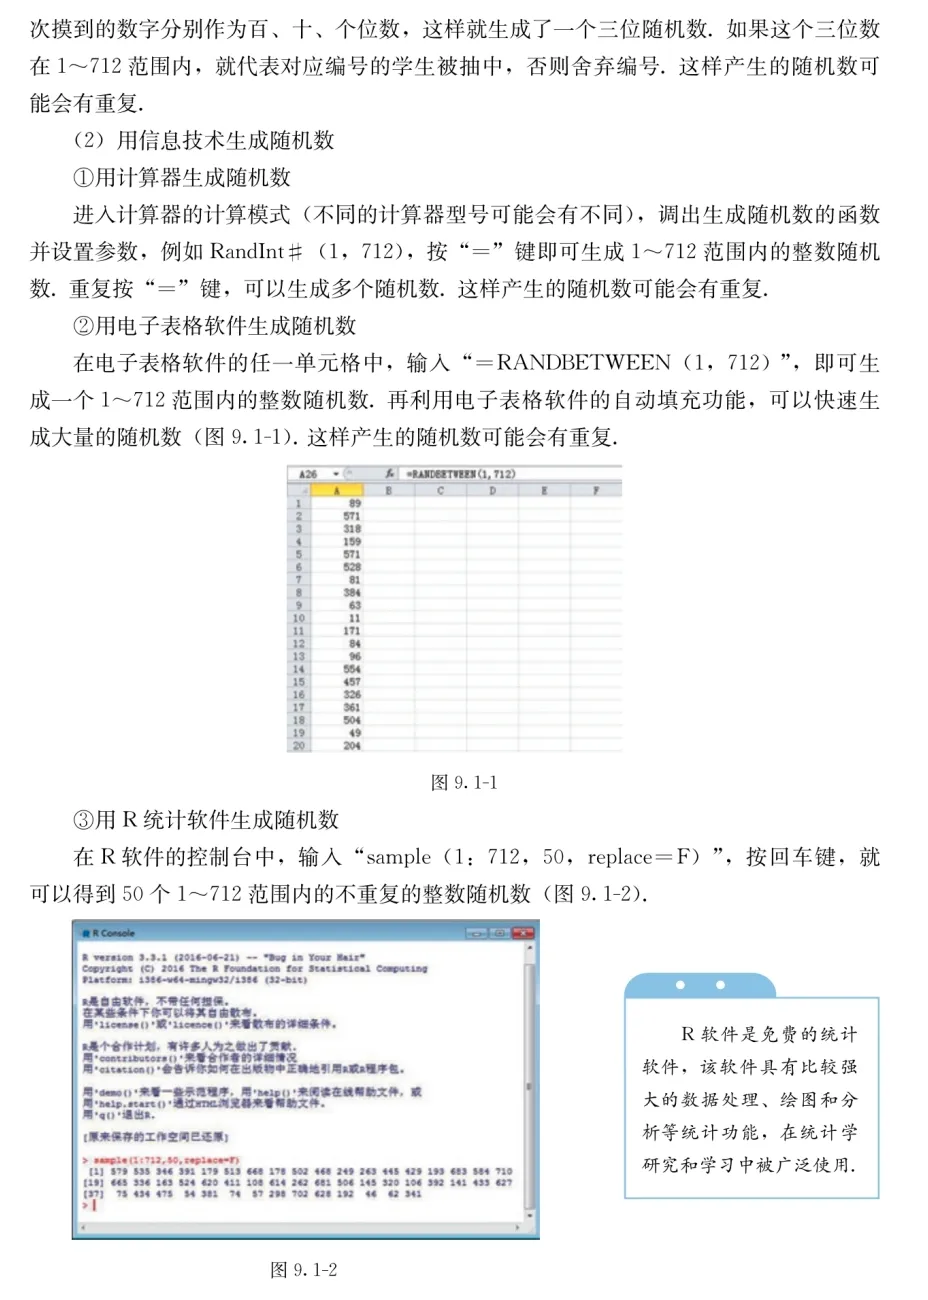
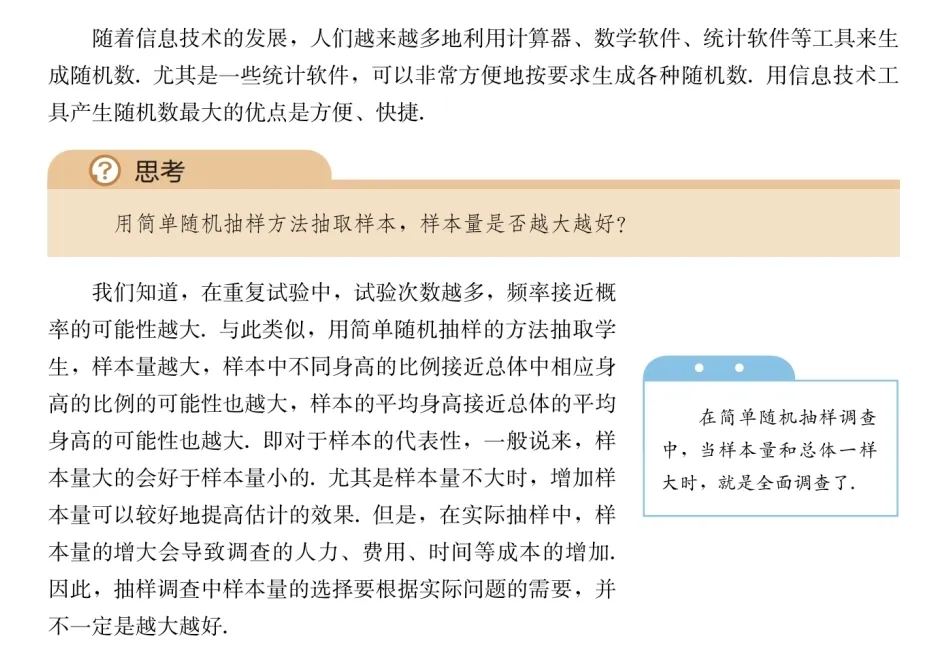
讲解三种生成随机数途径:随机试验小球摸取、计算器、电子表格软件、R 统计软件。
对比抽签法与随机数法优缺点,信息技术生成随机数优点是方便快捷。
(三)探究思考:样本量是否越大越好
组织学生思考讨论。
从两方面分析:样本量大,样本代表性会更好;但是样本量增大,人力、金钱、时间成本随之增加。
总结:样本量要结合实际需求选择,并非越大越好;样本量等于总体数量时就是全面调查。
(四)课堂小结
归纳抽签法、随机数法步骤,二者适用条件,样本量选取原则。
(五)布置作业
整理两种抽样方法步骤;
课后找一个生活实例,分别说一说怎样用抽签法、随机数法抽样。
试讲
我今天试讲的题目是《简单随机抽样的方法》,下面开始我的试讲。
上课,同学们好,请坐。
上节课我们学习了什么叫做简单随机抽样,知道抽样要保证公平。
那老师带来一个现实的问题,有家家具厂,要给树人中学高一同学制作课桌椅,高一总共有七百一十二名学生,想要通过简单随机抽样,调查全体高一学生平均身高,那我们具体该怎么抽取样本呢?
这就是我们今天要学习的内容。
大家先来思考,如果用抽签法完成抽样,我们该做哪些操作?
第一排同学你来说一说你的想法。
很好,请坐。
这位同学说到要先给学生编上号码。
我们第一步,先给七百一十二名学生编号,可以编为一到七百一十二。
接下来,我们把全部编号写在外观质地没有差别的小纸片上,当做号签,全部放进不透明盒子里面,充分搅拌均匀。
之后,从盒子当中不放回地逐个抽取号签,和号签编号对应的学生就进入我们的样本,一直抽到满足样本需要的人数就可以。这就是抽签法完整步骤。
大家想一想,为什么一定要编号?直接拿学生的学号当做编号行不行?
靠窗这位同学,你来说。
说得非常到位,请坐。
编号的目的是统一格式,方便抽取,学号当然可以拿来直接作为编号。
那抽签法有什么长处和短处呢?最后一排这位男生。
没错,请坐。
抽签法简单,很好操作。
可是,如果总体里面个体数量很大,做号签、搅拌号签就会十分麻烦。所以抽签法适合总体个体数目不多的情况。
那总体数目比较大的时候,我们还有另外一种办法,叫做随机数法。
我们依旧以七百一十二名同学为例。
第一步同样给学生进行编号一到七百一十二。接着我们要生成一到七百一十二这个范围里面的整数随机数,抽中随机数对应的编号,对应的学生就进入样本。
这里要注意,如果生成的随机数出现重复,同一个编号被多次抽中,我们要剔除重复编号,重新产生随机数,直到得到足够多不一样的编号。
那随机数可以怎么得到呢?
大家看大屏幕。
第一种,可以做随机试验,准备十个一模一样的小球,写上数字零到九,放回摸取三次,得到百位十位个位,组成三位随机数,落在一到七百一十二就保留,不在这个范围就舍弃。
第二种,借助信息技术。计算器、电子表格软件,还有 R 统计软件,都可以直接生成指定范围随机数。信息技术工具最大优点就是方便、快捷。
大家对比抽签法和随机数法,二者各有什么优缺点?
中间第三排同学,你来谈谈。
回答很有见解,请坐。
抽签法适合小总体,操作手工完成;随机数法适合总体较大,借助计算机工具效率更高。
学到这里,老师有一个思考问题抛给大家:做简单随机抽样的时候,样本量是不是越大就越好?
给大家一点时间思考,哪位同学愿意分享?举手最高的这位同学,你来。
很不错,请坐。
这位同学考虑到两个角度。样本量越大,样本里面数据比例接近总体的可能性就越大,样本代表性会更好。
但是现实当中,样本量变大,调查耗费的人力、费用还有时间也都会增加。
所以,样本量要结合实际问题的需要去选择,不一定越大越好。补充一点,如果样本量和总体数量一样大,那这就变成全面调查了。
好了,新知识学完。谁来帮我们梳理本节课学到的全部内容?
来,第二排这位女生。
总结很完整,请坐。
今天学习了简单随机抽样两种实施方法:抽签法、随机数法,掌握各自操作步骤和适用情形,同时我们明白了样本量不是越大越好,需要兼顾代表性和现实成本。
课后作业,整理抽签法、随机数法的操作步骤;找一个生活当中调查的例子,想一想分别如何用两种方法抽样。
本节课到此结束,下课。
板书设计
简单随机抽样的方法
实例:712 名高一学生,调查平均身高
1. 抽签法
步骤:
①编号(1~712,学号可用)
②制作号签
③充分搅拌
④不放回逐个抽取,得到样本
特点:简单易行;适合总体个体数不多
总体大时操作麻烦
2. 随机数法
步骤:
①编号
②生成 1~712 随机数
③剔除重复编号,凑够样本数量
获取随机数途径:
1)小球随机试验
2)计算器、电子表格
3)R 统计软件
优点:方便快捷
思考:样本量越大越好?
样本量大:代表性更好
但是:人力、时间、费用成本增加
→按实际需求选择,并非越大越好
样本量 = 总体:就是全面调查
对比:抽签法适合小总体;随机数法适合大总体
总体均值与样本均值
教学过程
(一)复习导入
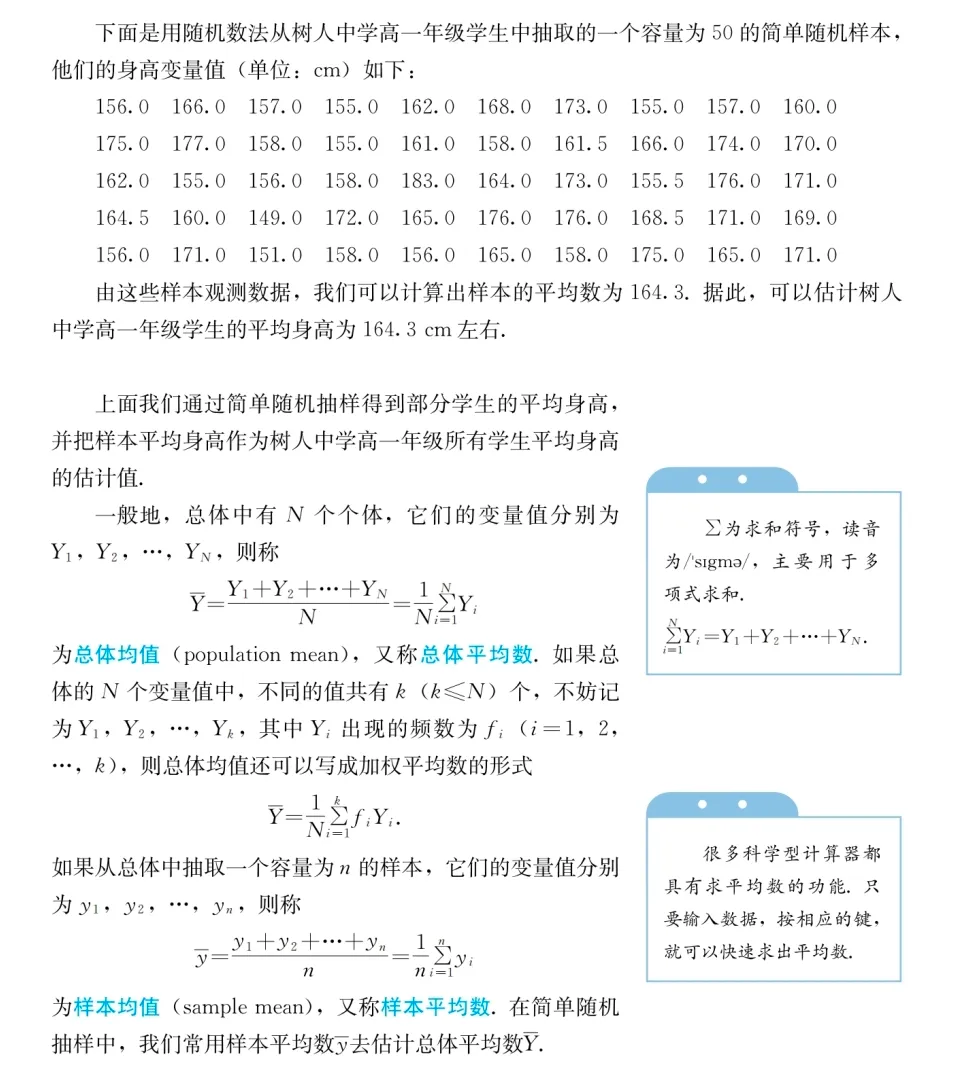
1、简单随机抽样:树人中学高一 712 名学生,抽取容量为 50 的样本,得到 50 个身高数据。
2、提出问题:拿到样本数据之后,如何估计全体高一学生平均身高?
(二)新知讲授
1、结合实例,给出样本均值概念。
50 个样本身高,把 50 个身高求和再除以五十,算出样本平均数 164 点 3,用这个数值去估计高一全体学生平均身高。
引出求和符号 Σ,说明读音 sigma,用来做多项式求和。
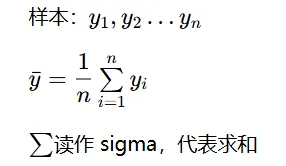
给出样本均值公式。
2、讲解总体均值:
点明统计核心思想:简单随机抽样当中,用样本均值去估计总体均值。
补充科学计算器可以快速求平均数。
(三)探究活动:样本平均数的随机性
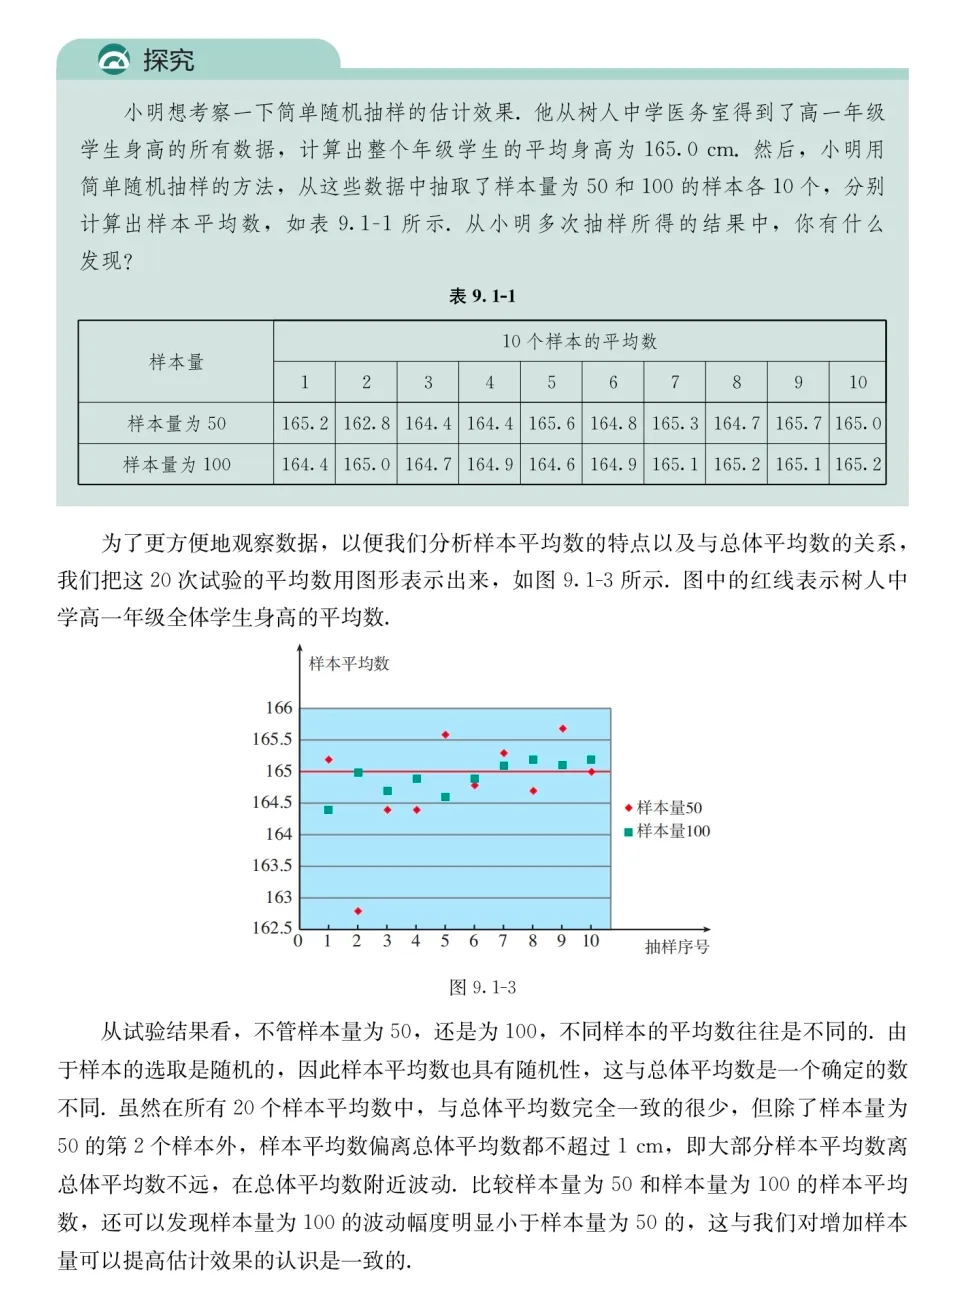
1、展示探究案例:高一全体真实平均身高 165 点 0 厘米,分别抽取样本量 50、100 的样本各 10 组,得到多组样本平均数。
2、结合散点图分析。
3、引导学生发现:
①样本是随机抽取,样本平均数具有随机性,不同样本得到平均数不一样;总体均值是固定不变的常数。
②大部分样本平均数在总体平均数附近波动。
③样本量 100 相比样本量 50,波动幅度更小;样本量越大,估计效果越好。
(四)课堂小结
梳理总体均值、样本均值定义公式,统计思想,样本平均数的随机性特点。
(五)布置作业
抄写总体均值、样本均值公式;
思考:样本均值一定和总体均值完全相等吗,为什么。
试讲
我今天试讲的题目是《总体均值与样本均值》,下面开始我的试讲。
上课,同学们好,请坐。
上一节课,我们用简单随机抽样,从树人中学高一年级七百一十二名同学当中,抽取了容量为五十的样本,拿到这五十位同学身高数据。
那拿到这些样本数据之后,我们要怎么去估计全年级同学的平均身高呢?
这就是我们这节课要解决的问题。
大家看屏幕上这五十个身高数据。
我们把这五十个同学身高全部相加,再除以五十,算出来样本的平均数是一百六十四点三厘米。于是我们就用一百六十四点三厘米,来估计树人中学高一年级全体学生的平均身高。
像这样,对于抽取出来容量为 n 的样本,变量值依次是 y₁,y₂一直到 y 下标 n。我们把 y 拔,等于 n 分之一乘以,从 i 等于 1 到 n 求和 y 下标 i,叫做样本均值,也叫样本平均数。
这里这个大写希腊字母 Σ,读作 sigma,它是求和符号,代表把后面这些数全部相加。
大家注意,很多科学计算器,输入数据就可以直接算出平均数。
那有样本均值,对应就有总体均值。
如果总体一共有 N 个个体,变量值是 Y₁,Y₂一直到 Y 下标 N。那么总体均值 Y 拔,就等于 N 分之一乘以,从 i 等于 1 到 N 求和 Y 下标 i。如果总体里面有些数据重复出现,总体均值还能写成加权平均数的形式。
在简单随机抽样里面,我们最核心的思想,就是拿样本均值,去估计总体均值。
讲到这里老师带来一个探究问题。树人中学全体高一学生真实平均身高是一百六十五点零厘米。
小明做了这样一组试验:他分别抽取样本量为五十和一百的样本各十组,分别算出每一组样本的平均数。大家观察表格,第一排同学你来分享,你从表格里面看到什么现象?
很好,请坐。
这位同学观察到,同样是抽样,不同样本算出来的平均数并不完全一样。
为什么会出现这种情况呢?靠窗的同学,你来说。
说得非常关键,请坐。
因为抽样是随机的,所以样本平均数本身带有随机性。不管样本量是五十还是一百,每一次抽出来样本不同,得到平均数就不一样。但是总体均值,它是一个确定不变的数。
我们再来看屏幕这张散点图,图里面红线就是真实的总体平均数一百六十五点零厘米。大家对比样本量五十和样本量一百这两组数据。中间第三排这位同学,说说两组数据波动有什么区别?
回答得很不错,请坐。
我们能够看到,大部分样本平均数,都在总体平均数附近来回波动。样本量是一百的时候,数据波动幅度明显比样本量五十要小。
这就验证了我们之前得到结论:样本量越大,样本平均数估计总体的效果就越好。当然也会有少数样本,和真实总体均值差距稍大。
好了新知识学完,谁来帮我们梳理本节课收获?来,第二排这位女生。
总结得很完整,请坐。
今天我们学习样本均值、总体均值的概念和计算公式;知道统计当中用样本均值估计总体均值;理解样本平均数具有随机性;样本量越大,估计效果越好。
课后作业,请大家抄写总体均值、样本均值的公式;课后思考,样本均值是否一定等于总体均值,写下你的理由。
本节课到此结束,下课。
板书设计
总体均值与样本均值
实例:高一 712 名学生,样本容量 50
样本均值 164.3,估计总体平均身高
1. 样本均值(样本平均数)
2. 总体均值(总体平均数)
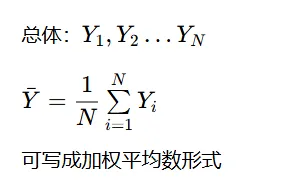
统计思想:用样本均值估计总体均值
探究:样本平均数的特点
样本抽取随机 → 样本平均数具有随机性;总体均值是定值
多数样本平均数在总体均值附近波动
样本量越大,波动越小,估计效果越好
补充:计算器可快速计算平均数
用样本估计总体比例
教学过程
(一)复习导入
1、总体均值、样本均值,用样本均值估计总体均值。
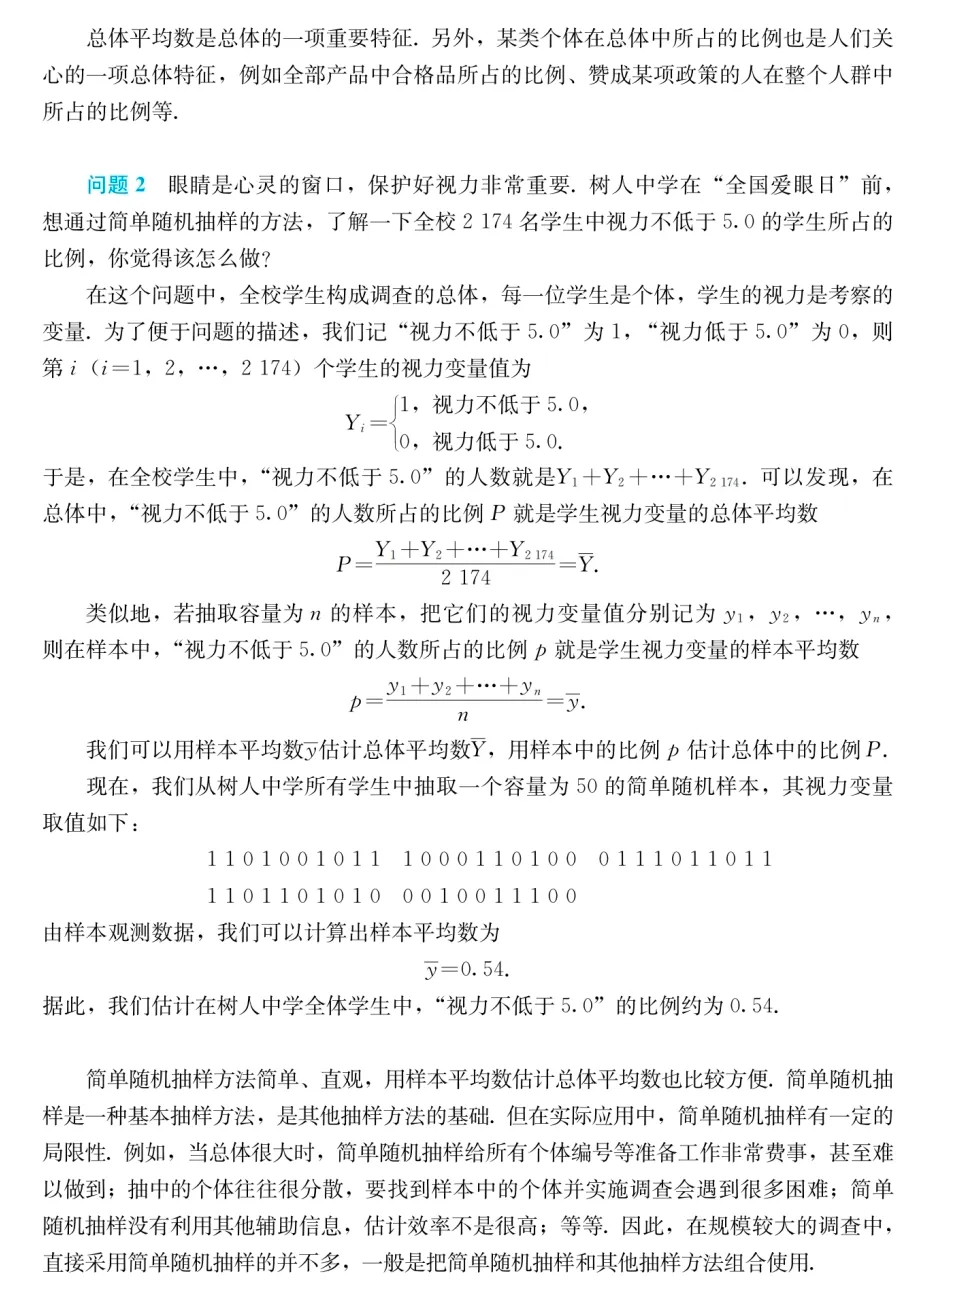
2、抛出实际问题:树人中学一共 2174 名学生,想要了解全校视力不低于 5 点 0 的学生所占比例,用简单随机抽样该怎么做?
(二)新知讲授
问题转化与 0‑1 编码
把 “视力不低于 5 点 0” 记作数字 1,“视力低于 5 点 0” 记作数字 0。
每一名学生对应一个变量取值 1 或者 0。
总体里面,视力不低于 5 点 0 人数占比 P,就是这一组 0、1 变量的总体均值。
抽取容量为 n 的样本,样本当中该部分人数占比 p,就是样本的 0‑1 变量的样本均值。
因此可以用样本比例 p,也就是样本均值 y 拔,去估计总体比例 P,也就是总体均值 Y 拔。
实例演算
给出容量为 50 的样本的 0、1 编码数据,算出样本均值 y 拔等于 0 点 54,以此估计全校视力不低于 5 点 0 的比例大约是 0 点 54。
简单随机抽样的评价
优点:方法简单直观,用样本平均数估计总体平均数操作方便,是其他抽样方法的基础。
局限性:总体很大时,编号工作费事;抽到的个体很分散,实地调查困难;没有利用辅助信息,估计效率不高;大规模调查很少单独使用,常常和其他抽样方法组合使用。
(三)课堂小结
总结 0‑1 变量下总体比例、样本比例的联系,统计估计思想,简单随机抽样优缺点。
(四)布置作业
梳理总体比例、样本比例之间的关系;
举一个生活当中需要估计总体比例的实例,说一说怎么用简单随机抽样完成。
试讲
我今天试讲的题目是《用样本估计总体比例》,下面开始我的试讲。
上课,同学们好,请坐。
上一节课我们学习了总体均值和样本均值,我们可以用样本均值来估计总体的均值。
但现实当中,我们不光关心平均数,还经常关心某一类个体占总体的比例。
比如说产品当中合格品占多少,人群当中赞同某项政策的占多少。
老师带来校园当中的真实情境,树人中学一共有两千一百七十四名学生,学校想了解全校视力不低于 5 点 0 的学生所占比例,如果采用简单随机抽样,我们该怎么做呢?这就是今天我们要共同研究的内容。
我们看这个问题,全校学生构成总体,每一位学生是个体,考察变量是学生视力。
视力是两种结果:不低于 5 点 0,或是低于 5 点 0。那我们怎么把这种分类的信息变成可以计算的数字呢?
第一排同学你来谈谈你的想法。
思路很不错,请坐。
我们可以做编码处理:把视力不低于 5 点 0 记作数字 1,视力低于 5 点 0 记作数字 0。这样每一位同学就对应取值 1 或者 0。
那大家想一想,总体当中视力不低于 5 点 0 的学生所占比例 P 该怎么表示?靠窗这位同学,你来说。
很好,请坐。
全部两千一百七十四个学生的变量相加,得到视力合格的总人数,再除以两千一百七十四。大家看,这个式子正好就是我们之前学的总体均值 Y 拔。
也就是说,总体比例 P,本质就是这一组 0‑1 变量的总体均值。
同理,我们抽取容量为 n 的简单随机样本,把样本的变量记为 y₁、y₂一直到 y 下标 n。
样本当中视力不低于 5 点 0 的比例 p,就等于样本数据求和除以 n,这正好就是样本均值 y 拔。
所以,我们就可以用样本的比例 p,也就是样本均值 y 拔,去估计总体的比例 P。
屏幕这里给出一组容量为五十的简单随机样本,全部由 0 和 1 组成。
我们统计计算,得到样本均值 y 拔等于零点五四。
据此,我们就估计树人中学全体学生当中,视力不低于 5 点 0 的比例大约是零点五四。
到这里,我们已经完整学习了简单随机抽样。
那大家思考,简单随机抽样有哪些长处,又存在什么不足呢?中间第三排这位同学,你来分享。
分析得很全面,请坐。
简单随机抽样优点十分突出:方法简单、直观,借助样本平均数去估计总体平均数,操作方便,它也是我们后续其他抽样方法的基础。
但是它也有明显局限。当总体数量非常庞大,给全部个体编号会十分麻烦;抽出来的样本个体往往很分散,实地开展调查难度大;同时它没有利用其他辅助信息,估计效率不算很高。
所以在大规模调查当中,很少单独直接使用简单随机抽样,一般会把它和其他抽样方法组合起来使用。
好了,新知识学完。谁来帮我们梳理本节课主要内容?来,第二排这位女生。
总结条理很清晰,请坐。
今天我们学习了把分类问题做 0‑1 数字化编码;总体比例就是 0‑1 变量的总体均值,样本比例就是 0‑1 变量样本均值,用样本比例估计总体比例;同时客观认识简单随机抽样的优点与局限性。
课后作业,请大家梳理总体比例与样本比例的关系;找一个生活实例,说一说如何用简单随机抽样估计某一类个体的总体比例。
本节课到此结束,下课。
板书设计
用样本估计总体比例
实例:全校 2174 名学生,估计视力≥5.0 占比
编码:视力不低于 5.0 → 1
视力低于 5.0 → 0
1. 总体比例 P
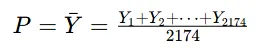
总体比例 = 0‑1 变量的总体均值
2. 样本比例 p
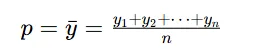
样本比例 = 0‑1 变量的样本均值
统计思想:用样本比例 p 估计 总体比例 P

简单随机抽样评价
优点:简单直观,估计方便;是其他抽样方法基础
局限性:
①总体大时,编号费事
②样本个体分散,调查实施困难
③未利用辅助信息,估计效率不高
大规模调查:常与其他抽样方法组合使用
分层随机抽样
教学过程
(一)复习导入
1、简单随机抽样,它存在局限,有可能抽到极端样本,比如样本全是男生或者全是女生,身高估计会出现偏差。
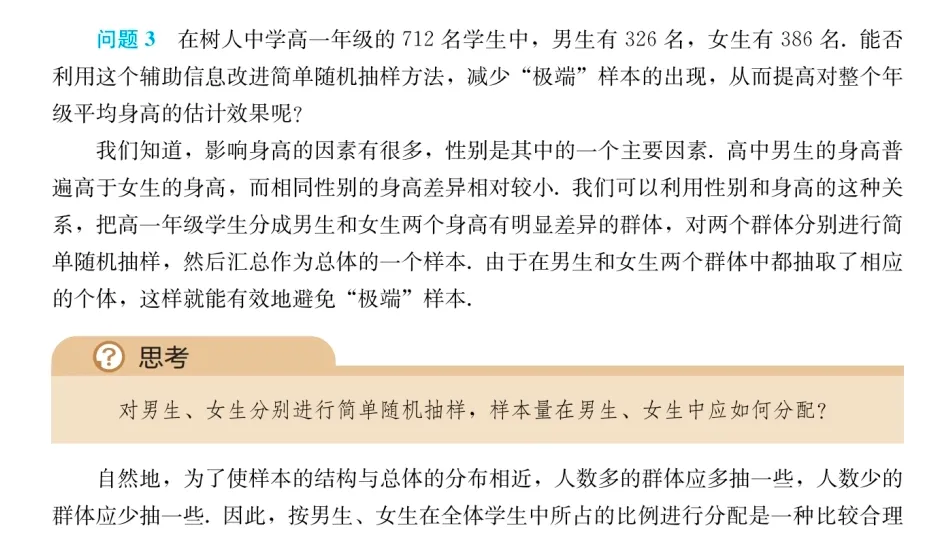
2、出示问题 3:树人中学高一总共 712 名学生,男生 326 名,女生 386 名,能不能利用性别这个辅助信息改进抽样,减少极端样本,提高估计效果?引出分层随机抽样。
(二)新知讲授
分层的思想
性别对身高影响大,男生、女生身高差异明显,同性别内部身高差异较小。
把总体分成男生、女生两个子总体,每一个子总体就叫做一层;在每一层分别独立做简单随机抽样,合并各层样本得到总样本,能够避免极端样本。
抛出思考:两层的样本量该如何分配?
引导得出:人数多的层多抽,人数少的层少抽,按照各层占总体的比例分配样本,就是比例分配。
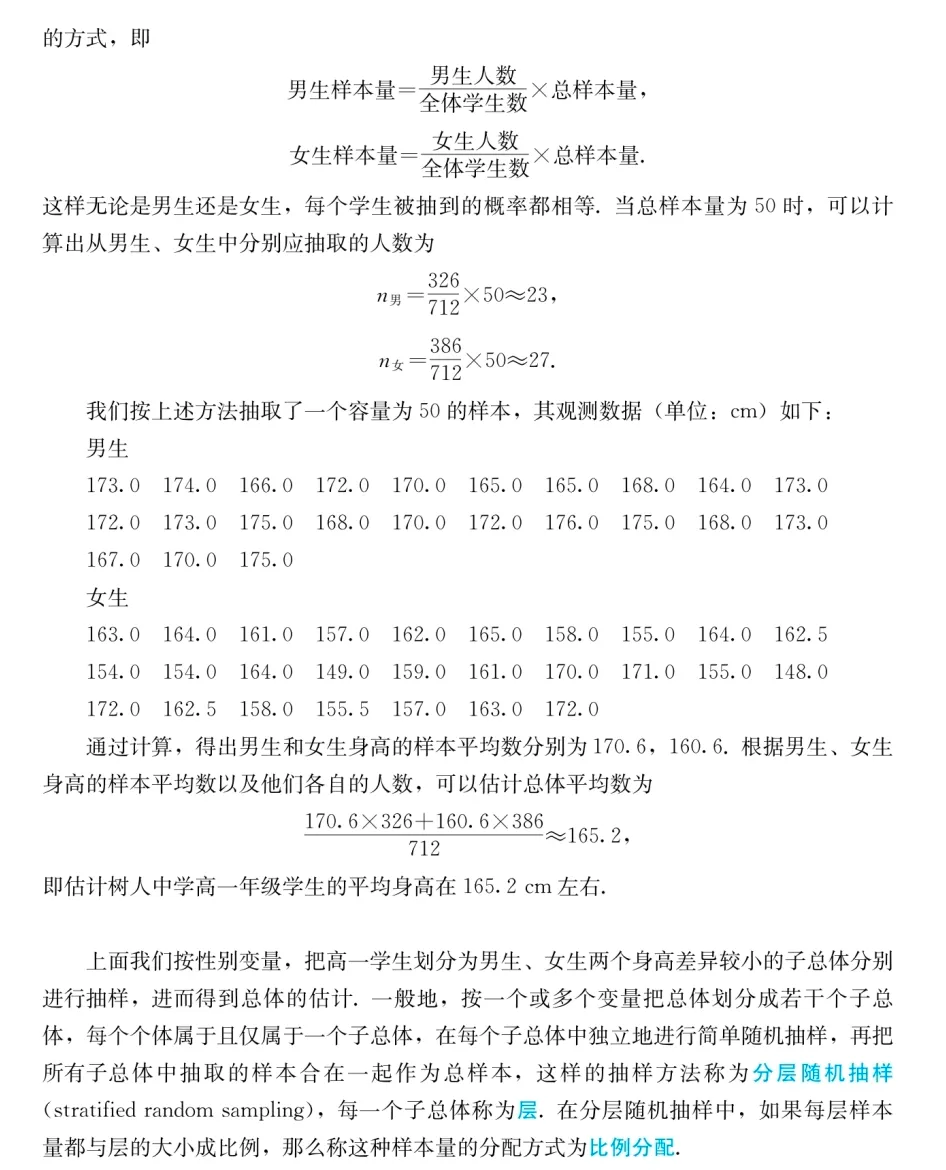
比例分配公式
某一层样本量等于该层个体数除以总体个体数,再乘总样本量。
结合实例总样本量取 50,代入公式,算出男生大约抽 23 人,女生大约抽 27 人。
说明比例分配下每个个体被抽到的概率相等。
分层抽样估计总体均值
给出分层抽取的样本数据,算出男生层样本平均数 170 点 6,女生层样本平均数 160 点 6。利用两层样本平均数与两层真实总人数加权,计算得到总体均值估计约等于 165 点 2。
归纳分层随机抽样定义:按一个或者多个变量,把总体划分若干互不重叠子总体(层),每层独立简单随机抽样,合并得到总样本;每层样本量和层大小成比例叫比例分配。
(三)课堂小结
分层随机抽样步骤、比例分配含义、分层抽样优势。
(四)布置作业
整理分层随机抽样的定义与比例分配公式;
自己举一个适合分层随机抽样的生活例子。
试讲
我今天试讲的题目是《分层随机抽样》,下面开始我的试讲。
上课,同学们好,请坐。
上节课我们学习了简单随机抽样,但是简单随机抽样有不足,有可能出现很极端的样本。
就拿树人中学高一年级七百一十二名同学举例,男生有三百二十六名,女生有三百八十六名。
如果简单随机抽样,有可能抽到样本里面几乎全是男生,或者几乎全是女生,这样对平均身高的估计就会出现很大偏差。
那我们能不能利用性别这个辅助信息,改进抽样,减少极端样本,提高估计效果?
今天我们就来学习分层随机抽样。
大家思考,男生普遍身高高于女生,同一性别内部,身高的差异反而比较小。那我们可以怎么做来规避极端样本?
第一排同学你来谈谈你的想法。
想法非常好,请坐。
这位同学提出,我们可以按照性别,把全体学生分成男生、女生两个群体。
我们把划分出来的每一个子总体,叫做一层。男生是一层,女生是一层,分别在男生层、女生层当中做简单随机抽样,最后把抽出来样本合在一起,作为总样本。
这样两层都能抽到个体,就可以有效避免全部抽到男生或者全部抽到女生这种极端样本。
那新的问题来了,思考一下,男生、女生这两层,样本数量要怎么分配才合理呢?
靠窗这位同学,你来说。
说得很有道理,请坐。
总体当中哪一层人数多,这一层就应该多抽取样本;人数少的层就少抽取样本。
按照每一层在总体当中所占的比例分配样本量,就是很合理的方案,这种分配叫做比例分配。
我们把这个思路写成公式:
某一层的样本量,等于这一层的个体数除以全部总体个体数,再乘总样本量。
现在我们设定总样本量等于五十,我们一起来算一算。男生层样本量,等于七百一十二分之三百二十六,乘以五十,大约等于二十三;女生层样本量,等于七百一十二分之三百八十六,乘以五十,大约等于二十七。
在比例分配的方式之下,每一名学生被抽中的概率都是相等的。
屏幕给出我们按比例分配抽出来容量五十的样本数据。
我们算出男生这一层样本平均数是一百七十点六,女生层样本平均数是一百六十点六。
注意,估计总体平均数的时候,不能直接把两个层的样本平均数简单求平均,要拿两层样本平均数,分别乘上男、女生真实总人数,相加之后再除以总体七百一十二。计算得到估计值大约一百六十五点二厘米。
现在我们来归纳分层随机抽样完整定义。按照一个或者多个变量,把总体划分成若干个子总体,每个个体属于并且仅属于其中一层;在每一层内部独立开展简单随机抽样,把各层抽取样本合并,得到总样本,这样的抽样方法就是分层随机抽样。
当每层样本量和层本身大小成比例,就叫比例分配。
好了新知识学完,谁帮我们梳理本节课学到的要点?来,第二排这位女生。
总结很完整,请坐。
今天我们学习分层随机抽样,把总体划分为不同的层,每层独立简单随机抽样;学习比例分配的计算;分层抽样可以减少极端样本,优化估计效果;分层估计总体均值需要用层的真实人数做加权计算。
课后作业,请大家整理分层随机抽样定义、比例分配公式;举一个现实当中适合分层随机抽样的实例。
本节课到此结束,下课。
板书设计
分层随机抽样
实例:高一 712 人,男生 326,女生 386,总样本量 50
问题:简单随机抽样可能出现极端样本
1. 分层思想
层:按某些变量划分互不重叠子总体
男生为一层,女生为一层
每层独立简单随机抽样,合并为总样本
优点:减少极端样本,提升估计效果
2. 比例分配
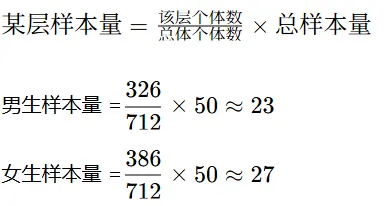
比例分配:每层样本量与层大小成比例,个体被抽概率相等
3. 估计总体均值(加权)
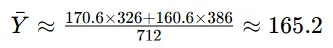
分层随机抽样定义:
按变量划分若干层,每层独立简单随机抽样,合并得到总样本。
分层随机抽样的均值与估计效果
教学过程
(一)复习导入
1、分层随机抽样、比例分配。
2、对于分为两层的总体,已知两层个体总数、两层样本,怎样估计总体平均数?
3、引出本节课分层随机抽样的均值计算与估计效果。
(二)新知讲授
1、两层的均值符号定义
第一层总体个体数 M,样本量 m;
第二层总体个体数 N,样本量 n。
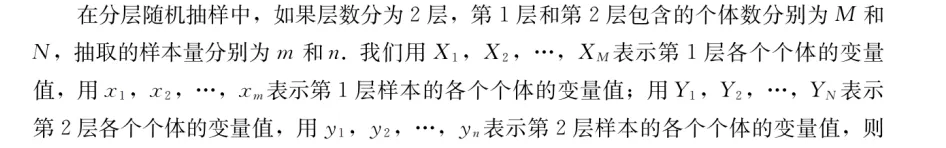
分别写出每层总体平均数、每层样本平均数。总体平均数需要用两层全部个体做加权平均。用每层样本平均数去代替每层总体平均数,得到总体均值估计公式。
2、比例分配的特殊结论
可以推导出,总体均值估计等价于直接用全部样本的总样本平均数。
也就是比例分配时,直接拿总样本平均数就可以估计总体平均数。
3、探究分层抽样估计效果
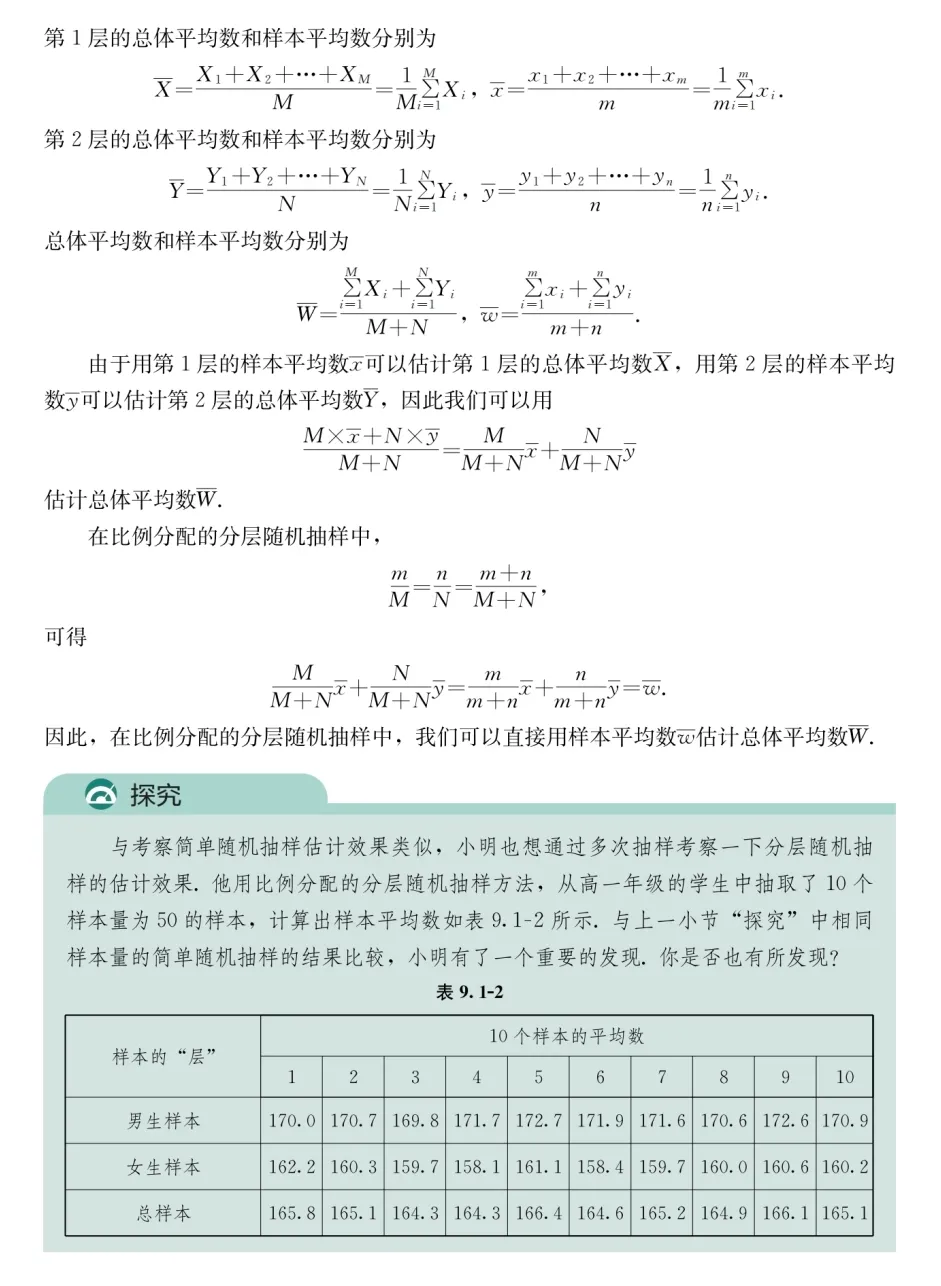
展示多次抽样试验表格与对比图像。
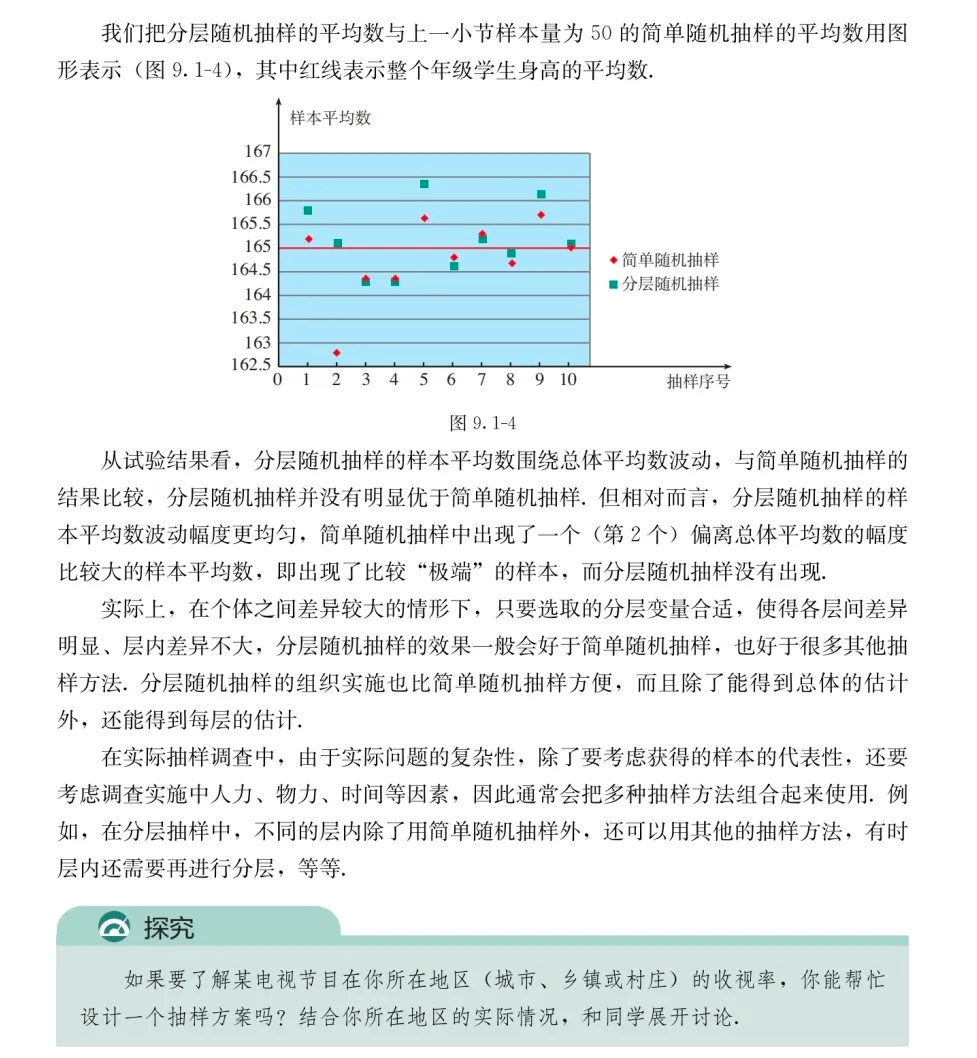
对比简单随机抽样、比例分配分层随机抽样的样本平均数波动。
试验现象:分层抽样不会出现极端样本;合适分层(层间差异大、层内差异小)时分层抽样估计效果更好;分层抽样还可以同时得到每一层的估计。
4、实际应用说明
现实调查综合人力物力,常常多种抽样方法组合;层内部也可以使用别的抽样方式,层内还可以继续分层。
5、抛出拓展思考:调查电视节目收视率,怎么设计抽样方案。
(三)课堂小结
总结分层抽样均值估计公式、比例分配的结论、分层抽样的效果与适用条件。
(四)布置作业
整理两层分层抽样均值公式;
课后思考,调查地区电视节目收视率,写出分层抽样的设计思路。
试讲
我今天试讲的题目是《分层随机抽样的均值与估计效果》,下面开始我的试讲。
上课,同学们好,请坐。
上一节课我们学习分层随机抽样和比例分配,我们用男女生两层的例子计算过总体平均身高。
那推广到一般情况,如果总体分成两层,我们该怎样用两层的样本,估计整个总体的平均数?
这节课我们继续研究分层随机抽样的均值计算,以及它的估计效果。
我们设总体分为两层,第一层个体总数是 M,抽取样本量 m;第二层个体总数 N,抽取样本量 n。
我们可以分别算出第一层的样本平均数 x 拔,第二层的样本平均数 y 拔。
那大家思考,能不能直接把 x 拔和 y 拔求算术平均当作总体平均数?第一排同学你来谈谈你的想法。
说得很好,请坐。
不能直接简单平均,两层总体个体数目不一样,要拿两层真实个体数量做权重。
所以我们估计总体平均数的公式,就是 M 乘以 x 拔,加上 N 乘以 y 拔,再除以 M 加 N。这个就是分层随机抽样估计总体均值的加权公式。
那如果是我们上节课学的比例分配,会发生什么呢?
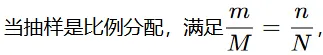
比例分配满足,m 比 M 等于 n 比 N。我们代入公式推导就会发现,这个加权结果,正好等于全部样本合在一起算出来的总样本平均数 w 拔。
也就是说,在比例分配的分层随机抽样当中,我们可以直接用总样本平均数去估计总体平均数,不用再额外加权计算,这给我们计算带来方便。
接下来我们来做探究试验。小明用比例分配的分层随机抽样,抽取十个容量为五十的样本,算出每一组样本平均数。
屏幕上表格给出了试验数据,还有对比图像,红线代表真实的总体平均数。大家观察图像,对比简单随机抽样和分层随机抽样。靠窗这位同学,说说你观察到什么现象?
观察很仔细,请坐。
我们看到,简单随机抽样会出现偏离很大的极端样本,而分层随机抽样没有出现极端样本,样本平均数波动更加均匀。
那是不是分层随机抽样一定处处更好?大家注意,想要分层抽样效果好,分层变量要选合适,做到层和层之间差异明显,每一层内部差异比较小,这种情况下分层抽样效果优于简单随机抽样。分层抽样还有一个好处,除了估计总体,我们还可以单独得到每一层的估计结果。
当然现实统计调查,不能只看样本代表性,还要考虑人力、物力、时间。
所以实际工作经常把多种抽样方法组合使用,某一层内部,还可以继续分层,或者使用别的抽样方法。
大家课后可以想一想,如果要调查一个地区电视节目的收视率,结合城市、乡镇、村庄,该怎样设计抽样方案。
好了,本节课的新知识到这里。谁来梳理本节课主要收获?来,第二排这位女生。
总结很到位,请坐。
今天我们学习两层分层抽样总体均值的加权估计公式;知道比例分配下,直接用总样本平均数就可以估计总体;通过试验看到分层抽样可以避免极端样本,理解分层抽样的适用条件,现实中抽样方法常常组合使用。
课后作业,请大家整理分层随机抽样均值相关公式;课后思考电视节目收视率的分层抽样设计思路。
本节课到此结束,下课。
板书设计
分层随机抽样的均值与估计效果
两层:
第一层总数M,样本量m
第二层总数N,样本量n
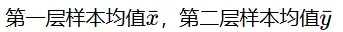
1. 总体均值估计(加权)
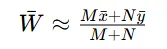
2. 比例分配时
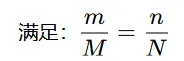

3. 估计效果
分层抽样样本平均数波动更均匀,不容易出现极端样本
分层原则:层间差异大,层内差异小,估计效果更好
优点:同时得到总体、各层的估计
实际调查
常多种抽样方法组合;层内可再分层或使用其他抽样。
思考:地区电视节目收视率抽样方案。
获取数据的途径
教学过程
(一)导入新课
统计学依靠收集、分析数据认识客观现象。
我们前面学了简单随机抽样、分层随机抽样,那除了抽样,我们还有哪些手段拿到数据?
引出课题获取数据的途径。
(二)新知讲授
通过调查获取数据
针对有限总体,用普查或者抽样调查获取数据。
举例人口总数、高中生近视比例等。介绍除简单、分层抽样外,还有系统抽样、整群抽样等多种抽样,实际要结合背景选方法,规避人为错误。
通过试验获取数据
没有现存数据的时候,做对比试验。
例子新药效果、小麦新品种产量、材料配方。要严格控制环境,精心设计试验,也就是试验设计。
通过观察获取数据
针对不可人为控制的自然现象,地震、降水、大气污染。
不能抽样,不能做试验,只能长期持续观察。专业设备采集,是大数据来源。
通过查询获得数据(二手数据)
查找前人已经收集好的数据,叫二手数据。
来源统计年鉴、公报、国家统计局。
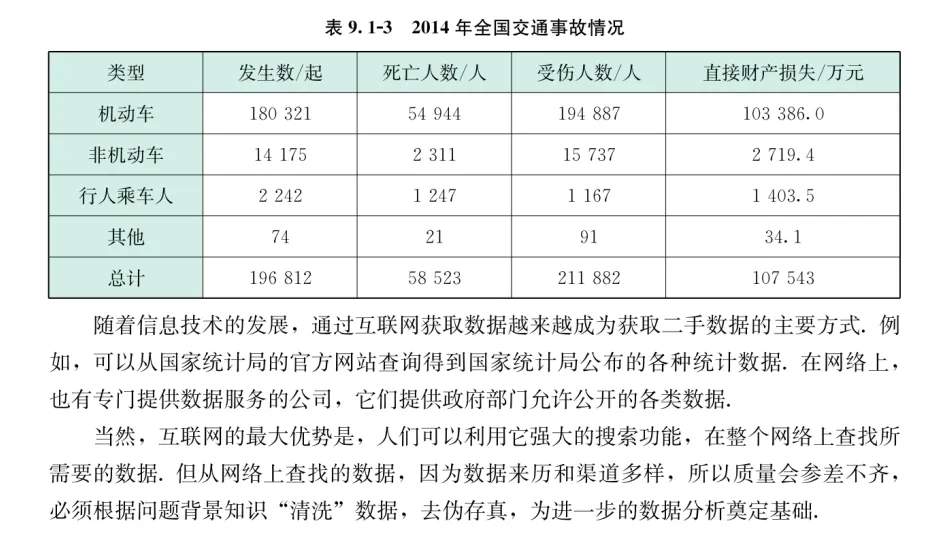
展示交通事故统计表格案例。
互联网是获取二手数据重要方式;网络数据来源复杂,质量参差不齐,需要清洗数据,去伪存真。
(三)巩固辨析
给出几个实例,请学生判断该用哪一种途径,加深四种途径的区分。
(四)课堂小结
四种获取数据途径,每一种适合什么情况,补充二手数据注意事项。
(五)布置作业
课后习题;
思考:要调查本地高中生每日运动时长,该选择什么途径获取数据。
试讲
我今天试讲的题目是《获取数据的途径》,下面开始我的试讲。
上课,同学们好,请坐。
前面几节课,我们学习了简单随机抽样、分层随机抽样。
统计是依靠收集数据、分析数据来认识世界的。大家想一想,抽样是拿到数据的唯一办法吗?
还有哪些办法可以拿到我们需要的数据?
今天我们一起来学习获取数据的途径。
请大家阅读课本,找一找,书上一共给我们介绍了几大类获取数据的途径。
第一排同学你来,说说你的发现。
很好,请坐。
找到了四种途径,分别是调查、试验、观察、查询。我们一个一个来学习。
第一种,通过调查获取数据。这种途径,一般处理有限总体。
比如说统计人口总数,调查高中生近视比例,检查产品合格率。手段分为普查和抽样调查。
我们已经学习简单随机抽样、分层随机抽样,除此之外,还有系统抽样、整群抽样等许许多多抽样方法。
在实际使用的时候,要结合背景信息选合适抽样方法,同时避免人为带来的错误。
那如果我们要检验一款新药有没有效果,培育小麦新品种能不能增产,这种情况,过去没有现成的数据,调查就行不通了,我们该怎么办?靠窗这位同学,你来说。
思路很不错,请坐。
这就要用到第二种途径,通过试验获取数据。像新药、农作物新品种、材料配方,我们要做对比试验拿到观测数据。做试验的时候,我们要严格控制环境,精心安排,这门学问叫做试验设计。
那大家思考,地震、降水、大气污染,这些自然现象,我们既不能做普查抽样,也不能人为做试验,那怎么拿到数据?
来,第二排男生,你说一说。
说得非常到位,请坐。
这类不受人类控制的自然现象,我们只能依靠长期持续观察获取数据。
借助专业仪器设备记录现象,这就是第三种途径,通过观察获取数据。很多大数据,就是这样观察采集得来的。
前面三种,都是我们自己动手去得到一手数据。但很多问题,别人已经做过研究了,我们可以直接拿来使用,这就是第四种途径,通过查询获得数据,这样得到的数据叫做二手数据。
大家看屏幕上的表格,二零一四年全国交通事故情况,这份数据就来自《中国统计年鉴》,国家统计局会发布公报、年鉴,给我们提供大量二手数据。
现在互联网也成为获取二手数据的主要方式,我们可以登录官方网站查找公开统计资料。但是注意,网络上面的数据来源五花八门,质量高低不一样,拿到之后要做数据清洗,做到去伪存真,才能用来分析。
我们一起来做个小练习。判断几个场景分别用哪一种途径。
研究暴雨对城市的影响;检验新轮胎配方质量;查历年人口数量;调查班级同学睡眠时间。大家可以小声交流。
好了,新知识学完了,谁来帮我们梳理本节课收获?来,第三排这位女生。
总结的很完整,请坐。
我们今天学习四种获取数据途径:调查适合有限总体;试验适合研发新产品;观察用来研究不可控自然现象;查询用来获取二手数据。
同时特别注意,网络得到二手数据,一定要甄别清洗。
课后作业,完成课后练习;想一想,如果我们想要了解本地高中生每日运动时长,应该选择哪一种途径获取数据。
本节课到此结束,下课。
板书设计
获取数据的途径
通过调查获取数据
适用:有限总体;普查、抽样调查
抽样:简单随机、分层、系统、整群抽样等
通过试验获取数据
适用:无现存数据(新药、新品种、配方)
要求:控制环境 → 试验设计
通过观察获取数据
适用:不可人为控制自然现象(地震、降水)
设备采集,大数据来源
通过查询获得数据
二手数据:年鉴、公报、国家统计局、互联网
网络数据:需要清洗数据,去伪存真
小结:根据实际问题选择合适途径
作业:调查本地高中生每日运动时长途径思考